
TL;DR
Claude Fable 5.1 ma mocniejsze wyniki w benchmarkach dla trudnego autonomicznego kodowania i pracy o długim horyzoncie. GPT-5.6 Sol oferuje niższe zwykłe koszty tokenów, szeroki natywny zestaw narzędzi oraz niższy czas do pierwszego tokena w niezależnym porównaniu przy maksymalnym wysiłku. Właściwy wybór domyślny zależy od kosztu niepowodzenia zadania, a nie tylko od najwyższego wyniku w benchmarku.
W migawce Intelligence Index z 8 września 2026 r. Fable 5.1 uzyskuje 53, a GPT-5.6 Sol 47. Przepustowość wyjścia jest praktycznie remisowa: 69.9 vs 69.8 tokens/s. Te wyniki wspierają decyzję jakość kontra koszt; nie ustanawiają uniwersalnego zwycięzcy szybkości.
Najważniejsze wnioski
- Wybierz Fable 5.1 do najtrudniejszych zadań autonomicznych, jeśli Twoje własne ewaluacje uzasadniają wyższą cenę.
- Zacznij od GPT-5.6 Sol dla wrażliwego na koszty inferencjonowania frontier i aplikacji, które korzystają z jego zintegrowanych narzędzi.
- Porównuj opóźnienie startu oddzielnie od szybkości wyjścia: GPT-5.6 Sol ma niższy zmierzony czas do pierwszego tokena, podczas gdy przepustowość jest niemal równa.
- Modeluj zapisy/odczyty/retencję cache oraz stawki dla długiego kontekstu oddzielnie. Nagłówkowe ceny wejścia/wyjścia nie opisują każdego obciążenia agenta.
Dane sprawdzone 8 września 2026 r. Niezależne wyniki używają GPT-5.6 Sol przy maksymalnym wysiłku i Fable 5.1 z Adaptive Reasoning, Max Effort, Default Fallback. Benchmarki dostawców i niezależne benchmarki używają różnych konfiguracji ewaluacji. Ceny w USD za milion tokenów (MTok), o ile nie zaznaczono inaczej.
GPT-5.6 Sol vs Fable 5.1: szybki werdykt
| Wymiar | GPT-5.6 Sol | Claude Fable 5.1 | Lepszy wybór |
|---|---|---|---|
| Niezależny Intelligence Index v4.3 (8 wrz) | 47 | 53 | Fable 5.1 |
| Niezależny Terminal-Bench 4.0 (7 wrz) | 39.9% | 52.0% | Fable 5.1 |
| Terminal-Bench 4.0 uruchamiany przez Anthropic | 37.3% | 55.8% | Fable 5.1 |
| Okno kontekstu | 1.05M | 1M | Praktycznie remis |
| Maksymalne wyjście | 128K | 128K | Remis |
| Wejście tekst/obraz | Yes | Yes | Remis |
| Oficjalna cena wejścia / MTok | $4 | $10 | Sol |
| Oficjalna cena wyjścia / MTok | $20 | $50 | Sol |
| Oficjalny odczyt cache / MTok | $0.40 | $0.25 | Fable 5.1 |
| Niezależna szybkość wyjścia (8 wrz) | 69.8 tok/s | 69.9 tok/s | Praktycznie remis |
| Szerokość narzędzi API | Very broad | Strong | Sol |
| Długotrwała praca autonomiczna | Excellent | Core strength | Fable 5.1 |
| Produkcja wrażliwa na koszty | Better default | Premium escalation | Sol |
Użyteczna polityka na start to Sol do rutynowej pracy na froncie, z Fable 5.1 jako ścieżką eskalacji, gdy zadanie nie spełnia Twojego progu jakości lub autonomii. Zweryfikuj tę politykę względem kosztu udanego zadania.
GPT-5.6 Sol udostępnia sześć poziomów wysiłku rozumowania, od none po max, z domyślnym medium. Fable 5.1 używa zawsze włączonego adaptacyjnego myślenia; parametr effort steruje głębokością rozumowania, a domyślne ustawienie to high.
Dodatkowe 50 000 tokenów w kontekście GPT-5.6 Sol raczej nie zadecyduje o większości architektur. Rozliczenia i ponowne użycie cache stają się ważniejsze, gdy żądanie zbliża się do miliona tokenów; sekcja o długim kontekście poniżej wyjaśnia dlaczego.
Czym jest GPT-5.6 Sol?
GPT-5.6 Sol to wysoko wydajny poziom w rodzinie GPT-5.6 od OpenAI do wymagającego kodowania, researchu, planowania i przepływów pracy agentów. Jego główny atut w tym porównaniu to połączenie kontroli rozumowania i otaczającego środowiska wykonawczego.
Poprzez Responses API GPT-5.6 Sol obsługuje szerokie natywne portfolio narzędzi: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills oraz tool search. To może zmniejszyć liczbę oddzielnych komponentów runtime, które aplikacja musi zintegrować.
OpenAI opisuje także programmatic tool calling i wykonywanie multi-agentowe dla tej rodziny. Te funkcje platformowe mają znaczenie, gdy model musi koordynować pracę z narzędziami, zamiast zwracać pojedynczą odpowiedź.
Czym jest Claude Fable 5.1?
Claude Fable 5.1 celuje w wymagające kodowanie, profesjonalną pracę wiedzochłonną, research i długo działające agenty. Jego bezpośrednie wyniki benchmarków czynią go mocnym kandydatem do zadań, w których odzyskiwanie po błędach, wytrwałość i pomyślne ukończenie są ważniejsze niż krótka odpowiedź.
Anthropic akcentuje utrzymywaną autonomiczną egzekucję w różnych aplikacjach, w tym planowanie, wychodzenie z nieudanych kroków i komunikowanie postępów. Traktuj to pozycjonowanie jako powód do testów dłuższych zadań, a nie gwarancję, że każdy przepływ pracy zakończy się poprawnie.
Fable 5.1 różni się od GPT-5.6 Sol także zachowaniem API: jego ograniczenia wymuszonego wyboru narzędzia mają znaczenie w przepływach, które wymagają, by model wywołał konkretne narzędzie. Sprawdź obsługiwane tryby tool_choice przy migracji deterministycznej pętli agenta.
Pytanie integracyjne jest więc praktyczne: czy Twoja aplikacja toleruje bardziej autonomiczną pętlę rozumowania, czy wymaga drobniejszej kontroli nad każdym krokiem? Przetestuj dokładne zachowanie narzędzi przed wyborem ścieżki.
Porównanie benchmarków: Fable 5.1 ma silniejsze bezpośrednie dowody
Porównania benchmarków między konkurencyjnymi dostawcami łatwo nadużyć. Pierwotne ewaluacje startowe GPT-5.6 od OpenAI poprzedzają Fable 5.1, podczas gdy wydanie Fable 5.1 od Anthropic zawiera nowsze bezpośrednie porównania z GPT-5.6 Sol.
Najczystszy sposób odczytu dowodów to trzy warstwy: bezpośrednie porównanie Anthropic, bieżące niezależne testy i własny profil możliwości GPT-5.6 Sol od OpenAI.
Bezpośrednie wyniki Anthropic: Fable 5.1 vs GPT-5.6 Sol
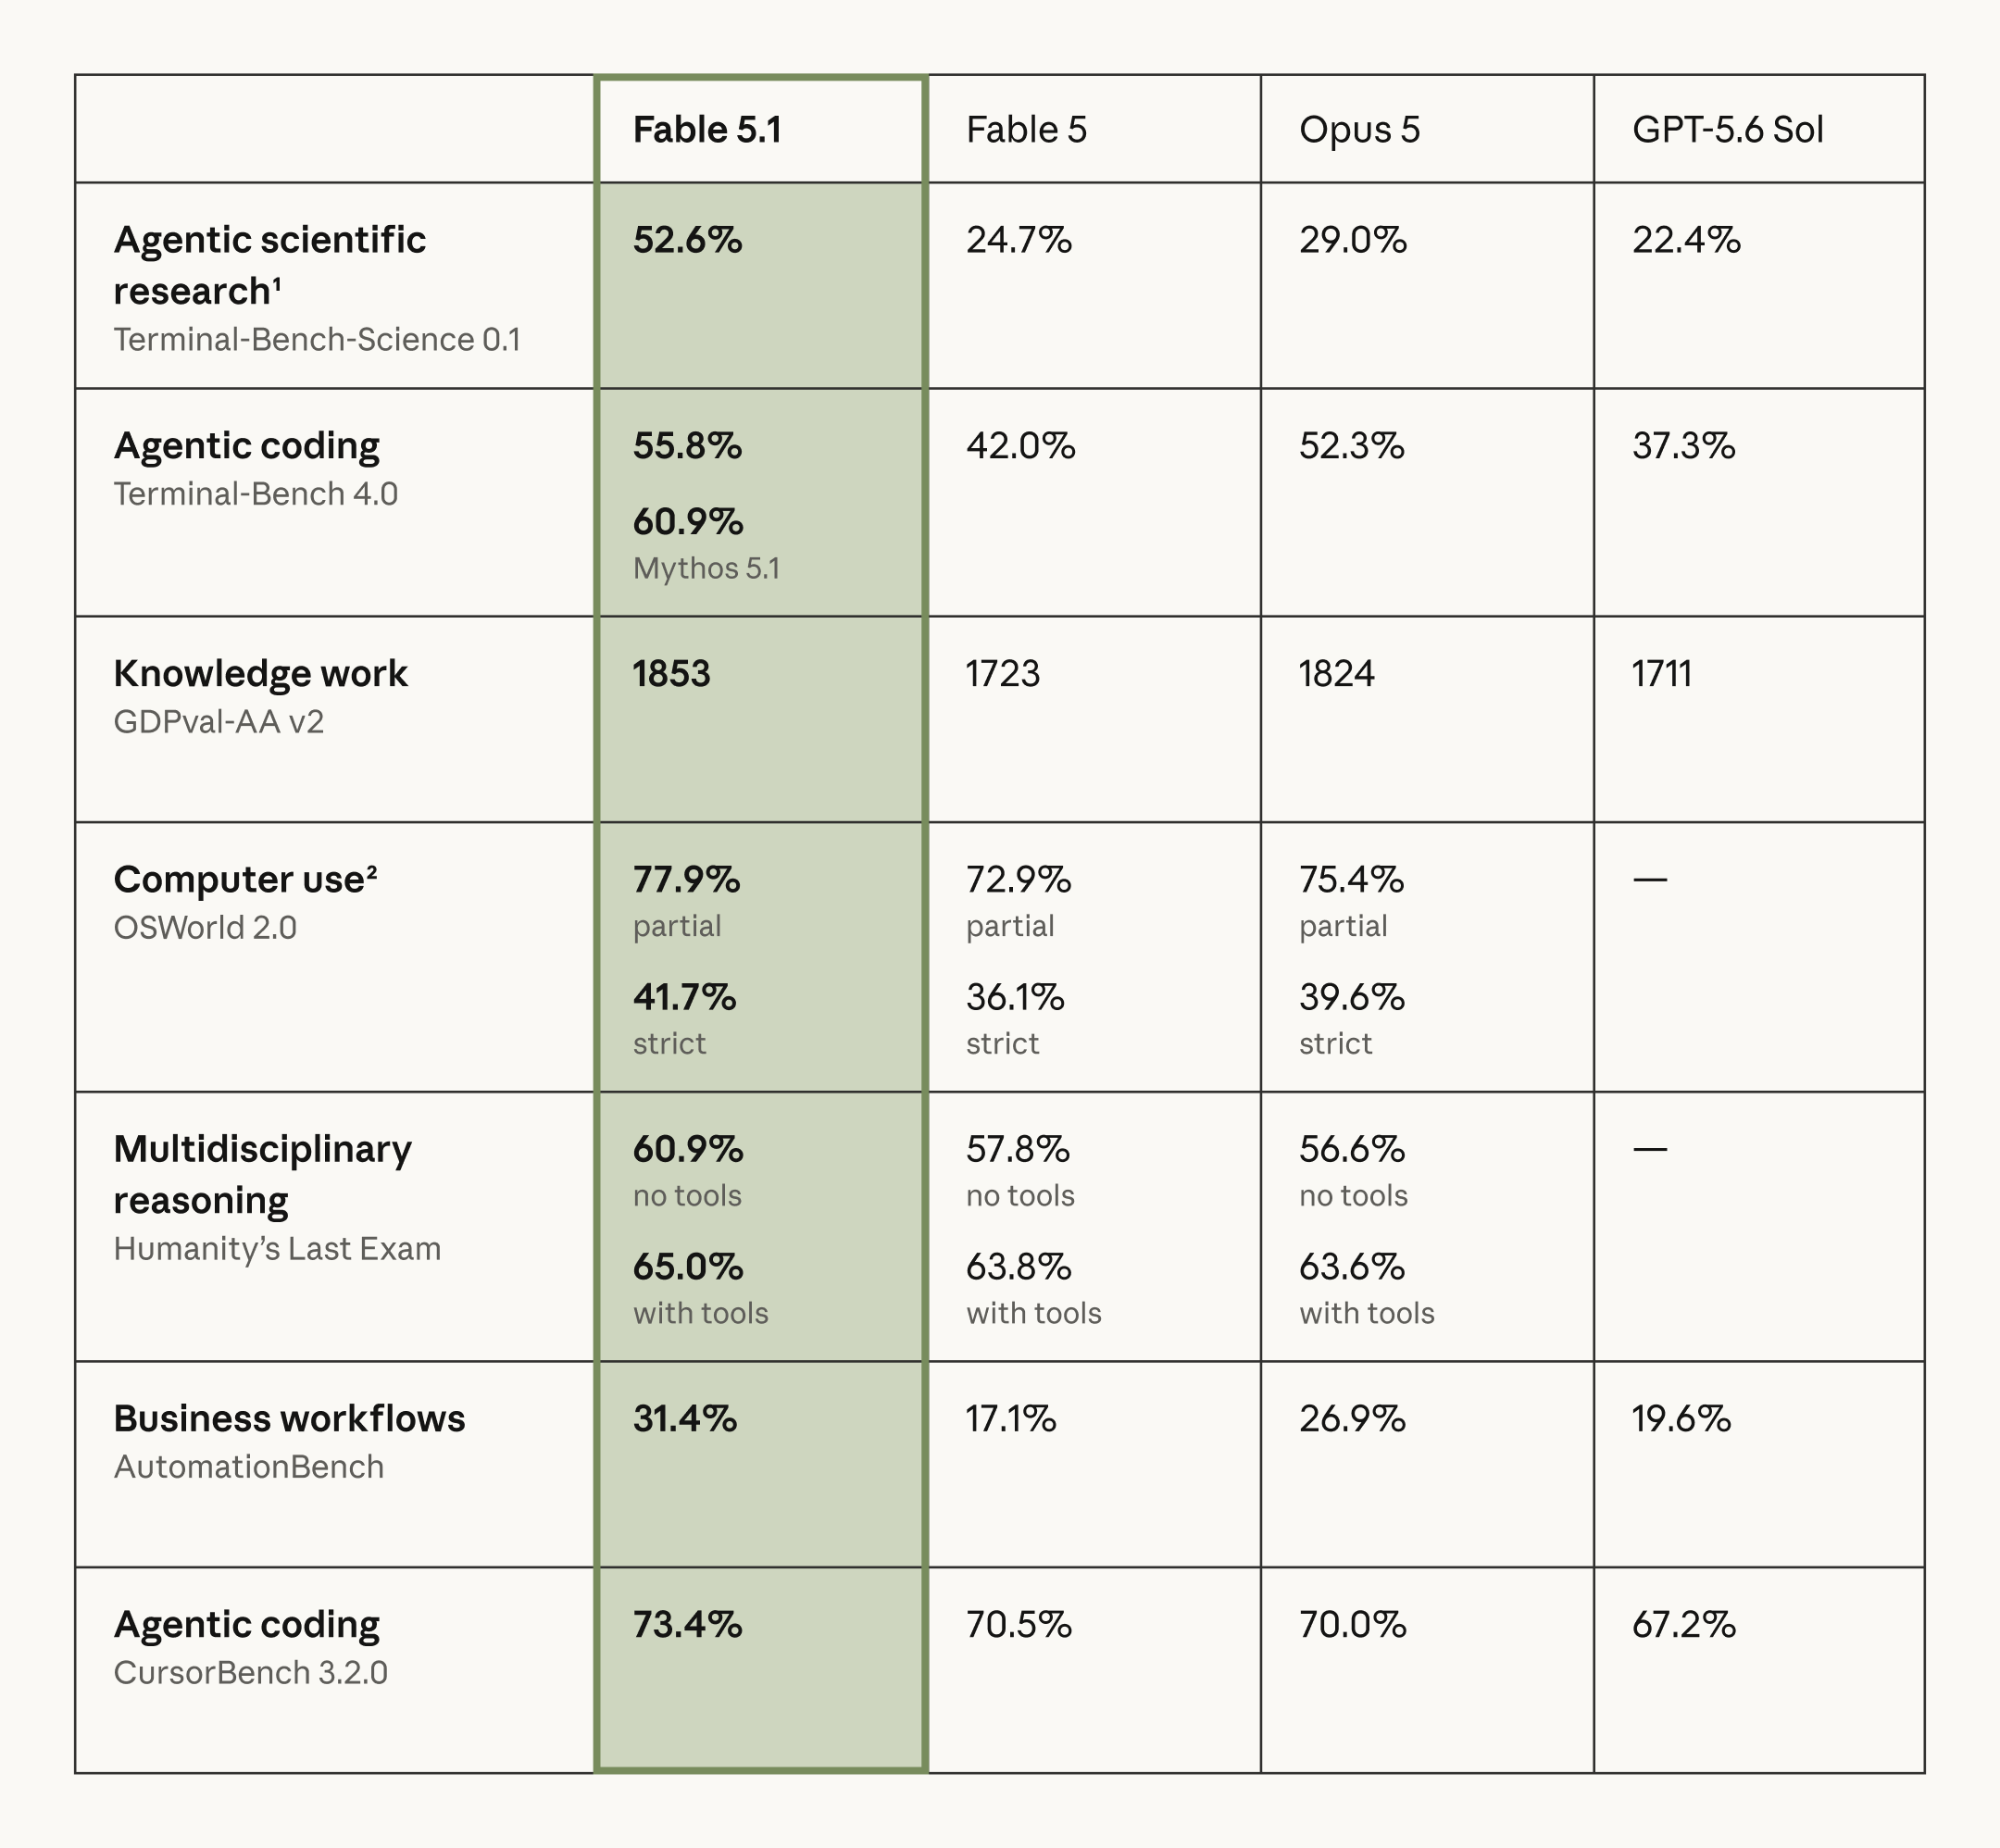
Oficjalne wyniki benchmarków obejmują pięć zadań z raportowanymi wynikami dla obu modeli. Poniższe różnice punktowe i Elo obliczono na podstawie opublikowanych wartości.
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Przewaga Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pkt |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pkt |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pkt |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pkt |
Wynik jest niezwykle spójny: Fable 5.1 prowadzi z GPT-5.6 Sol w każdym wierszu bezpośrednio opublikowanym przez Anthropic. Największe różnice pojawiają się w naukowych pracach agentowych i terminalowym kodowaniu, a nie w zwykłym krótkim rozumowaniu.
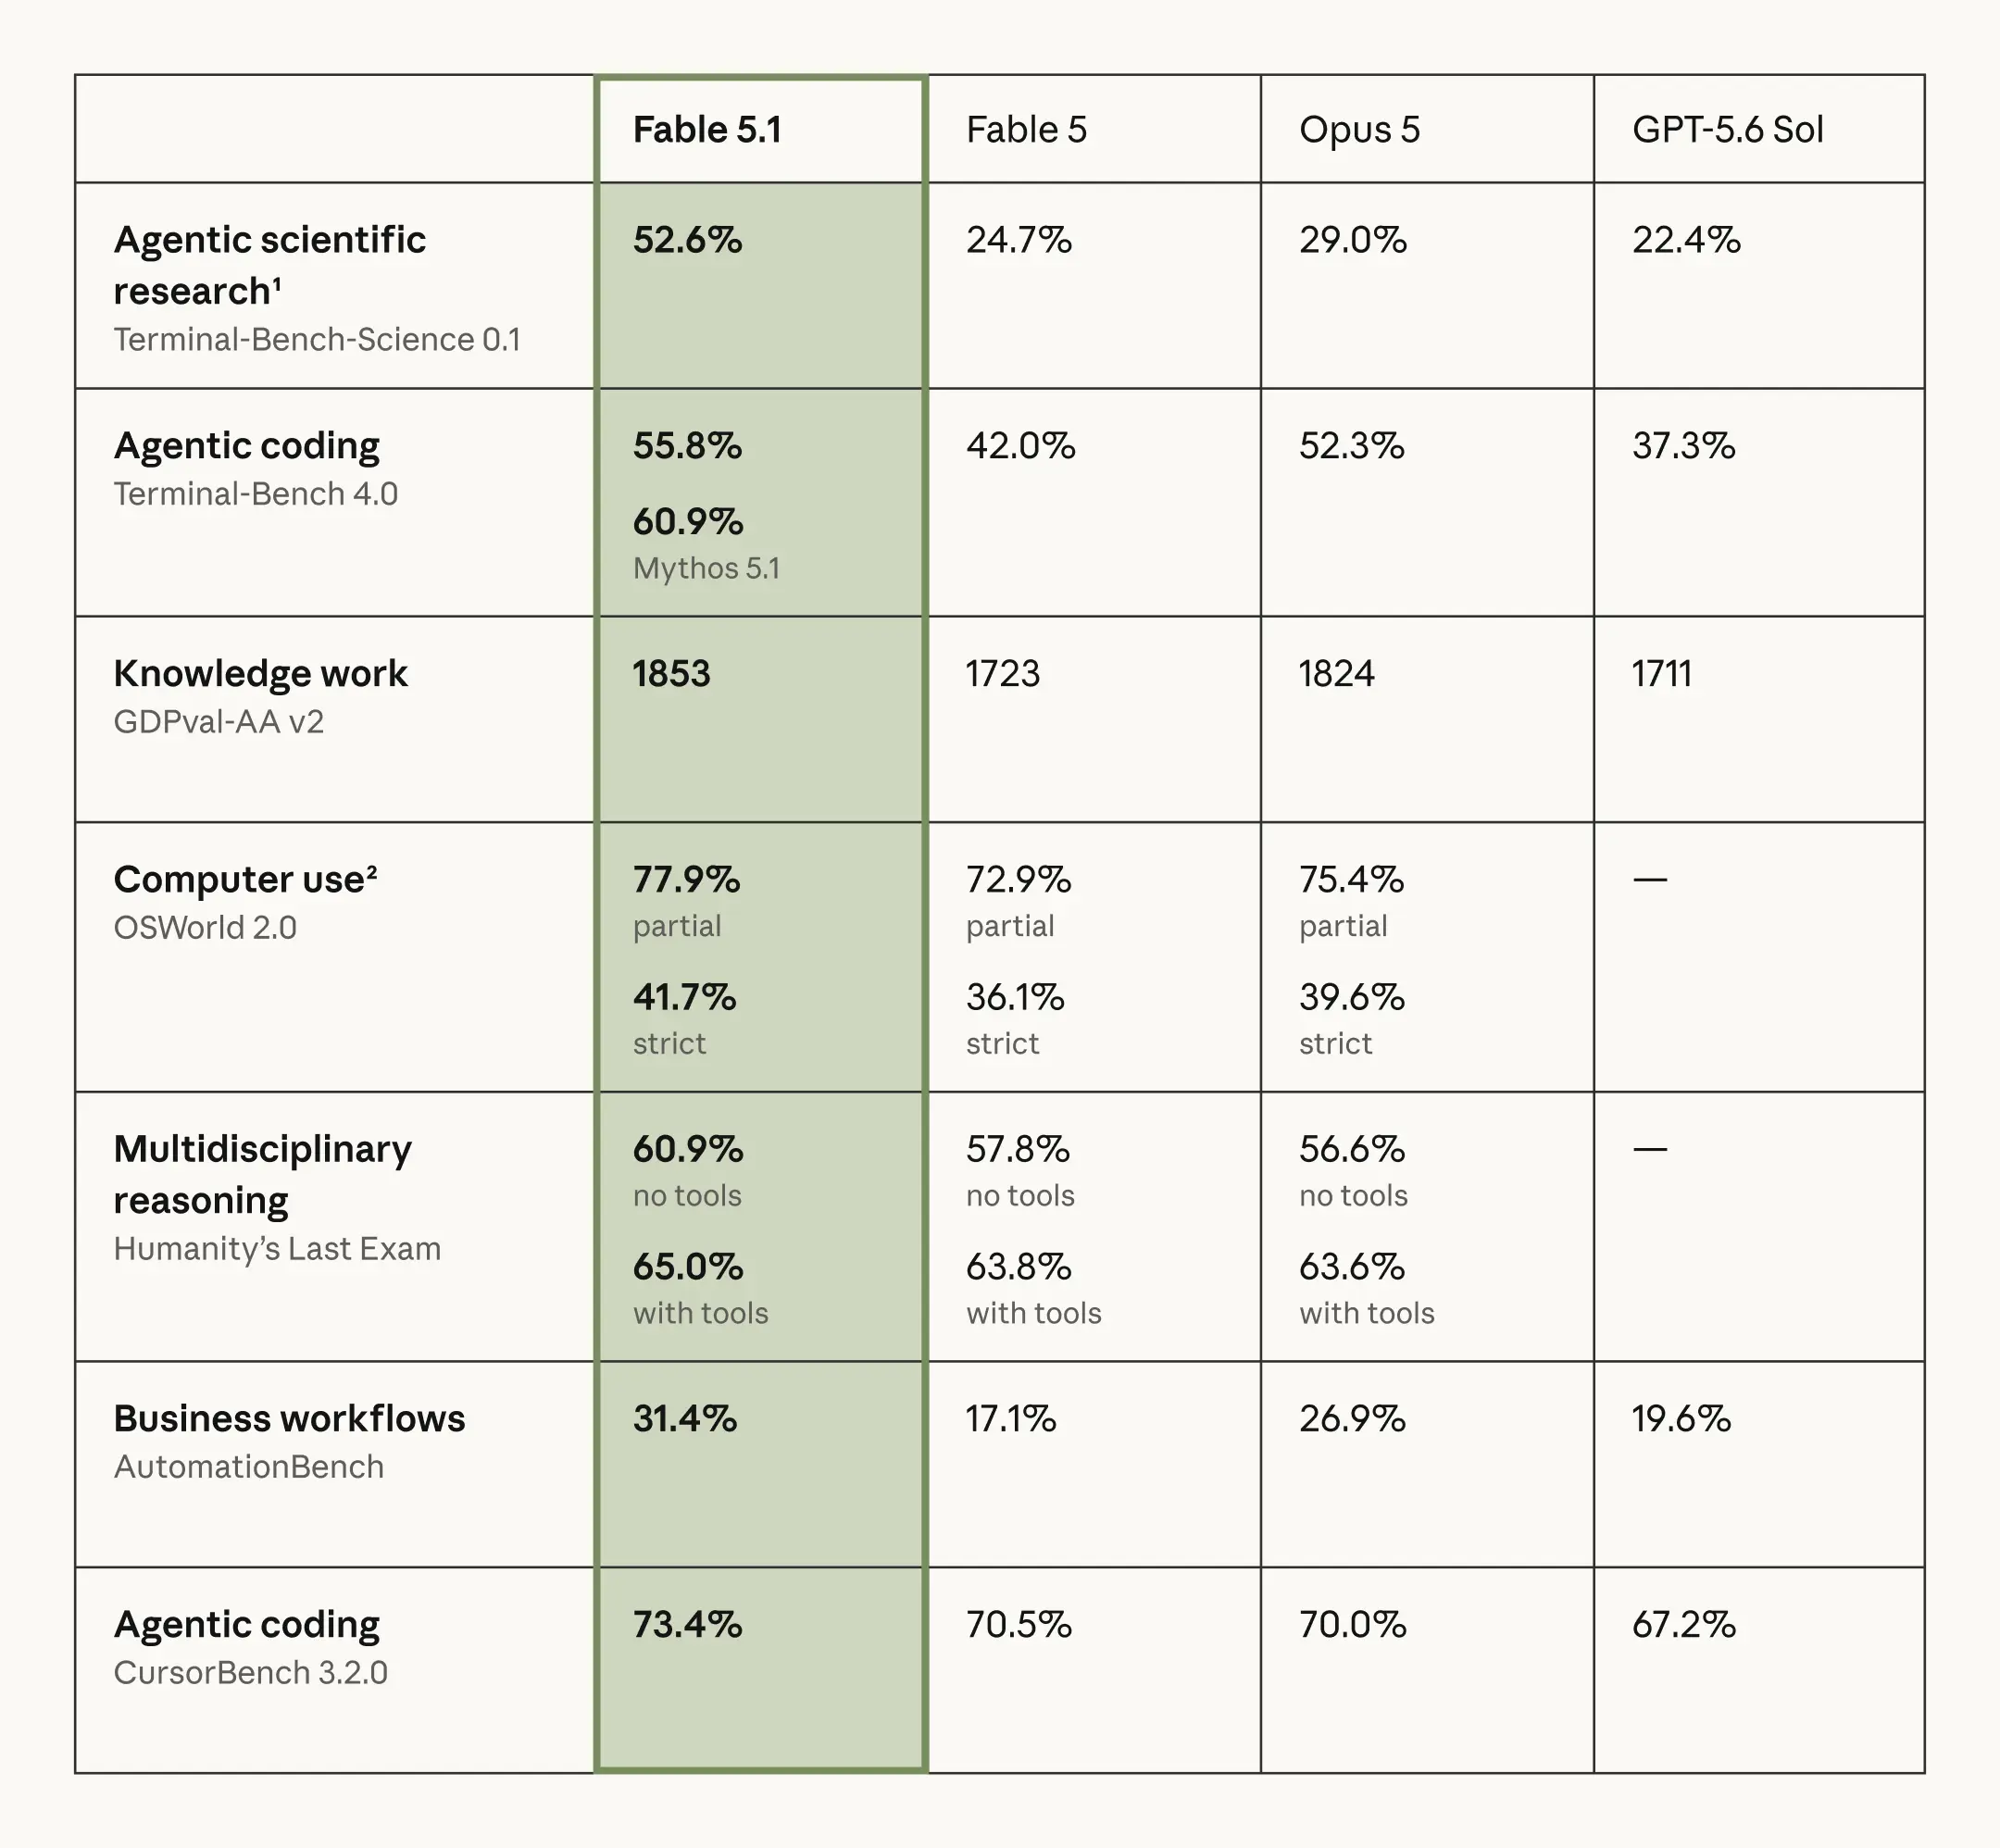
Źródło: Anthropic — oryginalna grafika benchmarkowa.
To ewaluacje prowadzone przez dostawcę: Anthropic testował zarówno swój model, jak i model konkurencji. Zapewniają bezpośrednie dowody porównawcze, ale nie są to testy niezależne. Anthropic raportuje standardowy błąd ±3.5–4.5 punktu procentowego na model w Terminal-Bench-Science; powyższa tabela pokazuje oszacowania punktowe, nie przedziały ufności.
Wyniki dostawcy sprzyjają Fable 5.1, ale niezależne dowody wymagają własnych dat i konfiguracji.
Niezależne benchmarki: oddziel wyniki datowane od pomiarów na żywo
Artificial Analysis wprowadziło Intelligence Index v4.3 7 września, zastępując Terminal-Bench 2.1 przez Terminal-Bench 4.0 i dodając AutomationBench-AA. Wydanie raportowało 53 dla Fable 5.1 i 47 dla GPT-5.6 Sol, co odpowiada zaokrąglonym wynikom pokazanym w porównaniu z 8 września. Tabela odróżnia terminalowe wyniki z publikacji od późniejszej migawki wydajności.
| Niezależna metryka — porównanie AA / wydanie v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Wynik |
|---|---|---|---|
| Intelligence Index v4.3 (8 wrz) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (wydanie 7 wrz) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Szybkość wyjścia (8 wrz) | 69.8 tok/s | 69.9 tok/s | Praktycznie remis |
| Czas do pierwszego tokena (8 wrz) | 132.10 s | 277.47 s | Sol |
| Znormalizowana cena mieszanki tokenów AA / MTok | $3.08 | $7.175 | Sol |
Migawka: 8 września 2026 r., z wyjątkiem wiersza Terminal-Bench z wyraźną datą 7 września. Fable 5.1 używa Adaptive Reasoning, Max Effort, Default Fallback; Sol używa max. Pomiary na żywo mogą się zmieniać. Znormalizowana cena mieszanki tokenów AA używa stosunku 7:2:1 dla cache-hit/input/output; nie jest to koszt każdego żądania API.
OSWorld 2.0 to największa odnotowana przewaga Sol w tym porównaniu: 62.6% wobec 41.7% dla Fable 5.1, przewaga o 20.9 punktu. To równoważy silniejsze wyniki Fable w Intelligence Index i Terminal-Bench.
Dowody wspierają konkretny kompromis: Fable 5.1 ma wyższy Intelligence Index, podczas gdy Sol ma niższy czas do pierwszego tokena i niższą znormalizowaną cenę. Przepustowość wyjścia jest praktycznie równowa. Te pomiary wspierają różne wybory dla wrażliwej na jakość pracy wsadowej i aplikacji interaktywnych.
Datowane niezależne porównanie Terminal-Bench wskazuje w tym samym kierunku co test Anthropic: 52.0% wobec 39.9%, w porównaniu z 55.8% wobec 37.3% u dostawcy. Obie luki nie są zamienne, ponieważ konfiguracje ewaluacji się różnią.
Co wciąż mówią nam benchmarki OpenAI o GPT-5.6 Sol
Ewaluacje startowe OpenAI dostarczają dodatkowego kontekstu dla możliwości GPT-5.6 Sol. Poprzedzają nowsze bezpośrednie wyniki head-to-head omówione powyżej, więc nie należy ich używać jako bezpośredniego porównania z Fable 5.1.
OpenAI raportuje 88.8% na Terminal-Bench 2.1 dla GPT-5.6 Sol. To dowód silnych możliwości agentowego kodowania w konfiguracji startowej; starszej wersji benchmarku nie należy porównywać liczbowo z wynikami Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 w kodowaniu
Do prostego generowania kodu oba modele są nadmiernie wykwalifikowane dla wielu produkcyjnych zastosowań. Różnica staje się wyraźniejsza, gdy kodowanie zamienia się w inżynierię oprogramowania przez agenty: inspekcję dużego repozytorium, edycję wielu plików, uruchamianie poleceń, diagnozowanie błędów, pisanie testów i iterację aż do przejścia zadania.
Tutaj Claude Fable 5.1 ma silniejszy obecny przypadek benchmarkowy. Prowadzi zarówno w vendorowym, jak i niezależnym porównaniu Terminal-Bench 4.0, a wynik CursorBench od Anthropic także mu sprzyja: 73.4% do 67.2%.
W praktycznej ewaluacji kodowania uwzględnij zmiany obejmujące całe repozytorium, testy, review i pracę nad wydajnością. Udany krótki fragment kodu jest słabym substytutem ukończenia zadania obejmującego kilka plików i nieudanych prób.
GPT-5.6 Sol pozostaje atrakcyjny, gdy środowisko wykonawcze ma takie samo znaczenie jak jakość modelu. Natywne wsparcie dla shell execution, apply-patch, code interpreter, file search, computer use i MCP może zredukować ilość infrastruktury orkiestracji, którą musisz samodzielnie zbudować.
Werdykt dla kodowania: wybierz Fable 5.1, gdy Twoje ewaluacje kładą nacisk na najtrudniejszą autonomiczną pracę w repozytorium. Wybierz GPT-5.6 Sol, gdy nieco niższa zdolność benchmarkowa jest akceptowalna w zamian za niższy koszt i szeroki zintegrowany stos wykonawczy.
Kontrole rozumowania i doświadczenie deweloperskie
Oba interfejsy API eksponują inteligencję w różny sposób.
Zakres none–max w Sol pozwala zespołowi testować jakość i opóźnienie na kilku ustawieniach. Niższy wysiłek może ograniczyć pracę rozumowania, ale właściwe ustawienie zależy od kosztu niepowodzenia zadania.
Zawsze włączone adaptacyjne myślenie w Fable czyni strojenie effort innym ćwiczeniem. Porównuj ustawienia, które Twoja aplikacja rzeczywiście wdroży, zamiast traktować identyczne etykiety effort jako identyczne budżety obliczeniowe.
W konsekwencji nie ma uniwersalnie uczciwego porównania między „domyślnym Sol” a „domyślnym Fable”. Ich domyślne konfiguracje rozumowania różnią się. Ewaluacje produkcyjne powinny porównywać albo równoważne budżety effort, albo dokładne ustawienia, które Twoja aplikacja faktycznie wdroży.
GPT-5.6 Sol vs Fable 5.1: Który jest lepszy dla agentów AI?
Wybór zależy od tego, czy wąskim gardłem jest trudne rozumowanie, czy otaczający runtime.
Przewaga Fable w cytowanych benchmarkach terminalowych, automatyzacyjnych i pracy profesjonalnej czyni go rozsądnym kandydatem do najtrudniejszych zadań. Zmierz odsetek ukończeń i odzyskiwanie po błędach, zanim uogólnisz tę przewagę na swojego agenta.
Udokumentowane portfolio narzędzi Responses w GPT-5.6 Sol czyni go atrakcyjnym dla aplikacji opartych na wyszukiwaniu, plikach, wykonywaniu w shellu i patchach. To przewaga integracyjna do oceny obok dokładności zadań, a nie jej substytut.
| Wymaganie agenta | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Twarde rozumowanie długiego horyzontu | Excellent | Best fit |
| Autonomia terminal/repozytorium | Excellent | Stronger evidence |
| Natywne zintegrowane portfolio narzędzi | Stronger | Strong |
| Wymuszone wybranie narzędzia | Supported; check chosen API | Restricted; check tool_choice modes |
| Integracja platformy multi-agent | Strong advantage | Available through agent architecture |
| Komunikacja postępu podczas długich zadań | Good | Core behavior |
| Agenci wysokowydajni wrażliwi na koszty | Better | Premium |
| Powtarzany masywny buforowany kontekst | Good | Potentially very attractive |
Używanie obu może być ekonomiczne, gdy tylko niewielka część zadań wymaga eskalacji. Zmierz, czy dodatkowe udane ukończenia równoważą wyższą cenę i opóźnienie startu drugiego modelu.
Długi kontekst: 1.05M vs 1M to nieistotna różnica
Liczby nagłówkowe wyglądają niemal identycznie: GPT-5.6 Sol oferuje 1.05M tokenów, a Fable 1M. 5% różnicy pojemności raczej nie zadecyduje o tym, czy możesz analizować duże repozytorium, korpus prawny, archiwum badań lub wielogodzinną historię agenta. Oba należą już do klasy milion-tokenowej.
Dla GPT-5.6 Sol wejście powyżej 272K uruchamia wyższe stawki dla długiego kontekstu dla żądania: $8/MTok za wejście, $0.80/MTok za odczyt z cache i $30/MTok za wyjście. Zapisy do cache rosną także z $5 do $10/MTok.
Fable 5.1 utrzymuje standardowe stawki dla kontekstu 1M: $10/MTok za wejście, $50/MTok za wyjście i $0.25/MTok za odczyty cache. W tej udokumentowanej konfiguracji nie ma osobnej premii powyżej 272K.
Rozważ turę z 100K niebuforowanych tokenów wejścia, 900K tokenów odczytanych z cache i 20K łącznych rozliczanych tokenów wyjścia. GPT-5.6 Sol kosztuje 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 kosztuje 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Ta tura ciężka w cache niemal zamyka lukę cenową, ponieważ Fable ma tańsze odczyty cache. Wynik zależy od miksu tokenów w obciążeniu; nie oznacza to, że oba modele kosztują tyle samo dla całej sesji agenta.
Założenia kosztowe: 900K-tokenowy prefiks jest już w cache, a 100K świeżego wejścia nie jest rozliczane jako nowy zapis cache. Szacunek pomija początkowy zapis cache i opłaty za narzędzia. Przydział 20K wyjścia obejmuje wszystkie rozliczane tokeny wyjściowe, w tym ewentualne rozliczane tokeny rozumowania.
Cennik: Sol wygrywa zwykłe obciążenia, Fable wygrywa jeden ważny parametr cache
Przy sprawdzonych stawkach Sol kosztuje $4 za wejście / $20 za wyjście na MTok, z $0.40 za odczyt cache. Fable 5.1 kosztuje $10 za wejście, $50 za wyjście i $0.25 za odczyt cache. Tabela rozdziela ceny dostawców od stawek w GPT-5.6 Sol API w CometAPI oraz Claude Fable 5.1 API w CometAPI.
| Składnik ceny | GPT-5.6 Sol — ceny oficjalne | Claude Fable 5.1 — ceny oficjalne |
|---|---|---|
| Oficjalne wejście / MTok | $4.00 | $10.00 |
| Oficjalne wyjście / MTok | $20.00 | $50.00 |
| Oficjalny odczyt cache / MTok | $0.40 | $0.25 |
| Oficjalny zapis cache / MTok | $5.00 (30 minut) | $12.50 (5 minut) |
| Powyżej 272K wejścia: input / cache read / cache write / output | $8 / $0.80 / $10 / $30 | Te same udokumentowane stawki bazowe |
| CometAPI wejście / MTok | $3.20 | $8.00 |
| CometAPI wyjście / MTok | $16.00 | $40.00 |
Różne czasy retencji zapisów cache: Sol używa domyślnego okresu retencji 30 minut, podczas gdy stawka Fable 5.1 pokazana dotyczy zapisu 5-minutowego. Sprawdź tworzenie, odświeżanie i wygaśnięcie cache u dostawcy i na trasie, których faktycznie używasz.
Przy sprawdzonych stawkach bezpośrednich Fable 5.1 kosztuje 2.5× więcej niż Sol zarówno dla niebuforowanego wejścia ($10 vs $4/MTok), jak i wyjścia ($50 vs $20/MTok). Traktuj te stawki jako porównanie „na daną datę”, bo promocje dostawców i ceny bramek mogą się zmieniać.
Żądanie z krótkim kontekstem z 100K wejścia i 10K łącznego rozliczanego wyjścia kosztuje około $0.60 w Sol lub $1.50 w Fable przy stawkach bezpośrednich. Przy pokazanych stawkach CometAPI ten sam miks kosztuje $0.48 lub $1.20. Przykłady te pomijają zapisy cache i opłaty za narzędzia.
Krótko-kontekstowa stawka odczytu cache w Fable jest o 37.5% niższa: ($0.40 − $0.25) ÷ $0.40. Może to mieć znaczenie dla agentów ponownie używających dużego stałego prefiksu, ale całkowita oszczędność nadal zależy od świeżego wejścia, częstotliwości zapisów i wolumenu wyjścia.
Werdykt cenowy: Sol to tańszy punkt wyjścia dla ruchu ze świeżym kontekstem. Fable staje się bardziej konkurencyjny wraz ze wzrostem udziału odczytów cache; porównuj koszt całej sesji, uwzględniając tworzenie i odświeżanie cache.
Szybkość i opóźnienia
Testy przy maksymalnym wysiłku mogą spędzić znaczący czas na rozumowaniu przed pojawieniem się pierwszego widocznego tokena.
Pomiary przepustowości i opóźnień z 8 września pokazują 69.9 tokenów/s dla Fable i 69.8 dla Sol. Czas do pierwszego tokena to 277.47 s vs 132.10 s. Przepustowość wyjścia jest praktycznie równa; Sol zaczyna produkować widoczne wyjście szybciej w tej konfiguracji.
To pomiary benchmarkowe przy maksymalnym wysiłku, a nie obiecane opóźnienia dla każdego wywołania API. Długość promptu, konfiguracja rozumowania, obciążenie dostawcy, narzędzia i stan cache mogą zmieniać wynik. Czas do pierwszego tokena i pełny czas odpowiedzi to różne metryki.
Dla pracy interaktywnej niższe obserwowane opóźnienie startu może faworyzować Sol. Dla asynchronicznego researchu lub nocnej pracy nad repozytorium pomyślne ukończenie może mieć większe znaczenie niż czekanie na pierwszy token. Benchmarkuj oba modele przy ustawieniach i współbieżności, które zamierzasz używać.
Zabezpieczenia to różnica produkcyjna
Oba modele stosują silniejsze zabezpieczenia, bo ich możliwości sięgają w wrażliwe domeny cyberbezpieczeństwa i naukowe, ale implementują je inaczej.
OpenAI opisuje warstwowe zabezpieczenia i monitoring dla rodziny GPT-5.6. Aplikacje w wrażliwych domenach powinny ocenić odpowiednie zabezpieczenia jako część zachowania wdrożenia.
Zasady przekierowań i retencji Anthropic opisują kierowanie niektórych wrażliwych żądań z zakresu cyberbezpieczeństwa lub biologii do mniej zdolnych modeli, bez naliczania stawki Fable dla tych przekierowanych żądań. Domyślny okres retencji danych to 30 dni, z wyjątkami dla kwalifikujących się układów enterprise.
Dla zwykłego kodowania i pracy wiedzochłonnej te różnice mogą nigdy się nie ujawnić. Dla produktów bezpieczeństwa, obciążeń regulowanych lub wdrożeń wrażliwych na prywatność należą do checklisty ewaluacyjnej obok jakości benchmarków i ceny.
Który model wybrać?
Ogólne porównanie można sprowadzić do kształtu obciążenia.
| Obciążenie | GPT-5.6 Sol | Claude Fable 5.1 | Rekomendacja |
|---|---|---|---|
| Trudne autonomiczne kodowanie | Excellent | Stronger current benchmarks | Fable 5.1 |
| Research długiego horyzontu | Excellent | Core strength | Fable 5.1 |
| API o dużym wolumenie | Much cheaper | Expensive | Sol |
| Interaktywny asystent kodu | Lower measured max-effort TTFT | Higher measured max-effort TTFT | Testuj ustawienia |
| Agent API oparty na narzędziach | Broader native tool stack | Strong | Sol |
| Agent z milionowym kontekstem w cache | Competitive | Very low cache-read price | Testuj oba |
| Maksymalna jakość rozumowania | Excellent | Independent lead | Fable 5.1 |
| Koszt zwykłego żądania | Clear advantage | Premium | Sol |
| Rozumienie obrazów/dokumentów | Strong | Strong | Test na obciążeniu |
| Jednodostawczy stack OpenAI | Natural fit | Requires migration/gateway | Sol |
| Trasowanie niezależne od modelu | Strong | Strong | Użyj obu przez CometAPI |
Polityka trasowania powinna usprawiedliwiać swoją złożoność. Porównaj bazę jednmodelową z polityką „Sol najpierw”, która eskaluje trudne zadania do Fable 5.1, i utrzymuj router tylko wtedy, gdy poprawia koszt udanego zadania przy wymaganej jakości.
Jak porównywać GPT-5.6 Sol i Fable 5.1 przez CometAPI
CometAPI ma już zintegrowane GPT-5.6 Sol i Claude Fable 5.1. Uzyskaj dostęp do obu modeli z ich natywnymi formatami żądań, wyślij ten sam zestaw ewaluacyjny i porównaj zwrócone wyniki przy dopasowanych ustawieniach.
Używaj natywnych formatów żądań dla każdego modelu i utrzymuj stałe prompty, zbiory danych, ustawienia effort, współbieżność i zasady ocen. Powtórz przebiegi; pojedyncze sekwencyjne żądanie na model to za mało, by oszacować wiarygodne opóźnienia lub jakość.
Dla ewaluacji produkcyjnej użyj stałego zestawu promptów, powtarzaj przebiegi w naprzemiennej kolejności, zapisuj ustawienie effort i oceniaj poprawność, wskaźnik przejścia testów, sukcesy narzędzi, ponowienia, użycie tokenów, czas całkowity i całkowity koszt udanego zadania. Stroń każdy model osobno po wspólnej bazie.
Ostateczny werdykt: GPT-5.6 Sol czy Claude Fable 5.1?
Fable 5.1 ma silniejsze bezpośrednie dowody dla najtrudniejszego autonomicznego kodowania i pracy o długim horyzoncie. Prowadzi w pięciu wspólnych wierszach benchmarków dostawcy i datowanym niezależnym teście terminalowym. To czyni go mocnym kandydatem do eskalacji, z zastrzeżeniem walidacji na Twoich własnych zadaniach.
Sol ma niższe zwykłe ceny tokenów, dokładniejsze sterowanie rozumowaniem i szeroki natywny zestaw narzędzi. W sprawdzanej niezależnej konfiguracji przy maksymalnym wysiłku ma też niższy czas do pierwszego tokena; przepustowość wyjścia jest praktycznie równa.
Priorytetyzuj Fable 5.1, gdy o Twoim wskaźniku sukcesów decydują najtrudniejsze zadania autonomiczne. Zacznij od Sol dla oszczędnego inferencjonowania na froncie lub aplikacji mocno opartych na narzędziach. Dla obciążeń interaktywnych przetestuj wdrożone ustawienia effort, by potwierdzić, czy obserwowana przewaga opóźnienia startu się utrzymuje.
Wybierz pojedynczy model, gdy spełnia Twoje wymagania w prosty sposób. Dodaj trasowanie, gdy wyniki ewaluacji pokażą, że przełączanie między nimi poprawia jakość lub koszt udanego zadania.
FAQ
Czy Claude Fable 5.1 jest lepszy niż GPT-5.6 Sol?
W migawce z 8 września ma wyższy niezależny Intelligence Index: 53 wobec 47 dla Sol. Prowadzi także w datowanym niezależnym teście terminalowym. To wspiera przewagę jakości w tych ewaluacjach, ale nie oznacza, że jest lepszy dla każdego obciążenia.
Czy GPT-5.6 Sol jest tańszy niż Claude Fable 5.1?
Dla zwykłego, niebuforowanego ruchu API — tak: sprawdzone stawki bezpośrednie to $4/$20 za MTok dla Sol i $10/$50 dla Fable 5.1. Obciążenia silnie korzystające z cache mogą zawęzić tę lukę, bo Fable ma niższą stawkę odczytu cache. Uwzględnij zapis i wygaśnięcie cache w estymacie.
Który model jest lepszy do kodowania?
Fable 5.1 ma silniejsze dowody benchmarkowe dla autonomicznego kodowania w tym porównaniu. Sol pozostaje atrakcyjny dla tańszych przepływów i dzięki zintegrowanym narzędziom wykonawczym. Użyj zadań na repozytoriach z uruchamialnymi testami, by zdecydować, czy zmierzona luka zdolności ma znaczenie dla Twojej aplikacji.
Który model ma większe okno kontekstu?
Sol technicznie prowadzi 1.05M do 1M tokenów w Fable 5.1, przy maksymalnym wyjściu 128K dla obu. W praktyce próg cenowy Sol powyżej 272K i tanie odczyty cache w Fable zwykle są ważniejsze niż różnica 50K tokenów pojemności.
Czy mogę uzyskać dostęp do obu modeli przez CometAPI?
Tak. GPT-5.6 Sol API w CometAPI i Claude Fable 5.1 API w CometAPI zapewniają wspólny punkt wyjścia dla ewaluacji tekstowych. Sprawdź specyficzne dla trasy wsparcie rozumowania, cache i narzędzi, zanim rozszerzysz bazę do produkcyjnego agenta.