Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: benchmarki, funkcje, ceny
Porównaj GPT-6.1 Terra i DeepSeek V4.1 Flash pod kątem benchmarków, programowania, funkcji wizyjnych, kontekstu, cen API oraz dostępu do CometAPI, aby ustalić, który jest lepszy.
TL;DR: GPT-6.1 Terra to lepszy punkt wyjścia, gdy najważniejsze są jakość rozumowania i złożone przepływy wizualne; DeepSeek V4.1 Flash jest atrakcyjny, gdy priorytetem są koszt tokenów, szybkość generowania lub samodzielne hostowanie. To porównanie wykorzystuje aktualizację DeepSeek z 17 października, Flash-1017.
DeepSeek Flash-1017 ma niższe ceny tokenów, ale koszt ukończonego zadania zależy też od długości rozumowania, liczby ponownych prób i wywołań narzędzi.
Porównanie poniżej obejmuje architekturę, kontekst, rozumowanie, kodowanie, wizję, szybkość, ceny i wdrożenie. Ceny i strony z wynikami na żywo sprawdzono 28 października 2026.
Najważniejsze wnioski
Terra prowadzi w cytowanym niezależnym porównaniu Intelligence Index, co czyni ją logicznym pierwszym kandydatem do wymagających zadań rozumowania.
DeepSeek ma niższe listowane ceny tokenów. Porównuj opóźnienie end-to-end i koszt na udane zadanie, uwzględniając stawki w godzinach szczytu, użycie cache, tokeny rozumowania i ponowne próby.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Oceniaj kod po zaakceptowanych poprawkach, a przepływy wizualne po ukończonych zadaniach. Opublikowane wyniki benchmarków dostarczają użytecznych dowodów, ale konfiguracje testów się różnią.
Terra to hostowany model zastrzeżony. DeepSeek oferuje do pobrania wagi na licencji MIT do samodzielnego hostowania; należy uwzględnić sprzęt i koszty operacyjne.
CometAPI zapewnia wspólny interfejs tekstowy do testowania obu modeli. Przed wdrożeniem sprawdź rozwiązaną wersję modelu oraz wsparcie dla narzędzi, sterowania rozumowaniem i strukturalnego wyjścia.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: przegląd i specyfikacje
Główne różnice specyfikacji dotyczą limitów wyjścia, sterowania rozumowaniem, wywoływania narzędzi i wdrożenia. Tabela poniżej podsumowuje oba modele.
Architektura zastrzeżona; liczba parametrów niejawna
552B Causal Encoder–Decoder MoE; około 8B aktywnych parametrów dla wejścia i 16B dla wyjścia
Okno kontekstu
1,050,000 tokenów
1M tokenów
Maksymalna długość wyjścia
128,000 tokenów
384K tokenów
Modalności wejściowe
Tekst, obrazy
Tekst, obrazy
Modalności wyjściowe
Tekst
Tekst
Sterowanie rozumowaniem
none, low, medium, high, xhigh, max
Przełącznik thinking; low, high, max w Chat Completions
Wywoływanie narzędzi
Obsługiwane przez Responses API
Obsługiwane; zachowanie zależy od endpointu i trybu rozumowania
Otwarte wagi
Nie
Tak, licencja MIT
Architektura i wersje modeli
Terra używa zastrzeżonej architektury, której liczba parametrów nie jest publicznie ujawniona. DeepSeek-V4.1-Flash wykorzystuje architekturę Causal Encoder–Decoder MoE, z różnymi budżetami aktywnych parametrów dla przetwarzania wejścia i generowania wyjścia.
Wydanie V4.1 Flash DeepSeek opisuje szkielet MoE Causal Encoder–Decoder z 552B parametrami, z ~8B parametrów aktywnych podczas przetwarzania wejścia i ~16B podczas generowania wyjścia. Aktualizacja z 17 października poprawia publikowane wyniki w kodowaniu, agentach i wizji.
W całym artykule Flash-1017 oznacza checkpoint z października. Ogólny alias API może później wskazywać inną wersję, więc zapis ewaluacji powinien zawierać faktycznie serwowaną wersję modelu.
Pamięć podręczna KV i wymagania wdrożeniowe
DeepSeek raportuje globalny ślad KV-cache rzędu ~890 bajtów na token, około jednej czwartej w porównaniu z DeepSeek-V4-Flash. Zwiększa to efektywność cache, choć samodzielne hostowanie nadal wymaga znacznych zasobów na wagi modelu. Terra jest dostępna jako usługa hostowana, podczas gdy pobieralne wagi DeepSeek zapewniają dodatkową opcję self-hostingu.
Sterowanie rozumowaniem i wywoływanie narzędzi
Oba modele wspierają przepływy agentowe, ale sterowanie rozumowaniem i wymagania dotyczące wywoływania narzędzi różnią się. Udokumentowane wsparcie wywoływania narzędzi w Terra używa Responses API. Karta modelu DeepSeek opisuje numeryczny wysiłek rozumowania od 1 do 100; sterowanie w hostowanym API należy sprawdzić oddzielnie. Przy przełączaniu modeli dostosuj parametry rozumowania i definicje narzędzi do wybranego endpointu.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: wydajność
Poniższe porównanie obejmuje rozumowanie, kodowanie, wizję oraz zadania z długim kontekstem. Niezależne ewaluacje i benchmarki raportowane przez dostawców są oznaczone osobno, a wyniki interpretowane wraz z konfiguracjami modeli i frameworkami agentów.
Rozumowanie i wiedza
Artificial Analysis raportuje wynik Intelligence Index v5.0 na poziomie 51 dla GPT-6.1 Terra (Max) i 32 dla DeepSeek Flash-1017 (Max) w cytowanych konfiguracjach, na dzień 28 października 2026. Indeks łączy dziewięć ewaluacji.
Wyższy wynik Terra wspiera testowanie jej w pierwszej kolejności w wymagających zadaniach rozumowania. Dla węższych zastosowań DeepSeek może być lepszym wyborem, jeśli osiąga wymaganą dokładność przy niższym koszcie na udane zadanie.
Oficjalne benchmarki kodowania i agentów
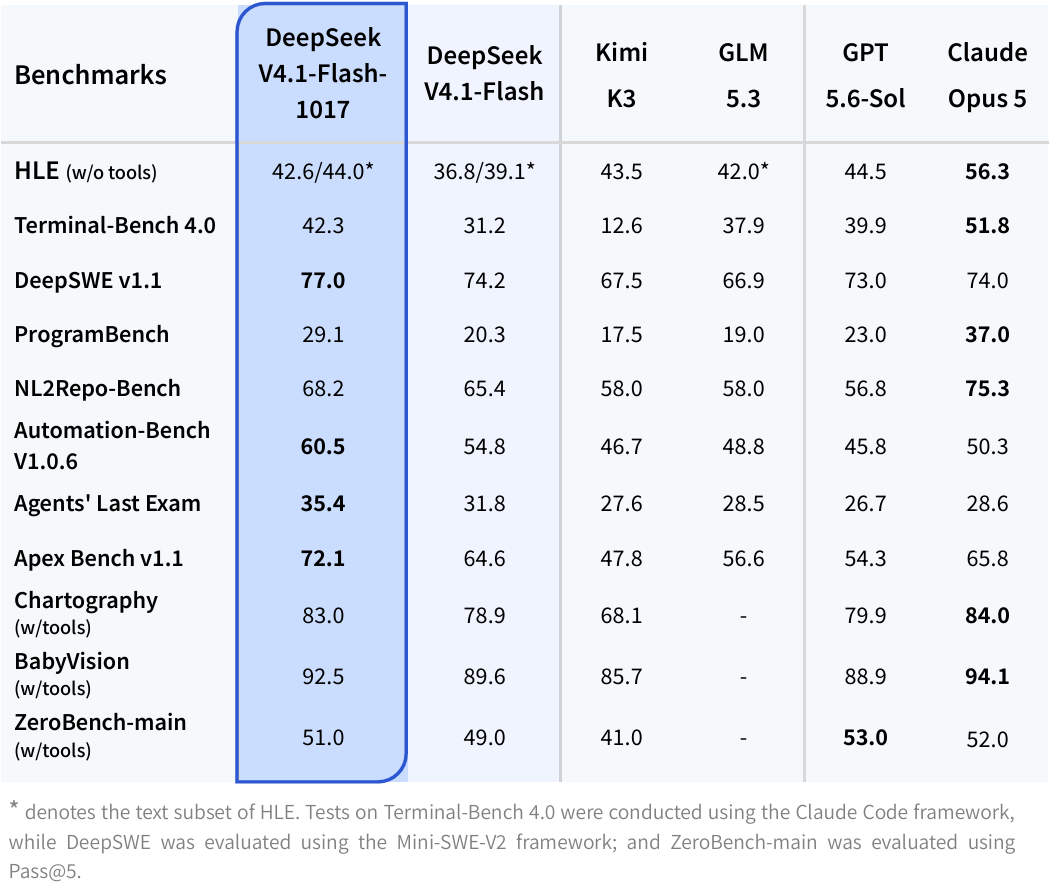
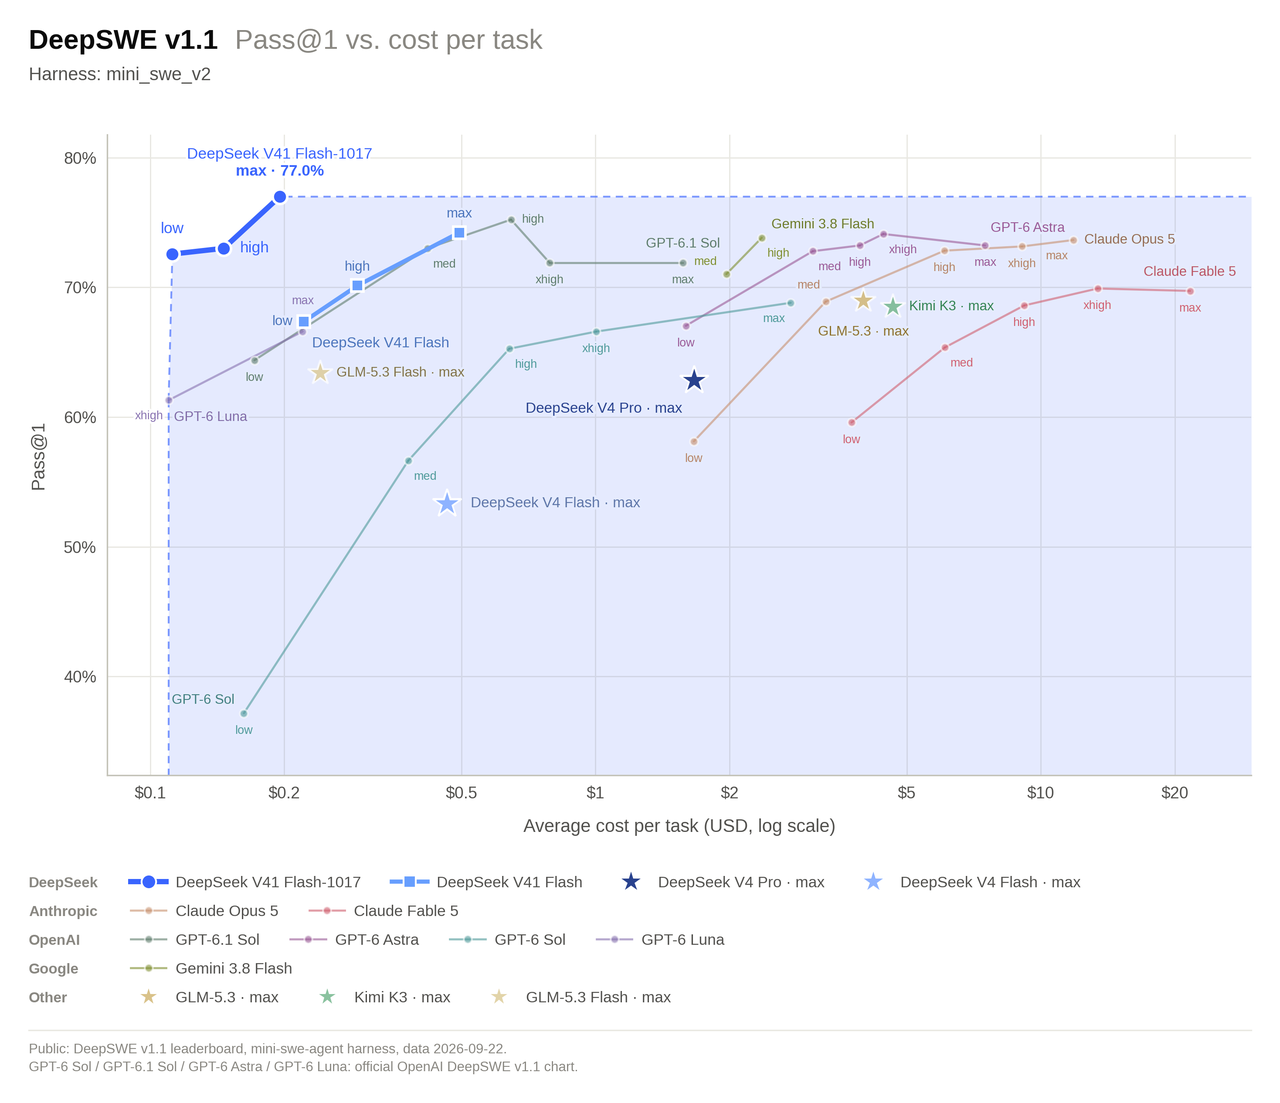
Terminal-Bench 4.0 i DeepSWE v1.1 dostarczają dowodów dotyczących wydajności w kodowaniu i pracy agentów. Porównując wyniki dostawców, zidentyfikuj dokładną wersję modelu, ustawienie rozumowania, framework agenta i metrykę oceny; różnice w tych ustawieniach mogą istotnie wpływać na wyniki.
W praktycznej pracy z kodem porównuj, czy każdy model generuje poprawki przechodzące istniejące testy, zachowujące publiczne interfejsy, obsługujące przypadki brzegowe i unikające niepowiązanych zmian. Niezawodność wywołań narzędzi i odzyskiwanie po błędach wykonania również wpływają na zakres pracy, jaką agent potrafi ukończyć.
Niższe listowane ceny tokenów DeepSeek czynią go użytecznym kandydatem do powtarzalnej konserwacji repozytoriów z jasnymi kryteriami akceptacji. Przy złożonych zmianach porównuj oba modele pod kątem zaakceptowanych poprawek, całkowitego kosztu zadania i czasu ręcznych korekt.
Wizja i obsługa komputera
Oba modeli przyjmują obrazy jako wejście, ale rozumienie obrazów i interakcja z pulpitem wymagają różnych zdolności. Materiały premierowe Terra od OpenAI omawiają MMMU-Pro i OSWorld 2.1, podczas gdy karta modelu DeepSeek raportuje zadania wizualne, w tym Chartography i BabyVision, z ustawieniami wspomaganymi narzędziami.
W ekstrakcji dokumentów porównuj trafność pól, brakujący tekst i strukturę tabel. W automatyzacji pulpitu porównuj ukończone przepływy, błędne działania i odzyskiwanie po zmianach interfejsu. Model, który dokładnie opisuje zrzut ekranu, może wciąż mieć trudności z obsługą pokazywanej aplikacji.
Wybieraj zależnie od przepływu: w przetwarzaniu dokumentów najważniejsza jest dokładność ekstrakcji, podczas gdy w agentach do obsługi komputera ważniejsze są niezawodne akcje i odzyskiwanie. Koszt porównuj dopiero po tym, jak oba modele spełnią wymagany próg jakości.
Rozumowanie i wyszukiwanie w długim kontekście
Oba modele wspierają przepływy z długimi dokumentami, ale sama pojemność kontekstu nie determinuje jakości wyszukiwania. Porównuj je na tej samej kolekcji dokumentów, umieszczając ważne dowody na początku, w środku i na końcu.
Oceniaj trafność odpowiedzi, fragmenty wspierające, spójność między dokumentami i kompletność odpowiedzi. Do badań i analizy dokumentów preferuj model, który niezawodnie wyszukuje i łączy istotne dowody w ramach wymagań dot. opóźnień i kosztów.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: szybkość
Przepustowość wyjścia i czas ukończenia zadania
Opóźnienie zasługuje na osobne potraktowanie względem jakości rozumowania.
Na stronach Artificial Analysis z 28 października, prędkość wyjścia Flash-1017 (Max) wynosi 173.4 tokenów na sekundę, a prędkość wyjścia Terra (Max) to 90.9. Te pomiary opisują serwowane konfiguracje u ewaluatora, a nie gwarantowane stawki u każdego dostawcy.
Model, który generuje tokeny szybciej, wciąż może kończyć wolniej, jeśli produkuje więcej rozumowania, czeka na narzędzia lub wykonuje ponowne próby. Mierz czas do pierwszego tokena, całkowity czas ukończenia i opóźnienie do zadania zaakceptowanego — osobno.
Opóźnienia interaktywne na Twojej trasie API
Dla produktu interaktywnego przetestuj krótkie i długie prompty przy realistycznej współbieżności i zanotuj medianę oraz 95. percentyl opóźnień. W wynikach zachowaj region, trasę API, cache promptów, ustawienia rozumowania i politykę ponownych prób. Taki zapis powie więcej o doświadczeniu użytkownika niż pojedyncza liczba tokenów na sekundę.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: koszt
Cennik to jedna z najjaśniejszych różnic między tymi modelami.
Cennik Terra i polityka cenowa DeepSeek dają następujące stawki pierwszopartyjne, sprawdzone 28 października 2026. Wszystkie ceny w USD za milion tokenów.
Oficjalne stawki API
Kategoria tokenów
GPT-6.1 Terra Standard
DeepSeek Flash poza szczytem
DeepSeek Flash w szczycie
Wejście, brak trafienia w cache
$1.00
$0.15
$0.30
Wejście, trafienie w cache
$0.05
$0.003
$0.006
Wyjście
$5.00
$0.60
$1.20
Ceny DeepSeek w szczycie obowiązują od poniedziałku do piątku, 01:00–04:00 i 06:00–10:00 UTC, z wyłączeniem chińskich świąt państwowych. To odpowiada 09:00–12:00 i 14:00–18:00 czasu CST (UTC+8). Poza tymi okresami stosowane są stawki poza szczytem.
Dla żądań Terra powyżej 272,000 tokenów wejściowych OpenAI określa 2× stawkę za wejście i wejście z cache oraz 1.5× stawkę za wyjście dla całego żądania. Porównaj te warunki z faktycznymi rozmiarami promptów, zanim potraktujesz cenę bazową jako cenę efektywną.
Stawki CometAPI
Stawka bazowa CometAPI za 1M tokenów
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Wejście bez cache
$0.80
$0.12
Wyjście
$4.00
$0.48
Wejście z cache
Nie określono osobno
$0.0024
Mnożnik zależny od czasu
Nie określono w cenach bazowych
2× w wymienionych oknach szczytu
CometAPI wymienia okna szczytu DeepSeek jako poniedziałek–piątek, 01:00–04:00 i 06:00–10:00 UTC. Podany harmonogram nie ustanawia tego samego wyjątku świątecznego, co polityka pierwszopartyjna DeepSeek. Sprawdź warunki rozliczeń wybranej trasy dla planowanego czasu wykonania.
Przykład kosztu dla stałej liczby tokenów
Rozważ żądanie zużywające 100,000 tokenów wejściowych bez cache i generujące 10,000 tokenów wyjściowych.
Jeśli są to pełne rozliczane sumy tokenów, opłata za tokeny wynosi $0.150 dla Terra, $0.021 dla DeepSeek poza szczytem lub $0.042 dla DeepSeek w szczycie. Redukcja poza szczytem to 86%. Przykład nie obejmuje dodatkowych opłat za narzędzia, infrastruktury i ponownych prób; wszelkie oddzielnie liczone tokeny rozumowania również muszą wejść do kalkulacji.
Przy podanych stawkach bazowych CometAPI te same 100,000 wejść i 10,000 wyjść kosztują $0.120 dla Terra lub $0.0168 dla Flash. Zastosowanie wymienionego mnożnika 2× w szczycie daje $0.0336 dla Flash. To kalkulacje samych tokenów przy użyciu podanych liczb, a nie pomiary rzeczywistego zadania.
Gdy dodatkowe wyjście niweluje przewagę cenową tokenów
Utrzymaj 100,000 tokenów wejściowych bez cache i 10,000 rozliczanych tokenów wyjścia Terra. Standardowy rachunek tokenowy Terra wynosi wtedy $0.150. Flash osiąga ten sam rachunek przy 225,000 rozliczanych tokenach wyjścia poza szczytem lub 100,000 w stawkach szczytowych. Ta arytmetyka izoluje wolumen wyjścia; cache, powtarzane wejścia, opłaty za narzędzia i ponowne próby zmieniają porównanie.
Koszt na pomyślnie zrealizowane zadanie
Oceń stałą partię zadań i podziel wszystkie rozliczone wydatki API i narzędzi przez liczbę zadań, które przeszły Twoje kryteria akceptacji. Policzyć należy także wydatki na nieudane próby. Raportuj wskaźnik sukcesu obok tego kosztu, aby model nie był nagradzany za ukończenie tylko najłatwiejszych prac.
Koszt na pomyślnie zrealizowane zadanie = Całkowity koszt API i narzędzi / Pomyślnie ukończone zadania
Co wybrać: GPT-6.1 Terra czy DeepSeek-V4.1-Flash?
Wybieraj zgodnie z wymaganiami jakościowymi zadania, celami kosztowymi i potrzebami wdrożenia. Użyj powyższych wyników benchmarków, aby zdecydować, który model przetestować jako pierwszy.
Zastosowanie
Kandydat startowy
Co powinno zdecydować o wyborze
Wymagające rozumowanie
GPT-6.1 Terra
Dokładność i praca korekcyjna na reprezentatywnych trudnych zadaniach
Agenci do kodowania
Testuj oba
Zaakceptowane poprawki, testy regresji, awarie narzędzi i całkowity koszt
Złożone przepływy wizualne
GPT-6.1 Terra
Ukończone przepływy i odzyskiwanie po błędach interfejsu
Ekstrakcja tekstu/obrazów na dużą skalę
DeepSeek Flash-1017
Czy dokładność ekstrakcji spełnia wymagany próg
Wyszukiwanie w długich dokumentach
Testuj oba
Wyszukiwanie dowodów i dokładność odpowiedzi w różnych pozycjach wejścia
Samodzielne hostowanie
DeepSeek Flash-1017
Dostępny sprzęt, koszty operacyjne i kontrola nad wagami
Aplikacje interaktywne
Testuj oba
Mediana i ogon opóźnień na wybranej trasie u dostawcy
Kiedy wybrać GPT-6.1 Terra
Priorytetyzuj Terra w ewaluacji, gdy złożone rozumowanie jest centralne dla zadania. Dla wymagających przepływów wizualnych lub obsługi komputera uwzględnij ją w zestawie testowym i mierz ukończone zadania, błędy oraz odzyskiwanie.
Kluczowe pytanie brzmi, czy Terra zmniejsza liczbę nieudanych prób i ręcznych korekt na tyle, by uzasadnić wyższą cenę tokenów.
Kiedy wybrać DeepSeek-V4.1-Flash
Zacznij od DeepSeek-V4.1-Flash w przypadku powtarzalnych, wysokowolumenowych zadań z jasnymi kryteriami akceptacji i ostrymi celami kosztowymi. Wybierz go, jeśli wyniki spełniają Twoje wymagania jakościowe przy niższym koszcie na udane zadanie.
Wagi DeepSeek na licencji MIT czynią go również właściwą opcją, gdy wymagane jest samodzielne hostowanie. W tej decyzji uwzględnij koszty sprzętu i operacyjne.
Kiedy testować oba modele
Testuj oba, gdy krytyczne są jakość kodu, niezawodność narzędzi, opóźnienia lub dokładność w długich dokumentach. Używaj reprezentatywnych zadań z tymi samymi wejściami, narzędziami, limitami wykonania i kryteriami akceptacji.
Porównaj odsetek pomyślnie ukończonych zadań, całkowity koszt na udane zadanie, opóźnienie end-to-end i czas ręcznych korekt. Zapisz wersję modelu i ustawienia rozumowania, aby wyniki dało się odtworzyć.
Hybrydowe podejście może uruchamiać rutynowe zadania w DeepSeek i eskalować wybrane niepowodzenia do Terra. Zmierz koszt i skuteczność całego przepływu, aby potwierdzić, że dodatkowe wywołanie modelu jest opłacalne.
Gdzie uzyskać dostęp do GPT-6.1 Terra i DeepSeek V4.1 Flash?
Użyj hostowanego API OpenAI dla Terra lub hostowanego API DeepSeek dla Flash. Potwierdź bieżący identyfikator modelu, limity konta i obsługiwany endpoint przed integracją. Pobieralne wagi Flash-1017 zapewniają osobną opcję self-hostingu.
Dostęp przez CometAPI
CometAPI zapewnia interfejs kompatybilny z OpenAI, co może uprościć tworzenie aplikacji wielomodelowych.
Użyj GPT-6.1 Terra API i DeepSeek V4.1 Flash API ze wspólnym klientem tekstowym, a następnie dodaj sterowanie specyficzne dla modelu dopiero po sprawdzeniu wsparcia wybranej trasy.
Porównaj odpowiedzi tekstowe przez CometAPI
Aby wypróbować oba modele jednym klientem tekstowym, użyj OpenAI Python SDK z kluczem CometAPI i endpointem https://api.cometapi.com/v1. Przechowuj klucz w zmiennej środowiskowej, a następnie wyślij ten sam prompt do tras gpt-6.1-terra i deepseek-v4.1-flash i porównaj zwrócone odpowiedzi oraz wykorzystanie tokenów.
Na przykład poproś każdy model o przegląd workflow płatności, który ponawia żądania po upłynięciu limitu czasu bez klucza idempotencyjnego i loguje pełne treści żądań. Porównaj, jak jasno odpowiedzi identyfikują ryzyka niezawodności i prywatności oraz wyjaśniają praktyczne poprawki. Wspólny prompt ułatwia inspekcję odpowiedzi, ale domyślne żądanie tekstowe nie wyrównuje budżetów rozumowania ani nie ustanawia rankingu wydajności. Potwierdź checkpoint serwowany przez każdą trasę, zanim potraktujesz wynik jako dowód dotyczący Flash-1017.
Wniosek
GPT-6.1 Terra oferuje obecnie silniejszy zbiorczy wynik w rozumowaniu, podczas gdy DeepSeek Flash-1017 łączy niższe ceny tokenów, szybciej mierzone generowanie wyjścia i wdrożenie z otwartymi wagami. Użyteczny wybór to model, który spełnia Twoje wymagania jakości i opóźnień przy najniższym całkowitym koszcie.
Zacznij od reprezentatywnego obciążenia, utrzymaj stałe środowisko narzędzi i kryteria akceptacji, i porównaj koszt pomyślnych ukończeń. Wspólna integracja tekstowa CometAPI może to ułatwić, choć funkcje specyficzne dla modeli wciąż wymagają własnej konfiguracji.
FAQ
Dlaczego to samo zadanie może generować różne rachunki za tokeny w Terra i Flash-1017?
Tekstowy prompt nie musi składać się z tej samej liczby tokenów w dwóch modelach. Wygenerowane odpowiedzi i długość rozumowania także mogą się różnić. Porównuj użycie raportowane przez każdą trasę dla identycznych zadań, uwzględniając tokeny rozumowania w cache i rozliczane, tam gdzie są raportowane, zamiast przykładać oba cenniki do jednej szacowanej liczby tokenów.
Czy GPT-6.1 Terra i DeepSeek V4.1 Flash mogą współdzielić cache promptów?
Możesz ponownie używać tekstu promptu w swojej aplikacji, ale nie zakładaj, że cache utworzony dla jednego modelu lub dostawcy zmniejszy rachunek u drugiego. Kwalifikowalność i rozliczanie cache są specyficzne dla trasy. Sprawdzaj pola usage w odpowiedziach i testuj powtórzone żądania, zanim wpiszesz oszczędności do prognoz.
Jak weryfikować strukturalne wyjście z Terra i Flash-1017?
Zdefiniuj wymagane pola i typy w swojej aplikacji przed wyborem modelu. Jeśli trasa oferuje JSON lub wyjście ograniczone schematem, zweryfikuj dokładny tryb, jaki wspiera, a następnie sparsuj odpowiedź i zwaliduj ją względem schematu. Traktuj brakujące pola, nieprawidłowe wartości, ucięte wyjście i odmowy jako oddzielne wyniki. Sam poprawny JSON nie dowodzi, że wyekstrahowane fakty są prawidłowe.