Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
GPT-6.1 Terra vs GPT-6.1 Sol: benchmarki, ceny i który wybrać
Porównaj GPT-6.1 Terra i GPT-6.1 Sol pod kątem oficjalnych benchmarków, zdolności rozumowania, cen API oraz praktycznych obciążeń roboczych, z przykładowym kodem w Pythonie dla CometAPI.
lesileZespół badań AI modeli i API
Zaktualizowano Oct 28, 2026 12 min czyt.
Najpierw odpowiedź
Porównaj GPT-6.1 Terra i GPT-6.1 Sol pod kątem oficjalnych benchmarków, zdolności rozumowania, cen API oraz praktycznych obciążeń roboczych, z przykładowym kodem w Pythonie dla CometAPI.
Użyj tego podsumowania, aby szybko poznać odpowiedź, a potem przeczytaj przewodnik dla kontekstu, przykładów i szczegółów implementacji.
Zacznij od GPT-6.1 Terra w zadaniach o dużej skali, możliwych do weryfikacji i wrażliwych na koszty. Oceń GPT-6.1 Sol w przypadku złożonego kodowania, wieloetapowego użycia narzędzi i przepływów pracy, w których błędy są kosztowne. Praktycznym domyślnym podejściem jest najpierw użyć Terra, a następnie eskalować do Sol, gdy zawiodą z góry zdefiniowane testy lub kontrole walidacyjne.
Najważniejsze wnioski
Standardowe ceny tokenów: W OpenAI Standard Terra kosztuje $1 za milion tokenów wejściowych i $5 za milion tokenów wyjściowych; Sol odpowiednio $2 i $10.
Wydajność zależna od zadania: Przy maksymalnym wysiłku rozumowania Terra minimalnie prowadzi w Agents’ Last Exam v1 i Terminal-Bench-Science 0.1, podczas gdy Sol prowadzi w Terminal-Bench 4.0 i OSWorld 2.1.
Wspólna pojemność kontekstu: Oba modele oferują okno kontekstu o wielkości 1.05 mln tokenów i przyjmują dane wejściowe w postaci tekstu oraz obrazów.
Różne sterowanie rozumowaniem: Terra pozwala wyłączyć rozumowanie ustawieniem ; Sol wymaga co najmniej wysiłku rozumowania.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
none
low
Koszt operacyjny ma znaczenie: Porównuj wydatki na jedno pomyślnie ukończone zadanie, wliczając ponowne próby i wywołania narzędzi, a koszty przeglądu przez człowieka śledź oddzielnie.
GPT-6.1 Terra vs GPT-6.1 Sol: Przegląd i specyfikacje
Poniższy przegląd podsumowuje kompromisy. Szczegółowe sekcje wyjaśniają dowody, założenia rozliczeniowe i ograniczenia stojące za każdym wyborem.
GPT-6.1 Terra: Wydajne przepływy wizualne i agentowe
OpenAI wprowadziło GPT-6.1 Terra 26 października 2026 r. Łączy rozumowanie wizualne, obsługę komputera i uniwersalne generowanie tekstu dla rutynowych profesjonalnych przepływów pracy. Niższe stawki za tokeny czynią go użytecznym punktem wyjścia, gdy zadania są częste, a wyniki można sprawdzać.
GPT-6.1 Sol: Złożone kodowanie i profesjonalne rozumowanie
GPT-6.1 Sol zadebiutował 29 września 2026 r. Jest skierowany do wymagającego kodowania i profesjonalnych zadań. Warto go ocenić, gdy dodatkowa zdolność rozumowania jest cenna przy nieznanym repozytorium, długim łańcuchu zależnych działań lub kosztownych poprawkach.
Kontekst, rozumowanie i specyfikacje API
Funkcje API: Oba modele obsługują Structured Outputs, streaming i Batch API. Wywoływanie narzędzi używa Responses API, a fine-tuning nie jest obsługiwany. Sprawdź, czy wybrany dostawca i endpoint oferują funkcje potrzebne Twojej aplikacji.
Oba modele pozwalają na maksymalnie 128,000 tokenów wyjściowych w ramach okna kontekstu 1,050,000 tokenów. Zarezerwowanie pełnego limitu wyjścia pozostawia 922,000 tokenów na resztę wymiany, w tym Twoje wejście, instrukcje systemowe i historię narzędzi. To kalkulacja planistyczna, a nie odrębny, stały limit wejścia.
Ujawnienie architektury: Powiązane publiczne specyfikacje modeli nie dostarczają wystarczających szczegółów wewnętrznej architektury do wiarygodnego porównania. Pojemności kontekstu i ustawień rozumowania nie należy traktować jako dowodu liczby parametrów czy architektury.
Sterowanie rozumowaniem: Ustawienie none w Terra jest przydatne dla prostych transformacji i ekstrakcji. Do pierwszego porównania użyj tego samego wspieranego ustawienia rozumowania w obu modelach, a następnie dostrajaj każdy model zgodnie z jakością i latencją, jakich wymaga Twój przepływ pracy.
Oba modele mają tę samą opublikowaną pojemność kontekstu, ale nie implikuje to identycznej dokładności retrievalu ani jakości rozumowania w długim kontekście. Wybór modelu powinien zatem uwzględniać jakość rozumowania, efektywność przepływu pracy, koszt i zależną od zadania skuteczność wyszukiwania w długim kontekście.
GPT-6.1 Terra vs GPT-6.1 Sol: Wydajność
Zgłoszone wyniki są mieszane: Terra minimalnie prowadzi w niektórych ewaluacjach agentów i naukowego kodowania, podczas gdy Sol uzyskuje wyższe wyniki w ogólnym kodowaniu terminalowym, automatyzacji pulpitu i wizji. Poniższe porównania oddzielają wyniki premierowe OpenAI od niezależnych ewaluacji i wyjaśniają, co mogą — i czego nie mogą — powiedzieć o wydajności produkcyjnej.
Oficjalne wyniki benchmarków i warunki testów
Poniższe wyniki pochodzą z ewaluacji premierowych Terra od OpenAI. Terra pokazana jest przy średnim i maksymalnym wysiłku rozumowania; Sol pokazany jest przy maksymalnym wysiłku. Ostatnia kolumna porównuje wyłącznie konfiguracje z maksymalnym wysiłkiem.
OSWorld używa offline’owej ewaluacji 2.1. Test faktograficzności używa wewnętrznych promptów OpenAI zaprojektowanych do wywoływania błędów. To wyniki raportowane przez dostawcę z konkretnych ustawień ewaluacji, a nie pomiary Twojego produkcyjnego obciążenia.
Wszystkie wyniki to wartości procentowe; różnice wyrażono w punktach procentowych (pp). Niżej jest lepiej tylko dla wskaźnika błędów faktograficznych. Sama różnica 0.1 punktu w wskaźniku błędów nie stanowi istotnej przewagi niezawodności.
Dla inżynierii oprogramowania przewaga Sol w Terminal-Bench i wąska przewaga Terra w Terminal-Bench-Science sugerują, że wyniki zależą od rodzaju zadania kodowania. Dla przepływów aplikacyjnych wyższy wynik Sol w OSWorld wspiera jego ocenę pod kątem automatyzacji pulpitu, podczas gdy wynik Terra w Agents’ Last Exam czyni go kandydatem do profesjonalnych zadań agentowych. Żaden z wzorców nie ustanawia uniwersalnego zwycięzcy.
Scaffolding agentów, dostęp do narzędzi i konfiguracja środowiska mogą wpływać na te wyniki. Użyj tych liczb do wskazania kandydatów do testów, a następnie zweryfikuj je na tle zmian w repozytorium i przepływów aplikacji, które faktycznie musisz zrealizować.
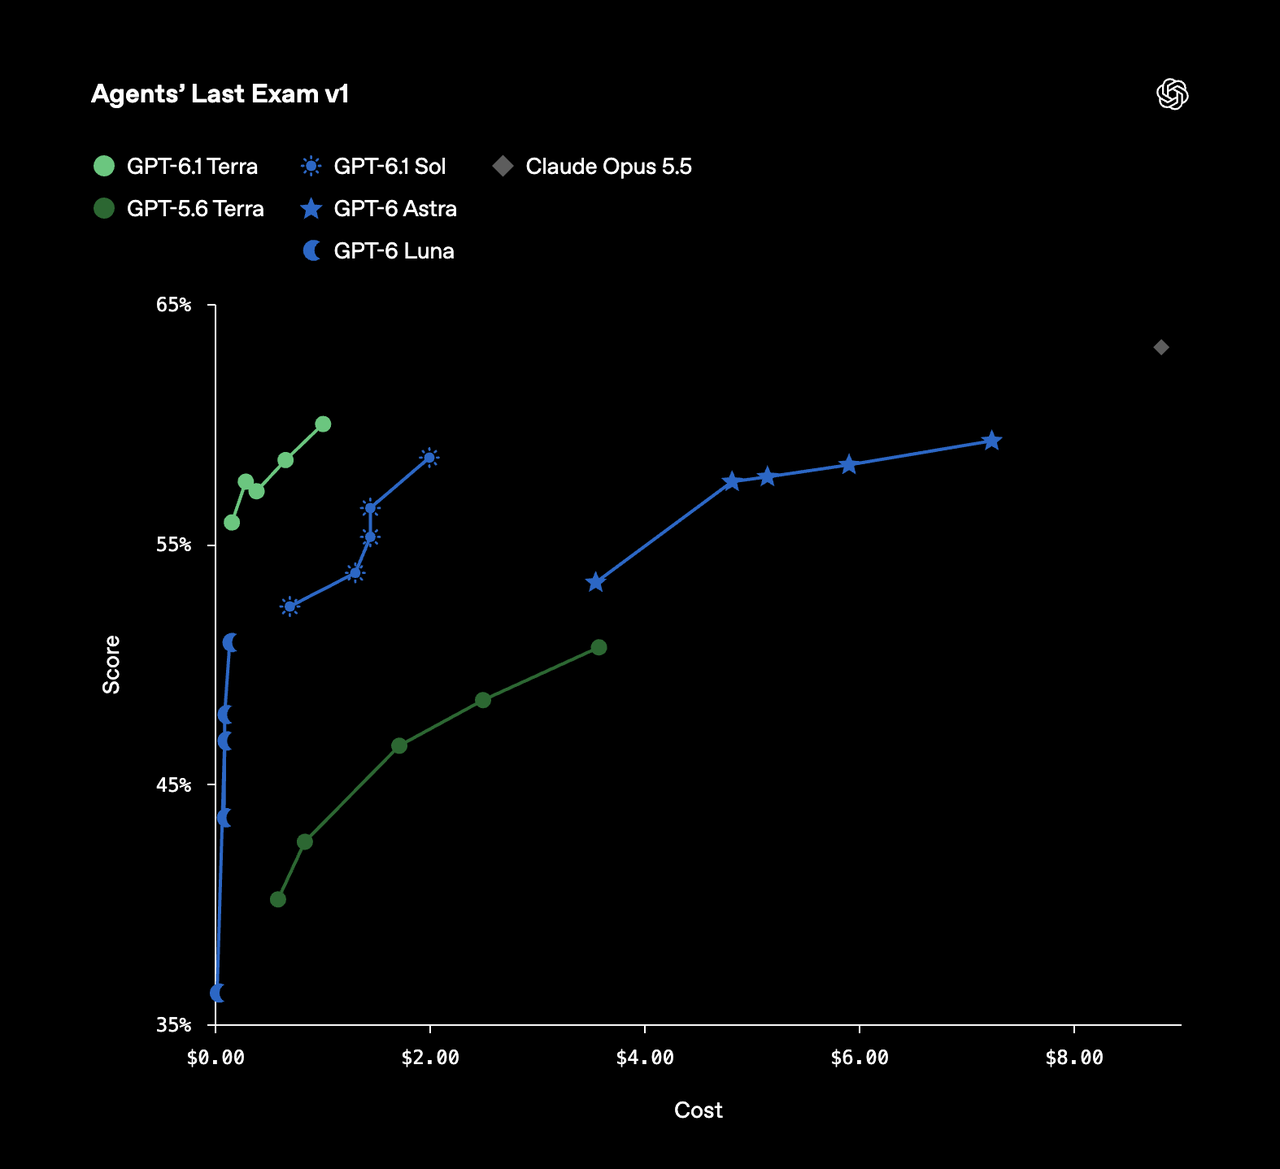
Wykres OpenAI dla Agents’ Last Exam v1 nanosi wyniki względem szacowanych kosztów zadań w różnych konfiguracjach modeli. Dodaje perspektywę efektywności kosztowej do tabeli powyżej; przedstawione koszty są specyficzne dla ustawień ewaluacji.
Niezależne ewaluacje inteligencji i kodowania
Październikowa ewaluacja Artificial Analysis z 26 dnia umieszcza Terra o cztery punkty poniżej Sol na jego Intelligence Index przy maksymalnym wysiłku rozumowania. Coding Agent Index v2.0 przyznaje Terra 48, a Sol 54. To odrębne ewaluacje z własnymi metodami i skalami punktacji; nie należy ich łączyć liczbowo z wynikami benchmarków OpenAI.
Ta sama analiza wskazuje, że ustawienia niskiego i średniego wysiłku rozumowania w Terra są szczególnie efektywne kosztowo w ewaluacji inteligencji. Wspiera to testowanie praktycznych konfiguracji obok ustawień maksymalnych. Koszty ewaluacji pozostają specyficzne dla konfiguracji testu i nie powinny być traktowane jako szacunki wydatków Twojej aplikacji.
Szybkość i latencja: ukończenie zadania vs. generowanie tokenów
OpenAI raportuje, że Terra ukończyła oceniane zadania Agents’ Last Exam ponad trzykrotnie szybciej niż Sol. To pomiar end-to-end obejmujący rozumowanie i interakcje z oprogramowaniem. Nie implikuje trzykrotnie wyższej przepustowości tokenów wyjściowych ani takiego samego przyspieszenia dla każdego żądania API.
Dla aplikacji interaktywnych rozróżniaj czas do pierwszego tokena (time to first token), czyli oczekiwanie przed rozpoczęciem wyjścia, od tokenów wyjściowych na sekundę (output tokens per second), czyli szybkości kontynuacji odpowiedzi. Dla agentów priorytetyzuj całkowity czas ukończenia end-to-end, w tym wywołania narzędzi, ponowne próby i odzyskiwanie po błędach.
Porównuj oba modele, używając tych samych promptów, narzędzi, wspieranego ustawienia rozumowania i kryteriów akceptacji. Rejestruj latencję wraz z powodzeniem zadania: szybsza odpowiedź ma ograniczoną wartość, jeśli wymaga więcej poprawek lub nie kończy przepływu pracy.
Wizja i długi kontekst: co ustalają wyniki
Przewaga Sol o 0.8 punktu procentowego w MMMU-Pro przy maksymalnym wysiłku to jeden zgłoszony wynik wizualny, a nie gwarancja lepszej wydajności w każdym przepływie wizualnym. Testuj małe etykiety, słabe skany, gęste diagramy i nieznane układy na reprezentatywnych danych wejściowych.
Powyższe ewaluacje nie rozstrzygają, który model lepiej radzi sobie z wyszukiwaniem w długim kontekście lub rozumowaniem. Choć oba mają tę samą opublikowaną pojemność kontekstu, sama pojemność nie demonstruje dokładności retrievalu ani pamięci między sesjami. Sprawdź, czy każdy model potrafi znaleźć i wykorzystać istotne dowody w Twoich dokumentach, a stan aplikacji utrzymuj explicite między żądaniami.
GPT-6.1 Terra vs GPT-6.1 Sol: Koszt
Ceny tokenów to punkt wyjścia do porównania kosztów. Na wydatki za pomyślne ukończenie zadania wpływają też ponowne próby, tokeny rozumowania, wywołania narzędzi i przegląd ludzki.
Poniższe stawki są w USD za milion tokenów i ceny.
Cennik OpenAI API
Wymienione stawki Standard dla Terra są o połowę niższe niż dla Sol w tych kategoriach. Rzeczywiste opłaty zależą od konfiguracji żądania: żądań z długim kontekstem, poziomów przetwarzania, przetwarzania regionalnego i użycia narzędzi mogą dotyczyć inne warunki. Sprawdź obowiązującą dokumentację cen OpenAI przed szacowaniem kosztów produkcyjnych.
Cennik CometAPI
CometAPI to zewnętrzna droga dostępu z własnym cennikiem i dostępnością funkcji. Jej zwykłe stawki wejścia i wyjścia pokazano poniżej oddzielnie.
Przy tych stawkach zwykłe ceny wejścia i wyjścia CometAPI są o 20% niższe niż powyższe stawki OpenAI Standard. Przed wdrożeniem potwierdź aktualne ceny, opłaty za długi kontekst, obsługę cache i dostępność narzędzi dla Twojego konta.
Przykładowy koszt dla 1,000 żądań
Załóżmy, że aplikacja wykonuje 1,000 żądań, z których każde używa 2,000 niebuforowanych tokenów wejściowych i 500 rozliczanych tokenów wyjściowych. Daje to łącznie 2 miliony tokenów wejściowych i 500,000 tokenów wyjściowych.
Dla 1,000 żądań, z których każde używa 2,000 niebuforowanych tokenów wejściowych i 500 rozliczanych tokenów wyjściowych, szacunkowe koszty wynoszą:
Terra przez OpenAI: $2.00 za wejście i $2.50 za wyjście, łącznie $4.50.
Sol przez OpenAI: $4.00 za wejście i $5.00 za wyjście, łącznie $9.00.
Terra przez CometAPI: $1.60 za wejście i $2.00 za wyjście, łącznie $3.60.
Sol przez CometAPI: $3.20 za wejście i $4.00 za wyjście, łącznie $7.20.
Te obliczenia używają zwykłych stawek wymienionych powyżej, bez zniżki Batch API. Nie uwzględniają zapisów do pamięci podręcznej, oddzielnych opłat za narzędzia ani ponownych prób. Wszelkie tokeny rozumowania rozliczane jako wyjście muszą być uwzględnione w łącznej liczbie tokenów wyjściowych.
Efektywny koszt na pomyślne zadanie
W tym artykule zadanie uznaje się za pomyślne, jeśli przechodzi z góry ustalone kontrole jakości, schematu (jeśli dotyczy) i ukończenia bez dodatkowej korekty przez człowieka.
Niższe ceny tokenów nie zawsze przekładają się na niższe koszty operacyjne. Oszczędności Terra mogą maleć, jeśli potrzebuje więcej prób, tokenów rozumowania lub interwencji człowieka. Wyższe stawki Sol mogą się opłacać, jeśli częściej kończy zadania pomyślnie za pierwszym razem.
Efektywny koszt modelu i narzędzi na pomyślne zadanie = łączny wydatek na model i narzędzia we wszystkich próbach ÷ liczba pomyślnych zadań.
Koszty przeglądu i korekt przez człowieka śledź oddzielnie. Wybierz model, który spełnia cel jakości przy najniższym łącznym koszcie, zamiast porównywać same ceny tokenów.
Który model wybrać: GPT-6.1 Terra czy GPT-6.1 Sol?
Wybieraj na podstawie złożoności zadania, weryfikowalnej jakości wyjścia i całkowitego kosztu ukończenia. Terra to użyteczny punkt wyjścia dla rutynowych przepływów; Sol warto ocenić, gdy trudne rozumowanie lub kosztowne błędy uzasadniają wyższe wydatki.
Kiedy wybrać GPT-6.1 Terra
Zacznij od Terra w przypadku ekstrakcji na dużą skalę, szkicowania dokumentów, dopasowywania katalogów i przewidywalnych przepływów aplikacji. To dobre kandydatury, gdy wyniki można sprawdzić względem dokumentów źródłowych, wymaganych pól lub zautomatyzowanych reguł walidacji.
Wybierz Terra, gdy spełnia Twoje cele dokładności i ukończenia w ramach dozwolonego budżetu ponownych prób i przeglądu przez człowieka. Niższe stawki tokenów przynoszą niewielką korzyść, jeśli powtarzające się niepowodzenia niwelują oszczędności.
Kiedy wybrać GPT-6.1 Sol
Oceń Sol w przypadku trudnego debugowania, zmian w repozytorium obejmujących wiele zależności i przepływów pulpitu z długimi łańcuchami zależnych działań.
Wybierz Sol, gdy testy pokazują, że tworzy więcej akceptowanych łatek, przechodzi więcej testów lub wymaga mniej ręcznych korekt. Wyższy koszt tokenów jest uzasadniony, jeśli te ulepszenia redukują całkowity koszt wykonania pracy.
Kiedy użyć najpierw Terra, a następnie eskalować do Sol
Hybrydowy przepływ może użyć Terra do pierwszej próby i eskalować do Sol, gdy zawiodą z góry określone kontrole. Oparta na eskalacji decyzja powinna wynikać z obserwowalnych rezultatów, a nie jedynie z pewności modelu.
Na przykład przepływ generowania kodu mógłby:
Poprosić Terra o wprowadzenie żądanej zmiany.
Uruchomić odpowiednie testy i kontrole walidacyjne.
Eskalować do Sol, jeśli zmiana nie przejdzie tych kontroli lub wykracza poza zweryfikowane możliwości Terra.
Przekazać nierozwiązane przypadki do przeglądu przez człowieka po wyczerpaniu budżetu ponownych prób.
W trakcie eskalacji zachowaj oryginalne żądanie, istotny kontekst, nieudane wyjście i wyniki walidacji. Rejestruj użycie obu modeli, aby porównanie kosztów obejmowało cały przepływ.
Lista kontrolna ewaluacji produkcyjnej
Używaj reprezentatywnych zadań: uwzględnij rutynowe prośby oraz przypadki, w których porażka jest kosztowna.
Zachowaj kontrolowane porównania: stosuj porównywalne instrukcje, dowody, narzędzia i kryteria akceptacji. Rejestruj identyfikatory modeli, endpointy, ustawienia rozumowania i daty testów.
Mierz zaakceptowane wyniki: sprawdzaj dokładność, poprawność schematu (jeśli dotyczy), wyniki testów i ukończenie bez ręcznych poprawek.
Mierz czas i wydatki: śledź medianę i ogony latencji, rozliczane tokeny, wywołania narzędzi, ponowne próby i wysiłek przeglądu przez człowieka.
Powtórz porównanie: uruchamiaj zadania wielokrotnie i zmieniaj kolejność modeli, aby ograniczyć wpływ jednorazowych wyników.
Zdefiniuj limity operacyjne: ustal budżety ponownych prób, wyzwalacze eskalacji i wymagania zatwierdzeń przez człowieka przed wdrożeniem.
Porównuj kompletny przepływ: uwzględnij nieudane próby i koszty eskalacji przy obliczaniu wydatku na pomyślne zadanie.
Gdzie uzyskać dostęp do GPT-6.1 Terra i GPT-6.1 Sol?
Oficjalny dostęp dostawcy
Oba modele są dostępne przez OpenAI API. Dla żądań tekstowych obsługiwane są Chat Completions; wywoływanie narzędzi wymaga Responses API. Potwierdź wspierane parametry modelu, limity konta oraz narzędzia dostępne na trasie, której zamierzasz używać.
Dostęp przez CometAPI
Aby używać któregokolwiek modelu przez CometAPI, skorzystaj z jego przewodnika szybkiego startu, aby skonfigurować SDK kompatybilne z OpenAI. Przekaż klucz CometAPI bezpiecznie przez zmienną środowiskową COMETAPI_KEY i ustaw bazowy URL na https://api.cometapi.com/v1. Wybierz gpt-6.1-terra lub gpt-6.1-sol jako identyfikator modelu i potwierdź, że trasa jest włączona dla Twojego konta.
Do pierwszego porównania daj obu modelom te same reprezentatywne zadania i użyj średniego wysiłku rozumowania. Zachowaj spójność instrukcji i kryteriów akceptacji, powtarzaj każde zadanie i zmieniaj kolejność modeli. Porównuj pomyślne wyniki, czas, rozliczane tokeny i ponowne próby zamiast oceniać model na podstawie pojedynczej odpowiedzi.
Wnioski
Zacznij od GPT-6.1 Terra w przypadku częstych, weryfikowalnych przepływów, gdzie niższe ceny tokenów i szybsze ukończenie zadań mają znaczenie. Oceń GPT-6.1 Sol, gdy trudne kodowanie, wieloetapowe użycie narzędzi lub kosztowne błędy czynią wyższą zdolność rozumowania wartościową. Ostateczny wybór powinien opierać się na koszcie zaakceptowanego zadania w reprezentatywnym zestawie ewaluacji, a nie na cenie czy pojedynczym benchmarku.
Dla wielu zastosowań kolejnym użytecznym krokiem jest mała, reprezentatywna próba z jasnymi warunkami zaliczenia i ograniczoną ścieżką eskalacji. Pozwól, aby o wyborze modelu zadecydował zmierzony wynik, zamiast polegać na cenie lub jednym benchmarku.
Czynnik decyzyjny
GPT-6.1 Terra
GPT-6.1 Sol
Początkowy zakres prac
Rutynowa praca wizualna i powtarzalne przepływy agentów
Złożone kodowanie i długotrwałe profesjonalne rozumowanie
Kontekst i modalności
Taka sama łączna pojemność kontekstu; wejście: tekst i obrazy
Taka sama łączna pojemność kontekstu; wejście: tekst i obrazy
Kontrola rozumowania
Zawiera opcję wyłączenia rozumowania
Wymaga co najmniej low wysiłku rozumowania
Opublikowany wzorzec wydajności
Niższy koszt przy powtarzalnych zadaniach agentowych
Lepsze wyniki w kilku trudnych testach kodowania i pulpitu
Dostęp przez API
OpenAI i CometAPI
OpenAI i CometAPI
Specyfikacja
GPT-6.1 Terra
GPT-6.1 Sol
Oficjalna data wydania
October 26, 2026
September 29, 2026
Identyfikator modelu API
gpt-6.1-terra
gpt-6.1-sol
Okno kontekstu
1,050,000 tokens
1,050,000 tokens
Granica wiedzy
June 1, 2026
April 30, 2026
Wejście / wyjście
Tekst i obrazy / tekst
Tekst i obrazy / tekst
Wysiłek rozumowania
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Domyślny wysiłek rozumowania
medium
medium
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Porównanie przy maksymalnym wysiłku
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 p.p.
MMMU-Pro (Wizja)
84.60%
85.50%
86.30%
Sol +0.8 p.p.
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 p.p.
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 p.p.
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 p.p.
Wskaźnik błędów faktograficznych na trudnych poleceniach
10.10%
4.30%
4.40%
Terra niżej o 0.1 p.p.
Dostawca i kategoria tokenów
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinary input
$0.80
$1.60
CometAPI ordinary output
$4.00
$8.00
GPT-6.1 Terra vs GPT-6.1 Sol: benchmarki, ceny i który wybrać - CometAPI