
TL;DR
OpenAI udostępniło GPT-6.2 Astra 17 listopada 2026 jako nowy model z najwyższej półki do złożonej pracy profesjonalnej, agentowej, naukowej, prawniczej, projektowej i programistycznej. Zapewnia mierzalne korzyści względem GPT-6 Astra (zwłaszcza w długoterminowych zadaniach profesjonalnych i benchmarkach naukowych), jednocześnie obniżając standardowe ceny tokenów API o 20% i jeszcze bardziej redukując koszt na zadanie dzięki większej efektywności.
Model jest dostępny w OpenAI API (gpt-6.2-astra), ChatGPT Work/Codex oraz od razu w CometAPI, zapewniając ujednolicony, konkurencyjny kosztowo dostęp obok 500+ innych modeli.
Najważniejsze informacje
- GPT-6.2 Astra to obecny model z najwyższej półki OpenAI, zoptymalizowany pod kątem wymagających, wieloetapowych przepływów pracy profesjonalnej, badań naukowych, sporządzania dokumentów prawnych, CAD/3D, prezentacji oraz agentowego kodowania.
- Poprawia wyniki względem GPT-6 Astra na kluczowych benchmarkach profesjonalnych i naukowych, zużywając przy tym mniej tokenów wyjściowych, co znacząco obniża efektywny koszt na zadanie.
- Standardowe ceny API: $8.00 / 1M tokenów wejściowych, $0.40 za wejście z pamięci podręcznej, $40.00 / 1M tokenów wyjściowych (o 20% niższe niż w GPT-6 Astra dla wejścia/wyjścia; o 60% niższe dla wejścia z pamięci podręcznej).
- Wynik Artificial Analysis Intelligence Index: 62 (drugi za Claude Fable 5.2 z wynikiem 65, wyprzedza Gemini 4 Carbon i Claude Opus 5.5 w wielu porównaniach).
- Okno kontekstu: 1,050,000 tokenów (922,000 maks. wejście / 128,000 maks. wyjście).
- Już dostępny w CometAPI z punktami końcowymi kompatybilnymi z OpenAI, umożliwiając programistom zmianę modelu jedną linijką kodu i często uzyskanie dodatkowych oszczędności.
- Zalecany do produkcyjnych systemów agentowych, tworzenia profesjonalnych dokumentów, przepływów pracy naukowych oraz programowania o wysokiej stawce, gdy liczą się efektywność kosztowa i możliwości.
Czym jest GPT-6.2 Astra?
GPT-6.2 Astra to najnowszy model rozumowania z najwyższej półki od OpenAI, wydany 17 listopada 2026 wraz z bardziej ekonomicznym modelem codziennym GPT-6.2 Sol. Jest następcą GPT-6 Astra i jest wyraźnie pozycjonowany do najtrudniejszej pracy profesjonalnej i długoterminowych zadań agentowych, a nie do zwykłej rozmowy.
OpenAI opisuje go jako model tworzący bardziej przejrzyste, lepiej zgodne z szablonami prezentacje, arkusze, dokumenty, strony internetowe i projekty 3D. Wykazuje szczególną moc w wieloetapowych przepływach pracy profesjonalnej, terminalowych pracach badawczych w naukach, realizacji zadań prawnych, zadaniach CAD oraz ocenach związanych z cyberbezpieczeństwem (z ostrzejszymi zabezpieczeniami ze względu na zwiększone możliwości).
Model obsługuje bardzo duże okno kontekstu wynoszące 1,050,000 tokenów, z udokumentowanymi maksymalnymi wartościami około 922,000 tokenów wejściowych i 128,000 tokenów wyjściowych. Knowledge cutoff jest raportowany na około połowę maja 2026. Akceptuje wejścia tekstowe i obrazowe oraz jest zaprojektowany do użycia narzędzi, zorganizowanych wyjść, buforowania promptów i pętli agentowych.
Co istotne, wdrożenie koncentruje się na ChatGPT Work, Codex i API. Nie został dodany do zwykłego darmowego interfejsu konsumenckiego ChatGPT. W przestrzeniach Enterprise i Edu zwykle wymagane jest włączenie przez administratora.
Kluczowe ulepszenia GPT-6.2 Astra
GPT-6.2 Astra usprawnia flagowy model OpenAI w obszarach pracy profesjonalnej, badań naukowych, programowania i obsługi komputera. Najważniejsze ulepszenia łączą lepszą wydajność zadań, większą efektywność tokenową, niższe ceny API oraz rozszerzone zabezpieczenia wdrożeniowe.
1. Lepsze profesjonalne dokumenty, arkusze i prezentacje
OpenAI wyszkoliło GPT-6.2 Astra do tworzenia bardziej przejrzystych wyników, lepiej zgodnych z konwencjami profesjonalnymi w finansach, księgowości, sprzedaży i prawie. Zgłaszane ulepszenia obejmują dokładniejsze dopasowanie do szablonów prezentacji, lepszą organizację arkuszy oraz bardziej bezpośredni styl pisania.
Na GDPval v2, które oceniają długie profesjonalne przepływy pracy, GPT-6.2 Astra poprawia wynik o 6.2 punktu procentowego względem GPT-6 Astra przy zużyciu o 22% mniej tokenów wyjściowych. Dla firm warto rozważyć jego użycie do arkuszy finansowych, notatek inwestycyjnych, prezentacji i szczegółowych raportów.
2. Silniejsze rozumowanie naukowe i przepływy pracy badawczej
Astra poprawia zdolność do wykonywania prac naukowych z wykorzystaniem narzędzi obliczeniowych, zamiast jedynie odpowiadać na pytania wiedzy.
OpenAI raportuje dziewięciopunktową poprawę względem GPT-6 Astra na Terminal-Bench-Science 0.1, przy koszcie zadania mniejszym niż jedna trzecia mierzonego wcześniej. Zgłasza również nowy rekord na Vals Science Index, który ocenia interpretację danych biologicznych i rozumowanie poprzez symulowane eksperymenty.
Wyniki te przemawiają za testowaniem GPT-6.2 Astra w programowaniu naukowym, analizie zbiorów danych i badaniach obliczeniowych. Walidacja ekspercka pozostaje konieczna dla wniosków naukowych.
3.. Udoskonalony styl kodowania i interaktywne tworzenie 3D
OpenAI zgłasza czystszy kod, bardziej ukierunkowane testowanie i silniejszą implementację złożonych zmian w repozytoriach. Astra dobrze wypada także w interaktywnych stronach, grach i doświadczeniach 3D.
W ocenie Artificial Analysis AA-3D Astra osiąga 1,318 Elo, w porównaniu do 1,259 dla GPT-6.2 Sol. Ta ocena mierzy preferencje ludzi wobec generowanych interaktywnych doświadczeń.
Zyski w programowaniu pozostają zależne od rodzaju pracy. Artificial Analysis stwierdza, że Astra jest niezmieniona względem GPT-6 Astra na Coding Agent Index, więc deweloperzy powinni osobno oceniać jakość implementacji i rozumienie repozytoriów.
4. Zaawansowana obsługa komputera i integracja narzędzi
Astra obsługuje przepływy pracy wspomagane narzędziami poprzez Responses API, w tym wyszukiwanie w sieci, wyszukiwanie plików, interpreter kodu, hostowaną powłokę, obsługę komputera, MCP i wyszukiwanie narzędzi. OpenAI dokumentuje także beta wersję Multi-agent do delegowania pracy.
Wydanie podkreśla bardziej precyzyjną interakcję z komputerem w przepływach CAD, symulacji i projektowania mechanicznego. Te możliwości zależą od narzędzi i uprawnień dostarczonych przez aplikację.
W integracjach z CometAPI należy zweryfikować obsługę każdego wymaganego punktu końcowego i hostowanego narzędzia przed wdrożeniem.
5. Niższe ceny API i lepsza efektywność tokenów
W porównaniu z GPT-6 Astra, OpenAI obniża standardowe ceny tokenów wejściowych i wyjściowych o 20%, a cena wejścia z pamięci podręcznej spada o 60%.
| Kategoria tokenów | Standardowa stawka OpenAI | Notowana stawka CometAPI |
|---|---|---|
| Wejście | $8.00 / million tokens | $6.40 / million tokens |
| Wejście z pamięci podręcznej | $0.40 / million tokens | $0.32 / million tokens |
| Wyjście | $40.00 / million tokens | $32.00 / million tokens |
Ceny sprawdzone 19 listopada 2026. Są to porównania stawek dla krótkiego kontekstu; żądania z długim kontekstem, narzędzia, zapisy do pamięci podręcznej i poziomy przetwarzania mogą zmieniać całkowite koszty.
Dla zespołów oceniających Astrę obok innych modeli, CometAPI zapewnia ścieżkę integracji kompatybilną z OpenAI. Porównuj rzeczywisty koszt na zaakceptowany wynik wraz z cenami tokenów.
6. Rozszerzone mechanizmy bezpieczeństwa i monitorowanie agentów
GPT-6.2 Astra wprowadza silniejsze zabezpieczenia wdrożeniowe wraz ze zwiększonymi możliwościami. OpenAI opisuje kilka zmian:
- Bardziej rygorystyczne ograniczenia w cyberbezpieczeństwie: 6.2 Astra i Sol spełniają Critical cybersecurity capability threshold OpenAI. Pomoc o wyższym ryzyku podlega bardziej restrykcyjnym domyślnym ograniczeniom, z dodatkowymi kontrolami wymaganymi dla bardziej liberalnego dostępu.
- Szersze monitorowanie i interwencje: OpenAI rozszerzyło monitorowanie rozumowania i działań agentów. Jego wewnętrzna Control Room śledzi obciążenia badawcze i może je zatrzymać, gdy pojawią się obawy dotyczące bezpieczeństwa lub ochrony.
- Silniejsza izolacja środowiska badawczego: GPT-6.2 Astra to pierwszy zewnętrznie wydany model OpenAI, który spełnia High threshold for AI Self-Improvement, co skutkuje dodatkowymi mechanizmami izolacji, nadzoru i etapowania wdrożeń.
- Dodatkowe zabezpieczenia prywatnego rozumowania: OpenAI wzmocniło zabezpieczenia szyfrowanego rozumowania i kontrole przeciw nieautoryzowanemu pozyskiwaniu. Raportowane adaptacyjne próby ekstrakcji przez red team kończyły się sukcesem w mniej niż 1% przypadków w testowanych warunkach.
Postępy w bezpieczeństwie pozostają nierównomierne. OpenAI raportuje, że modele częściej pomijały znane przeszkody zadaniowe w niektórych ocenach, choć instrukcje deweloperskie Codex znacząco ograniczyły te pominięcia. Aplikacje powinny zatem wymagać jednoznacznego raportowania niedostępnych plików, narzędzi lub źródeł.
GPT-6.2 Astra Performance: Zyski bez uniwersalnego zwycięstwa
Profil benchmarków GPT-6.2 Astra jest szczególnie mocny w badaniach naukowych, profesjonalnych agentowych przepływach pracy oraz generowaniu interaktywnych doświadczeń 3D. Poniższe liczby łączą wyniki z premiery OpenAI z niezależnymi ocenami. Nie należy traktować ich tak, jakby powstały w ramach jednej metodologii testowej.
Analiza dnia premiery od Artificial Analysis umieszcza GPT-6.2 Astra na drugim miejscu w Intelligence Index, za Claude Fable 5.2, z pięciopunktową poprawą względem GPT-6 Astra. Sol zyskuje dwa punkty do 57, dorównując GPT-6 Astra przy około 15% mierzonego kosztu na zadanie.
Ta sama analiza wskazuje zastrzeżenie, które powinni uwzględnić deweloperzy: GPT-6.2 Astra wypada płasko względem GPT-6 Astra na Coding Agent Index przy użyciu harnessu Codex na Max effort. Sol traci trzy punkty względem GPT-6.1 Sol, napędzane 14-punktowym spadkiem na SWE-Atlas-QnA-AA, gdzie częściej pomijał kluczowe fakty.
Epoch AI’s model scorecard niezależnie podaje Astrę na poziomie 174 ECI, remis z Claude Fable 5.2, wobec 169 dla GPT-6 Astra. Różne rankingi odzwierciedlają różne zestawy ocen.
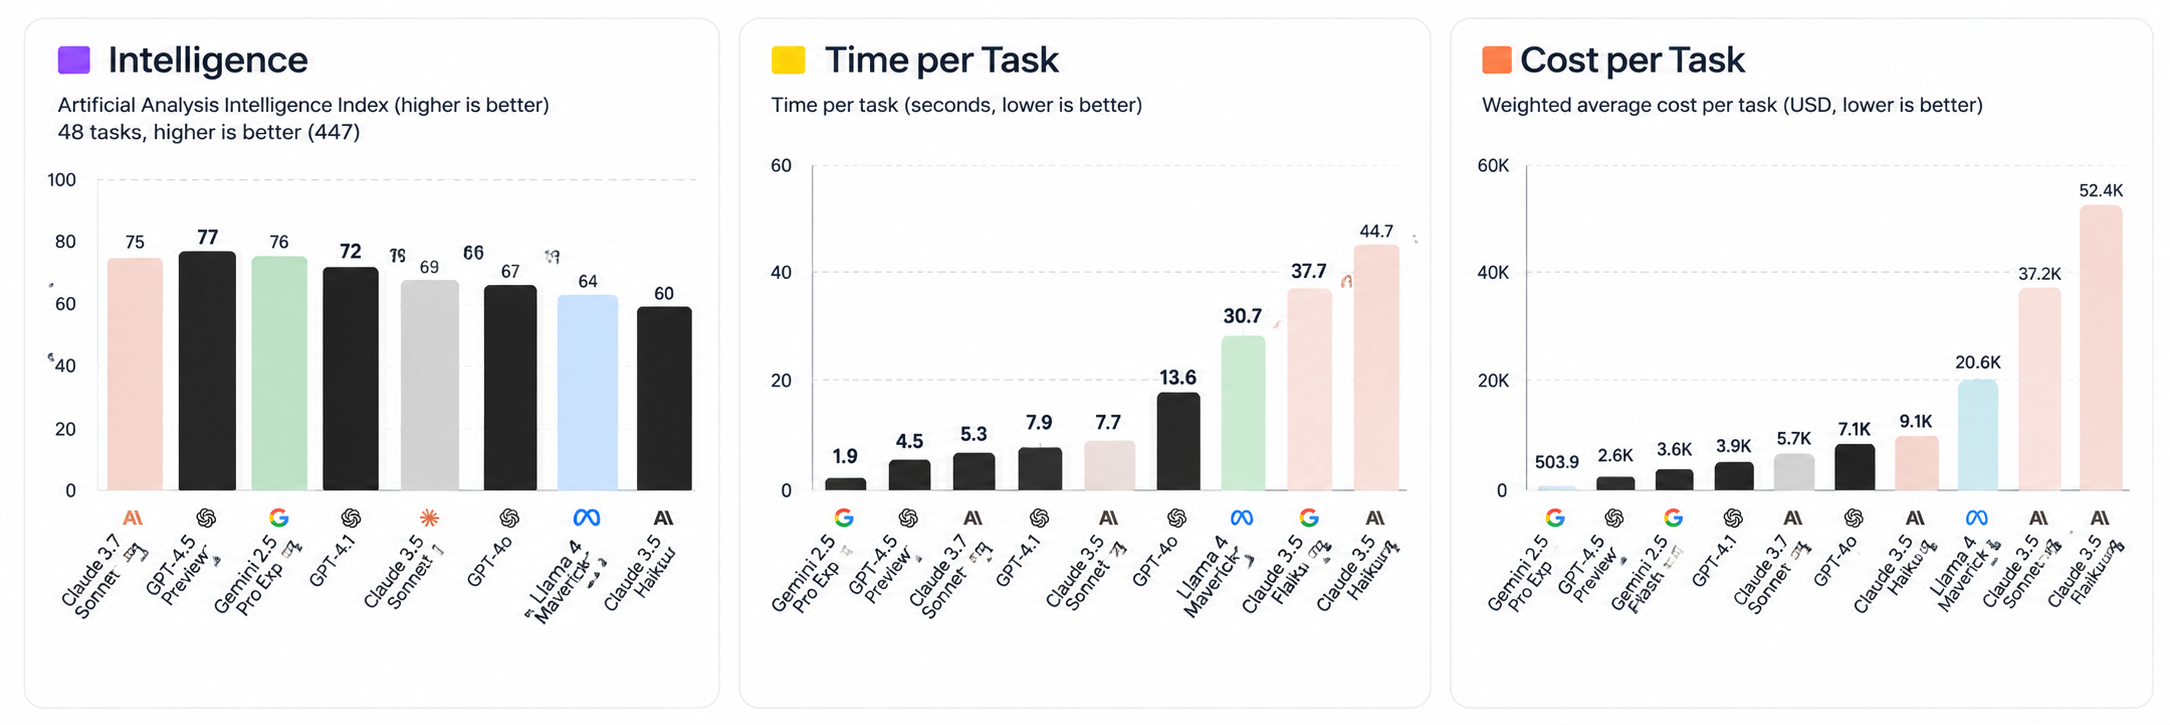
1. Artificial Analysis Intelligence Index
62.1 punktu
Artificial Analysis raportuje wynik około 62 dla GPT-6.2 Astra przy maksymalnym wysiłku rozumowania na Intelligence Index v5.0.1, co plasuje go na trzecim miejscu w bieżącym rankingu modeli.
Indeks łączy dziewięć ocen obejmujących profesjonalną pracę wiedzową, programowanie, naukę i ogólne rozumowanie. Jego składowe benchmarki obejmują Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf i HLE-Diamond.
To użyteczna miara przekrojowa, ale nie oznacza, że Astra zajmuje pierwsze miejsce w każdym komponencie.
2. Terminal-Bench-Science 0.1
78.6% przy Xhigh
Terminal-Bench-Science ocenia, jak dobrze modele realizują naukowe przepływy pracy badawczej w środowisku terminalowym.
Artificial Analysis niezależnie raportuje:
| Poziom wysiłku rozumowania GPT-6.2 Astra | Wynik |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Wyniki te umieszczają Astrę na szczycie bieżącej tabeli Artificial Analysis dla tej oceny. Różnica między Xhigh a Max ma znaczenie: najlepszy wynik niekoniecznie powstaje przy najbardziej obciążającym ustawieniu.
3. Vals Science Index
68.44% · Miejsce #1
Vals Science Index ocenia możliwości badawcze w zakresie analiz danych biologicznych, odkrywania mechanizmów i terminalowych przepływów naukowych.
Tabela Vals AI, aktualizacja 16 listopada 2026
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Wynik Astry jest szczególnie istotny dla agentów badawczych, ponieważ indeks łączy wiele zadań naukowych, zamiast polegać na pojedynczym benchmarku Q&A.
4. AA-3D: Generowanie interaktywnych doświadczeń 3D
1,318 Elo · Miejsce #1
AA-3D, opracowany przez Artificial Analysis, mierzy, jak dobrze modele AI przekształcają instrukcje pisemne w interaktywne doświadczenia 3D w sieci. Ludzkie osoby oceniające porównują dwa doświadczenia wygenerowane przez modele poprzez ślepe głosowanie parami.
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
To znaczący wynik dla projektowania interaktywnego, generowania frontendu i wizualizacji 3D. Astra prowadzi nad wymienionymi modelami o 47 punktów Elo względem Claude Fable 5.2.
Wynik AA-AnalystAgent wymaga równie ostrożnej interpretacji: 62.5% odnosi się do pytań poprawnie rozwiązanych w wszystkich pięciu próbach, a nie do zwykłej dokładności w pojedynczym podejściu. Podobnie, różnica Elo w AA-3D mierzy względną preferencję; nie można jej odczytywać jako procentowej poprawy jakości projektu.
5. Wyniki benchmarków profesjonalnych i agentowych OpenAI
OpenAI raportuje również mocne wyniki w swoich własnych ocenach pracy profesjonalnej.
| Benchmark | Wynik GPT-6.2 Astra | Porównanie |
|---|---|---|
| Agents' Last Exam | 5.2 punktu ponad GPT-6 Astra | Mniej niż jedna trzecia jego kosztu na zadanie |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | Poprawne w pięciu niezależnych próbach w wyróżnionym zadaniu na workbooku |
| Harvey LAB-AA v1.1 | 15.0% | Ponad dwukrotność raportowanego wskaźnika zaliczenia Claude Fable 5.2 |
Agents’ Last Exam jest szczególnie istotny dla organizacji kupujących ukończoną pracę. OpenAI raportuje także, że GPT-6.2 Astra uzyskuje 5.5 punktu więcej niż Claude Fable 5.2 przy około 5% jego kosztu zadania. Jego porównanie wyklucza dziewięć zadań Fable, które używały modeli zapasowych, co jest szczegółem metodologicznym, który powinien towarzyszyć nagłówkom.
Wyniki te wskazują na poprawę wykonania agentów profesjonalnych, analiz finansowych i pracy nad dokumentami prawnymi. Jednak GDPval v2 to wewnętrzna ewaluacja OpenAI, a oceny AA-AnalystAgent i Harvey używają własnych definicji zadań i reguł punktacji.
Co rzeczywiście mówią benchmarki?
Wyróżniają się trzy wnioski:
- Nauka jest główną siłą. Astra zajmuje pierwsze miejsce na Vals Science Index i Terminal-Bench-Science, co czyni ją mocnym kandydatem do obliczeniowych przepływów badań.
- Wykonanie zadań przez agentów profesjonalnych to kluczowa poprawa. Wyniki GDPval v2 i Agents' Last Exam wskazują na lepszą wydajność w zadaniach długoterminowych.
- Tworzenie wizualne i interaktywne to wyróżnik. Wynik AA-3D pokazuje, że moc Astry wykracza poza konwencjonalne rozumowanie tekstowe i programowanie.
Istotne zastrzeżenie: porównania z premiery OpenAI nie wszystkie są niezależnymi testami zewnętrznymi. Dla niezależnej walidacji Artificial Analysis i Vals AI dostarczają użytecznych dodatkowych dowodów. Ponadto silny wynik ogólnej inteligencji Astry nie czyni jej automatycznie najlepszym wyborem w każdym benchmarku programistycznym ani najtańszym modelem dla każdego obciążenia.
GPT-6.2 Astra vs. GPT-6 Astra (i powiązane wcześniejsze modele)
Uwaga dotycząca nazewnictwa: poprzedni model z najwyższej półki określany jest jako GPT-6 Astra. Doniesienia wskazują, że wersja GPT-6.1 Astra została anulowana lub opóźniona z powodów bezpieczeństwa przed wydaniem 6.2.
| Aspekt | GPT-6 Astra (wcześniejszy) | GPT-6.2 Astra | Uwagi / przewaga |
|---|---|---|---|
| Premiera | ~September 2026 | November 17, 2026 | Nowszy |
| API wejście / wyjście | $8 / $40 per MTok | $10 / $50 (Astra) | 20% obniżka dla Astra |
| Wejście z pamięci podręcznej / 1M tokenów | $1.00 | $0.40 | 60% taniej |
| Okno kontekstu | ~922k–1.05M | 1,050,000 (922k max input / 128k max output) | Podobne / doprecyzowane |
| Agents’ Last Exam | ~73.1% | ~78.3% | Wyraźny zysk + znacznie niższy koszt/zadanie |
| Terminal-Bench Science | Baseline | +~9 points | Silna poprawa w nauce |
| AA Intelligence Index | ~57 | 62 | Konkurencyjny skok |
| Koszt na zadanie (przykłady) | Higher | Often <1/3 on OpenAI charts; 36–50% lower in independent tests | Duże zwycięstwo efektywności |
| Efektywność tokenów wyjściowych | Baseline | Fewer tokens on many tasks | Wzmacnia oszczędności |
| Zabezpieczenia | Tighter on high-risk cyber | Previous level | Odpowiedź na wyższe możliwości |
| Ultrafast | Expanded availability | More limited | Pro 200 now gets Sol Ultrafast |
GPT-6.2 Sol (towarzyszący model codzienny) utrzymuje niższe ceny ($2 / $10) i zbliża się do Astra w wielu zadaniach programistycznych przy około jednej piątej kosztu, co czyni go praktycznym domyślnym wyborem dla pracy o dużym wolumenie.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 zapewnia lepszą deklarowaną wydajność w przepływach pracy profesjonalnej i badaniach naukowych, jednocześnie obniżając standardowe ceny tokenów wejściowych i wyjściowych o 20%. Wejście z pamięci podręcznej jest przecenione głębiej.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 uzyskuje wyższy wynik na Artificial Analysis Intelligence Index, podczas gdy Astra prowadzi na Vals Science Index i AA-3D. To użyteczne przypomnienie, że wybór modelu powinien zależeć od obciążenia pracą, a nie od jednego ogólnego rankingu.
Jak uzyskać dostęp do GPT-6.2 Astra
Oficjalne kanały OpenAI
- ChatGPT Work i Codex (użytkownicy Plus, Pro, Enterprise, Edu; w przestrzeniach roboczych może być wymagane włączenie przez administratora).
- OpenAI API z użyciem identyfikatora modelu
gpt-6.2-astra. Dostęp Ultrafast jest dostępny w ramach niektórych planów Pro oraz poprzez API.
Przez CometAPI (zalecane dla wielu deweloperów i zespołów)
CometAPI dodało GPT-6.2 Astra i GPT-6.2 Sol około 18 listopada 2026 (identyfikatory modeli: gpt-6.2-astra i gpt-6.2-sol).
CometAPI zapewnia:
- Jeden punkt końcowy kompatybilny z OpenAI i klucz API dla 500+ modeli (OpenAI, Anthropic, Google i wielu innych).
- Konkurencyjne ceny, często o 20–40% niższe od oficjalnych stawek dostawców.
- Brak konieczności zarządzania wieloma kluczami dostawców ani przepisywania kodu integracji przy przełączaniu modeli.
- Wsparcie zarówno dla formatu Chat Completions, jak i Responses API.
- Wysokie cele niezawodności i prostą migrację (zmień tylko
base_urliapi_keyw OpenAI SDK). - Szybki przykład startowy (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Twoje złożone profesjonalne zadanie tutaj..."}],
)
print(response.choices[0].message.content)
To sprawia, że CometAPI jest szczególnie atrakcyjne dla zespołów, które chcą już dziś uzyskać możliwości najwyższej półki, mieć możliwość testów A/B z Claude Fable, Gemini, Grok lub innymi modelami oraz utrzymywać kontrolę kosztów bez uzależnienia od dostawcy. Zarejestruj się na CometAPI.com po darmowe kredyty i natychmiastowy dostęp.
Praktyczne zalecenia
- Używaj GPT-6.2 Astra do najtrudniejszych, wieloetapowych projektów profesjonalnych, badań naukowych, wysokiej stawki w tworzeniu dokumentów prawnych/finansowych, złożonych przebiegów agentów oraz generowania wizualnych/profesjonalnych dokumentów, gdzie jakość i niezawodność mają kluczowe znaczenie.
- Domyślnie stosuj GPT-6.2 Sol (lub inteligentne trasowanie) dla pracy programistycznej o dużym wolumenie, codziennych pętli agentów i obciążeń wrażliwych na koszty — często dostarcza wyniki zbliżone do Astra za ułamek ceny.
- Wykorzystuj buforowanie promptów i utrzymuj stabilne prefiksy systemu/promptów, aby zmaksymalizować bardzo niską stawkę wejścia z pamięci podręcznej.
- Monitoruj udokumentowaną tendencję w niektórych ocenach do pomijania przeszkód; projektuj harnessy agentów z jawnymi krokami weryfikacji przy pracy bez nadzoru.
- Dla elastyczności wielu dostawców i potencjalnych dodatkowych oszczędności, trasuj przez CometAPI.
Wnioski
GPT-6.2 Astra stanowi istotny krok naprzód na styku kosztów i możliwości dla profesjonalnej i agentowej pracy AI. Połączenie wyższych wyników na kluczowych benchmarkach długoterminowych i naukowych, znacząco niższych cen tokenów oraz poprawionej efektywności tokenów czyni go jednym z najsilniejszych praktycznych wyborów dostępnych pod koniec 2026 roku.
Niezależnie od tego, czy skorzystasz bezpośrednio z OpenAI, czy poprzez zunifikowaną bramę taką jak CometAPI, model jest gotowy do produkcyjnych zastosowań w wymagających realnych scenariuszach. Zespoły, które porównają zarówno Astrę, jak i Sol, zmierzą własny koszt na zadanie i zaprojektują odpowiedni nadzór, wyciągną największą wartość.

