Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Grok Voice 3.0 to model mowy na mowę w czasie rzeczywistym firmy xAI, wydany 14 października 2026 r. Nazwa modelu w API to grok-voice-3.0; na dzień 3 listopada 2026 r. grok-voice-latest wskazuje na tę wersję. Ogłoszenie premiery podaje cenę sesji głosowych: 0,08 USD za minutę (4,80 USD za godzinę). Model łączy rozmowę, obsługę przerwań i użycie narzędzi dla asystentów głosowych oraz wsparcia klienta. Mając podstawy Pythona, klucz API xAI i bibliotekę websockets, możesz wysłać prompt i zapisać odpowiedź mówioną. Zacznij od przykładu poniżej, a następnie dodawaj nagrane audio, strumieniowanie z mikrofonu na żywo i narzędzia biznesowe wraz z rozwojem aplikacji.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Najważniejsze informacje
Grok Voice 3.0 wymienia mowę i tekst w czasie rzeczywistym. Twoja aplikacja wysyła i odbiera zdarzenia sesji przez WebSocket przez całą rozmowę.
Pierwszy test może być pojedynczym przejściem tekst→audio. Odtwarzalna odpowiedź potwierdza, że uwierzytelnianie i generowanie audio działa, zanim podłączysz mikrofon.
Wejście audio wymaga pasującego formatu i wyraźnej granicy tury. Aplikacja może przesłać nagrane audio PCM z ręcznym domykaniem tury lub strumieniować audio z mikrofonu z serwerowym wykrywaniem głosu.
Twoja aplikacja kontroluje akcje biznesowe. Waliduje argumenty funkcji i uprawnienia użytkownika, wykonuje zatwierdzoną akcję i zwraca wynik, aby agent głosowy mógł kontynuować.
Przeglądarki i aplikacje mobilne używają poświadczeń krótkotrwałych. Twój serwer przechowuje stały klucz API i wydaje klientom tymczasowe tokeny do połączeń.
Czym jest Grok Voice 3.0?
Grok Voice 3.0 to konwersacyjny model głosowy czasu rzeczywistego opracowany przez xAI, działający pod marką SpaceX Super Intelligence. Przyjmuje wejście mówione lub tekstowe i może zwracać audio oraz tekst w ramach trwającej sesji. Model jest zoptymalizowany do zastosowań agentów głosowych, a nie jako bezpośredni zamiennik dla ogólnych, wyłącznie tekstowych modeli Grok.
Tradycyjne asystenty głosowe często łączą rozpoznawanie mowy, model językowy i syntezę mowy. Grok Voice zamiast tego udostępnia sesję mowa‑na‑mowę z wbudowanym zachowaniem konwersacyjnym i obsługą narzędzi. Taka architektura może uprościć warstwę orkiestracji po stronie dewelopera, choć aplikacje nadal wymagają przechwytywania audio, transportu, uwierzytelniania, integracji biznesowych i monitorowania.
Definicja modelu Grok Voice 3.0 wskazuje tekst i audio jako tryby wejścia i wyjścia. W tym samouczku pierwszym użytecznym punktem kontrolnym jest odtwarzalna odpowiedź z uruchomionego po stronie serwera skryptu w Pythonie.
Kluczowe funkcje i możliwości Grok Voice 3.0
Prowadź rozmowę na żywo: wymieniaj mowę i tekst przez WebSocket w trakcie sesji.
Obsługuj przerwania: używaj serwerowego wykrywania głosu i zatrzymuj zakolejkowane odtwarzanie, gdy rozmówca zaczyna mówić.
Używaj narzędzi biznesowych: podłącz własne funkcje do zadań takich jak wyszukiwanie zamówień i planowanie.
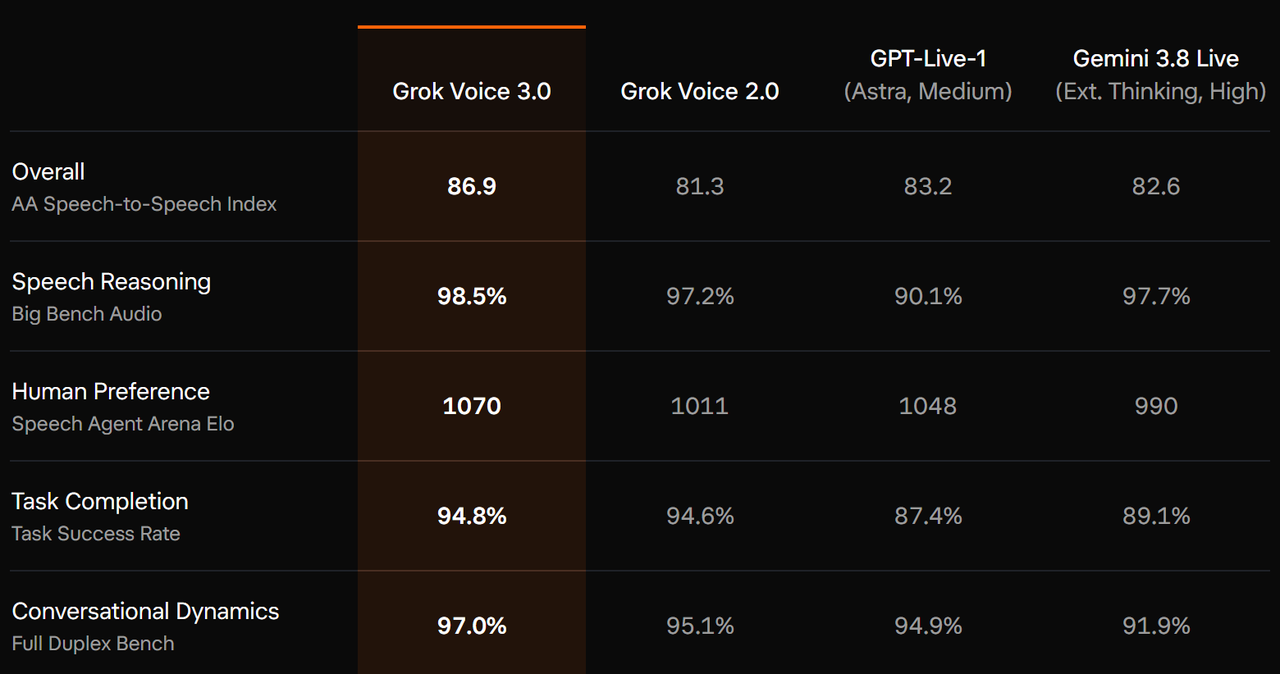
To opublikowane wyniki benchmarków, a nie gwarancje dla Twojego wdrożenia. Przetestuj własne akcenty, warunki szumu, narzędzia i ścieżki eskalacji, zanim użyjesz agenta z klientami.
Co jest potrzebne, zanim wywołasz API Grok Voice 3.0?
Utwórz lub zaloguj się na konto w xAI Console, wygeneruj klucz API i sprawdź, czy Twoje konto ma dostęp i dostępne środki. Użyj lokalnego terminala lub zaufanego serwera dla przykładu w Pythonie.
Python 3.11 lub nowszy oraz pip w tym samym środowisku.
Ważny klucz xAI API zapisany jako XAI_API_KEY.
Połączenie sieciowe umożliwiające wychodzące, szyfrowane połączenia WebSocket.
Odtwarzacz multimedialny do otwarcia wygenerowanego pliku WAV.
Wygeneruj klucz w xAI Console. Przechowuj go w zmiennej środowiskowej zamiast wpisywać na stałe w aplikacji.
Ustaw klucz API dla bieżącej sesji Bash.
export XAI_API_KEY="your_xai_api_key"
W Windows PowerShell:
Ustaw klucz API dla bieżącej sesji PowerShell.
$env:XAI_API_KEY="your_xai_api_key"
Zainstaluj klienta WebSocket w środowisku Pythona.
python -m pip install "websockets>=14,<18"
Uruchom pozostałe polecenia w tej sameej sesji terminala. Jeśli używasz wirtualnego środowiska, aktywuj je przed instalacją pakietu.
Jak używać API Grok Voice 3.0 w Pythonie
Natywne Realtime API korzysta z połączenia WebSocket. W odróżnieniu od zwykłych uzupełnień czatu tekstowego, wymienia bieżące zdarzenia sesji i strumieniuje fragmenty audio, gdy rozmowa trwa.
Krok 1: Wybierz stałą wersję modelu i skonfiguruj sesję
API akceptuje wersjonowaną nazwę modelu w adresie URL WebSocket. Przykład używa grok-voice-3.0, aby żądana wersja była jednoznaczna. Zdarzenie session.update ustawia głos, format audio i ręczne zarządzanie turą; poczekaj na session.updated przed wysłaniem promptu.
Krok 2: Wyślij tekst i zbierz odpowiedź mówioną
Zapisz poniższy skrypt jako grok_voice_demo.py. Wysyła jeden prompt tekstowy, zbiera fragmenty audio zakodowane base64 i zapisuje monofoniczny plik WAV 24 kHz, 16-bit PCM. Skrypt przerywa także działanie w przypadku błędów API, niepowodzenia zakończenia odpowiedzi lub braku audio w odpowiedzi.
Utwórz jedną odpowiedź mówioną z tekstowego promptu i zapisz ją jako plik WAV.
Po udanej odpowiedzi terminal wypisze „Saved grok_response.wav”. Otwórz ten plik w odtwarzaczu i sprawdź, czy słyszysz pełną odpowiedź w normalnym tempie. Brak lub nieodtwarzalny plik to sygnał, by przejrzeć zwrócone zdarzenia i konfigurację audio, zanim dodasz kolejne funkcje.
Dokumentacja zdarzeń w czasie rzeczywistym opisuje potwierdzenie sesji i cykl życia odpowiedzi użyty tutaj. Skrypt czeka na całą turę przed zapisaniem pliku; interaktywna aplikacja głosowa powinna odtwarzać fragmenty audio w miarę ich nadejścia.
Jak wysyłać audio do Grok Voice 3.0?
Nagrane audio z ręcznym zakończeniem tury
Ten przykład używa monofonicznego pliku WAV 24 kHz, 16-bit PCM. Grok Voice 3.0 obsługuje także inne częstotliwości próbkowania PCM, μ-law, A-law i Opus. Rzeczywisty format musi odpowiadać konfiguracji w session.update. Zamień tylko blok conversation.item.create w poprzednim skrypcie na poniższy fragment. Pozostaw późniejsze wywołanie response.create i istniejącą pętlę odbioru.
Zastąp blok wiadomości tekstowej przesłaniem nagranego audio wewnątrz main().
with wave.open("request.wav", "rb") as source:
    if (
        source.getnchannels() != 1
        or source.getsampwidth() != 2
        or source.getframerate() != SAMPLE_RATE
        or source.getcomptype() != "NONE"
    ):
        raise ValueError("Use mono, 24 kHz, 16-bit PCM WAV audio.")
    pcm = source.readframes(source.getnframes())

if len(pcm) < SAMPLE_RATE * 2 // 10:
    raise ValueError("Use a spoken recording longer than 100 ms.")

for offset in range(0, len(pcm), 4800):
    await ws.send(json.dumps({
        "type": "input_audio_buffer.append",
        "audio": base64.b64encode(pcm[offset:offset + 4800]).decode("ascii"),
    }))
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
while (await receive_event(ws)).get("type") != "input_audio_buffer.committed":
    pass
Wcięcie tego zastąpienia powinno być na tym samym poziomie co oryginalny blok wiadomości tekstowej, wewnątrz kontekstu WebSocket. Wysyła surowe próbki PCM z pliku WAV, a nie nagłówek kontenera WAV. Pierwszy skrypt jawnie wybiera ręczne zarządzanie turą, więc zatwierdzenie bufora i żądanie odpowiedzi to osobne działania.
Przechwytywanie z mikrofonu na żywo i natychmiastowe odtwarzanie
Dla interaktywnej rozmowy ciągle przechwytuj audio, konwertuj je do skonfigurowanego formatu wejściowego i wysyłaj krótkie fragmenty, podczas gdy osobna pętla odbioru obsługuje odpowiedzi. Wybierz server_vad do automatycznego wykrywania tury zamiast trybu ręcznego użytego w przykładzie z nagranym plikiem. Unikaj dodawania drugiego response.create, gdy serwer już tworzy odpowiedź.
W przypadku przerwania szybko zatrzymuj odtwarzanie zakolejkowanego audio asystenta. Sama anulacja sieciowa nie usuwa dźwięku już zbuforowanego w Twojej aplikacji. Utrzymuj małą kolejkę odtwarzania i śledź, ile audio słuchacz faktycznie usłyszał, aby utrzymać spójny stan rozmowy.
Jak dodać narzędzia do agenta Grok Voice 3.0?
Aplikacje mogą udostępniać narzędzia takie jak wyszukiwanie zamówień, planowanie czy weryfikacja konta. Agent potrafi zinterpretować złożone żądanie mówione, wywołać autoryzowaną funkcję i użyć wyniku, aby kontynuować. Jest to szczególnie przydatne, gdy klient prosi o kilka powiązanych zmian w jednej rozmowie.
API obsługuje funkcje niestandardowe i narzędzia zarządzane przez serwer. W przypadku funkcji niestandardowej Twoja aplikacja implementuje akcję; samo zdefiniowanie narzędzia nie łączy modelu z Twoją bazą danych.
Zadeklaruj nazwę funkcji, opis i schemat JSON argumentów w session.tools.
Obsłuż response.function_call_arguments.done, sparsuj argumenty i zwaliduj uprawnienia dzwoniącego przed wykonaniem funkcji.
Zwróć wynik jako zdarzenie conversation.item.create z item.type ustawionym na function_call_output i dopasowanym call_id.
Wyślij response.create po przesłaniu wymaganych wyników funkcji. Jeśli kilka wywołań przychodzi jednocześnie, zwróć wszystkie wyniki przed poproszeniem modelu o kontynuację.
Zacznij od narzędzia tylko do odczytu, np. sprawdzania statusu dostawy zamówienia. Dla akcji zmieniających rezerwacje, zwracających środki lub składających zamówienia, egzekwuj w aplikacji weryfikację tożsamości, potwierdzenia i ochronę przed duplikatami żądań.
Jak używać Grok Voice 3.0 w przeglądarce i aplikacjach mobilnych
Używaj poświadczeń efemerycznych do połączeń po stronie klienta. Twój serwer żąda krótkotrwałego tokena za pomocą stałego klucza API i przekazuje token do klienta. Uwierzytelniaj żądania do własnego endpointu tokenów i stosuj limity użycia, aby nie stał się nieograniczonym punktem dostępowym.
W interfejsie utrzymuj widoczność zgody na mikrofon, kontroli nagrywania i statusu połączenia. Obsługuj utratę połączenia wprost: zatrzymaj nieaktualne odtwarzanie, poinformuj użytkownika o odzyskiwaniu połączenia i unikaj ponownego odtwarzania akcji, które mogły już zostać wykonane.
Jak rozwiązywać typowe błędy API Grok Voice 3.0
Błąd uwierzytelnienia: potwierdź, że XAI_API_KEY jest ustawiony w terminalu uruchamiającym skrypt i że klucz należy do konta z dostępem. Nie wklejaj klucza do logów ani wiadomości do wsparcia.
Nieoczekiwane argumenty biblioteki klienckiej: sprawdź, czy pip zainstalował żądaną wersję websockets w środowisku Pythona używanym do uruchomienia skryptu.
Brak wyjścia audio: przejrzyj zdarzenia błędów i response.done, potwierdź, że session.updated potwierdziło konfigurację, i sprawdź, czy dla trybu ręcznego poproszono o odpowiedź.
Zniekształcone odtwarzanie: porównaj rzeczywiste bajty z skonfigurowanym kodekiem, częstotliwością próbkowania, liczbą kanałów i nagłówkiem WAV. Zmiana nazwy pliku MP3 na WAV nie konwertuje go.
Limit czasu: sprawdź dostęp sieciowy i status usługi, a następnie przejrzyj ostatnie udane zdarzenie. Ponów nieudane połączenie niezależnie od wszelkich akcji biznesowych, które mogły już zostać wykonane.
Jaki budżet przewidzieć na wywołania API Grok Voice 3.0?
Korzystanie z głosu i integracje niestandardowe mogą generować osobne opłaty. W tym samouczku istotne stawki to sesja w czasie rzeczywistym i wejścia tekstowe; samodzielne usługi transkrypcji i generowania mowy to oddzielne produkty.
Sesja mowa‑na‑mowę: 0,08 USD za minutę, czyli 4,80 USD za godzinę.
Wejście tekstowe podczas sesji głosowej: 0,004 USD za każde wejście tekstowe.
Na przykład 500 rozliczalnych minut sesji odpowiada 40 USD podstawowych opłat za głos. To oszacowanie nie obejmuje wejść tekstowych, opcjonalnych narzędzi, telefonii i Twojej infrastruktury. Zacznij od krótkich sesji testowych i zamykaj bezczynne połączenia po zakończeniu rozmowy.
Podsumowanie
Zacznij od jednego pełnego przejścia Grok Voice 3.0: połącz się, skonfiguruj sesję, wyślij prompt, odbierz audio i odtwórz wynik. Gdy ta ścieżka działa, dodaj nagrane wypowiedzi, a potem zbuduj przechwytywanie z mikrofonu i strumieniowe odtwarzanie. Wprowadzaj narzędzia biznesowe dopiero po ustabilizowaniu ścieżek rozmowy i obsługi błędów.