
TL;DR
DeepSeek-V4.1-Flash ma otwarte wagi i może być hostowany samodzielnie, ale „lokalnie” nie oznacza „na komputerze do gier”. DeepSeek opisuje go jako trzon MoE o 552 mld parametrów z architekturą Causal Encoder-Decoder; aktywne jest 8 mld parametrów podczas przetwarzania promptu i 16 mld podczas generacji. Pełny model pozostaje celem wdrożeń klasy frontier.
Obecna recepta wdrożeniowa vLLM określa rozmiar checkpointu na około 511 GB na dysku i co najmniej 614 GB VRAM, co sprawia, że serwer klasy 8×H200 lub porównywalny system o dużej pamięci jest znacznie bardziej realistyczny niż stacja robocza użytkownika.
Dla zespołów, które potrzebują jedynie dostępu, a nie kontroli nad wagami, DeepSeek V4.1 Flash API w CometAPI jest znacząco prostsze niż utrzymanie serwera inferencyjnego na wielu GPU.
Kluczowe wnioski
- DeepSeek-V4.1-Flash wykorzystuje trzon MoE 552B z 8B aktywnymi parametrami podczas prefill i 16B podczas dekodowania; aktywne parametry nie odzwierciedlają wymaganej pamięci rezydentnej.
- Jego kontekst 1 048 576 tokenów i globalna pamięć podręczna KV 890 bajtów na token zmniejszają presję na cache, ale w planowaniu pojemności nadal dominują wagi modelu.
- Oficjalny checkpoint ma około 511 GB na dysku. Recepta vLLM szacuje około 614 GB łącznej użytecznej pamięci VRAM jako minimalny budżet na załadowanie modelu i narzut środowiska wykonawczego; to szacunek bazowy, nie gwarancja dla każdego rozmiaru wsadu, długości kontekstu czy konfiguracji multimodalnej.
- vLLM jest najczystszą ścieżką do serwowania produkcyjnego, SGLang celuje w zaawansowaną rozproszoną inferencję; obecnie ścieżka Ollamy to hosting w chmurze, a nie pełna lokalna inferencja.
- Samodzielny hosting jest najbardziej przekonujący ze względu na prywatność, pracę w odizolowaniu (air‑gapped), badania na poziomie wag lub stałe wykorzystanie klastra; większości deweloperów prostsze wyda się hostowane API.
Czym jest DeepSeek-V4.1-Flash? Architektura, parametry i rozmiar modelu
DeepSeek oficjalnie wydał V4.1-Flash 10 września 2026 jako najmniejszy model w nowej rodzinie architektur, z natywnym rozumieniem obrazu. Mimo nazwy „Flash” nie jest to mały gęsty model.
Kluczową zmianą architektoniczną jest kauzalna architektura Encoder-Decoder (CED). Model asymetrycznie dzieli obliczenia między wczytywanie promptu a generację tokenów, zmniejszając aktywną moc obliczeniową przy zachowaniu bardzo dużej puli ekspertów.
| Specyfikacja | DeepSeek-V4.1-Flash |
|---|---|
| Architektura | Multimodalny MoE z Causal Encoder-Decoder |
| Parametry trzonu | 552B |
| Aktywne parametry, wejście | 8B |
| Aktywne parametry, wyjście | 16B |
| Warstwy transformera | 40: 20 encoder + 20 decoder |
| Okno kontekstu | 1,048,576 tokenów |
| Globalna pamięć podręczna KV | 890 bajtów/token |
| Modalności | Wejście tekst + obraz, wyjście tekst |
| Licencja wag | MIT |
| Zalecane próbkowanie | Temperatura 1.0; top_p 0.95 lub 1.0 |
| Oficjalne wagi | Hugging Face |
| Główne opcje lokalnego serwowania | vLLM, SGLang, DeepSeek reference inference |
Rozróżnienie między aktywnymi parametrami a parametrami rezydentnymi jest kluczowe. Trasowanie MoE zmniejsza ilość obliczeń używanych dla pojedynczego tokenu, ale serwer nadal potrzebuje dostępu do wag ekspertów, które mogą zostać wybrane. Dlatego model „8B aktywnych” może nadal wymagać setek gigabajtów pamięci masowej i pamięci akceleratora.
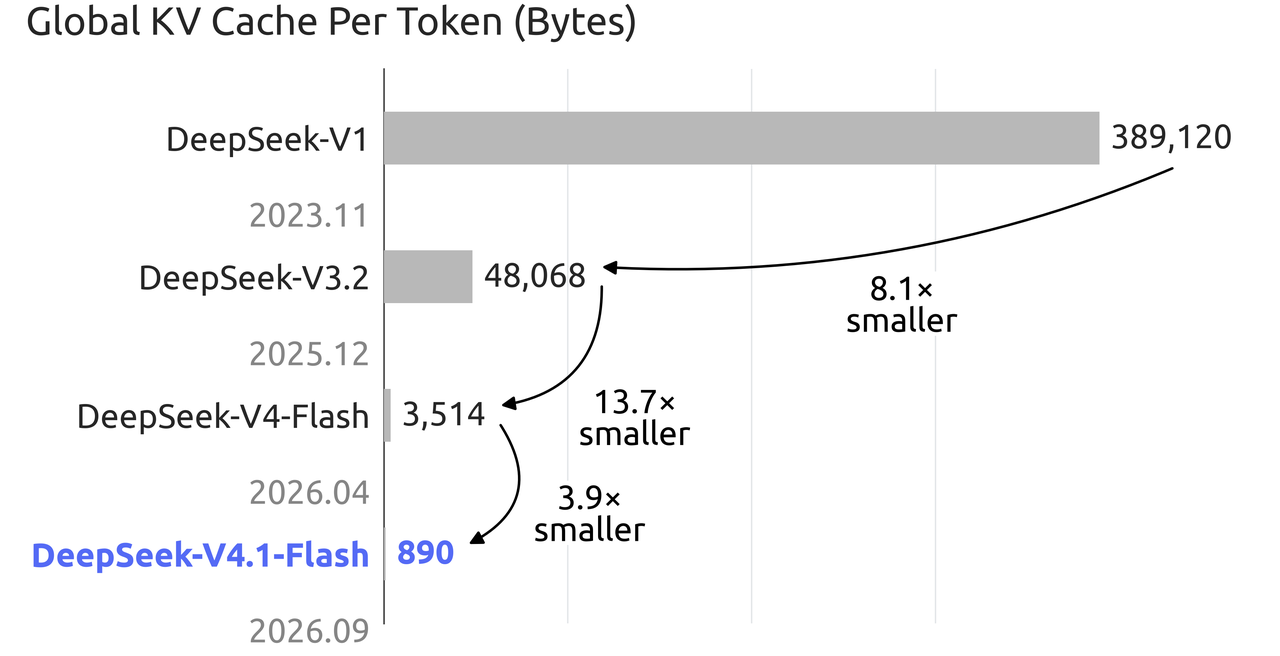
Oficjalny wykres KV-cache DeepSeeka pokazuje spadek globalnej pamięci podręcznej z 3 514 bajtów na token w V4 Flash do 890 bajtów na token w V4.1 Flash, czyli około 3,9×. Ma to znaczenie dla inferencji na milionie tokenów, ale nie eliminuje znacznie większego zapotrzebowania na pamięć ze względu na same wagi modelu.
Jak dobry jest DeepSeek-V4.1-Flash zanim go wdrożysz?
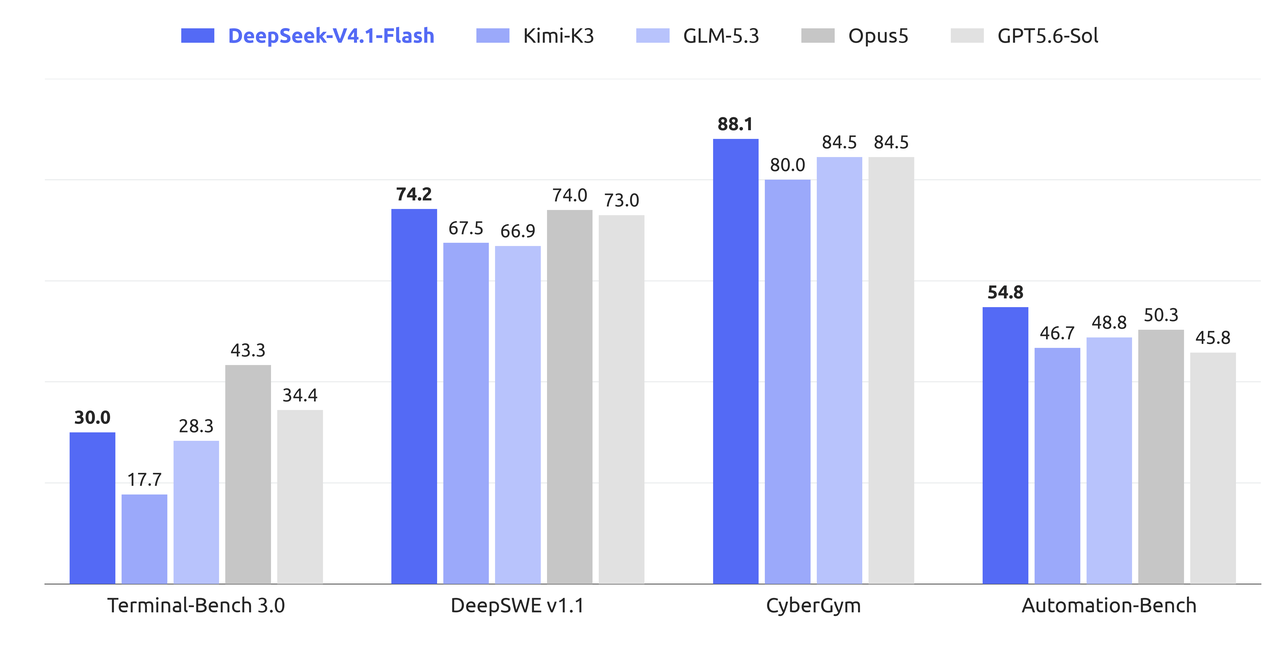
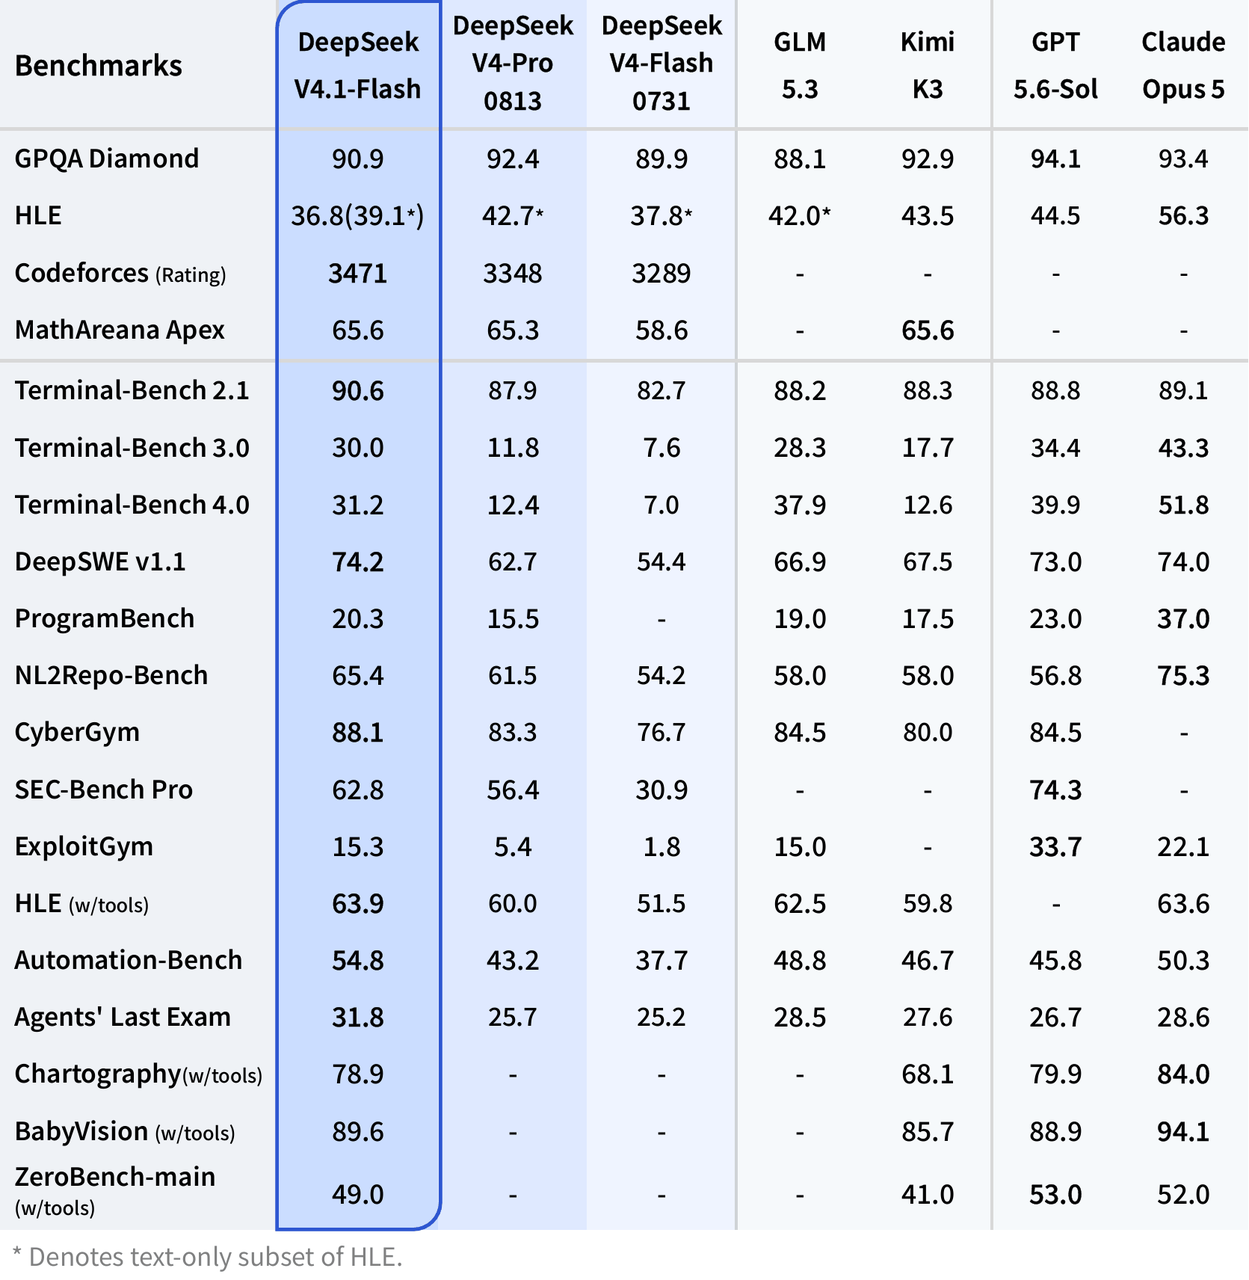
Opublikowana przez DeepSeeka tabela benchmarków pozycjonuje V4.1-Flash głównie jako duży skok w agentowym kodowaniu, operacjach terminalowych, automatyzacji i zadaniach inżynierii oprogramowania. To są wyniki benchmarków raportowane przez dostawcę, więc należy traktować je jako pomiary referencyjne, a nie gwarantowaną wydajność w aplikacji.
Dla odtwarzalności, oficjalna karta modelu zaleca temperaturę 1.0 i top_p 0.95, podczas gdy nakład wysiłku rozumowania i budżety tokenów różnią się w zależności od ewaluacji. Poniższe liczby to wyniki referencyjne uruchomione przez dostawcę, a nie sprzętowo neutralne gwarancje wydajności; przed replikacją należy zapoznać się ze szczegółami specyficznymi dla danego benchmarku.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Wzorzec jest ważniejszy niż pojedynczy wynik. V4.1-Flash nie prowadzi w każdym benchmarku, ale skok względem V4 Flash 0731 jest szczególnie duży w Terminal-Bench, DeepSWE, automatyzacji i cyberbezpieczeństwie. Sprawia to, że lokalne wdrożenie ma duże znaczenie dla prywatnych agentów kodujących, analizy w skali repozytorium, wewnętrznej automatyzacji i odizolowanej (air‑gapped) infrastruktury agentów.
Czy naprawdę możesz uruchomić DeepSeek-V4.1-Flash lokalnie?
Tak, ale słowo „lokalnie” wymaga doprecyzowania. Najnowsza recepta vLLM dla DeepSeek-V4.1-Flash rozbija checkpoint na około pół terabajta i zaleca znacznie większy budżet VRAM po uwzględnieniu narzutu środowiska wykonawczego.
| Składnik | Przybliżony rozmiar na dysku |
|---|---|
| Eksperci routed + DSpark | 259.5 GiB |
| Tablice Engram | 183.1 GiB |
| Attention, gęste projekcje i routery | 6.9 GiB |
| Osadzenia, głowica LM i normy | 3.9 GiB |
| Skale bloków UE8M0 | 21.9 GiB |
| Pełny checkpoint | ~476 GiB / ~511 GB |
| Zalecany minimalny budżet VRAM (vLLM) | ~614 GB |
Kluczowe zaskoczenie polega na tym, że V4.1-Flash jest już wewnętrznie silnie skompresowany. Wagi ekspertów routed używają formatów niskiej precyzji, więc oficjalny checkpoint to nie po prostu ogromny model BF16 czekający na łatwą konwersję do 4 bitów.
Wymagania sprzętowe DeepSeek-V4.1-Flash
| Konfiguracja sprzętowa | Status praktyczny | Uwagi |
|---|---|---|
| 1× RTX 4090 / 5090 | Nie | Zdecydowanie poniżej śladu pamięciowego modelu |
| 2–4 konsumenckie GPU | Nie dla oficjalnego pełnego checkpointu | Łączny VRAM nadal niewystarczający |
| Stacja robocza 128 GB | Nie | Aktywne parametry nie determinują pamięci wag rezydentnych |
| Stacja robocza 256 GB | Nie dla oficjalnej ścieżki | Nadal znacznie poniżej rozmiaru oficjalnego checkpointu |
| 512 GB RAM + offload GPU | Eksperymentalnie | Obszar community/offload, nie równoważny zweryfikowanemu serwowaniu produkcyjnemu |
| 4× GPU z dużą pamięcią | Zależne od sprzętu | Możliwe z wystarczająco dużymi nowoczesnymi akceleratorami; sprawdź receptę runtime |
| 8× H200 | Tak, udokumentowana klasa | Około 1 128 GB łącznego HBM |
| System klasy GB200 NVL4 | Tak | vLLM podaje, że tacka 768 GB mieści model |
Ważne: 8B aktywnych parametrów nie oznacza 8 GB VRAM. „Aktywne” opisuje, jaka część sieci MoE uczestniczy w obliczeniach dla tokenu. Kompletny zbiór ekspertów nadal musi być przechowywany w miejscu dostępnym dla silnika inferencyjnego.
Którego środowiska uruchomieniowego użyć dla DeepSeek-V4.1-Flash?
| Runtime | Obecny status V4.1-Flash | Najlepsze zastosowanie |
|---|---|---|
| vLLM | Dostępna bieżąca recepta wdrożeniowa; wymaga świeżego obrazu | Produkcyjne serwowanie zgodne z OpenAI |
| SGLang | Wspierany przez bieżące buildy wdrożeniowe DeepSeek-V4.1 | Wysokowydajna rozproszona inferencja |
| DeepSeek reference inference | Oficjalna implementacja referencyjna TP8 | Badania architektury i walidacja |
| Transformers | Integracja modelu dostępna na Hugging Face | Rozwój i eksperymenty; nadal wymagany sprzęt |
| Ollama | Oficjalna ścieżka biblioteki obecnie używa :cloud | Wygodne wywołanie w chmurze, nie równoważne self‑hostingowi |
Dla produkcyjnego self‑hostingu vLLM jest obecnie najczystszym punktem wyjścia. Wytyczne wdrożeniowe SGLang zapewniają inną wspieraną ścieżkę dla zaawansowanej rozproszonej inferencji.
Jak uruchomić DeepSeek-V4.1-Flash lokalnie z vLLM
To praktyczna ścieżka dla wielo‑GPU serwera Linux.
Wszystkie przykłady poleceń poniżej zostały przeformatowane jako blok kodu dla danego języka z krótkimi angielskimi opisami.
Krok 1: Sprawdź środowisko
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Kilkaset gigabajtów wolnego miejsca na SSD.
- Wspierana konfiguracja z wieloma GPU.
- Około 614 GB łącznej użytecznej pamięci akceleratorów dla obecnego profilu serwowania oficjalnych wag.
- Szybka sieć, jeśli model nie jest jeszcze zcache’owany lokalnie.
Krok 2: Pobierz wagi DeepSeek-V4.1-Flash
Oficjalne wagi są hostowane w repozytorium DeepSeek-V4.1-Flash na Hugging Face na licencji MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Upewnij się, że system plików, na którym znajduje się ~/.cache/huggingface, ma znacznie więcej niż 511 GB wolnego miejsca. Pliki tymczasowe i dodatkowe artefakty silnika mogą zwiększyć szczytowe użycie dysku.
Krok 3: Uruchom DeepSeek-V4.1-Flash z vLLM
Według bieżącej recepty vLLM, wsparcie DeepSeek-V4.1 wymaga wystarczająco świeżego obrazu vLLM. Tekstowa konfiguracja startowa dla ośmiu GPU może wyglądać następująco:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Znajdują się tu dwa zamierzone wybory. Po pierwsze, --language-model-only wyłącza enkoder wizji dla obciążeń tylko tekstowych. Po drugie, start od 131 072 tokenów jest bezpieczniejszy niż natychmiastowe włączanie pełnego kontekstu miliona tokenów. Gdy serwer będzie stabilny, możesz to zwiększyć:
--max-model-len 1048576
Odpowiednie ustawienie równoległości tensora zależy od topologii akceleratorów, więc nie kopiuj bezrefleksyjnie --tensor-parallel-size 8 na każdy serwer.
Krok 4: Przetestuj lokalny endpoint DeepSeek-V4.1-Flash
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "Ile to jest 17 * 19? Zwróć wyłącznie liczbę całkowitą."
      }
    ]
  }'
323
Krok 5: Wywołaj lokalny serwer DeepSeek-V4.1-Flash w Pythonie
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Wyjaśnij różnice między TCP a UDP w trzech punktach."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Jak włączyć lokalnie tryb myślenia w DeepSeek-V4.1-Flash?
V4.1-Flash wspiera jawne sterowanie rozumowaniem poprzez szablon czatu. Przykład:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Znajdź najbardziej wydajny algorytm dla tego problemu szeregowania."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Jeśli model wydaje się zwracać niewiele lub wcale treści końcowej przy małej wartości max_tokens, sprawdź, czy tryb myślenia nie zużywa budżetu generacji, zanim uznasz, że wdrożenie jest zepsute.
Jak uruchomić DeepSeek-V4.1-Flash z kodem referencyjnym?
DeepSeek dołącza również minimalną implementację inferencji TP8 wewnątrz repozytorium modelu. Jest przeznaczona przede wszystkim jako czytelny kod referencyjny, a nie wysoko‑przepustowy serwer produkcyjny.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Ta ścieżka jest przydatna do inspekcji CED, trasowania MoE, pamięci Engram, dekodowania spekulatywnego i pokrewnych szczegółów implementacyjnych. Do normalnego serwowania produkcyjnego łatwiejsze w obsłudze są vLLM lub SGLang.
Czy można uruchomić DeepSeek-V4.1-Flash lokalnie z Ollamą?
Nie w takim samym sensie, jak zwykły model Ollamy 7B lub 32B. Ollama obecnie udostępnia V4.1-Flash poprzez:
ollama run deepseek-v4.1-flash:cloud
Ważna część to :cloud. Obecny wpis biblioteki Ollamy używa ścieżki chmurowej, więc to polecenie nie jest równoważne pobraniu pełnego modelu i wykonywaniu inferencji w całości na Twojej maszynie.
Lokalny DeepSeek-V4.1-Flash vs API: co ma więcej sensu?
| Wymiar | Lokalny DeepSeek-V4.1-Flash | Hostowane API |
|---|---|---|
| Nakłady sprzętowe | Bardzo wysokie | Brak |
| Pamięć akceleratora | ~614 GB praktyczny oficjalny cel | Zarządzana przez dostawcę |
| Kontrola nad modelem | Pełna | Ograniczona |
| Dane pozostają on‑premises | Tak | Nie |
| Modyfikacja wag | Tak | Nie |
| Utrzymanie | Twoja odpowiedzialność | Zarządzane przez dostawcę |
| Złożoność konfiguracji | Wysoka | Niska |
| Skalowanie | Wymaga infrastruktury | Oparte na API |
| Najlepsze dla | Air‑gapped, prywatność, badania, klastry o wysokim wykorzystaniu | Większość deweloperów i aplikacji produkcyjnych |
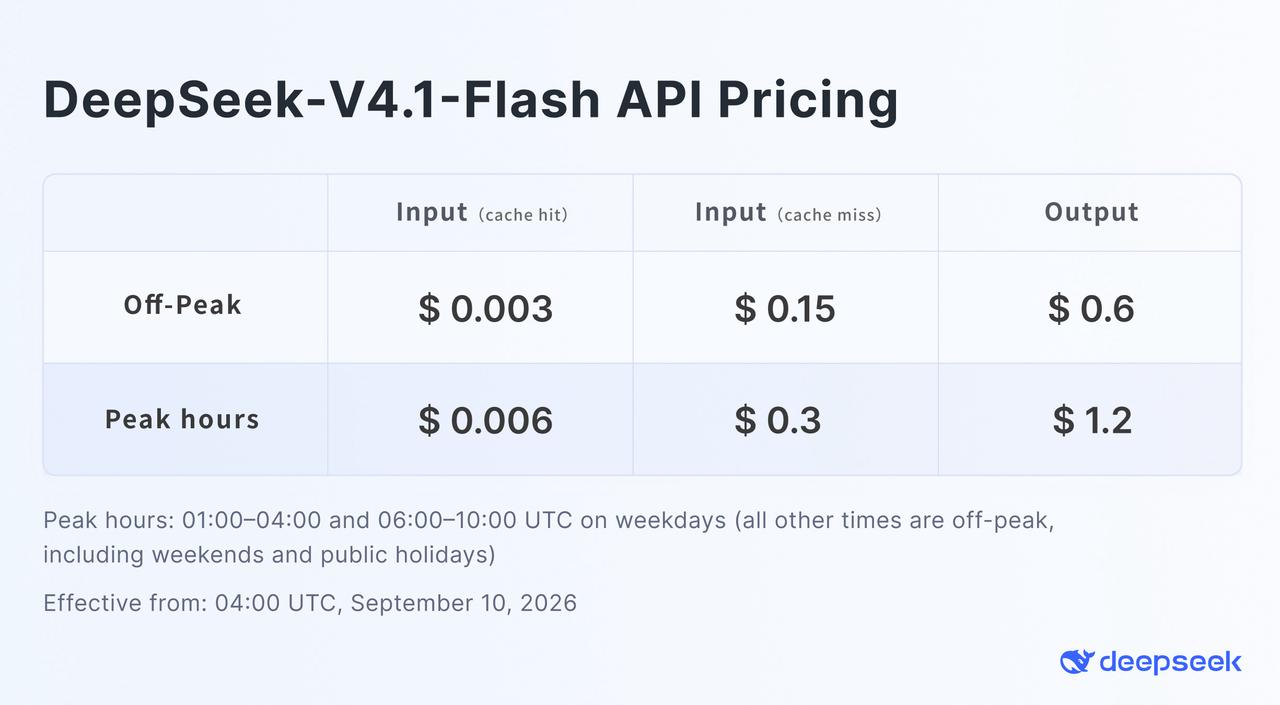
Oficjalne ceny off‑peak DeepSeeka pokazano na grafice cenowej V4.1-Flash. Dla deweloperów, którzy nie potrzebują fizycznego posiadania wag, DeepSeek V4.1 Flash API w CometAPI zapewnia alternatywę zgodną z OpenAI‑API.
Poniższy przykład używa identyfikatora modelu CometAPI. Nie jest to identyfikator używany przez oficjalne API DeepSeeka.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Przejrzyj tę funkcję w Pythonie i wskaż możliwe warunki wyścigu."
        }
    ]
)

print(response.choices[0].message.content)
Praktyczna decyzja jest prosta: lokalne wdrożenie staje się przekonujące, gdy prywatność, odizolowane środowisko (air‑gapped), eksperymenty na poziomie wag, przewidywalne wysokie wykorzystanie lub wymagania regulacyjne przeważają nad kosztem infrastruktury. Dla zwykłego rozwoju aplikacji hostowany endpoint pozwala uniknąć setek gigabajtów zarządzania modelem i orkiestracji wielu GPU.
Jakie problemy możesz napotkać podczas lokalnego uruchamiania DeepSeek-V4.1-Flash?
Serwer kończy pamięć zanim rozpocznie się generacja
O wymaganiach pamięci w największym stopniu decyduje pełny checkpoint, a nie liczby 8B/16B aktywnych parametrów. Sprawdź równoległość tensora, wykorzystanie pamięci GPU, ładowanie wizji i dostępne HBM.
DeepSeek-V4.1-Flash długo się uruchamia
Checkpoint o rozmiarze pół terabajta wymaga czasu na pobranie, zmapowanie, inicjalizację i podział. Długie czasy oczekiwania na gotowość silnika są normalne dla tej klasy modelu.
Odpowiedź jest pusta lub kończy się finish_reason=length
Tryb myślenia może zużywać budżet generacji. Zwiększ max_tokens, obniż nakład rozumowania lub wyłącz myślenie dla prostych żądań.
Wywołania narzędzi nie parsują się poprawnie
Upewnij się, że serwer używa tokenizera DeepSeek V4.1, parsera wywołań narzędzi, parsera rozumowania oraz flag automatycznego wyboru narzędzi.
Wejście wizualne nie działa
Jeśli uruchomiłeś z --language-model-only, celowo wyłączyłeś enkoder wizji. Uruchom ponownie z włączoną obsługą multimodalną przed testowaniem obrazów.
Czy warto uruchamiać DeepSeek-V4.1-Flash lokalnie?
DeepSeek-V4.1-Flash jest wyjątkowo interesujący z perspektywy self‑hostingu, ponieważ jego architektura znacząco redukuje koszt obliczeń na token i koszt pamięci KV, ale nie zamienia modelu klasy frontier z otwartymi wagami w model „desktopowy”.
Dla laboratorium badawczego, platformy AI w przedsiębiorstwie, prywatnego stosu agentów kodujących lub środowiska air‑gapped, vLLM i SGLang czynią self‑hosting technicznie realistycznym. Dla dewelopera z jedną lub dwiema kartami GPU nie jest to praktyczny cel pełnego wdrożenia. W takim przypadku użycie DeepSeek V4.1 Flash przez CometAPI zapewnia dostęp do modelu bez zamieniania serwowania w duży projekt infrastrukturalny.
FAQ
Czy DeepSeek-V4.1-Flash jest open source?
Jego wagi i repozytorium wydano na licencji MIT, która dopuszcza szerokie użycie, modyfikację i redystrybucję zgodnie z warunkami licencji.
Czy mogę uruchomić DeepSeek-V4.1-Flash na RTX 4090 lub RTX 5090?
Nie, nie pełny oficjalny model. Pojedyncze konsumenckie GPU ma tylko ułamek wymaganej pamięci przez pełny checkpoint.
Czy 8B aktywnych parametrów oznacza, że DeepSeek-V4.1-Flash potrzebuje tylko 8 GB VRAM?
Nie. Liczba 8B opisuje parametry uczestniczące podczas przetwarzania promptu. Pełna sieć ekspertów i stan wspierający nadal muszą być przechowywane i dostępne.
Ile VRAM potrzebuje DeepSeek-V4.1-Flash?
Obecna recepta vLLM używa około 614 GB jako wartości planistycznej dla oficjalnego checkpointu plus narzut runtime. Faktyczne potrzeby zależą od sprzętu, rozmiaru wsadu, kontekstu, wsparcia wizji i konfiguracji serwowania.
Jak duży jest DeepSeek-V4.1-Flash na dysku?
Obecny podział vLLM określa checkpoint na około 476 GiB, czyli około 511 GB.
Czy DeepSeek-V4.1-Flash może lokalnie obsłużyć kontekst 1M tokenów?
Architektura wspiera do 1 048 576 tokenów, ale praktyczne użycie pamięci zależy też od rozmiaru wsadu, buforów runtime, stanu wizji i innego narzutu.
Czy mogę uruchomić DeepSeek-V4.1-Flash lokalnie z Ollamą?
Obecny wpis Ollamy używa ścieżki :cloud, co nie jest tym samym, co uruchamianie pełnych wag w całości na własnej maszynie.
Czy lepszy jest vLLM czy SGLang dla DeepSeek-V4.1-Flash?
Oba celują w wysokowydajne serwowanie. vLLM ma obecnie szczególnie szczegółową receptę dla V4.1, podczas gdy SGLang także nadaje się do zaawansowanych rozproszonych wdrożeń.
Jaki jest najłatwiejszy sposób użycia DeepSeek-V4.1-Flash bez lokalnego sprzętu?
Użyj hostowanego API. DeepSeek zapewnia własne API, a CometAPI oferuje endpoint DeepSeek-V4.1-Flash zgodny z OpenAI obok innych modeli AI.