
Szybkie podsumowanie: Aby używać Claude Fable 5.1 API w CometAPI, przygotuj klucz API, ustaw identyfikator modelu na claude-fable-5-1 i zweryfikuj małe zapytanie przed budową dłuższego workflow. Ten przewodnik obejmuje dostęp, effort, streaming, narzędzia, cache, migrację i kontrole produkcyjne. Traktuj wdrożenie jako coś więcej niż zmianę nazwy modelu: potwierdź kompatybilność tras, zweryfikuj wyniki i zmierz jakość zadań zaliczonych do akceptacji, opóźnienie oraz koszt przed rozszerzeniem użycia.
Kluczowe wnioski
- Najpierw uruchom jedno działające zapytanie: potwierdź dane uwierzytelniające, dostęp do modelu, wybrany endpoint i użyteczną odpowiedź na niesensytywnych danych testowych.
- Wybieraj poziom effort świadomie: zacznij od wysokiego, a następnie porównuj inne ustawienia na reprezentatywnych zadaniach zamiast używać maksymalnego effort dla każdego żądania. Claude Code domyślnie ustawia High. Claude Cowork / Claude.ai domyślnie ustawia Medium
- Przejrzyj zachowania migracyjne: wymuszony wybór narzędzia jest odrzucany; zachowaj wymagane kroki workflow i walidację argumentów narzędzi w kodzie aplikacji.
- Mierz kompletny workflow: śledź użycie cache, koszt tokenów, opóźnienie, odmowy, zachowanie fallbacków oraz to, czy wynik końcowy przechodzi Twoje testy akceptacyjne.
Dodatkowe informacje: wcześniejszy tracker Fable 5.1 CometAPI i samouczek Fable 5 API. Ten artykuł koncentruje się na bieżącym workflow integracji.
Czym jest Claude Fable 5.1?
Claude Fable 5.1 to najbardziej zaawansowany ogólnodostępny model Anthropic do ambitnego kodowania, wieloetapowych badań, obsługi komputera i profesjonalnych workflow z dużą liczbą dokumentów. Anthropic zaleca rozpoczynanie większości obciążeń od Claude Opus 5 i eskalację do Fable 5.1, gdy wysokowysiłkowe oceny Opus nadal nie wystarczają.
Różnica jest operacyjna: Fable 5.1 został zaprojektowany tak, aby działać przez zależne kroki, odzyskiwać sprawność po nieudanym wywołaniu narzędzia, weryfikować wyniki oraz raportować postępy podczas długich uruchomień. To może poprawić współczynniki ukończeń, ale jednocześnie czyni koszt, opóźnienie i obserwowalność kluczowymi przy wdrożeniu.
Specyfikacja Claude Fable 5.1 API
| Oficjalna specyfikacja | Claude Fable 5.1 |
|---|---|
| Dostawca | Anthropic |
| Identyfikator modelu | claude-fable-5-1 |
| Data wydania | September 1, 2026 |
| Okno kontekstu | 1,000,000 tokens |
| Maksymalna odpowiedź | 128,000 tokens |
| Wejście i wyjście | Tekst i obrazy do tekstu |
| Rozumowanie | Adaptacyjne, zawsze włączone |
| Domyślny effort | API to High, Claude Code domyślnie High, Claude Cowork / Claude.ai domyślnie Medium |
| Poziomy effort | low, medium, high, xhigh, max |
| Granica wiedzy | June 2026 |
| Oficjalna cena | $10 input / $50 output per million tokens |
| Odczyt z cache | $0.25 per million tokens |
Oficjalny przegląd potwierdza okno kontekstu 1M i maksymalny output 128K. Adaptacyjne rozumowanie jest zawsze aktywne; głębokość rozumowania kontrolowana jest parametrem effort, a nie tradycyjnym budżetem tokenów myślenia.
Claude Fable 5.1 API: oficjalne wyniki benchmarków
Podsumowanie benchmarków jest celowo zwięzłe, ponieważ głównym celem artykułu jest wdrożenie. Wyniki poniżej wskazują, gdzie premia API najczęściej ma znaczenie.
| Benchmark Anthropic | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1,853 Elo | 1,723 | 1,824 | 1,711 |
| OSWorld 2.0, partial | 77.9% | 72.9% | 75.4% | — |
| Humanity's Last Exam, no tools | 60.9% | 57.8% | 56.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
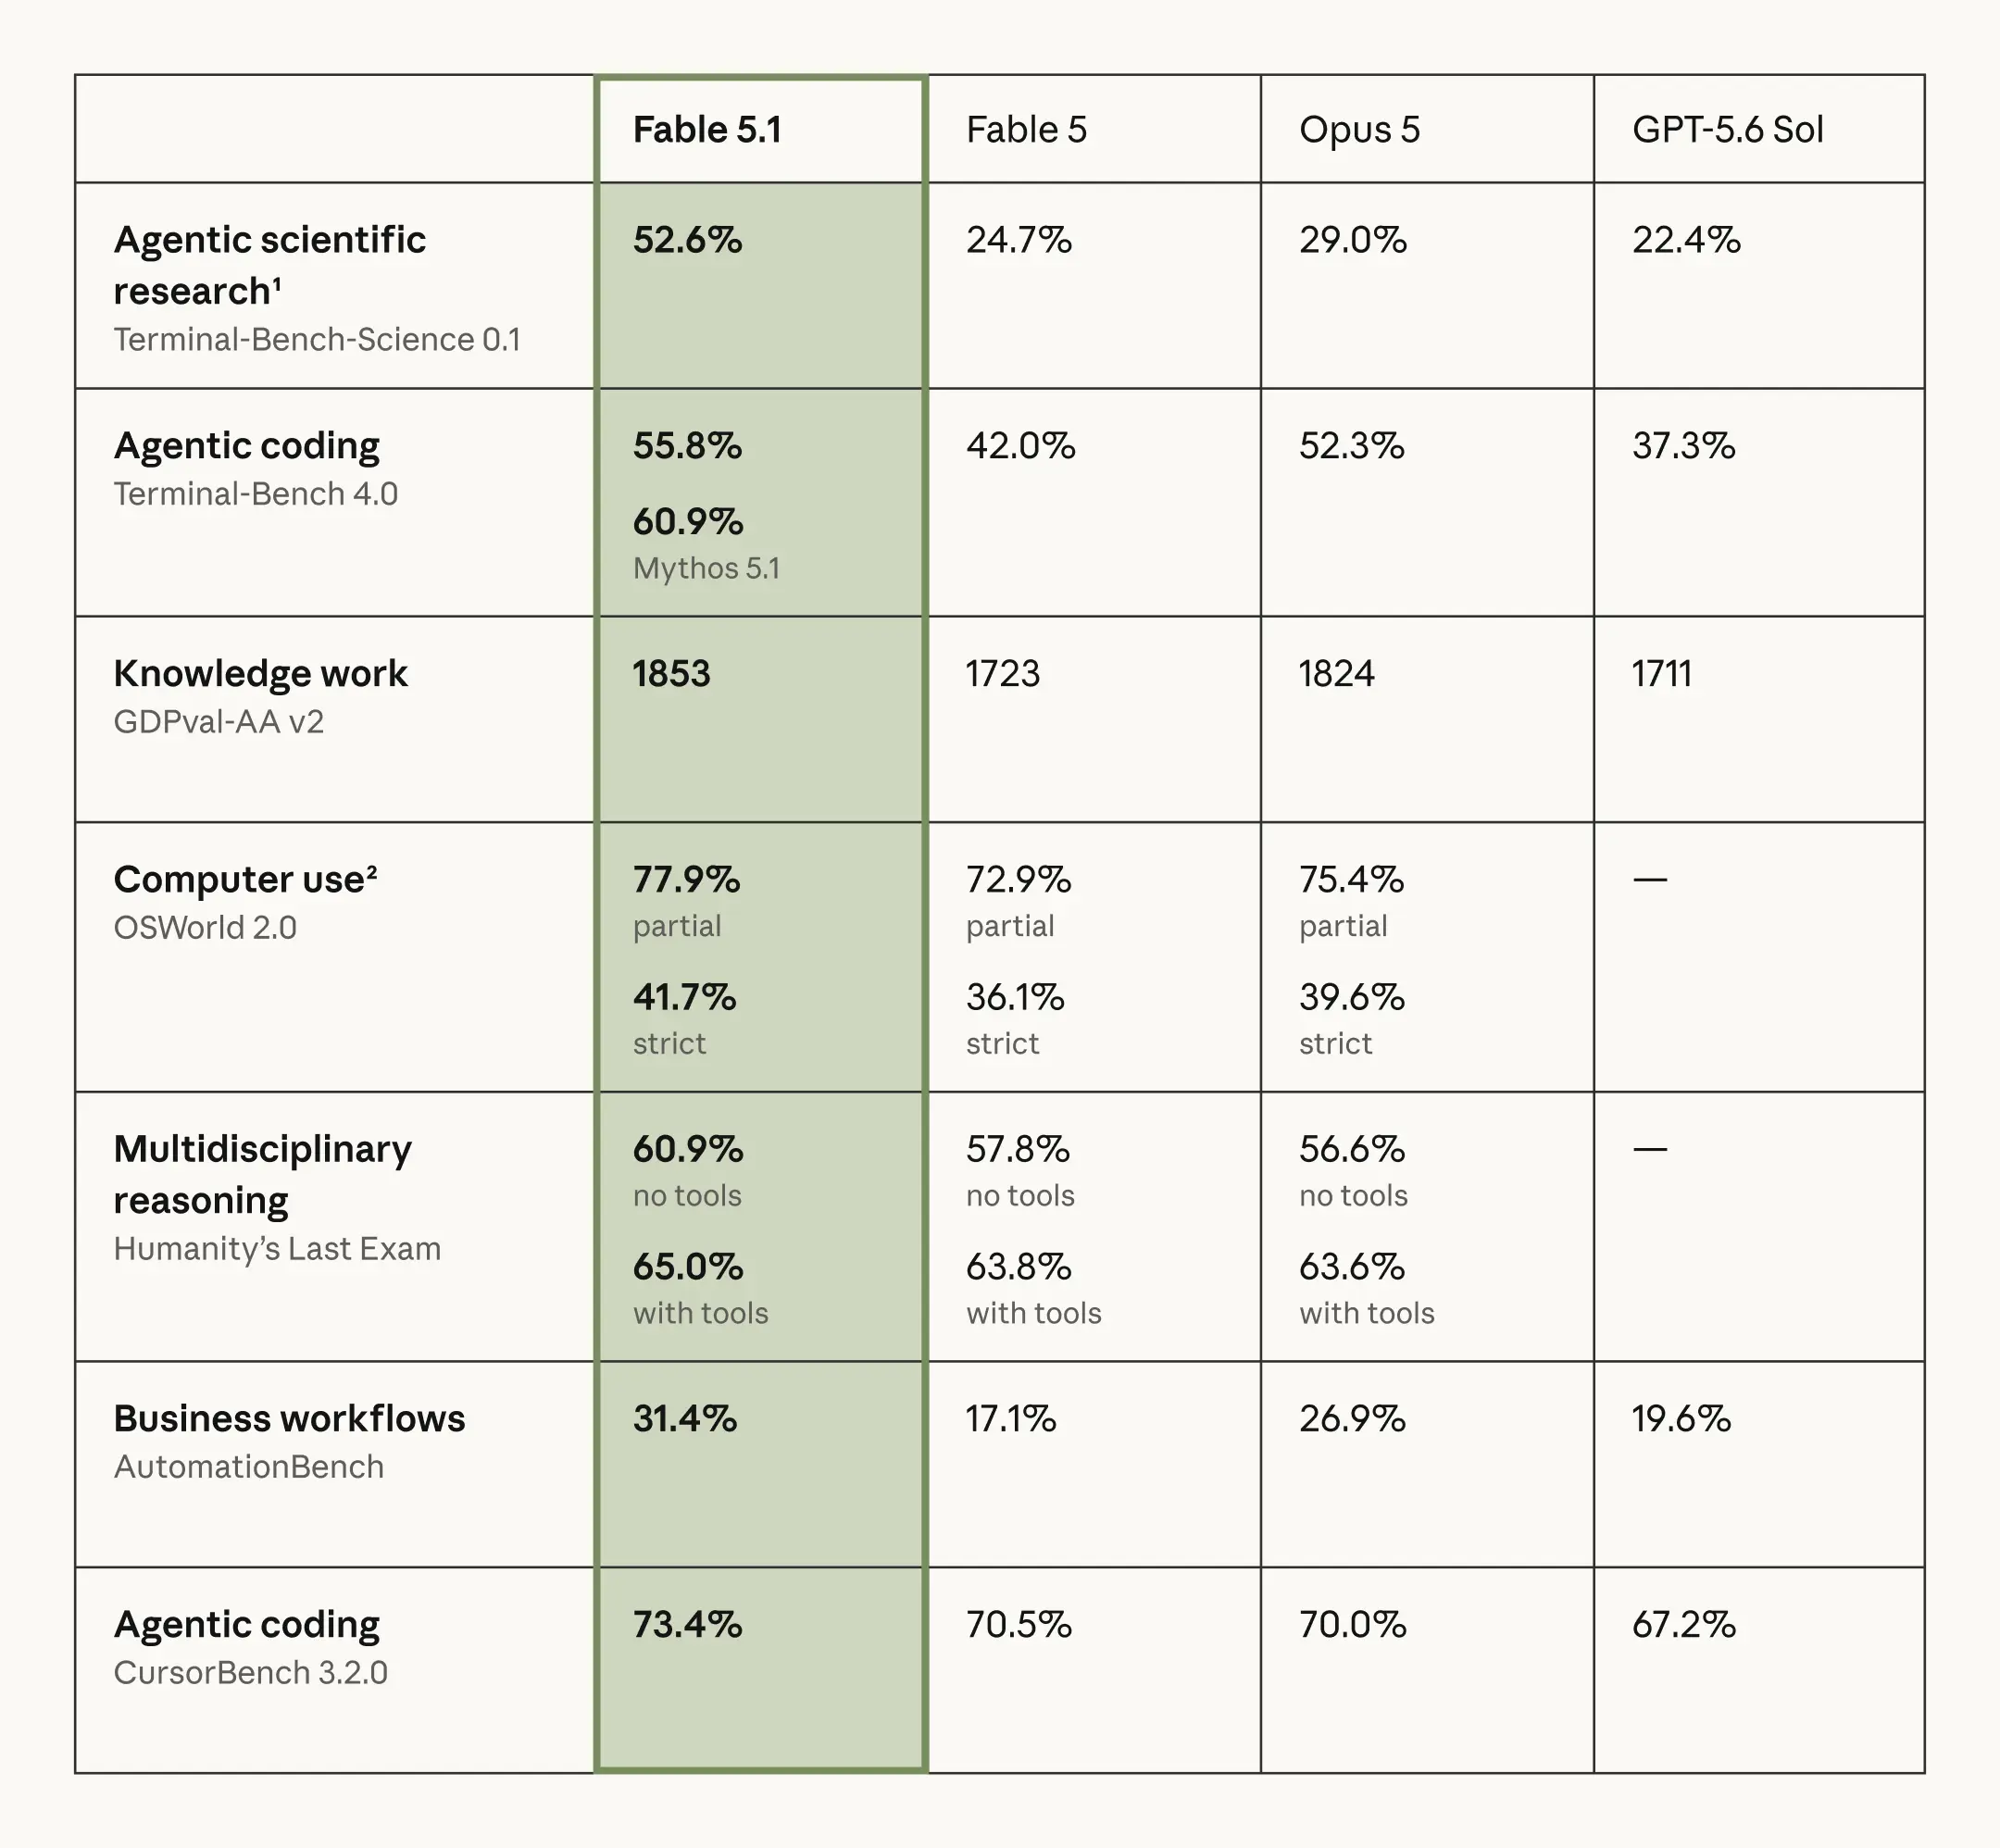
Oficjalne porównanie benchmarków Claude Fable 5.1 od Anthropic
Największy przyrost generacyjny w tym zestawie to Terminal-Bench-Science: 52.6% versus 24.7%. AutomationBench rośnie z 17.1% do 31.4%, a Terminal-Bench 4.0 poprawia się do 55.8%. To silny argument za testowaniem Fable 5.1 w agentach badawczych, długotrwałym kodowaniu i automatyzacji biznesowej — nie za kierowaniem każdego krótkiego żądania do najdroższego modelu.
Co zmieniło się względem Claude Fable 5 API?
| Wymiar | Claude Fable 5.1 | Claude Fable 5 | Wpływ migracji |
|---|---|---|---|
| Główna rola | Silniejsze długotrwałe agenty i badania | Oryginalny publiczny model klasy Mythos | Ponownie oceń najtrudniejsze workflow |
| Wymuszony wybór narzędzia | Zwraca błąd | Wcześniej wspierane | Usuń wymuszanie any i nazwanych |
| Historia myślenia | Surowsze zasady kompatybilności | Wcześniejsze zachowanie | Utrzymuj historie append-only |
| Aktualizacje postępu | Czytelne aktualizacje między wywołaniami narzędzi | Niedostępne w tej formie | Udostępniaj status długich runów |
| Effort per-message | Dostępne w becie | Niedostępne w tej formie | Stroj głębokość w obrębie rozmowy |
| Cena odczytu cache | $0.25 / MTok | $1.00 / MTok | Przelicz ekonomię długich kontekstów |
| Cena wej./wyj. | $10 / $50 per MTok | $10 / $50 per MTok | Brak zmiany cennika |
Trzy zmiany niekompatybilne wstecz
Wymuszone użycie narzędzia nie jest już wspierane
Claude Fable 5.1 odrzuca wartości tool_choice, które wymuszają dowolne narzędzie lub konkretne nazwane narzędzie, zwracając błąd 400 invalid-request. Zachowaj automatyczny wybór, używaj ścisłych schematów lub struktur wyjścia do walidacji, a obowiązkowe kroki workflow egzekwuj w orkiestracji aplikacji zamiast wymuszać wywołanie narzędzia przez model.
Wcześniejsze modele nie odczytują bloków myślenia Fable 5.1
Kompatybilność myślenia jest jednokierunkowa: Fable 5.1 może konsumować bloki myślenia stworzone przez wcześniejsze kompatybilne modele Claude, ale wcześniejsze modele nie mogą czytać bloków stworzonych przez Fable 5.1. Router lub fallback przełączający na wcześniejszy model może odrzucić te bloki przed inferencją, więc integracje powinny logować przełączenia modeli i jawnie testować zachowanie fallbacku.
Edytowanie wcześniejszych tur unieważnia zachowane myślenie
Zmiana wcześniejszego system promptu, definicji narzędzia, wiadomości lub bajtów pliku referencjonowanego może unieważnić późniejsze bloki myślenia. Traktuj prefiks rozmowy jako append-only, używaj instrukcji w środku rozmowy zamiast przepisywać historię i monitoruj transformacje wynikające z niedopasowania prefiksu podczas migracji.
Pięć dodatkowych możliwości API
Effort per-message
Aplikacje mogą zmieniać effort w trakcie rozmowy bez unieważniania cache promptu. Ta funkcja beta pozwala obniżać effort przy rutynowych turach i podnosić go dla trudnego planowania, debugowania lub weryfikacji.
System messages ograniczone do tury
Wiadomość systemowa w becie może działać przez jedną turę, a następnie przestać renderować po kolejnej wiadomości użytkownika, pozostając niezmieniona w historii. To przydatne dla tymczasowych instrukcji w pętlach narzędzi, ponieważ zachowuje zgodność cache promptu i ważność późniejszych bloków myślenia.
Czytelne aktualizacje postępu między wywołaniami narzędzi
Z opcją beta wyświetlania postępu wybrane bloki myślenia mogą zawierać krótkie aktualizacje statusu, które aplikacja może pokazywać użytkownikom, podczas gdy prywatne rozumowanie pozostaje ukryte. Długotrwałe agenty powinny traktować te aktualizacje jako status operacyjny, a nie ostateczne odpowiedzi.
Niższa cena odczytu cache
Odczyty cache kosztują $0.25 za milion tokenów, czyli jedną czwartą stawki Fable 5, podczas gdy podstawowe ceny wejścia i wyjścia pozostają bez zmian. To może zauważalnie obniżyć koszt długich sesji wielokrotnie wykorzystujących stabilny zcache’owany prefiks.
Pochodzenie treści
Generowany tekst zawiera statystyczny watermark Anthropic, a obsługiwane media pobierane przez Files API mogą zawierać podpisane poświadczenia C2PA Content Credentials. Te mechanizmy pochodzenia nie dodają tokenów promptu ani nie wymagają zmian formatu żądania.
Czego potrzebujesz przed użyciem Claude Fable 5.1 API?
- Konto i klucz API: zaloguj się do CometAPI i wygeneruj klucz w konsoli kluczy API. Sprawdź dostęp do modelu i gotowość konta do rozliczeń według użycia przed wysyłaniem testowych wywołań.
- Lokalny runtime: użyj terminala z curl do pierwszego przykładu HTTP. Dla przykładów w Pythonie przygotuj Pythona i pip w izolowanym środowisku, a następnie zainstaluj SDK używany przez wybrany przykład.
- Wybrana trasa: Claude Fable 5.1 API w CometAPI oferuje formaty Messages i Chat Completions. Używaj pasującej bazy URL i formatu żądania; nie mieszaj ich payloadów.
- Bezpieczna konfiguracja: ustaw
COMETAPI_KEYpoza plikami w repozytorium, używajclaude-fable-5-1jako identyfikatora modelu i upewnij się, że Twoja sieć ma dostęp dohttps://api.cometapi.com. - Bezpieczny test i check akceptacyjny: zacznij od krótkiego, niesensytywnego promptu. Potwierdź, że odpowiedź zawiera użyteczną treść, sprawdź wykorzystanie i status zakończenia oraz wymagania organizacji dotyczące przetwarzania danych przed przesłaniem prawdziwych dokumentów czy logów.
Jak uzyskać dostęp do Claude Fable 5.1 przez CometAPI
CometAPI udostępnia Claude Fable 5.1 przez trasę Messages zgodną z Anthropic oraz trasę Chat Completions zgodną z OpenAI. Używaj Messages, gdy potrzebujesz natywnego effort, myślenia, cache i semantyki narzędzi Claude; używaj Chat Completions, gdy Twoja aplikacja jest już standaryzowana na SDK OpenAI.
Krok 1: Zapisz klucz API
export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Krok 2: Wykonaj pierwsze żądanie Messages
curl https://api.cometapi.com/v1/messages \
  --header "Authorization: Bearer $COMETAPI_KEY" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "max_tokens": 2048,
    "messages": [{
      "role": "user",
      "content": "Review this deployment architecture and list the three highest-risk failure modes."
    }]
  }'
Krok 3: Użyj Anthropic Python SDK
pip install anthropic
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
)

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[{
        "role": "user",
        "content": "Find the root cause of this test failure and propose a verified patch.",
    }],
)

print(response.content[0].text)
Krok 4: Użyj OpenAI Python SDK
pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="claude-fable-5-1",
    messages=[{
        "role": "user",
        "content": "Design a migration plan for this service.",
    }],
)

print(response.choices[0].message.content)
Jak działa mechanizm rozumowania w Claude Fable 5.1 API?
Wcześniejsze modele nie mogą czytać bloków myślenia Claude Fable 5.1
Bloki myślenia wytworzone przez Fable 5.1 nie są wstecznie kompatybilne z wcześniejszymi modelami Claude. Jeśli workflow zmienia model w środku rozmowy, usuń niekompatybilne bloki myślenia lub rozpocznij nową gałąź, zachowując jedynie wiadomości widoczne dla użytkownika i wyniki narzędzi wymagane do kolejnego żądania.
Edytowanie wcześniejszych tur unieważnia zachowane myślenie
Zachowany blok myślenia jest kryptograficznie powiązany z poprzedzającym stanem rozmowy. Zmiana wcześniejszego system promptu, definicji narzędzia, wiadomości użytkownika, odpowiedzi asystenta lub wyniku narzędzia może przerwać to powiązanie i wywołać błąd historii myślenia. Utrzymuj odtwarzany prefiks bajt-w-bajt stabilny i dopisuj nowe tury zamiast przepisywać stare.
Zachowane myślenie między turami
Gdy prefiks rozmowy pozostaje niezmieniony, zachowane myślenie może przenosić użyteczny stan rozumowania do późniejszych tur. Przechowuj bloki myślenia z ich pierwotną kolejnością wiadomości, odtwarzaj je tylko na kompatybilnym modelu i traktuj edycję historii jako nową gałąź rozmowy zamiast mutowania istniejącego transkryptu.
Kontroluj rozumowanie przez effort
Rozpoczynaj trudną pracę produkcyjną od high, następnie testuj niższe ustawienia przy rutynowych turach i wyższe tylko tam, gdzie poprawa jakości zaliczonych zadań uzasadnia dodatkowe opóźnienie i tokeny. Ponieważ effort może zmieniać się między turami, jedna rozmowa nie musi już mieć jednego poziomu rozumowania przez cały czas.
Fable 5.1 używa adaptacyjnego rozumowania jako jedynego trybu. Zaczynaj od high, potem mierz niższe ustawienia dla rutyny i xhigh lub max tylko wtedy, gdy dodatkowa zdolność uzasadnia koszt i opóźnienie.
| Effort | Rekomendowana rola | Kompromis |
|---|---|---|
| low | Rutynowa, dobrze określona praca | Najszybsze i najtańsze |
| medium | Zrównoważony ruch produkcyjny | Umiarkowana głębia |
| high | Domyślnie praca trudna | Najlepszy punkt startowy |
| xhigh | Długie kodowanie i agenty | Większe opóźnienie i tokeny |
| max | Najtrudniejsze zadania o najwyższej wartości | Koszt i opóźnienie drugorzędne |
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Audit this repository migration plan.",
    }],
)
Claude Fable 5.1 API: strumieniuj długie odpowiedzi, używaj narzędzi i cache promptów
Skonfiguruj wspólnie następujące elementy: effort rozumowania, streaming, wykonywanie narzędzi, cache promptu oraz obsługę zabezpieczeń i danych trwałych. Każdy z nich wpływa na to, jak długotrwałe żądanie jest obserwowane, weryfikowane i obsługiwane operacyjnie.
Strumieniuj długie odpowiedzi
Streaming jest bezpieczniejszym domyślnym wyborem dla długich, wysokowysiłkowych zadań, ponieważ unika oczekiwania na zakończenie dużej odpowiedzi zanim aplikacja otrzyma jakikolwiek output.
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
Używaj narzędzi bez wymuszania wyboru
Fable 5.1 odrzuca wymuszony wybór narzędzia przy użyciu tool_choice typu any lub nazwanego narzędzia. Używaj automatycznego wyboru, ścisłych schematów, waliduj argumenty narzędzi w kodzie aplikacji i kontroluj obowiązkową sekwencję workflow poza modelem. Jeśli workflow wymaga uruchomienia konkretnego narzędzia, nie polegaj na tool_choice do egzekwowania sekwencji. Niech aplikacja wywoła to narzędzie lub zaimplementuj wymagany krok w kodzie orkiestrującym.
tools = [{
    "name": "search_incidents",
    "description": "Search recent production incidents",
    "input_schema": {
        "type": "object",
        "properties": {
            "service": {"type": "string"},
            "days": {"type": "integer"},
        },
        "required": ["service", "days"],
    },
}]

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    tools=tools,
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "Review checkout incidents from the last 30 days.",
    }],
)
Używaj cache promptów dla długich kontekstów
Anthropic podaje cenę odczytu cache $0.25 za milion tokenów, czyli jedną czwartą stawki Fable 5. Umieszczaj stabilne instrukcje systemowe, schematy narzędzi i duże materiały referencyjne przed dynamicznymi treściami użytkownika, a następnie weryfikuj trafienia cache w metadanych usage.
messages = [{
    "role": "user",
    "content": [
        {
            "type": "text",
            "text": large_reference_document,
            "cache_control": {"type": "ephemeral"},
        },
        {
            "type": "text",
            "text": "Identify obligations that changed in this revision.",
        },
    ],
}]
Obsłuż zabezpieczenia i retencję danych
Anthropic wskazuje, że wiele flagowanych próśb z zakresu cyberbezpieczeństwa i biologii jest kierowanych do mniej zdolnych modeli. Traktuj odmowę lub fallback jako stan aplikacji: zapisuj stop reason, pokaż użytkownikowi odpowiedni komunikat i kieruj do zatwierdzonej alternatywy, gdzie polityka na to pozwala.
Fable wymaga również domyślnej 30-dniowej retencji danych dla nadzoru bezpieczeństwa. Potwierdź uprawnienia organizacyjne i ustawienia retencji zanim zaczniesz debugować składniowo poprawne żądanie tak, jakby było tylko problemem formatu API.
Fable 5.1 vs Opus 5 vs Sonnet 5
| Wymiar decyzji | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Kontekst / maks. output | 1M / 128K | 1M / 128K | 1M / 128K |
| Oficjalna cena wej./wyj. | $10 / $50 | $5 / $25 | $2 / $10 |
| Opóźnienie względne | Wolniejsze | Umiarkowane | Szybkie |
| Domyślny effort | high | high | high |
| Główna mocna strona | Maksymalna zdolność długiego horyzontu | Premiumowe ogólne rozumowanie | Równowaga szybkości/kosztu |
| Najlepsza rola w produkcji | Eskalacja zdolności | Domyślna praca złożona | Bazowy wysoki wolumen |
Wynik selekcji: rozpoczynaj ruch rutynowy na Sonnet 5, używaj Opus 5 do złożonej pracy domyślnej, a eskaluj tylko najtrudniejsze lub powtarzalnie nieudane zadania do Fable 5.1. To zgodne z zaleceniami Anthropic i zapobiega temu, by premiumowe rozumowanie stało się domyślnym kosztem każdego żądania.
Cennik przez CometAPI
| Trasa | Wejście / MTok | Wyjście / MTok | Odczyt cache / MTok |
|---|---|---|---|
| Cennik listowy Anthropic | $10 | $50 | $0.25 |
| Cena listowa CometAPI | $8 | $40 | Sprawdź na żywo trasę |
| Różnica wej./wyj. nominalna | 20% niższa | 20% niższa | Zależy od trasy |
Strona modelu CometAPI na żywo to źródło prawdy dla bieżącej dostępności tras i cen. Dla żądania ze 100,000 niecache’owanych tokenów wejściowych i 10,000 tokenów wyjściowych, prosta estymacja CometAPI to $1.20; rzeczywisty koszt może się zmieniać z cache’owaniem, rozumowaniem, zachowaniem wsadowym i routingiem. Ceny mogą się zmieniać; sprawdzaj stronę modelu przed budżetowaniem produkcyjnym.
Lista kontrolna migracji z Fable 5
- Zmień identyfikator modelu z claude-fable-5 na claude-fable-5-1.
- Usuń wymuszanie tool_choice any i nazwanych narzędzi; użyj auto.
- Zastąp stare założenia budżetu myślenia parametrem output_config.effort.
- Rozpocznij ewaluację na high, następnie stroń na realnych zadaniach.
- Utrzymuj historie append-only, gdy zawierają zachowane bloki myślenia.
- Zwiększ max_tokens dla długich runów z wysokim effort.
- Weryfikuj trafienia cache w metadanych usage.
- Traktuj odmowy i fallbacki jako jawne stany.
- Odtwarzaj ślady produkcyjne i porównuj odsetek zadań zaliczonych, opóźnienie i koszt.
Najbezpieczniejsza strategia migracji: utrzymuj historie append-only. Fable 5.1 może zachowywać bloki myślenia między turami, ale odtwarzane bloki są powiązane z poprzedzającym stanem rozmowy; zmiana wcześniejszych system promptów, narzędzi lub wiadomości może unieważnić to powiązanie.
Częste błędy API
Błąd 400 po zmianie wywołań narzędzi
Prawdopodobna przyczyna: wymuszony tool_choice używający any lub nazwanego narzędzia. Użyj auto i egzekwuj wymaganą sekwencję w logice aplikacji.
claude-fable-5.1 nie działa
Kanoniczny identyfikator używa łączników: claude-fable-5-1.
Wyjście kończy się wcześniej niż oczekiwano
effort controls how much reasoning the model performs, while max_tokens limits the response token budget. Higher effort can require more output budget, so production applications should tune both independently. Raise max_tokens where justified and stream long responses.
Cache promptu nigdy nie trafia
Utrzymuj zcache’owany prefiks bajt-w-bajt stabilny; znaczniki czasu, zmieniona kolejność narzędzi i zmiany system messages uniemożliwiają ponowne użycie.
Odpowiedź HTTP-sukces nie zawiera normalnej odpowiedzi
Sprawdź stop_reason i metadane fallback zamiast traktować każdą odmowę jako błąd transportu.
Odtwarzanie historii wywołuje błąd myślenia
Nie edytuj wcześniejszych tur przed zachowanymi blokami myślenia Fable 5.1. Używaj historii append-only lub bieżących mechanizmów migracji.
Jak używać Claude Fable 5.1 API w produkcji?
Oddziel routing żądań, wykonanie modelu, wykonanie narzędzi, walidację i ewaluację. Loguj identyfikator modelu, effort, opóźnienie, użycie tokenów, użycie cache, stop reason, zachowanie fallbacków oraz sukces zadania końcowego.
Używaj Fable 5.1 do migracji repozytoriów, trudnego debugowania, długotrwałych agentów, głębokich badań, syntezy dużych dokumentów i zadań o wysokiej wartości, gdzie tańsze modele wielokrotnie zawodzą. Unikaj go jako domyślnego dla streszczeń, klasyfikacji, ekstrakcji i krótkich odpowiedzi obsługi klienta.
Przykład: Zbadaj incydent w checkout
Zespół może dostarczyć zanonimizowane błędy checkoutu, ostatnie diffs wdrożeń i odpowiednie runbooki. Aplikacja pobiera pasujące rekordy incydentów, po czym prosi model o uszeregowanie możliwych przyczyn i powiązanie każdej hipotezy z dowodami. Inżynier przegląda proponowane kroki diagnostyczne i zatwierdza test w piaskownicy z użyciem transakcji syntetycznych. Bramka akceptacyjna to odtwarzalne zachowanie, śledzalne dowody i zaliczone testy regresji; każda mitygacja produkcyjna wymaga odrębnej akceptacji człowieka.
Przykład: Analiza zmian wymagań operacyjnych
Zespół może dostarczyć zatwierdzony podręcznik operacyjny, polityki wspierające i zrewidowany szkic. Zachowaj niezmienione materiały referencyjne jako stabilny kontekst, a następnie poproś model o porównanie zmienionych obowiązków, zespołów odpowiedzialnych, terminów i wyjątków. Każde proponowane ustalenie powinno odwoływać się do odpowiednich fragmentów w obu wersjach i rozróżniać zmiany wyraźne od niepewnych interpretacji. Bramka akceptacyjna to recenzent potwierdzający każdą zgłoszoną zmianę wobec cytowanych dowodów, zanim zaktualizuje procedury lub powiadomi zainteresowane zespoły.
Zakończenie
Claude Fable 5.1 to nie jest jedynie aktualizacja stringu modelu. Jego zachowanie wobec wymuszania narzędzi, zasady historii myślenia, kontrola effort, ekonomia cache i funkcje postępu w długich runach wymagają przemyślanej migracji.
Najskuteczniejsze wdrożenie używa Claude Sonnet 5 dla ruchu rutynowego, Claude Opus 5 dla złożonego ruchu domyślnego i Claude Fable 5.1 jako mierzonej eskalacji zdolności. Promuj go tylko wtedy, gdy poprawa ukończenia zadań akceptowanych wystarcza, by uzasadnić całkowity koszt i opóźnienie.