
TLDR Kimi K3 to najnowszy flagowy model Moonshot AI, wprowadzony w lipcu 2026 r. do zadań programistycznych o długim horyzoncie, głębokiego rozumowania, multimodalnego rozumienia oraz kompleksowej pracy z wiedzą. Moonshot opisuje go jako otwarty model klasy 3T z 2,8 biliona parametrów, natywną wizją i oknem kontekstu o wielkości 1 miliona tokenów.
Dla deweloperów, którzy chcą szybkiego dostępu bez zarządzania osobnymi kontami dostawców, CometAPI wymienia Kimi K3 jako dostępny pod identyfikatorem modelu kimi-k3, korzystający z kompatybilnego z OpenAI endpointu /v1/chat/completions i bazowego adresu URL https://api.cometapi.com/v1. Na stronie CometAPI Kimi K3 widnieje cena wejścia $2.40 za 1M tokenów i cena wyjścia $12.00 za 1M tokenów, w porównaniu z oficjalnymi stawkami Kimi API: $3.00 za wejście przy braku trafienia w cache i $15.00 za wyjście. Ponieważ popyt na Kimi K3 spowodował czasowe ograniczenia subskrypcji w Moonshot, zespoły produkcyjne powinny używać CometAPI nie tylko dla łatwej konfiguracji, ale także do porównania modeli, monitorowania użycia i trasowania awaryjnego.
Kluczowe wnioski
- W produkcji zachowuj kompletne wiadomości asystenta w wieloturach, ustawiaj limit
max_completion_tokens, śledź zużycie tokenów i buduj ścieżki awaryjne. - Kimi K3 to model Mixture-of-Experts od Moonshot AI z 2,8T parametrów, 1M-tokenowym kontekstem i natywną wizją.
- Model CometAPI Kimi k3 ma ID
kimi-k3; główny endpoint toPOSThttps://api.cometapi.com/v1/chat/completions. - K3 zawsze rozumuje. Używaj
reasoning_effortz wartościamilow,highlubmax;maxto domyślna wartość w dokumentacji Kimi. - Strumieniowanie jest zdecydowanie zalecane przy długim kodowaniu, badaniach i analizach, bo użytkownicy widzą częściowy wynik, gdy model wciąż pracuje.
- Wejście wizyjne musi używać multimodalnych tablic
content. Dokumentacja Kimi podaje, że publiczne URL-e obrazów nie są obsługiwane dla tras wizji Kimi; używaj base64 lub referencji do przesłanych plików. - Kimi K3 obsługuje strukturyzowane wyjście, tryb JSON, wywoływanie narzędzi,
tool_choice, dynamiczne ładowanie narzędzi i buforowanie kontekstu.
CometAPI to praktyczny sposób na ocenę Kimi K3 obok GPT, Claude, Gemini, DeepSeek, Qwen i innych modeli z jednej warstwy API.
Czym jest Kimi K3: flagowy model Moonshot AI
Moonshot AI wydał Kimi K3 16 lipca 2026 r. jako swój najbardziej zaawansowany model — rzadką architekturę typu Mixture‑of‑Experts (MoE) z ~2,8 biliona łącznych parametrów (16 z 896 ekspertów aktywnych na token). Oferuje Kimi Delta Attention dla nawet 6,3x szybszego dekodowania w kontekstach milion‑tokenowych oraz Attention Residuals dla ~25% zysku efektywności treningu.
Kluczowe specyfikacje (na podstawie źródeł oficjalnych i niezależnych):
| Zdolność | Szczegóły Kimi K3 |
|---|---|
| Model ID | kimi-k3 |
| Context Window | 1,048,576 tokens (1M) |
| Parameters | 2.8T total (MoE) |
| Input | Text + native vision (images) |
| Reasoning | Always-on, max effort at launch |
| Features | Tool calling, structured/JSON output, streaming |
| Open Weights | Promised by July 27, 2026 (Modified MIT) |
Świetnie radzi sobie w zadaniach długohoryzontalnego kodowania, pracach agentowych, rozumieniu wizji i zadaniach wiedzochłonnych. Niezależne benchmarki plasują go konkurencyjnie (np. 57.1 na Artificial Analysis Intelligence Index, mocny w arenach frontendu).
Najnowsze wiadomości z Business Insider: Popyt po premierze wzrósł tak bardzo, że Moonshot tymczasowo wstrzymał nowe subskrypcje. To sygnał o chińskiej ofensywie w kierunku modeli z otwartymi wagami klasy frontier; Moonshot celuje w duże IPO.
Pełne wagi zaplanowane na 27 lipca 2026 r.
Dokumentacja Kimi K3 mówi, że pełne wagi modelu zostaną wydane do 27 lipca 2026 r. Dopóki wydanie nie zostanie zakończone i nie dojrzeją narzędzia wdrożeniowe stron trzecich, większość zespołów powinna traktować hostowany dostęp przez API jako najszybszą praktyczną ścieżkę. Nawet po udostępnieniu wag serwowanie modelu MoE z 2,8T parametrami to nie to samo co uruchamianie małego otwartego modelu na pojedynczej stacji roboczej. Blog techniczny Moonshot zaleca konfiguracje super‑node z 64 lub większą liczbą akceleratorów do wdrożeń K3, co oznacza, że hostowane API pozostanie domyślnym wyborem dla wielu zespołów SaaS, agencji, twórców narzędzi wewnętrznych i zespołów produktowych AI.
Wydajność w benchmarkach: dane, źródła i analiza
Kimi K3 dostarcza wyniki klasy frontier, szczególnie w kodowaniu i obszarach agentowych, pozostając konkurencyjnym ogólnie. Niezależne laboratoria jak Artificial Analysis potwierdzają deklaracje dostawcy z pewnymi zastrzeżeniami (np. wskaźniki halucynacji).
Ogólna inteligencja
- Artificial Analysis Intelligence Index v4.1: 57.1 (4. miejsce; za Fable 5 ~60, GPT-5.6 Sol ~59; przed Claude Opus 4.8 ~55.7).
- GDPval-AA v2 Elo: 1,668 (duży skok z 1,190 K2.6; przebija Opus 4.8, ustępuje Fable 5).

Źródło: reddit
Benchmarki programistyczne (dostawca + niezależne)
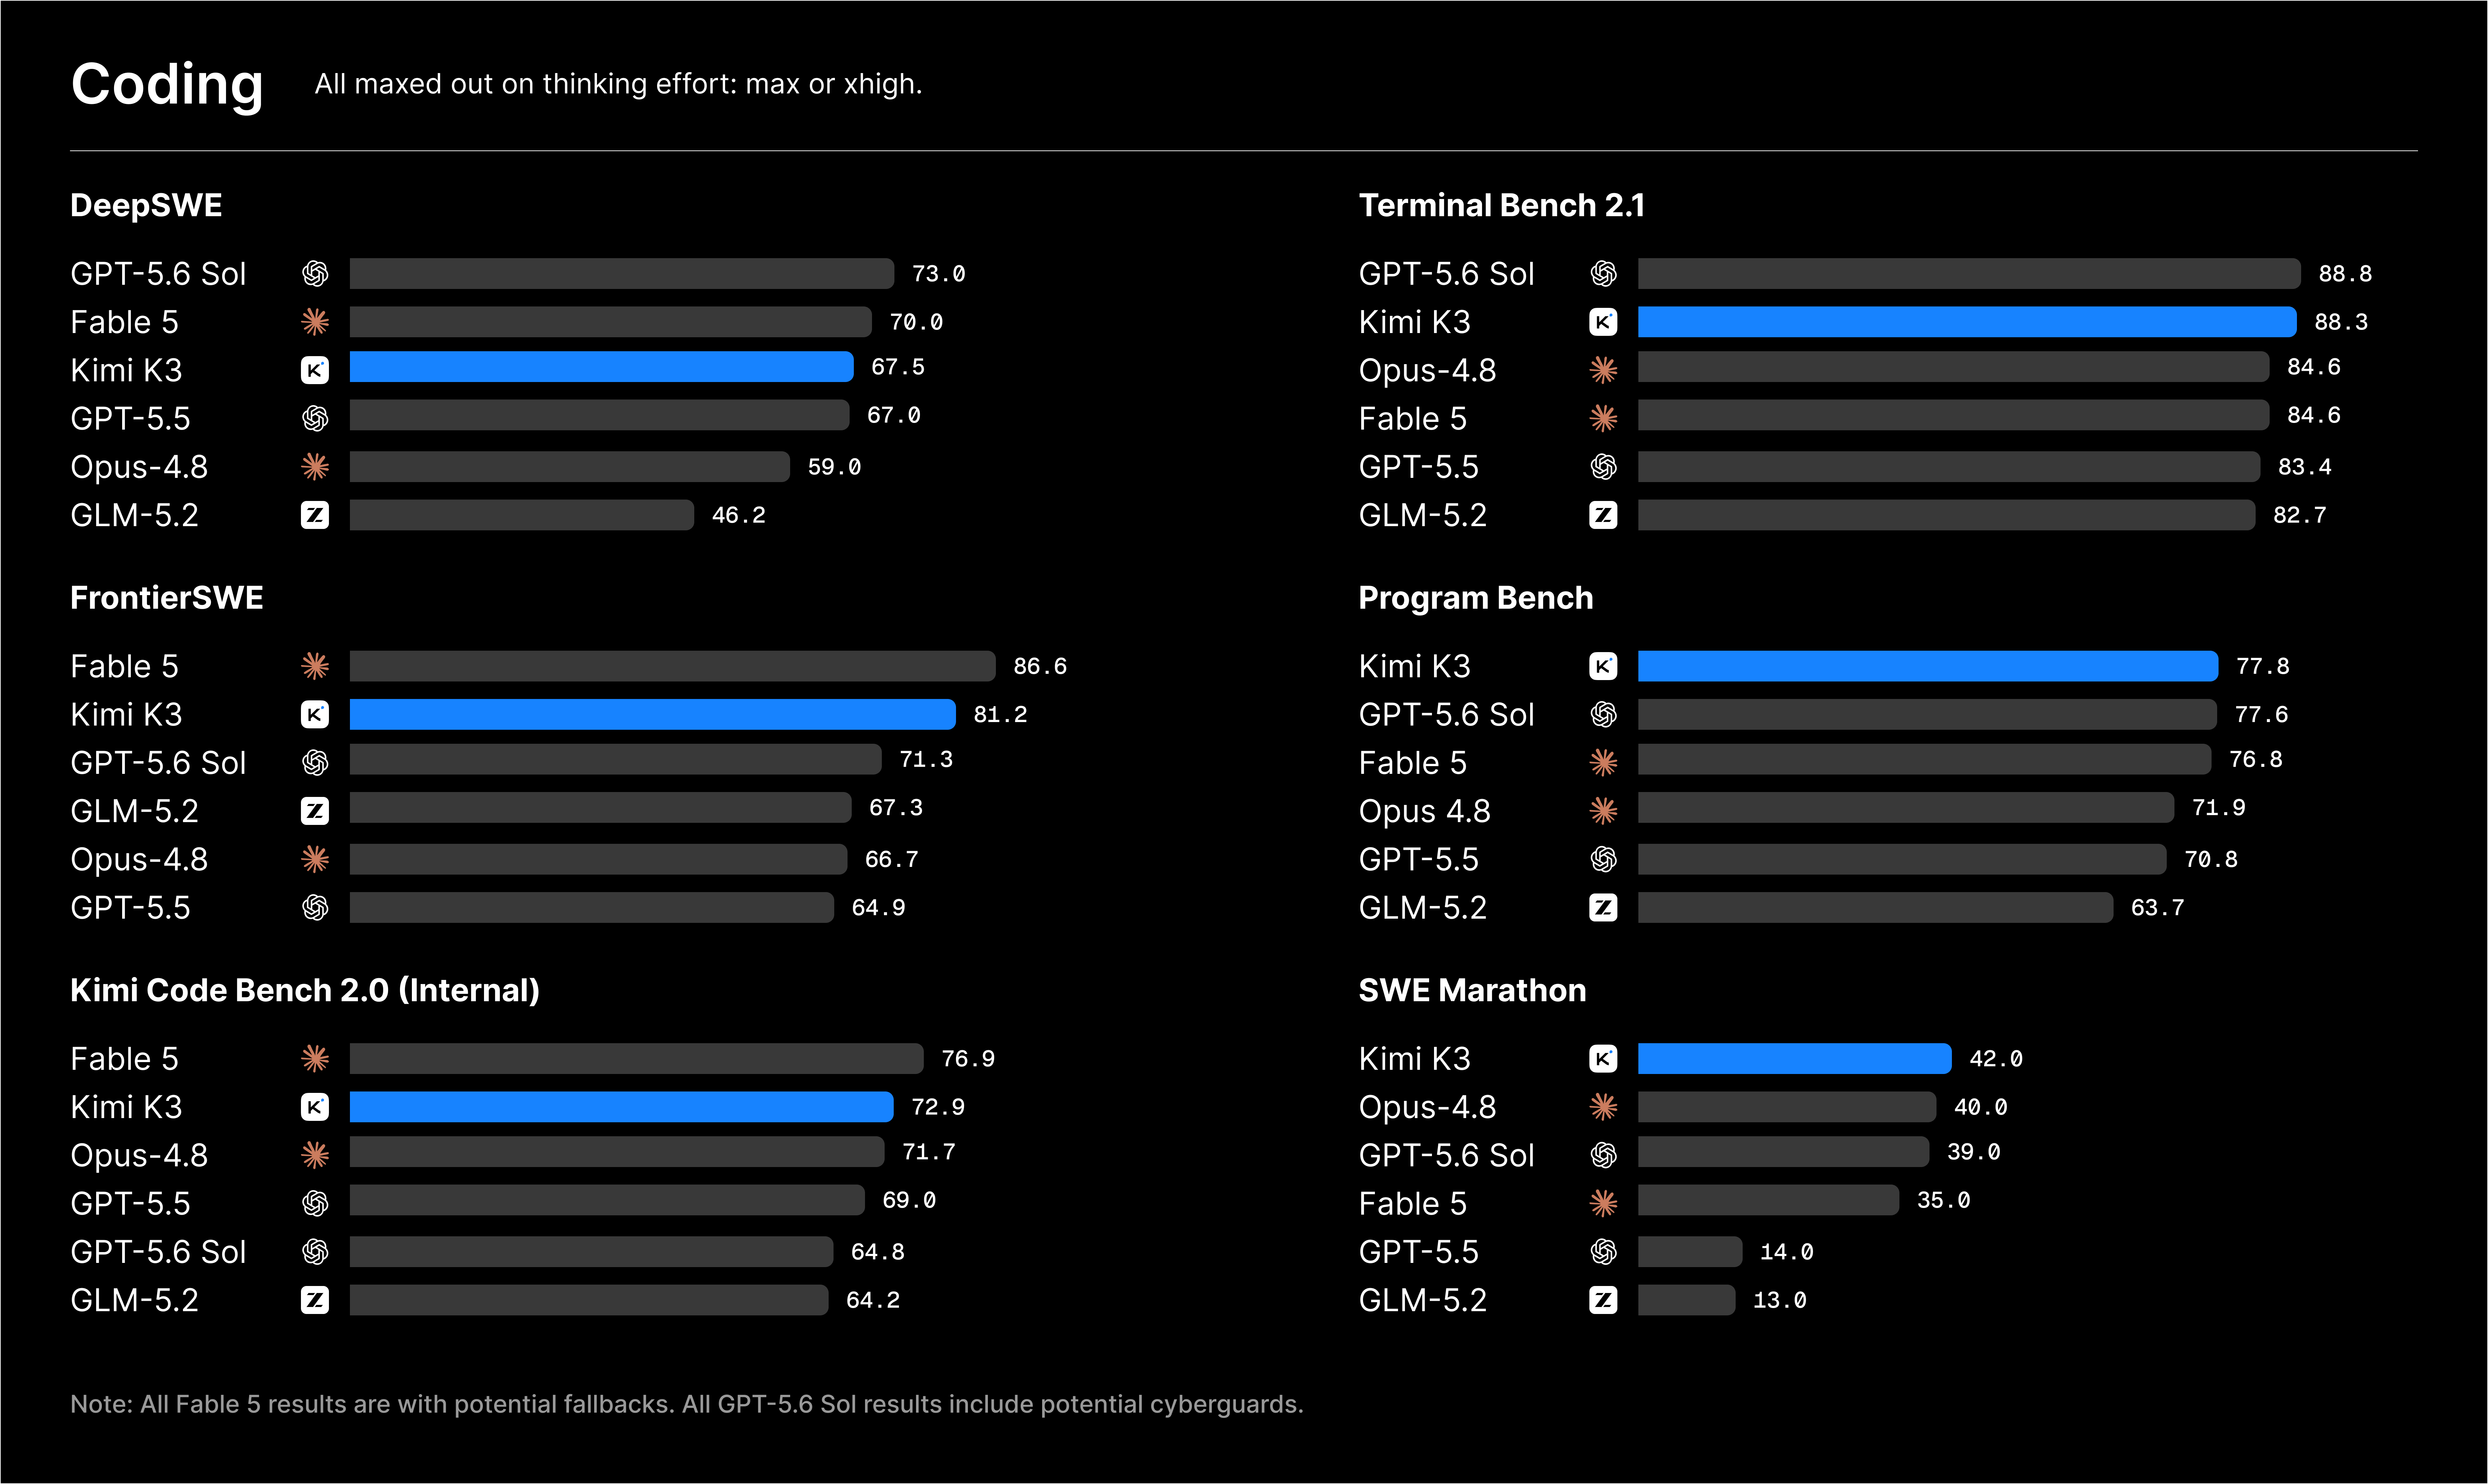
K3 błyszczy tutaj, prowadząc w Frontend Code Arena (1,679 Elo, #1 przed Fable 5 i Sol).
Źródło: Kimi
Indeks kodowania (Artificial Analysis): Mocny ~76, konkurencyjny wobec liderów.
K3 wyróżnia się w pracy na poziomie repozytoriów, frontendu z iteracją wizualną i agentów używających narzędzi. Deweloperzy raportują poziom „Opus 4.8+” dla wielu zadań kodowych.
Czym jest API Kimi K3?
Kimi K3 w prostych słowach dla deweloperów
API Kimi K3 zapewnia deweloperom hostowany dostęp do modelu K3 Moonshot AI przez interfejs w stylu chat‑completions. Typowe żądanie wysyła listę wiadomości, wybiera model: "kimi-k3" i otrzymuje odpowiedź asystenta. Poza podstawowym formatem czatu K3 dodaje funkcje istotne w produkcji: konfigurowalny nakład rozumowania, długi kontekst, wejście wizualne, strumieniowanie, wyjście JSON i ograniczone schematem, wywoływanie narzędzi oraz buforowanie kontekstu.
Kimi K3 nie jest najlepiej rozumieć jako „tani ogólny chatbot”. Jego największa wartość to ciężka praca. Jeśli Twój produkt musi nakarmić model dużym repozytorium, długim pakietem dokumentów, gęstym eksportem arkusza kalkulacyjnego, wieloma zrzutami ekranu, transkrypcją debugowania lub złożonym planem narzędzi — K3 jest zaprojektowany do takich sesji. Jeśli aplikacja potrzebuje tylko krótkich odpowiedzi FAQ lub klasyfikacji na małych wejściach, mniejszy model może być bardziej opłacalny.
Nowe funkcje API K3 i użycie
- 1M Context: Przetwarzaj całe repozytoria, książki lub długie rozmowy bez ucinania.
- Native Vision: Analizuj obrazy bezpośrednio w wiadomościach (base64 lub URL‑e).
- Always-On Reasoning: Domyślnie maksymalny wysiłek; obsługa strukturyzowanych śladów myślenia (strumieniowanie ujawnia delty).
- Tool Calling & Agents: Pełne wywoływanie funkcji w stylu OpenAI dla złożonych przepływów.
- Structured Output: Tryb JSON dla niezawodnego parsowania.
- Caching: Automatyczne buforowanie prefiksów znacząco obniża koszty przy powtarzalnych kontekstach (raportowane >90% trafień w kodowaniu).
Kluczowe możliwości API Kimi K3 w CometAPI
Kontekst 1M tokenów dla długich dokumentów i dużych baz kodu
CometAPI prezentuje Kimi K3 z oknem kontekstu 1,000k tokenów. Ta skala zmienia sposób projektowania przepływów. Zamiast dzielić każdy dokument na wiele części, możesz testować przepływy utrzymujące znacznie większy kontekst w jednym żądaniu: dokumenty architektury plus fragmenty kodu, wymagania produktowe plus raporty błędów, prace naukowe plus notatki, czy długie historie wsparcia klienta.
To nie znaczy, że każde żądanie powinno wykorzystywać pełen kontekst. Długi kontekst jest drogi i może spowolnić opóźnienie do pierwszego tokena. Używaj go, gdy model potrzebuje globalnej widoczności, a nie jako zamiennika dla czystego projektu wyszukiwania. Silny wzorzec produkcyjny w CometAPI to trasowanie hybrydowe: używaj osadzeń lub wyszukiwania do pobrania najbardziej istotnych fragmentów, ale pozostaw K3 dostępny dla rzadkich zadań, gdzie szeroki kontekst rzeczywiście poprawia jakość odpowiedzi.
Zawsze włączone rozumowanie z konfigurowalnym reasoning_effort
Dokumentacja Kimi mówi, że K3 zawsze rozumuje i obsługuje pole najwyższego poziomu reasoning_effort z wartościami low, high i max. Używaj niższego wysiłku przy lżejszych zadaniach, gdzie liczą się opóźnienia i koszt; używaj wysokiego lub maksymalnego przy zadaniach takich jak debugowanie, wyprowadzenia matematyczne, przegląd architektury, migracja kodu, synteza długich dokumentów i planowanie wielonarzędziowe.
W CometAPI przekaż reasoning_effort w żądaniu Chat Completions, gdy trasa Kimi K3 obsługuje parametry specyficzne dla dostawcy. Jeśli Twoja wersja SDK odrzuca to pole najwyższego poziomu, wyślij je przez extra_body albo użyj surowego HTTPS.
Strumieniowanie odpowiedzi dla lepszego UX
Dokumentacja Kimi o strumieniowaniu wyjaśnia, że strumieniowanie wysyła tokeny przez Server‑Sent Events zamiast czekać na pełną odpowiedź. Jest to szczególnie przydatne dla K3, ponieważ głębokie rozumowanie i długie wyjścia mogą trwać dłużej niż małe zadania czatowe. W narzędziu deweloperskim strumieniuj najpierw plan, potem kod. W asystencie badawczym strumieniuj podsumowania sekcji. W wewnętrznej aplikacji analitycznej strumieniuj wstępne obserwacje, gdy finalna strukturyzowana odpowiedź jest jeszcze generowana.
Wejście wizji dla zrzutów ekranu, wykresów i wideo
Kimi K3 obsługuje rozumienie wizualne. Dokumentacja wizji Kimi podaje, że K3 rozumie treści obrazów i wideo oraz że wiadomości wizualne powinny używać tablic content z częściami image_url lub video_url. Ta sama dokumentacja mówi, że obrazy sformatowane jako URL‑e nie są obsługiwane; używaj danych base64 lub referencji do przesłanych plików. Dla użytkowników CometAPI zacznij w stagingu od wejścia obrazu base64, bo jest proste, przenośne i łatwe do bezpiecznego logowania bez zależności od publicznego hostingu obrazów.
Strukturyzowane wyjście, tryb JSON i wywoływanie narzędzi
Kimi K3 obsługuje strukturyzowane wyjście przez response_format, a także wywoływanie narzędzi przez deklaracje funkcji w JSON Schema. Nowsze funkcje API K3 obejmują tool_choice i dynamiczne ładowanie narzędzi. To ważne dla produktów agentowych, bo inwentarz narzędzi może urosnąć ogromnie. Zamiast wysyłać definicje wszystkich narzędzi w każdym żądaniu, Twoja aplikacja może najpierw udostępnić małą funkcję search_tools, pobrać tylko istotne narzędzia i dynamicznie wstawić ich definicje do rozmowy.
Praktyczna decyzja jest prosta: nie wybieraj wyłącznie po tabeli benchmarków. Użyj CometAPI, by zbudować powtarzalny zestaw ewaluacyjny z własnych promptów. Uwzględnij co najmniej 20–50 realnych zadań: poprawki błędów, ekstrakcje, zrzuty ekranu, PDF‑y, pytania klientów, ślady wywołań narzędzi i żądania wrażliwe na koszt. Kieruj Kimi K3 do zadań, gdzie jego długi kontekst, rozumowanie i wizja zwracają koszt inwestycji.
Cennik API: ile kosztuje Kimi K3
Cennik Kimi K3 w CometAPI
Strona modelu Kimi K3 w CometAPI podaje:
| Trasa dostawcy | Cena wejścia | Cena wyjścia | Kontekst | Model ID |
|---|---|---|---|---|
| CometAPI Kimi K3 | $2.40 per 1M tokens | $12.00 per 1M tokens | 1,000k tokens | kimi-k3 |
Ta sama strona porównuje te liczby z oficjalnymi cenami $3.00 za wejście i $15.00 za wyjście na 1M tokenów, wskazując 20% zniżki w aktualnym cenniku CometAPI. Ceny mogą się zmieniać, więc zweryfikuj bieżącą stronę modelu CometAPI przed publikacją treści o wysokim ruchu lub zatwierdzeniem budżetu produkcyjnego.
Oficjalny cennik Kimi API
Blog techniczny Moonshot podaje ceny Kimi API: $0.30 za 1M wejściowych tokenów z trafieniem w cache, $3.00 za 1M wejściowych tokenów przy braku trafienia oraz $15.00 za 1M tokenów wyjściowych. Podaje też, że oficjalne Kimi API osiąga współczynnik trafień w cache powyżej 90% w zadaniach kodowych. Traktuj te 90% jako deklarację dostawcy specyficzną dla obciążenia, nie gwarancję dla każdej aplikacji. Twój współczynnik trafień zależy od stabilności promptów, definicji narzędzi, prefiksów repozytoriów i historii sesji.
Proste przykłady kosztów w CometAPI
| Przykładowe żądanie | Tokeny wejścia | Tokeny wyjścia | Szacunkowy koszt CometAPI |
|---|---|---|---|
| Krótki przegląd kodu | 20,000 | 2,000 | $0.072 |
| Pytanie o średnie repozytorium | 100,000 | 5,000 | $0.300 |
| Analiza dużego dokumentu | 500,000 | 20,000 | $1.440 |
| Synteza bliska pełnemu kontekstowi | 950,000 | 50,000 | $2.880 |
Wzór: (input_tokens / 1,000,000 * 2.40) + (output_tokens / 1,000,000 * 12.00).
Dwie uwagi są istotne. Po pierwsze, tokeny rozumowania są zwykle rozliczane jako tokeny wyjściowe w modelach rozumujących, więc ustawiaj max_completion_tokens rozważnie. Po drugie, długi kontekst powinien być intencjonalny. Wysłanie 500,000 tokenów jest potężne, ale rzadko mądre, jeśli 20,000 wysokosygnałowych tokenów da taki sam wynik.
Jak używać API Kimi K3 w CometAPI
Krok 1: Utwórz klucz CometAPI
Utwórz lub zaloguj się na konto CometAPI, otwórz stronę klucza API i utwórz klucz. Przechowuj go jako zmienną środowiskową po stronie serwera o nazwie COMETAPI_KEY. Nie umieszczaj kluczy produkcyjnych w JS przeglądarki, aplikacjach mobilnych, publicznych repozytoriach, zrzutach ekranu ani logach po stronie klienta.
PowerShell:
$env:COMETAPI_KEY = "your_cometapi_key_here"
macOS lub Linux:
export COMETAPI_KEY="your_cometapi_key_here"
Krok 2: Zainstaluj SDK OpenAI
CometAPI obsługuje SDK kompatybilne z OpenAI. W Pythonie zainstaluj SDK:
python -m pip install --upgrade openai
Krok 3: Wykonaj pierwsze wywołanie API Kimi K3
Użyj bazowego URL CometAPI i identyfikatora modelu kimi-k3:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "system",
            "content": "Jesteś precyzyjnym asystentem technicznym dla deweloperów API.",
        },
        {
            "role": "user",
            "content": "Wyjaśnij, kiedy powinienem używać Kimi K3 dla agenta programistycznego.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
Równoważne żądanie cURL:
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kimi-k3",
    "messages": [
      {"role": "system", "content": "Jesteś precyzyjnym asystentem technicznym dla deweloperów API."},
      {"role": "user", "content": "Wyjaśnij Kimi K3 w jednym akapicie."}
    ],
    "max_completion_tokens": 800
  }'
K3: nowe funkcje API i użycie
Nakład myślenia
Używaj reasoning_effort, aby kontrolować, ile budżetu rozumowania K3 zastosuje. Dokumentacja Kimi wymienia low, high i max, gdzie max jest domyślne. W produkcji wybieraj na podstawie typu zadania:
| Typ zadania | Zalecany wysiłek | Dlaczego |
|---|---|---|
| Krótkie podsumowania, parafrazy, proste pytania i odpowiedzi | low | Szybciej i taniej dla zadań niskiego ryzyka |
| Przegląd kodu, ekstrakcja, planowanie, analiza | high | Lepsza równowaga jakości i kosztu |
| Złożone debugowanie, matematyka, praca agentowa, długi kontekst | max | Najlepsza jakość, gdy głębsze rozumowanie warte jest opóźnienia i kosztu tokenów |
Przykład w Pythonie:
completion = client.chat.completions.create(
    model="kimi-k3",
    reasoning_effort="high",
    messages=[
        {
            "role": "user",
            "content": (
                "Przejrzyj ten plan migracji pod kątem ukrytych ryzyk. "
                "Zwróć 5 najważniejszych problemów i bezpieczniejszą sekwencję wdrożenia."
            ),
        }
    ],
    max_completion_tokens=2000,
)

message = completion.choices[0].message
print(message.content)
Jeśli Twoja wersja SDK OpenAI nie akceptuje reasoning_effort jako nazwanego argumentu, przekaż go przez extra_body:
completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[{"role": "user", "content": "Rozwiąż ten problem z harmonogramem."}],
    extra_body={"reasoning_effort": "high"},
)
Ważny szczegół implementacyjny: Dokumentacja myślenia Kimi mówi, że wielotury K3 powinny zachowywać kompletną wiadomość asystenta zwracaną przez API, w tym pola takie jak reasoning_content i tool_calls. Jeśli przechowujesz tylko widoczny content, możesz pogorszyć ciągłość rozumowania w długich sesjach.
Strumieniowanie odpowiedzi
Używaj strumieniowania, gdy odpowiedź może być długa, gdy liczy się opóźnienie lub gdy chcesz pokazać postęp w interfejsie czatu.
stream = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "user",
            "content": "Utwórz szczegółowy plan refaktoryzacji dla monolitu liczącego 200 tys. linii.",
        }
    ],
    stream=True,
    stream_options={"include_usage": True},
    max_completion_tokens=3000,
)

for chunk in stream:
    choice = chunk.choices[0]
    delta = choice.delta

    reasoning = getattr(delta, "reasoning_content", None)
    if reasoning:
        # W większości produktów przechowuj rozumowanie bezpiecznie lub ukryj je przed użytkownikami końcowymi.
        pass

    if delta.content:
        print(delta.content, end="", flush=True)

    usage = getattr(choice, "usage", None)
    if usage:
        print("\n\nZużycie:", usage)
Dokumentacja strumieniowania Kimi podkreśla, że strumień SSE kończy się data: [DONE]. W surowym kliencie SSE nie uznawaj strumienia za zakończony, dopóki ten znacznik nie nadejdzie.
Wejście wizji
Kimi K3 potrafi analizować obrazy i wideo. Najbezpieczniejszy pierwszy test w CometAPI to żądanie obrazu base64. Użyj multimodalnej tablicy content, a nie łańcucha JSON zawierającego tablicę.
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard-screenshot.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
image_b64 = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{image_b64}",
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Przejrzyj ten zrzut pulpitu. "
                        "Wskaż problemy UX, brakujące stany i ryzyka jakości danych."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1800,
)

print(completion.choices[0].message.content)
Dokumentacja wizji Kimi wymienia obsługiwane formaty obrazów, takie jak PNG, JPEG, WebP i GIF, oraz obsługiwane formaty wideo, takie jak MP4, MOV, AVI, WebM i inne. Zaleca też utrzymywanie rozdzielczości obrazów na poziomie 4K lub niższej, a wideo na poziomie FHD lub niższej, ponieważ wyższe rozdzielczości mogą zwiększać czas przetwarzania bez poprawy zrozumienia przez model.
Strukturyzowane wyjście z JSON Schema
Dla przepływów produkcyjnych nie parsuj swobodnej prozy, jeśli kolejny krok oczekuje danych strukturyzowanych. Użyj response_format z JSON Schema, gdy trasa to obsługuje.
import json

completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "user",
            "content": (
                "Wyodrębnij zadania implementacyjne z tego żądania: "
                "Dodaj SSO, zmigruj webhooki rozliczeń i utwórz dzienniki audytu administratora."
            ),
        }
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "implementation_tasks",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "tasks": {
                        "type": "array",
                        "items": {
                            "type": "object",
                            "properties": {
                                "title": {"type": "string"},
                                "risk": {"type": "string"},
                                "owner": {"type": "string"},
                            },
                            "required": ["title", "risk", "owner"],
                            "additionalProperties": False,
                        },
                    }
                },
                "required": ["tasks"],
                "additionalProperties": False,
            },
        },
    },
)

data = json.loads(completion.choices[0].message.content)
print(data["tasks"])
Wywoływanie narzędzi i tool_choice
Dokument najlepszych praktyk wywoływania narzędzi K3 zaleca unikanie ogromnych inwentarzy narzędzi w jednym żądaniu. Wzorzec jest następujący: najpierw udostępnij funkcję wyszukiwania narzędzi, wymuś ich pobranie z tool_choice: "required" w pierwszej turze, a następnie dynamicznie załaduj tylko te definicje narzędzi, których model potrzebuje.
Minimalny przykład w stylu statusu zamówienia:
import json

tools = [
    {
        "type": "function",
        "function": {
            "name": "get_order_status",
            "description": "Wyszukaj status zamówienia klienta.",
            "parameters": {
                "type": "object",
                "properties": {
                    "order_id": {"type": "string"},
                },
                "required": ["order_id"],
                "additionalProperties": False,
            },
        },
    }
]

messages = [
    {"role": "user", "content": "Gdzie jest zamówienie A1024?"},
]

first = client.chat.completions.create(
    model="kimi-k3",
    messages=messages,
    tools=tools,
    tool_choice="required",
)

assistant_message = first.choices[0].message
messages.append(assistant_message.model_dump(exclude_none=True))

for call in assistant_message.tool_calls or []:
    args = json.loads(call.function.arguments)
    result = {"order_id": args["order_id"], "status": "Wysłane", "eta": "2026-07-24"}
    messages.append(
        {
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(result),
        }
    )

final = client.chat.completions.create(
    model="kimi-k3",
    messages=messages,
    tools=tools,
)

print(final.choices[0].message.content)
Najlepsze praktyki Kimi K3 dla zespołów produkcyjnych
Używaj Kimi K3 tam, gdzie jego moc jest oczywista
Kimi K3 to mocny kandydat do analizy repozytoriów, frontendu z iteracją, reprodukcji błędów, syntezy długich dokumentów, rozumowania na arkuszach, QA wspieranego wizją i przepływów agentowych wymagających narzędzi. Może być „zbyt dużym młotem” do krótkiego generowania treści, prostej klasyfikacji czy makr wsparcia o niskiej stawce. W CometAPI zbuduj reguły trasowania modeli, aby K3 dostawał trudne zadania, a tańsze modele obsługiwały rutynowy ruch.
Buduj ścieżki awaryjne, bo premiera jest ograniczona pojemnością
Raport AP o wstrzymaniu nowych subskrypcji przez Moonshot przypomina, że dostępność jest elementem wyboru modelu. Buduj fallbacki na poziomie aplikacji. Jeśli Kimi K3 zwraca błąd pojemności dostawcy, kieruj do innego modelu CometAPI o podobnych mocnych stronach, zmniejsz rozmiar kontekstu lub ponów próbę z narastającym opóźnieniem. Dbaj o UX: pokazuj postęp, zachowuj szkice i sprawiaj, by błędy były odzyskiwalne.
Starannie zachowuj kontekst w sesjach wieloturach
Kimi K3 był trenowany z zachowaniem historii rozumowania. Blog techniczny Moonshot ostrzega, że przełączanie na K3 w środku sesji lub nieprzekazywanie pełnej historycznej wiadomości asystenta może obniżyć stabilność. W praktyce przechowuj pełny obiekt wiadomości asystenta zwracany przez API dla narzędzi deweloperskich i agentów. Nie kompresuj tool_calls ani specyficznych pól rozumowania dostawcy, chyba że przetestowałeś wpływ.
Kontroluj koszt wyjścia i rozumowania
Zawsze ustawiaj max_completion_tokens. Dokumentacja Kimi podaje, że K3 domyślnie pozwala na 131,072 tokenów wyjściowych i można ustawić do 1,048,576, z zastrzeżeniem limitu kontekstu modelu. To potężne, ale może zaskoczyć panel rozliczeń, jeśli prompt zachęca do ogromnej odpowiedzi. Dla większości przepływów produktowych definiuj oddzielne limity: 800–1500 tokenów dla podsumowań, 2000–4000 dla szczegółowych analiz i większe limity tylko dla świadomego długiego generowania.
Projektuj pod kątem cache
Buforowanie kontekstu Kimi działa najlepiej, gdy powtarzalny początkowy kontekst pozostaje stabilny. Obecna dokumentacja cache Kimi opisuje go jako automatyczny: bez ręcznego tworzenia, ID cache ani zarządzania TTL. Dla agentów kodowych trzymaj instrukcje repozytorium, definicje narzędzi i polityki projektowe w spójnym prefiksie. Dla QA dokumentów utrzymuj paczkę dokumentów stabilną w powiązanych pytaniach. Unikaj przepisywania promptu systemowego w każdej turze i umieszczaj stały duży kontekst blisko początku tablicy messages, aby cache rozpoznawał powtarzalne prefiksy.
Używaj wizji rozważnie
Wejście wizji jest wartościowe, ale obrazy i wideo konsumują tokeny zależnie od treści i rozdzielczości. Używaj obrazów, gdy dodają informacji, których tekst nie odda: układ UI, wykresy, odręczne notatki, makiety, zrzuty błędów. Zmniejszaj zbyt duże rozdzielczości, przycinaj zbędne marginesy i łącz obraz z precyzyjnym pytaniem.
Wnioski i rekomendacje
Kimi K3 w CometAPI dostarcza możliwości klasy frontier — masywny kontekst, wizję i rozumowanie — w przystępnych cenach i przy minimalnym wysiłku integracyjnym. Niezależnie od tego, czy tworzysz agentów kodujących, aplikacje multimodalne, czy skalowalne usługi AI, zacznij od CometAPI dla ujednoliconego dostępu, oszczędności i niezawodności. Zarejestruj się, przetestuj szybkie starty powyżej i skaluj z pewnością.