
TL;DR
Hy4 to mocny punkt wyjścia do badań finansowych i generowania dużych ilości tekstu; GPT-6.1 Terra to mocny punkt wyjścia do kodowania w terminalu i debugowania. Oba modele akceptują tekst i obrazy oraz wspierają użycie narzędzi. Najbardziej czytelne różnice dotyczą wydajności w zadaniach, pojemności wyjścia i ceny: Terra prowadzi w teście kodowania terminalowego poniżej, podczas gdy Hy4 przewodzi w testach finansowych i badawczych i kosztuje mniej przy stawkach CometAPI podanych na liście.
Najważniejsze wnioski
- Wybieraj według obciążenia: Hy4 do badań i aplikacji wymagających dużego wolumenu wyjścia; Terra do kodowania w terminalu i debugowania.
- Oba oferują okno kontekstu rzędu około miliona tokenów. Terra zapewnia większy maksymalny budżet wyjścia.
- Terra prowadzi w Terminal-Bench 4.0 o 10.10 punktu procentowego; model Tencent prowadzi w Finance Agent v2.1 o 8.74 punktu według wyników Vals AI.
- Przykład CometAPI dla 10M tokenów wejściowych i 2M wyjściowych kosztuje $10.672 versus $16.00 przy wyświetlonych stawkach bazowych.
- Dopasuj endpoint, zachowanie narzędzi i ustawienia rozumowania do swojej aplikacji, zanim zmienisz dostawcę.
Specyfikacje, zrzuty benchmarków i ceny sprawdzone 6 listopada 2026 r.
Hy4 vs GPT-6.1 Terra: specyfikacje i możliwości
Hy4 łączy rozumienie tekstu i obrazów z rozumowaniem i obsługą narzędzi, w tym przepływami pracy obejmującymi wiersz poleceń i interfejsy graficzne. GPT-6.1 Terra wspiera rozumowanie wizualne, obsługę komputera i pisanie, z jawnymi kontrolami nakładu rozumowania i większym budżetem wyjścia. Poniższa tabela porównuje specyfikacje dostarczone przez Tencent i OpenAI.
Oficjalne specyfikacje API
Oba modele potrafią pracować z dużymi kolekcjami dokumentów i bazami kodu. Przy długich promptach zarezerwuj budżet również na odpowiedź: Tencent podaje maksymalne wejście 960K dla Hy4. Niewielka różnica w reklamowanej pojemności kontekstu ma mniejsze znaczenie przy wyborze niż to, jak dokładnie każdy model wykorzystuje Twoje materiały.
Terra oferuje więcej miejsca na długą odpowiedź — do 128,000 tokenów wyjściowych wobec publikowanego limitu 64K dla Hy4. To pomaga, gdy raport lub dostarczany kod musi zmieścić się w jednej odpowiedzi. Tokeny rozumowania również zużywają budżet wyjścia Terra.
Ustawienia rozumowania
Terra oferuje sześć poziomów nakładu rozumowania: none, low, medium, high, xhigh i max, z domyślnym medium. Daje to aplikacjom jawny sposób dostosowania nakładu wnioskowania do zadania. Żądanie klasyfikacji i trudne zadanie debugowania nie muszą używać tego samego budżetu.
Opis premiery Tencent mówi o rozumowaniu połączonym z percepcją wizualną i użyciem narzędzi, ale nie definiuje równoważnej, sześciostopniowej kontroli w tym ogłoszeniu. Traktuj parametry rozumowania jako specyficzne dla endpointu: nie kopiuj ustawienia nakładu jednego dostawcy do żądania u innego i nie zakładaj, że ma to samo znaczenie.
Hy4 vs GPT-6.1 Terra: wydajność
Vals AI dostarcza bezpośrednie wyniki dla obu modeli w obszarach kodowania, finansów, badań prawnych i zadań podatkowych. Te wyniki pokazują, gdzie każdy model jest użytecznym kandydatem dla Twojego obciążenia.
Niezależne wyniki benchmarków i warunki testów
Poniższe wyniki Vals Index v2.2 sprawdzono 10 listopada 2026 r. Wyższe wyniki są lepsze.
Vals AI podaje temperature 0.9, top_p 1.0 i limit wyjścia 65,536 tokenów dla Hy4; Terra używa maksymalnego nakładu rozumowania i limitu wyjścia 128,000 tokenów. Te ustawienia się różnią, więc odczytuj wyniki jako porównanie testowanych konfiguracji, a nie biegów o tym samym budżecie.
Przewaga Terry jest większa w zadaniach terminalowych niż w generowaniu kodu: 10.10 punktu w Terminal-Bench 4.0 wobec 2.99 punktu w Vibe Code Bench. To sprawia, że debugowanie i rozwój w wierszu poleceń są najczystszymi miejscami do rozpoczęcia ewaluacji Terry.
Hy4 prowadzi w Finance Agent, Legal Research Bench i Tax Agent Bench odpowiednio o 8.74, 15.39 i 17.32 punktu. Przepływy badawcze, które gromadzą dowody i stosują reguły dziedzinowe, są zatem obiecującymi punktami wyjścia dla Hy4.
Ogólna różnica wynosi 1.19 punktu procentowego, a opublikowane przedziały niepewności się pokrywają.
Benchmarki z premiery Hy4 od Tencent
Oficjalny wykres premiery Tencent dodaje wyniki dla kodowania i obsługi komputera. Porównuje Hy4 z GPT-6.1 Sol; do bezpośredniego zestawienia z GPT-6.1 Terra użyj tabeli Vals AI powyżej.
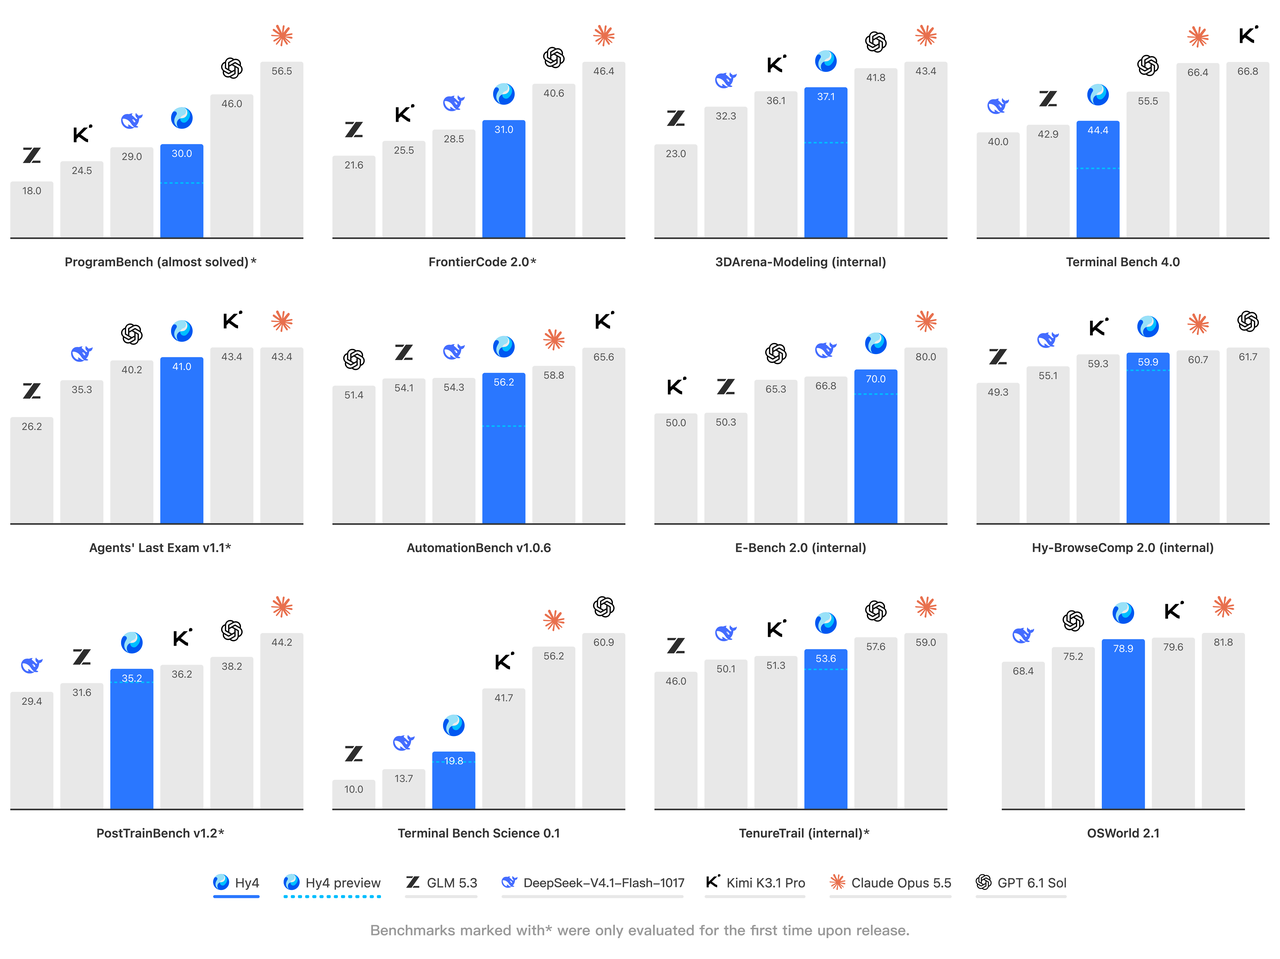
Wyniki benchmarków Hy4 raportowane przez Tencent, listopad 2026. Pokazany model OpenAI to GPT-6.1 Sol.
Na wykresie z premiery Tencent Hy4 uzyskuje 44.4 w Terminal Bench 4.0 i 78.9 w OSWorld 2.1. Te wartości opisują konfigurację ewaluacji Tencent i są odrębne od wyników Vals AI powyżej.
Przepływy pracy z wizją i obsługą komputera
Tencent wprowadza rozumienie obrazów w oficjalnym wydaniu i opisuje trening dla przepływów obejmujących narzędzia wiersza poleceń, interfejsy graficzne, Blender i CAD. To czyni analizę wykresów i wizualne zadania programowe centralnym elementem jego pozycjonowania.
OpenAI pozycjonuje swój model do przepływów opartych na ekranie, zwięzłego pisania i ograniczonych poprawek kodu. W aplikacji katalogowej przetestuj dopasowywanie zdjęć produktów; w pracach technicznych używaj rysunków z drobnymi etykietami i wymiarami; w automatyzacji desktopowej weryfikuj zapisane pliki i stan aplikacji.
Dobry zestaw testów wizualnych powinien oddzielać czytanie od działania. Najpierw zmierz, czy model wyodrębnia poprawne wartości lub identyfikuje właściwy element interfejsu. Następnie zmierz, czy kompletny przepływ osiąga wymagany wynik bez błędnych kliknięć, brakujących plików czy niepotrzebnej interwencji człowieka.
Szybkość i całkowite opóźnienie (end-to-end)
Dla czatu istotne miary szybkości to, jak szybko zaczyna się odpowiedź i jak długo trwa jej zakończenie. Dla agentów mierz pełne zadanie, w tym wykonanie narzędzi i ewentualne naprawy.
Porównuj oba modele na typowych i wymagających zadaniach przy oczekiwanej współbieżności. Śledź medianę i ogony opóźnień wraz z odsetkiem pomyślnych ukończeń: szybka odpowiedź ma wartość tylko wtedy, gdy dowozi efekt.
Hy4 vs GPT-6.1 Terra: koszt
Najpierw porównaj stawki za tokeny, a potem uwzględnij pracę wymaganą do uzyskania użytecznego wyniku. Poniższe ceny to stawki bazowe CometAPI w dolarach amerykańskich za milion tokenów; są one odrębne od kosztów per test raportowanych przez Vals AI.
Cennik wejścia i wyjścia w CometAPI
| Pozycja kosztowa | API Hy4 w CometAPI | API GPT-6.1 Terra w CometAPI |
|---|---|---|
| Wejście za milion tokenów | $0.6672 | $0.80 |
| Wyjście za milion tokenów | $2.00 | $4.00 |
Poniższa tabela używa podanych na liście stawek bazowych CometAPI w dolarach amerykańskich za milion tokenów. Porównuj osobno wejście i wyjście, a następnie oblicz koszt typowego żądania.
Przykładowy koszt dla 10,000 żądań
Rozważ 10,000 żądań, z których każde wykorzystuje 1,000 niekeszowanych tokenów wejścia i 200 rozliczanych tokenów wyjścia. Łącznie daje to 10 milionów tokenów wejściowych i 2 miliony tokenów wyjściowych. Używając powyższych cen bazowych CometAPI:
- Hy4: (10 × $0.6672) + (2 × $2.00) = $10.672.
- GPT-6.1 Terra: (10 × $0.80) + (2 × $4.00) = $16.00.
Hy4 kosztuje w tym przykładzie około 33.3% mniej. Ta estymacja obejmuje niekeszowane wejście i rozliczane wyjście; przy budżetowaniu kompletnego przepływu dodaj koszty cache, narzędzi i ponowień.
Rozliczenia bezpośrednie u dostawcy i żądania z długim kontekstem
Dla długich dokumentów na bezpośrednim API OpenAI, prompty powyżej 272K tokenów wejściowych uruchamiają 2× stawki wejścia i cache oraz 1.5× stawki wyjścia dla całego żądania. Zastosuj zasady rozliczeń usługi, z której korzystasz; przykład CometAPI powyżej używa stawek bazowych CometAPI. Szczegóły cen OpenAI.
Koszt na zaakceptowane zadanie
Zaakceptowane zadanie to takie, które spełnia kryteria jakości i ukończenia Twojej aplikacji. Zlicz wszystkie próby, użycie narzędzi i pracę weryfikacyjną potrzebne do osiągnięcia tego wyniku, wliczając wydatki na próby nieudane.
Koszt na zaakceptowane zadanie = łączne koszty modelu, ponowień, narzędzi i weryfikacji ludzkiej ÷ liczba zadań, które przechodzą kontrolę akceptacyjną.
Droższe wywołanie może być nadal ekonomiczne, jeśli eliminuje kilka prób naprawy. Z drugiej strony, gdy tańszy model spełnia próg jakości, płacenie wyższej stawki za każde zadanie może niewiele wnosić.
Który model wybrać: Hy4 czy GPT-6.1 Terra?
Zacznij od modelu, którego mocne strony odpowiadają Twojemu głównemu obciążeniu. Użyj poniższych wyborów, aby zbudować krótką listę, a następnie porównaj jakość i koszt ukończonych zadań.
Kiedy wybrać Hy4
Wybierz Hy4 w pierwszej kolejności do badań finansowych, analizy dokumentów prawnych lub podatkowych oraz aplikacji generujących dużo tekstu. Jego przewagi na trzech benchmarkach dziedzinowych czynią go użytecznym kandydatem do badań opartych na dowodach. Przy podanych stawkach CometAPI jego cena za wyjście jest o połowę niższa niż w Terze, co może mieć istotne znaczenie w masowym tworzeniu szkiców i raportów.
W pracach badawczych oceniaj gotową odpowiedź pod kątem poprawności źródeł, obliczeń i pokrycia pytania. Hy4 jest lepszym wyborem, gdy spełnia te wymagania przy niższym koszcie całkowitym, w tym przeglądu i ponowień.
Kiedy wybrać GPT-6.1 Terra
Wybierz GPT-6.1 Terra w pierwszej kolejności do kodowania w terminalu, debugowania i poprawek kodu. Jego przewaga 10.10 punktu w Terminal-Bench to najsilniejszy sygnał kodowy w tym porównaniu. Większy budżet wyjścia sprawia też, że warto go testować pod kątem długich raportów i obszernych odpowiedzi z kodem.
Oceniaj Terrę pod kątem tego, czy łatki przechodzą testy i czy dostarczane wyniki są kompletne. W pracach wizualnych lub desktopowych porównaj oba modele na Twoich rzeczywistych ekranach, wykresach i plikach, sprawdzając finalny zapisany rezultat.
Kierowanie badań i kodowania do różnych modeli
Mieszane obciążenie może skorzystać z użycia obu modeli. Asystent analizy finansowej mógłby używać Hy4 do badań i tworzenia raportów, a następnie wywołać Terrę, gdy skrypt analityczny wymaga debugowania:
- Wyślij gromadzenie dowodów i tworzenie raportu do Hy4.
- Sprawdź cytowania, wartości ze źródeł i obliczenia przed akceptacją raportu.
- Skieruj niesprawny skrypt analityczny do Terry wraz z kodem, wyjściem błędu i oczekiwanym zachowaniem.
- Uruchom poprawiony skrypt i zastosuj te same kontrole dowodowe przed zwróceniem wyniku końcowego.
Użyj drugiego modelu, gdy na tyle poprawia wynik końcowy, że pokrywa dodatkowy koszt i prace integracyjne.
Gdzie uzyskać dostęp do Hy4 i GPT-6.1 Terra?
Dostęp od oficjalnych dostawców
Dostęp do Hy4 uzyskasz przez Tencent Cloud TokenHub, a do GPT-6.1 Terra przez API OpenAI. Skorzystaj z dokumentacji dostawcy w zakresie uwierzytelniania, identyfikatorów modeli i rozliczeń.
Dostęp przez CometAPI i kompatybilność narzędzi
CometAPI oferuje oba modele pod identyfikatorami hy4 i gpt-6.1-terra. Strony modeli zawierają przykłady żądań i ceny dla każdej trasy: Hy4 i GPT-6.1 Terra.
W aplikacjach z obsługą narzędzi zweryfikuj wsparcie wybranej trasy dla wywołań funkcji i strukturyzowanych wyjść. Na bezpośrednim API OpenAI wywoływanie narzędzi przez Terrę wymaga Responses API.
Jak testować i wdrażać wybrany model
Zanim zmienisz ruch produkcyjny, porównaj modele na reprezentatywnych zadaniach, używając tych samych wejść, narzędzi i kryteriów zaliczenia. Zapisuj pomyślne ukończenia, całkowity koszt i czas, a następnie stopniowo wdrażaj silniejszą trasę.
- Uwzględnij rutynowe żądania i trudne przypadki istotne dla Twoich użytkowników.
- Sprawdzaj argumenty narzędzi, strukturyzowane wyjścia, błędy i status ukończenia.
- Ustal limity ponowień i wyzwalacze rollbacku przed skierowaniem ruchu produkcyjnego.
Wnioski
Wybierz Hy4, gdy priorytetem są jakość badań i niższe koszty generowania tekstu. Wybierz GPT-6.1 Terra, gdy najbardziej liczą się kodowanie w terminalu, debugowanie i większy budżet wyjścia.
W aplikacji mieszanej zacznij od jednego modelu na główne obciążenie i dodaj drugą trasę tam, gdzie poprawia wyniki. Najlepszy wybór to ten, który dokładnie wykonuje Twoje zadania przy koszcie, jaki jesteś w stanie utrzymać.