
TL;DR
Kimi K3.1 Pro to aktualizacja Kimi K3 od Moonshot AI z 24 października 2026 r. Dodatkowe post-trenowanie poprawia autonomiczne kodowanie, badania finansowe i rozszerzone przepływy pracy z użyciem narzędzi, przy zachowaniu podobnej, około milionowej pojemności kontekstu.
Niezależne ewaluacje pokazują ogólnie wyższą wydajność, a standardowe oficjalne stawki za tokeny wejścia/wyjścia spadają o jedną trzecią. Aktualizacja nadal wymaga testów obciążeniowych: głębsze rozumowanie może podnieść opóźnienie zadań i całkowite koszty, podczas gdy K3 zachowuje niewielką przewagę w AA-LCR i obecnie ma dostępne wagi do samodzielnego hostingu.
Kluczowe wnioski
- Najbardziej wyraźne zyski dotyczą wykonania agentowego. Artificial Analysis raportuje wyniki Terminal-Bench 4.0 na poziomie około 67% dla K3.1 Pro wobec 13% dla K3; wewnętrzne wyniki Moonshot w Financial Research rosną z 58.8 do 70.4.
- Niższe ceny tokenów nie gwarantują niższych kosztów zadań. Standardowe oficjalne stawki wejścia/wyjścia spadają z $3/$15 do $2/$10 za milion tokenów, ale dodatkowe rozumowanie, wywołania narzędzi i ponowienia mogą zniwelować oszczędności.
- Okno kontekstu pozostaje bez zmian. Oba modele obsługują do 1,048,576 tokenów. K3 pozostaje nieznacznie z przodu w cytowanej ewaluacji AA-LCR v1.1, więc przetestuj dokładność długiego kontekstu na własnych dokumentach.
- Dostępność wag może determinować wybór. Na 24 października 2026 r. wagi K3 są dostępne; wagi K3.1 Pro mają zostać udostępnione do 4 listopada. Zespoły wymagające natychmiastowego samodzielnego hostingu powinny uwzględnić tę różnicę.
Kimi K3.1 Pro vs Kimi K3: przegląd i specyfikacja
Kimi K3.1 Pro bazuje na K3 dzięki dodatkowemu post-trenowaniu, z usprawnieniami skoncentrowanymi na kodowaniu, badaniach finansowych i rozszerzonych przepływach pracy agentów. Oba modele zachowują około milion tokenów kontekstu. Główne różnice dotyczą wydajności zadań, cen tokenów, opcji serwowania i dostępności wag.
| Specyfikacja | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Deweloper | Moonshot AI | Moonshot AI |
| Data wydania | 24 października 2026 | 16 lipca 2026 |
| Architektura | MoE wywiedzione z K3, dalej post‑tren. | MoE z KDA, AttnRes |
| Rozmiar modelu | klasa 3T i 104B aktywnych parametrów | 2.8T łącznie i 104B aktywnych parametrów |
| Okno kontekstu | Do 1,048,576 tokenów | Do 1,048,576 tokenów |
| Standardowa cena API: wej./wyj. | $2 / $10 za milion tokenów | $3 / $15 za milion tokenów |
| Wersja Highspeed | Dostępna | Brak osobnej wersji K3 Highspeed |
| Dostępność wag | Plan wydania do 4 listopada 2026 | Dostępne na licencji Kimi K3 |
Dostępność wag odzwierciedla stan na 24 października 2026 r. Ceny API podane są w USD dla standardowego wejścia i wyjścia, bez opłat za zapis do cache, podatków i innych opłat.
Architektura i post-trenowanie
K3 wprowadził architekturę o 2.8 biliona parametrów łączącej Kimi Delta Attention, Attention Residuals i Stable LatentMoE. Aktywuje około 104 miliardy parametrów na token.
Moonshot opisuje K3.1 Pro jako wersję post-trenowaną K3, opracowaną przy znacząco większym nakładzie obliczeń w etapie post‑train. Aktualizacja koncentruje się na zastosowaniu możliwości modelu w zadaniach wieloetapowych, w tym użyciu narzędzi, debugowaniu i weryfikacji wyników. Ogłoszenie nie wprowadza osobno nazwanego modelu bazowego.
Wspólne możliwości i wymagania API
Oba modele obsługują wejścia multimodalne, wywoływanie narzędzi, strukturyzowane wyjścia i cache kontekstu. Format wejść obrazów i wideo zależy od wybranej trasy API. Oba zawsze rozumują i obsługują poziomy low, high i max wysiłku rozumowania, z max jako domyślnym.
Dla konwersacji wieloturowych i wywołań narzędzi integracje muszą zachować kompletne wiadomości asystenta, łącznie z treścią rozumowania i wywołaniami narzędzi, zgodnie z wymaganiami API. Rzeczywiste limity kontekstu i dostępność funkcji należy również sprawdzić dla wybranego dostawcy, produktu i poziomu subskrypcji.
Kimi K3.1 Pro vs Kimi K3: wydajność
Dowody pochodzą z wewnętrznych testów Moonshot i raportowanych porównań, a także niezależnych ewaluacji zewnętrznych.
Należy je interpretować osobno, ponieważ harnessy benchmarkowe, zbiory testowe, ustawienia rozumowania i kryteria oceny mogą się różnić.
Ewaluacja startowa Artificial Analysis raportuje wzrost o 11 punktów w kompozytowym Intelligence Index, ze szczególnie dużymi poprawami w kodowaniu terminalowym i przepływach pracy agentów.
| Niezależny benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Różnica |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 pp |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
Są to wyniki niezależnych ewaluacji. Użyto wartości zaokrąglonych, gdy ewaluator podaje wyniki zaokrąglone. Niższe wskaźniki halucynacji są lepsze.
Największa poprawa występuje w kodowaniu terminalowym. K3.1 Pro radzi sobie znacząco lepiej w zadaniach wymagających wykonywania poleceń, interakcji ze środowiskiem, debugowania i powtarzalnej walidacji.
AutomationBench-AA również pokazuje istotny wzrost, sugerując silniejsze wykonanie w przepływach pracy SaaS.
Wydane przez Moonshot benchmarki koncentrują się na kodowaniu, nauce, rekonstrukcji 3D, finansach, pracy wiedzo‑wej oraz agentach autonomicznych.
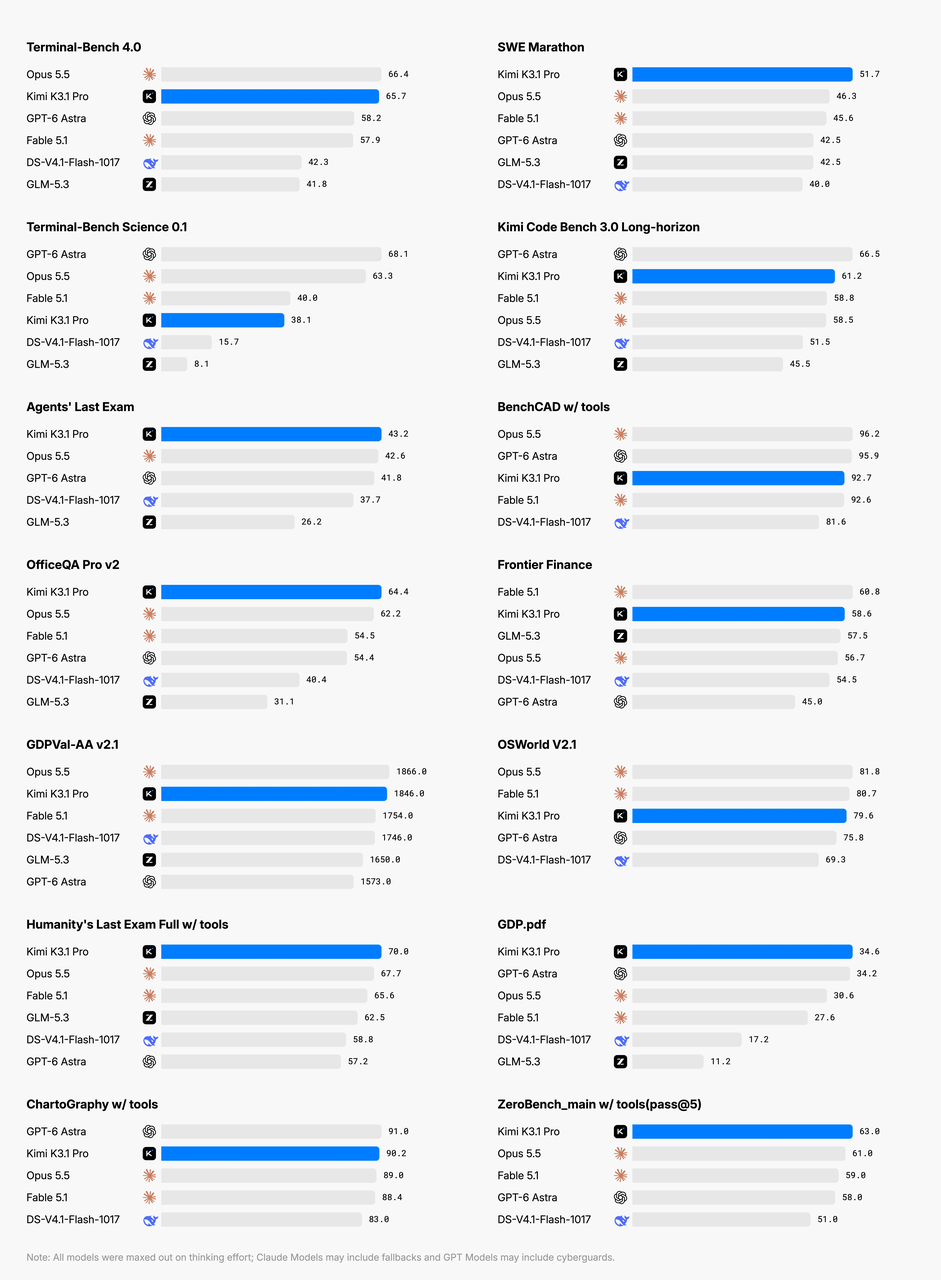
Wybrane porównania obejmują Claude Opus 5.5 i GPT-6 Astra. Porównuj każdy wynik w ramach nazwanego benchmarku i podanej konfiguracji.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Inny model | Wynik modelu porównawczego |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro zbliża się lub przewyższa kilka wiodących modeli zastrzeżonych w wybranych zadaniach. Nie dominuje jednak we wszystkich kategoriach.
Na przykład pozostaje w tyle za Claude Opus 5.5 w porównaniach BenchCAD i OSWorld raportowanych przez dostawcę, a oficjalny wykres pokazuje większą słabość w Terminal-Bench Science.
Ustawienia ewaluacji różnią się: Artificial Analysis używa harnessu mini-swe-agent dla Terminal-Bench 4.0, podczas gdy Moonshot używa Claude Code. Porównuj wyniki w ramach tego samego ustawienia testowego; harnessy, wysiłek rozumowania i limity czasu wykonania mogą wpływać na wyniki.
Programowanie i inżynieria oprogramowania
W przypadku złożonego autonomicznego kodowania K3.1 Pro jest na ogół silniejszym wyborem.
Wewnętrzne wyniki Moonshot dla Kimi Code Bench 3.0 Long-horizon rosną z 55.95% dla K3 do 61.2% dla K3.1 Pro, co daje wzrost o około 5.25 punktu procentowego.
Niezależne wyniki Terminal-Bench również pokazują znaczną poprawę. Testy te oceniają wykonanie wieloetapowe: zrozumienie repozytorium, modyfikację plików, uruchamianie poleceń, diagnozowanie błędów i weryfikację rezultatu.
K3.1 Pro jest silniejszym kandydatem do rozwoju wieloplikowego, autonomicznej pracy w terminalu i rozszerzonego debugowania. W przypadku prostego generowania kodu porównaj oba modele na własnych zadaniach; K3 pozostaje natychmiastową opcją, gdy wymagany jest samodzielny hosting.
Ważne rozróżnienie: wyniki benchmarków kodowych silnie zależą od frameworka agenta. Narzędzia, prompty, limity wykonania i środowiska testowe wpływają na wynik.
Dla produkcyjnego rozwoju oprogramowania najlepszą ewaluacją jest nadal dopasowane porównanie na własnych repozytoriach.
Badania finansowe i operacje biznesowe
Modelowanie finansowe dostarcza jednych z najczytelniejszych porównań między modelami.
Moonshot przetestował K3 i K3.1 Pro w wewnętrznych ewaluacjach obejmujących tworzenie arkuszy, jakość badań i symulowane operacje biznesowe.
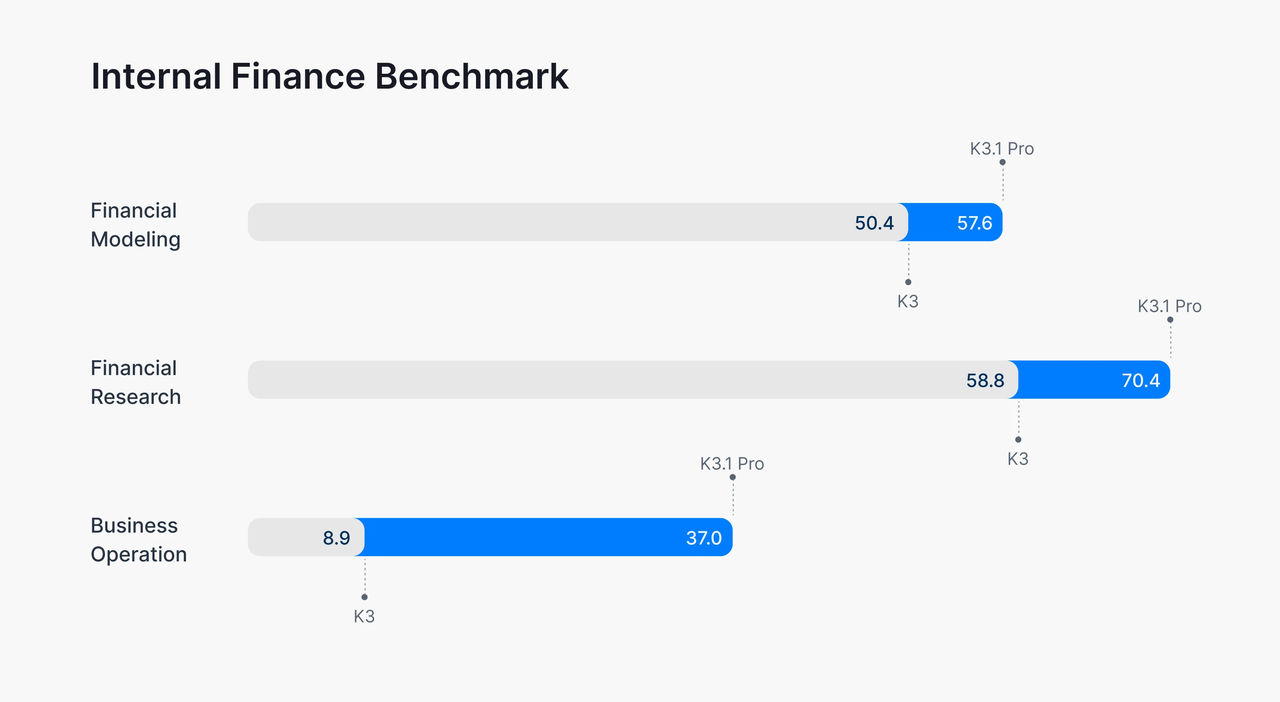
Wewnętrzne wyniki finansowe Moonshot obejmują modelowanie finansowe, badania i symulowane operacje biznesowe. Te wyniki zadań raportowane przez dostawcę nie są miarą zwrotów z inwestycji. Ustawień per‑zadanie nie należy uznawać za identyczne z niespokrewnionymi benchmarkami.
W wewnętrznych testach Moonshot Financial Modeling rośnie z 50.4 do 57.6, wzrost o 7.2 punktu, a Financial Research rośnie z 58.8 do 70.4, wzrost o 11.6 punktu. Business Operation rośnie z 8.9 do 37.0, około 4.2 raza wyniku K3.
Ten benchmark ocenia zarządzanie długohoryzontowe i podejmowanie decyzji w symulowanym środowisku biznesowym. Jest więc bliżej związany z planowaniem agentowym niż prostym odpowiadaniem na pytania finansowe.
Financial Research mierzy zdolność do tworzenia badań opartych na dowodach z poszanowaniem wymagań źródłowych i ograniczeń informacyjnych. Financial Modeling koncentruje się na zależnościach matematycznych, logice arkuszy i jakości skoroszytów.
Wzorzec sugeruje, że K3.1 Pro jest szczególnie wartościowy, gdy zadania finansowe wymagają trwałego rozumowania, weryfikacji i ustrukturyzowanych rezultatów.
Dla inwestorów, analityków i użytkowników biznesowych praktyczną korzyścią może być lepsza obsługa przepływów pracy obejmujących wiele dokumentów. Żaden model nie powinien być używany jako niekwestionowany autorytet w decyzjach finansowych.
Rozumowanie w długim kontekście i wiarygodność faktów
Jednak wyniki AA-LCR dla długiego kontekstu pokazują niewielką przewagę K3. To użyteczne przypomnienie, że nowszy model może znacznie się poprawić ogólnie, nie wygrywając każdej specjalistycznej kategorii.
Raportowane ewaluacje pokazują mniej błędów faktycznych na odpowiednich zbiorach testowych.
Na Kimi Hallu Bench Hard z narzędziami Moonshot raportuje spadek wskaźnika błędów na poziomie twierdzeń z 23.4% dla K3 do 8.3% dla K3.1 Pro.
To około 65% względnej redukcji w celowo trudnym teście warunków skrajnych Moonshot, a nie szacunku codziennych wskaźników błędów. Osobno, Artificial Analysis raportuje spadek wskaźnika halucynacji AA-Omniscience z 53% do 44%. Obie ewaluacje używają różnych metod, więc ich wartości procentowe nie są bezpośrednio porównywalne.
Praktyczna lekcja jest taka, że K3.1 Pro wydaje się bardziej wiarygodny w ocenianych zadaniach, ale poprawa faktograficzna nie eliminuje potrzeby retrievalu, cytowań, sprawdzania obliczeń i przeglądu ludzkiego w krytycznych przepływach pracy.
Analiza danych: dowody z ewaluacji Plotly
Plotly oceniło standardowy K3.1 Pro przez OpenRouter, używając prywatnego testu 43 pytań nad syntetyczną hurtownią danych energii wiatrowej. Nie testowano Highspeed. Wyniki ilustrują kompromis między jakością odpowiedzi, czasem ukończenia i kosztem w tej konkretnej, opartej na SQL ścieżce analitycznej.
| Miara analityki danych Plotly | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Poprawne odpowiedzi | 35/43 | 42/43 |
| Dokładność | 81.4% | 97.7% |
| Odkryte ukryte wzorce | 0/5 | 5/5 |
| Zidentyfikowane problemy jakości | 1/3 | 3/3 |
| Pełny koszt ewaluacji | $5.01 | $13.47 |
| Mediana czasu na pytanie | 43 sekundy | 2.5 minuty |
W tej ewaluacji K3.1 Pro odpowiedział poprawnie na więcej pytań i zidentyfikował więcej ukrytych wzorców oraz problemów jakości danych, ale poniósł wyższy koszt i dłuższy medianowy czas ukończenia.
Raportowane opłaty to zaobserwowane koszty ewaluacji, a nie szacunki obliczone z oficjalnych standardowych cen API Moonshot. Opublikowana konfiguracja nie ustanawia, że wszystkie ustawienia dostawców były identyczne między dwoma przebiegami modelu, więc różnic nie można przypisać wyłącznie modelowi.
Wyniki te wspierają ocenę K3.1 Pro w zadaniach analitycznych, gdzie dodatkowe ustalenia mogą uzasadnić więcej czasu i wydatków. Nie ustanawiają tej samej przewagi dokładności lub kosztów advantag
Czy Kimi K3.1 Pro jest szybszy niż Kimi K3?
Rozróżnij przepustowość tokenów wyjściowych od całkowitego opóźnienia zadania.
Artificial Analysis raportuje 73.5 tokena wyjściowego na sekundę dla K3.1 Pro w porównaniu z 38.5 dla K3 przy maksymalnym wysiłku rozumowania, korzystając z API Kimi. Są to pomiary generowania tokenów, sprawdzone 24 października 2026 r.; całkowite opóźnienie zależy również od długości rozumowania i wykonania narzędzi.
Jednak szybsze generowanie tokenów nie gwarantuje szybszego ukończenia zadania.
Moonshot oferuje także K3.1 Pro Highspeed, reklamowany jako dostarczający około dwa do trzech razy szybszy output niż wariant standardowy. To usprawnienie prędkości serwowania, a nie osobno potwierdzony wzrost „inteligencji”.
K3.1 Pro ma wyższą raportowaną przepustowość tokenów wyjściowych, ale niekoniecznie kończy zadania szybciej. Rozróżnij szybkość generowania tokenów od czasu potrzebnego na rozumowanie, wywołania narzędzi i zakończenie pracy.
Szybkość wyjścia vs czas ukończenia zadania
Artificial Analysis raportuje prędkości wyjścia 73.5 tokena na sekundę dla K3.1 Pro i 38.5 dla K3 przy maksymalnym wysiłku rozumowania, korzystając z API Kimi. Pomiary te sprawdzono 24 października 2026 r. i opisują przepustowość generowania tokenów, a nie całkowite opóźnienie zadania.
Model może generować tokeny szybciej, a mimo to trwać dłużej ogółem, jeśli produkuje więcej tokenów rozumowania lub wykonuje dodatkowe wywołania narzędzi. W omawianej ewaluacji Plotly medianowy czas ukończenia dla K3.1 Pro wyniósł 2.5 minuty na pytanie, w porównaniu z 43 sekundami dla K3, przy wyższej dokładności.
W przypadku aplikacji interaktywnych mierz czas do pierwszego tokena i całkowity czas ukończenia zadania na rzeczywistej trasie dostawcy. Sama przepustowość wyjścia nie wystarcza do przewidzenia responsywności.
Rozważ K3.1 Pro Highspeed
Moonshot reklamuje K3.1 Pro Highspeed jako dostarczający około dwa do trzech razy szybszy output niż standardowy K3.1 Pro. To dotyczy prędkości serwowania; nie należy interpretować tego jako dwukrotnego–trzykrotnego skrócenia całkowitego czasu ukończenia zadania.
Rozważ Highspeed dla interaktywnego kodowania lub asystentów, gdzie użytkownicy czekają na odpowiedzi. Porównaj całkowite opóźnienie, sukces zadania i łączny naliczony koszt z wariantem standardowym przed wyborem. Highspeed ma wyższe regularne stawki za tokeny wejścia i wyjścia, podczas gdy stawka za zcache’owane wejście jest taka sama.
Kimi K3.1 Pro vs Kimi K3: koszt
Oficjalne stawki API i CometAPI
Standardowe oficjalne stawki wejścia, wyjścia i trafień cache dla K3.1 Pro są o jedną trzecią niższe niż w K3. Wymienione stawki wejścia i wyjścia CometAPI są o kolejne 20% niższe od odpowiadających im stawek oficjalnych.
| Model | Oficjalne wejście / 1M | Oficjalne wyjście / 1M | Oficjalne zcache’owane wejście / 1M | CometAPI wejście / 1M | CometAPI wyjście / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Sprawdź bieżącą wycenę | Sprawdź bieżącą wycenę |
USD za milion tokenów; stawki sprawdzone 24 października 2026 r. Kolumny wejścia pokazują stawki dla regularnego, niezcache’owanego wejścia. Podatki i osobno rozliczane opłaty są wyłączone.
Official Kimi pricing wymienia także opłaty za zapis do cache: $2/$4 za milion tokenów dla standardowego Pro z retencją 5 minut/1 godzina oraz $4/$8 dla Highspeed. Trafienia cache, zapisy cache i regularne wejście to osobne, wzajemnie wykluczające się kategorie rozliczeń.
Oficjalne Kimi i CometAPI to oddzielne trasy dostawców. Potwierdź bieżące ceny i wsparcie cache dla wybranej trasy, w tym dostępność Highspeed. Porównuj łączny naliczony koszt zadania oraz stawki tokenów.
Przykład kosztu przy stałej liczbie tokenów
Rozważ obciążenie zużywające 100,000 niezcache’owanych tokenów wejściowych i 20,000 tokenów wyjściowych.
Dla tego stałego obciążenia koszt oficjalnego API wynosi $0.60 z K3 i $0.40 z K3.1 Pro. Przy wymienionych stawkach CometAPI te same liczby tokenów kosztują odpowiednio $0.48 i $0.32. Suma obejmuje wyłącznie podane tokeny wejścia i wyjścia.
Ale to porównanie przy stałej liczbie tokenów. Złożone przepływy agentowe mogą zużywać różne ilości tokenów rozumowania i wywołań narzędzi w zależności od modelu.
Oszczędności na tokenach znikają
Niech I oznacza identyczną liczbę niezcache’owanych tokenów wejściowych, O — naliczoną liczbę tokenów wyjściowych Kimi K3, a P — naliczoną liczbę tokenów wyjściowych Kimi K3.1 Pro, wszystkie mierzone w milionach. Przy standardowych oficjalnych stawkach z tabeli opłaty wynoszą 3I + 15O oraz 2I + 10P dolarów. Są równe, gdy P = 1.5O + 0.1I.
Dla żądań o dużym udziale wyjścia K3.1 Pro może więc zużyć około 50% więcej naliczonych tokenów wyjściowych, zanim utraci przewagę cenową. To obliczenie zakłada niezmienione stawki i wyklucza cache, opłaty za narzędzia i inne osobno naliczane użycie. Używaj faktycznych, naliczanych kategorii tokenów, a nie jedynie widocznej długości odpowiedzi.
Koszt na pomyślnie ukończone zadanie
Oblicz koszt na pomyślnie ukończone zadanie jako łączny naliczony koszt wszystkich prób ewaluacji podzielony przez liczbę unikalnych zadań spełniających zdefiniowane kryterium akceptacji. Uwzględnij opłaty za nieudane próby, ponowienia i przekroczenia czasu, gdy dostawca je nalicza; dzielenie tylko kosztu udanych przebiegów przez ich liczbę może zaniżać koszt na sukces.
Utrzymaj zbiór zadań, kryteria akceptacji, limit ponowień i politykę timeoutów stałe między Kimi K3 i K3.1 Pro. Raportuj współczynnik sukcesu wraz z kosztem na sukces, aby odrzucanie trudnych zadań nie sprawiało, że model pozornie wydaje się bardziej ekonomiczny. Jeśli żadne zadanie się nie powiedzie, koszt na sukces jest niezdefiniowany, a nie zero.
Kimi K3.1 Pro vs Kimi K3: porównanie i wybór
Dla większości hostowanych obciążeń agentowych K3.1 Pro jest silniejszym punktem wyjścia. Niemniej decyzja powinna odzwierciedlać złożoność zadań i wymagania wdrożenia.
| Zastosowanie | Rekomendowany model | Uzasadnienie |
|---|---|---|
| Autonomiczne kodowanie | Kimi K3.1 Pro | Oceń zmiany wieloplikowe, pracę w terminalu, debugowanie i wyniki testów końcowych. |
| Wielodokumentowe badania finansowe | Kimi K3.1 Pro | Poprawione benchmarki badań i operacji biznesowych |
| Złożona analiza danych | Kimi K3.1 Pro | Lepsze wykrywanie problemów i testowanie jakości danych |
| Tworzenie 3D i przepływy CAD | Kimi K3.1 Pro | Silne, wyspecjalizowane możliwości z narzędziami |
| Proste zadania tekstowe | Porównaj oba | Porównaj rutynowe teksty i proste zadania kodowe na obu modelach; dodatkowe rozumowanie może dodać opóźnienie bez poprawy akceptowalnego wyniku. |
| Dokładność retrievalu w długim kontekście | Porównaj oba | K3 ma niewielką przewagę w AA-LCR |
| Natychmiastowy samodzielny hosting | Kimi K3 | Wagi do pobrania są już dostępne |
| Interaktywne, wysoko‑zdolne agenty | K3.1 Pro Highspeed | Szybsze serwowanie, z zastrzeżeniem walidacji kosztów |
| Wrażliwe kosztowo przepływy produkcyjne | Porównaj oba | Niższe ceny tokenów nie muszą oznaczać niższego kosztu zadania |
Hostowana automatyzacja i profesjonalne przepływy pracy
Dla hostowanych agentów kodujących i przepływów analitycznych oceń K3.1 Pro na trudnych częściach faktycznej pracy: zmianach wieloplikowych, zbieraniu dowodów, sprawdzaniu obliczeń i odzyskiwaniu po nieudanym wywołaniu narzędzia. Preferuj mierzalne spadki nieudanych zadań lub prac naprawczych ponad wyższy, nagłówkowy wynik.
Dla ugruntowanych aplikacji K3 zachowaj dotychczasową trasę jako bazę porównawczą. Zadania rutynowe mogą już spełniać próg akceptacji, podczas gdy specjalistyczne zadania długiego kontekstu mogą zachowywać się inaczej niż zbiorcze benchmarki. Priorytetyzuj segmenty obciążenia, gdzie aktualizacja przynosi mierzalną korzyść.
Samodzielny hosting i ograniczenia wdrożeniowe
Na 24 października 2026 r. pełne wagi K3 są dostępne do wdrożenia, z zastrzeżeniem licencji modelu i wymagań sprzętowych. Pełne wagi K3.1 Pro nie zostały jeszcze opublikowane.
Moonshot planuje udostępnić wagi K3.1 Pro do 4 listopada 2026 r.. To ogłoszony plan wydania, a nie dostępny checkpoint; potwierdź opublikowane wagi i obowiązujące warunki przed planowaniem samodzielnego hostingu.
Kryteria oceny produkcyjnej
Porównuj K3 i K3.1 Pro na reprezentatywnych zadaniach, używając tych samych promptów, narzędzi, kryteriów akceptacji, limitów ponowień i timeoutów. Zapisuj ustawienia dostawcy i rozumowania oraz zachowuj kompletne wiadomości asystenta zgodnie z wymaganiami API.
Mierz sukces zadania, opóźnienie, zużycie tokenów i koszt na sukces, wliczając naliczone niepowodzenia i ponowienia. Przejrzyj przypadki, w których K3 odniósł sukces, a K3.1 Pro nie. Dla oceny ludzkiej ukryj etykiety modeli i losuj kolejność wyjść.
Jeśli K3.1 Pro spełnia Twoje progi jakości, opóźnienia i kosztów, wdrażaj go stopniowo z przetestowanym fallbackiem K3.
Kontrolowana migracja i fallbacki
Praktyczne podejście to rozpoczęcie od małego procentu ruchu produkcyjnego na K3.1 Pro.
Utrzymuj K3 jako fallback podczas walidacji. Porównuj jakość zadań, opóźnienia, wskaźniki błędów i wydatki przed zwiększeniem użycia K3.1 Pro.
Zwróć szczególną uwagę na schematy wywołań narzędzi, pola wiadomości związane z rozumowaniem, wejścia multimodalne i parsowanie wyjścia. Zgodność API nie gwarantuje automatycznie identycznego zachowania aplikacji.
Zyski i regresje w benchmarkach
Jeśli oba modele odpowiedziały na te same 43 pytania i uzyskały wyniki 35 i 42, K3.1 Pro mógł skorygować siedem porażek K3 bez regresji albo osiem porażek, tracąc jedną wcześniej poprawną odpowiedź. Sam łączny wynik nie rozróżnia tych scenariuszy.
Sprawdź sparowane odpowiedzi i sklasyfikuj je jako: oba poprawne, tylko K3 poprawny, tylko K3.1 Pro poprawny lub oba niepoprawne. Przejrzyj sukcesy wyłączne dla K3 pod kątem zadań o najwyższym wpływie przed migracją. Wynik 42/43 opisuje ten zestaw testowy; nie gwarantuje 97.7% sukcesu dla innego obciążenia.
Ślepa ocena wyjść modeli
Ukryj etykiety modeli i losuj kolejność, w jakiej recenzenci widzą wyjścia. Zdefiniuj rubrykę akceptacji przed przeglądem: dla kodu używaj testów wykonywalnych i testów regresji; dla badań sprawdzaj wsparcie źródłami, obliczenia i kompletność wymaganego deliverable. Oceniaj poprawność przed rozważeniem prezentacji lub stylu.
Ujawnij tożsamość modelu, opóźnienie i naliczony koszt dopiero po zarejestrowaniu oceny jakości. Oddziela to jakość wyjścia od oczekiwań względem nowszego modelu. Rozstrzygaj rozbieżności opinii według tych samych testów lub materiałów źródłowych i zachowuj decyzje, aby późniejsza zmiana modelu lub promptu mogła być oceniana spójnie.
Gdzie można uzyskać dostęp do Kimi K3.1 Pro i Kimi K3?
Oficjalny dostęp dostawcy
Użyj udokumentowanego Kimi K3 API lub Kimi K3.1 Pro API do bezpośredniej integracji z dostawcą. Sprawdź identyfikator modelu dla wybranego endpointu, obsługiwane pola żądań i limity konta. Publiczny dostęp API i możliwe do pobrania wagi modelu to oddzielne opcje wdrożenia.
Dostęp przez CometAPI
Deweloperzy mogą uzyskać dostęp do Kimi K3.1 Pro API i Kimi K3 API przez ujednolicony interfejs CometAPI i porównać obie trasy na tym samym obciążeniu aplikacji.
To sprawia, że migracja z K3 do K3.1 Pro jest relatywnie prosta, zwłaszcza dla aplikacji już korzystających z interfejsu czatu zgodnego z OpenAI.
Aby używać CometAPI, utwórz konto i klucz API, a następnie skonfiguruj aplikację z endpointem i identyfikatorem modelu w dokumentacji integracji. Wybierz kimi-k3 dla K3, kimi-k3.1-pro dla standardowego K3.1 Pro lub kimi-k3.1-pro-highspeed dla trasy Highspeed tam, gdzie obsługiwana. Zacznij od małego żądania, a następnie porównaj to samo obciążenie między modelami, sprawdzając zwracane wyniki, opóźnienie i naliczone użycie.
Podsumowanie
Kimi K3.1 Pro jest silniejszym kandydatem do wymagającego autonomicznego kodowania, badań finansowych i rozszerzonych przepływów pracy agentów w przeanalizowanych ewaluacjach. Kimi K3 pozostaje istotny dla natychmiastowego samodzielnego hostingu i obciążeń, w których jego obecny profil dokładności lub opóźnień już spełnia wymagania.
Wybieraj na podstawie reprezentatywnych zadań i faktycznej trasy dostawcy. Porównaj udane rezultaty, opóźnienia i łączne wydatki, a następnie migruj stopniowo. Niższe ceny tokenów i wyższe zbiorcze wyniki benchmarków to użyteczne punkty wyjścia, ale nie przesądzają o najlepszej konfiguracji dla każdej aplikacji.