
TL;DR
MiniMax M3.1 Flash to wysokoprędkościowy model SI zaprojektowany do autonomicznych agentów, inżynierii oprogramowania, obsługi komputera oraz złożonej automatyzacji przepływów pracy. Oficjalnie wydany 19 października 2026 r., łączy okno kontekstu o wielkości 1 miliona tokenów z konfigurowaną głębokością rozumowania i niższymi kosztami inferencji.
MiniMax raportuje do 200+ tokenów wyjściowych na sekundę, 70% redukcję kosztów obciążenia agentów w porównaniu z poprzednikiem oraz konkurencyjne wyniki w Automation-Bench, DeepSWE i OSWorld. Przy cenach $0.15 za milion tokenów wejściowych i $0.60 za milion tokenów wyjściowych model czyni wieloetapowe przepływy pracy agentów SI bardziej ekonomicznymi.
Kluczowe wnioski
- Wydajność MiniMax M3.1 Flash: Benchmarki raportowane przez dostawcę obejmują Automation-Bench 62.8, DeepSWE v1.1 73.7 i OSWorld 2.0 61.7, podkreślając możliwości w automatyzacji agentów, kodowaniu i obsłudze komputera.
- Cennik API MiniMax M3.1 Flash: Oficjalne stawki to $0.15/M wejścia, $0.60/M wyjścia i $0.015/M buforowanego (cached) wejścia. Stawki CometAPI to $0.80/M wejścia i $3.20/M wyjścia na dzień 21 października 2026 r., bez opublikowanej stawki cache na stronie modelu.
- Szybkość inferencji MiniMax M3.1 Flash: MiniMax raportuje 200+ tokenów/s w sprzyjających warunkach i przepustowość P50 powyżej 170 tokenów/s, wspierając responsywne przepływy pracy agentów.
- Efektywność agentów MiniMax M3.1 Flash: Pięć poziomów nakładu rozumowania pozwala deweloperom zbalansować ukończenie zadań, opóźnienia i całkowite koszty agentów SI.
- Dostęp do API MiniMax M3.1 Flash: Deweloperzy mogą uzyskać dostęp do wydanego modelu przez MiniMax lub eksplorować integrację CometAPI, używając specyficznych dla dostawcy identyfikatorów modeli i cen.
Czym jest MiniMax M3.1 Flash?
MiniMax M3.1 Flash to nowej generacji model językowy zoptymalizowany pod kątem agentowego rozumowania, kodowania, użycia narzędzi i autonomicznego wykonywania przepływów pracy. MiniMax oficjalnie zaprezentował M3.1 Flash 19 października 2026 r.
Zamiast koncentrować się wyłącznie na inteligencji konwersacyjnej lub izolowanych wynikach, model celuje w całkowity koszt ukończenia zadań poprzez powtarzalne rozumowanie, wywołania narzędzi i wieloetapowe wykonanie. MiniMax powiązał też wczesny rozwój z Space Bunny, anonimowo wdrożonym modelem, który – jak twierdzi – przetworzył ponad 200 bilionów tokenów przed ogłoszeniem; to raportowana liczba użycia, a nie opublikowana liczba tokenów treningowych.
Dla deweloperów budujących autonomicznych asystentów kodowania, firmowych współpracowników SI i agentów przeglądarkowych M3.1 Flash oferuje trzy istotne zalety: rozległą pojemność kontekstu, szybkie generowanie i niedrogi użytek tokenów.
Jakie są specyfikacje MiniMax M3.1 Flash?
| Specyfikacje API | MiniMax M3.1 Flash |
|---|---|
| Deweloper | MiniMax |
| Oficjalne wydanie | October 19, 2026 |
| Rodzina modeli | MiniMax M3 |
| Okno kontekstu | 1,000,000 tokens |
| Główne możliwości | Automatyzacja agentów, kodowanie, rozumowanie, obsługa komputera |
| Modalności wejściowe | Tekst, obraz i wideo via MiniMax's OpenAI-compatible API; confirm support on other providers |
| Modalność wyjściowa | Text |
| Kontrola rozumowania | Low, medium, high, xhigh, max |
| Zgłaszana szybkość wyjścia | Up to 200+ tokens/s |
| Zgłaszana szybkość P50 | 170+ tokens/s |
| Kanały dostępu | MiniMax API, M Plan, MiniMax Code |
| Otwarte wagi | Announced for future release |
| Liczba parametrów specyficzna dla M3.1 | Not established in the announcement |
Duże okno kontekstu jest wartościowe dla kodowania w skali repozytoriów i obciążonych dokumentami przepływów pracy, ale nie gwarantuje doskonałego przywoływania. Agenci produkcyjni powinni nadal stosować selektywne wyszukiwanie, strukturyzowane odpowiedzi narzędzi i kompresję kontekstu.
Pięć ustawień nakładu rozumowania pozwala deweloperom zarezerwować intensywne obliczenia dla złożonego planowania i debugowania zamiast wydawać maksymalny wysiłek na każdą klasyfikację, ekstrakcję czy prosty krok wyboru narzędzia. Ponieważ pojedyncze żądanie agenta może wywołać dziesiątki inwokacji modelu, drobne oszczędności w rutynowych krokach mogą materialnie obniżyć całkowity koszt.
Jak MiniMax M3.1 Flash wypada w benchmarkach?
MiniMax raportuje wyniki benchmarków obejmujące automatyzację biznesową, inżynierię oprogramowania, obsługę komputera, cyberbezpieczeństwo i multimodalne rozumowanie. To oceny raportowane przez dostawcę, a nie substytut niezależnych testów wdrożeń w realnych warunkach.
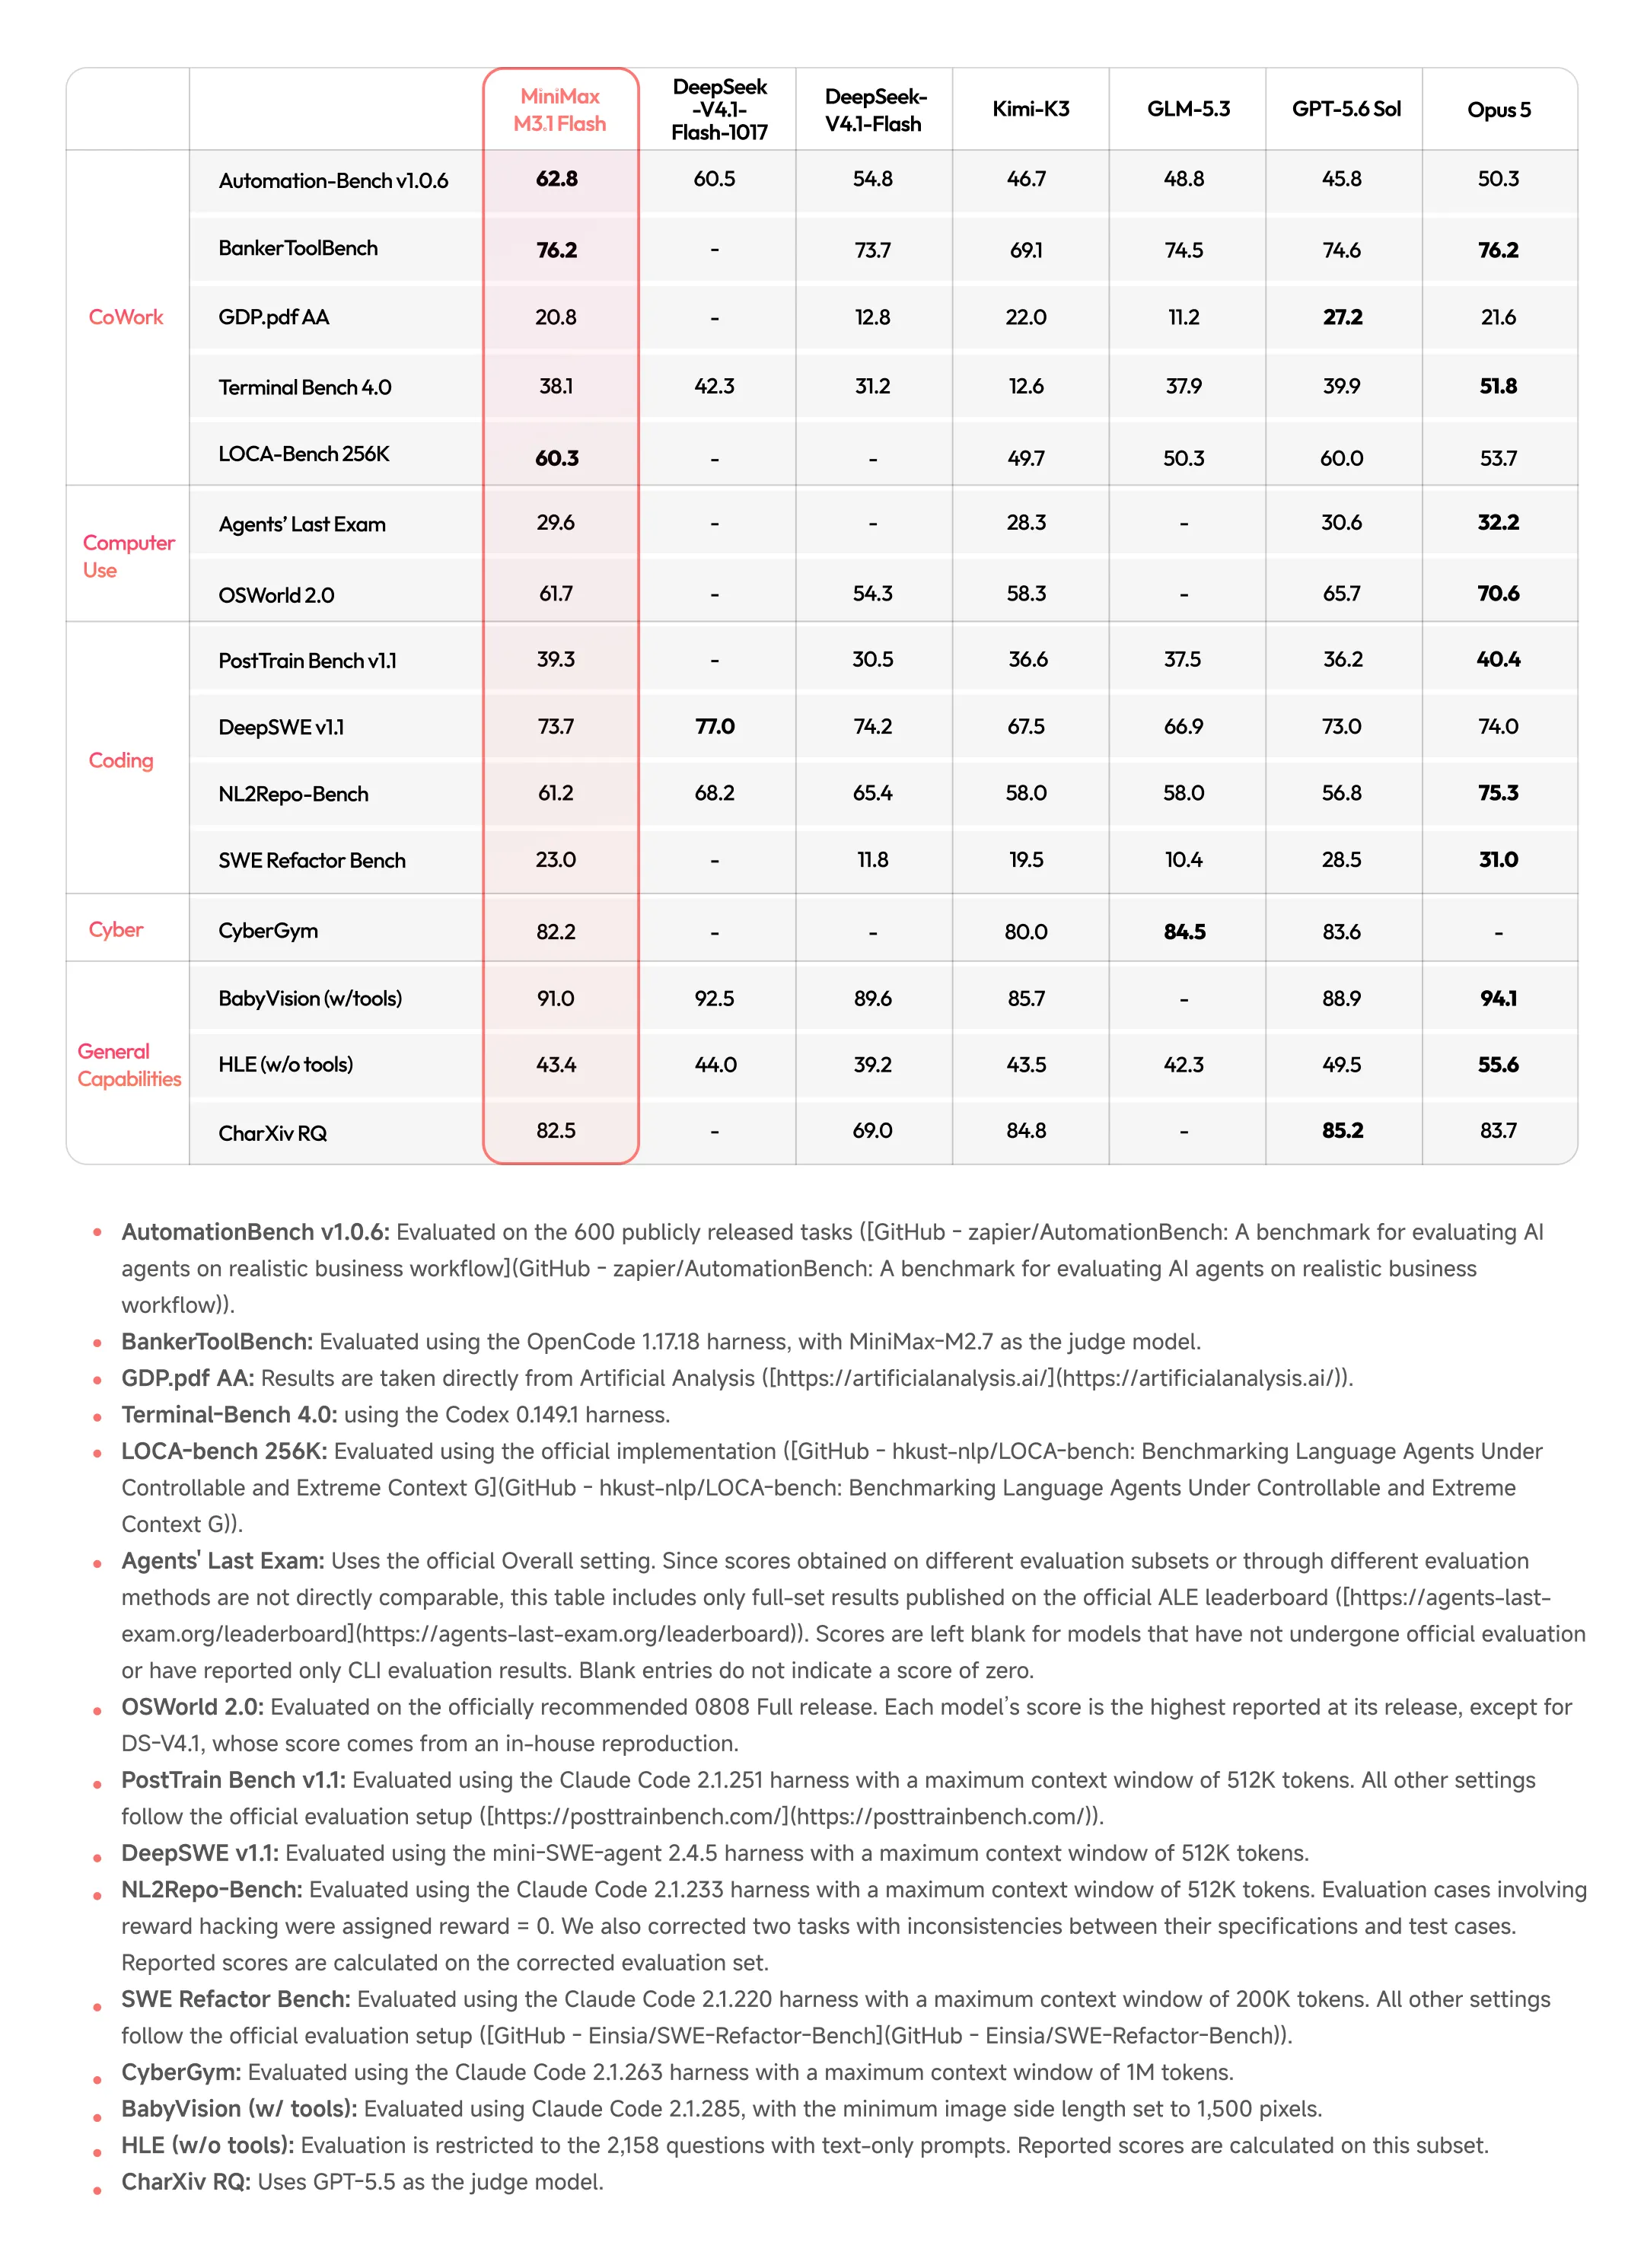
Oficjalne porównanie benchmarków MiniMax, włącznie z uwagami do oceny. Wyniki są raportowane przez dostawcę i nie stanowią jednolitego niezależnego testu.
| Oficjalne wyniki benchmarków | M3.1 Flash | Co mierzy |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Wielostopniowa automatyzacja biznesowa |
| BankerToolBench | 76.2 | Rozumowanie finansowe i narzędzia |
| LOCA-Bench 256K | 60.3 | Wykonywanie zadań agenta w długim kontekście |
| DeepSWE v1.1 | 73.7 | Autonomiczna inżynieria oprogramowania |
| Terminal Bench 4.0 | 38.1 | Rozwiązywanie problemów w terminalu |
| OSWorld 2.0 | 61.7 | Interakcja z pulpitem/komputerem |
| Agents’ Last Exam | 29.6 | Złożone zadania ekonomiczne |
| CyberGym | 82.2 | Rozwiązywanie problemów cyberbezpieczeństwa |
| BabyVision with tools | 91.0 | Wizualne rozumowanie z narzędziami |
| HLE without tools | 43.4 | Wymagająca wiedza i rozumowanie bez narzędzi |
Automation-Bench v1.0.6 używa 600 publicznych zadań. BankerToolBench używa OpenCode 1.17.18 z MiniMax-M2.7 jako sędzią; Terminal Bench 4.0 używa Codex 0.149.1. DeepSWE v1.1 używa mini-SWE-agent 2.4.5 z limitem kontekstu 512K. OSWorld używa wydania 0808 Full: tabela łączy najwyższy wynik wydania każdego modelu, z wyjątkiem DeepSeek V4.1, który MiniMax odtworzył wewnętrznie. Te różne konfiguracje ograniczają możliwość bezpośrednich wniosków między modelami.
Dla automatyzacji biznesowej priorytetyzuj Automation-Bench i BankerToolBench; dla agentów kodujących przeanalizuj DeepSWE i wyniki terminalowe. OSWorld ocenia interakcje ze środowiskiem komputerowym, a nie tylko generowanie instrukcji. Pojedynczy wynik zbiorczy nie zastąpi analizy specyficznej dla zadania.
Jak szybki jest MiniMax M3.1 Flash?
Systemy agentowe często wykonują wiele sekwencyjnych wywołań modelu, więc sama przepustowość nie opisuje responsywności.
| Metryka szybkości | Deklarowana wydajność |
|---|---|
| Codzienna szczytowa przepustowość wyjścia | 200+ tokens/s |
| Mediana przepustowości wyjścia (P50) | 170+ tokens/s |
| Poprawa inferencji online | Nearly 3× vs prior generation |
| Redukcja kosztu obciążenia agenta | 70% vs predecessor |
Te deklarowane przez dostawcę liczby szybkości i kosztu obciążenia opisują ocenę w momencie premiery MiniMax, a nie gwarantowaną przepustowość czy oszczędności dla każdej aplikacji. Sprzęt serwujący, współbieżność, długości promptów i zmienność powtórzeń nie są w pełni wyspecyfikowane w ogłoszeniu.
Całkowite opóźnienie obejmuje także opóźnienie pierwszego tokena, narzut rozumowania, czas narzędzi, ponowne próby i zależności między krokami. Szybszy generator może utracić przewagę, jeśli agent potrzebuje więcej wywołań, by ukończyć to samo zadanie.
Ile kosztuje API MiniMax M3.1 Flash?
MiniMax ogłosił płaskie standardowe stawki dla M3.1 Flash bez osobnego, wyższego progu długiego kontekstu w początkowym opisie cen. Tymczasem MiniMax M3.1 Flash Preview API w CometAPI oferuje odrębną strukturę cen z 20% zniżką względem wyświetlanych stawek referencyjnych.
| Kategoria cenowa | Oficjalny M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Tokeny wejściowe / 1M | $0.15 | $0.24 | $0.48 |
| Tokeny wyjściowe / 1M | $0.60 | $0.96 | $1.92 |
| Buforowane wejście / 1M | $0.02 | $0.05 | $0.10 |
| Struktura cen | Flat rate | Short-context tier | Long-context tier |
Oficjalny cennik API MiniMax czyni M3.1 Flash szczególnie atrakcyjnym dla obciążeń agentów. Tokeny wyjściowe kosztują czterokrotność standardowej stawki wejścia, podczas gdy buforowane wejście kosztuje jedną dziesiątą. Powtarzalne instrukcje i historie narzędzi mogą zatem stać się głównym celem optymalizacji.
Ceny Preview CometAPI zaczynają się od $0.24 za milion tokenów wejściowych i $0.96 za milion tokenów wyjściowych, co stanowi 20% zniżki względem wyświetlanych referencyjnych cen Preview. Jednak stawki te pozostają wyższe niż nowo ogłoszone oficjalne ceny M3.1 Flash, ponieważ obie oferty używają różnych baz cenowych.
Dla deweloperów kluczową różnicą jest to, że CometAPI zapewnia ujednolicone doświadczenie integracji, podczas gdy oficjalne wydanie oferuje obecnie niższe publikowane stawki tokenów. Przed wdrożeniem zweryfikuj aktywną wersję modelu, warstwę długości kontekstu i zasady rozliczeń, aby dokładnie oszacować koszt przepływów pracy autonomicznych agentów.
Koszt MiniMax M3.1 Flash na zadanie agenta
Szacunkowy koszt inferencji = (uncached input tokens × input rate + cached input tokens × cache rate + output tokens × output rate) / 1,000,000.
| Przykładowe obciążenie | Niebuforowane wejście | Buforowane wejście | Wyjście | Szac. koszt |
|---|---|---|---|---|
| Prosty asystent narzędzi | 10K | 0 | 2K | $0.0027 |
| Przegląd pull request | 40K | 20K | 8K | $0.0111 |
| Wieloetapowy agent kodujący | 100K | 200K | 30K | $0.0360 |
| Badania korporacyjne | 300K | 700K | 80K | $0.1035 |
| Duży autonomiczny workflow | 1M | 3M | 200K | $0.3150 |
Ilustracyjne kalkulacje, a nie zaobserwowane rozliczenia. Zakładają, że odczyty z cache kwalifikują się do ogłoszonej stawki cache; nie obejmują kosztów narzędzi, wyszukiwania, przeglądania, infrastruktury i przeglądów przez człowieka.
Nakład rozumowania a koszt zadania
Analiza kosztów Automation-Bench MiniMax łączy nakład rozumowania z sukcesem w benchmarku i wydatkami na inferencję per zadanie.
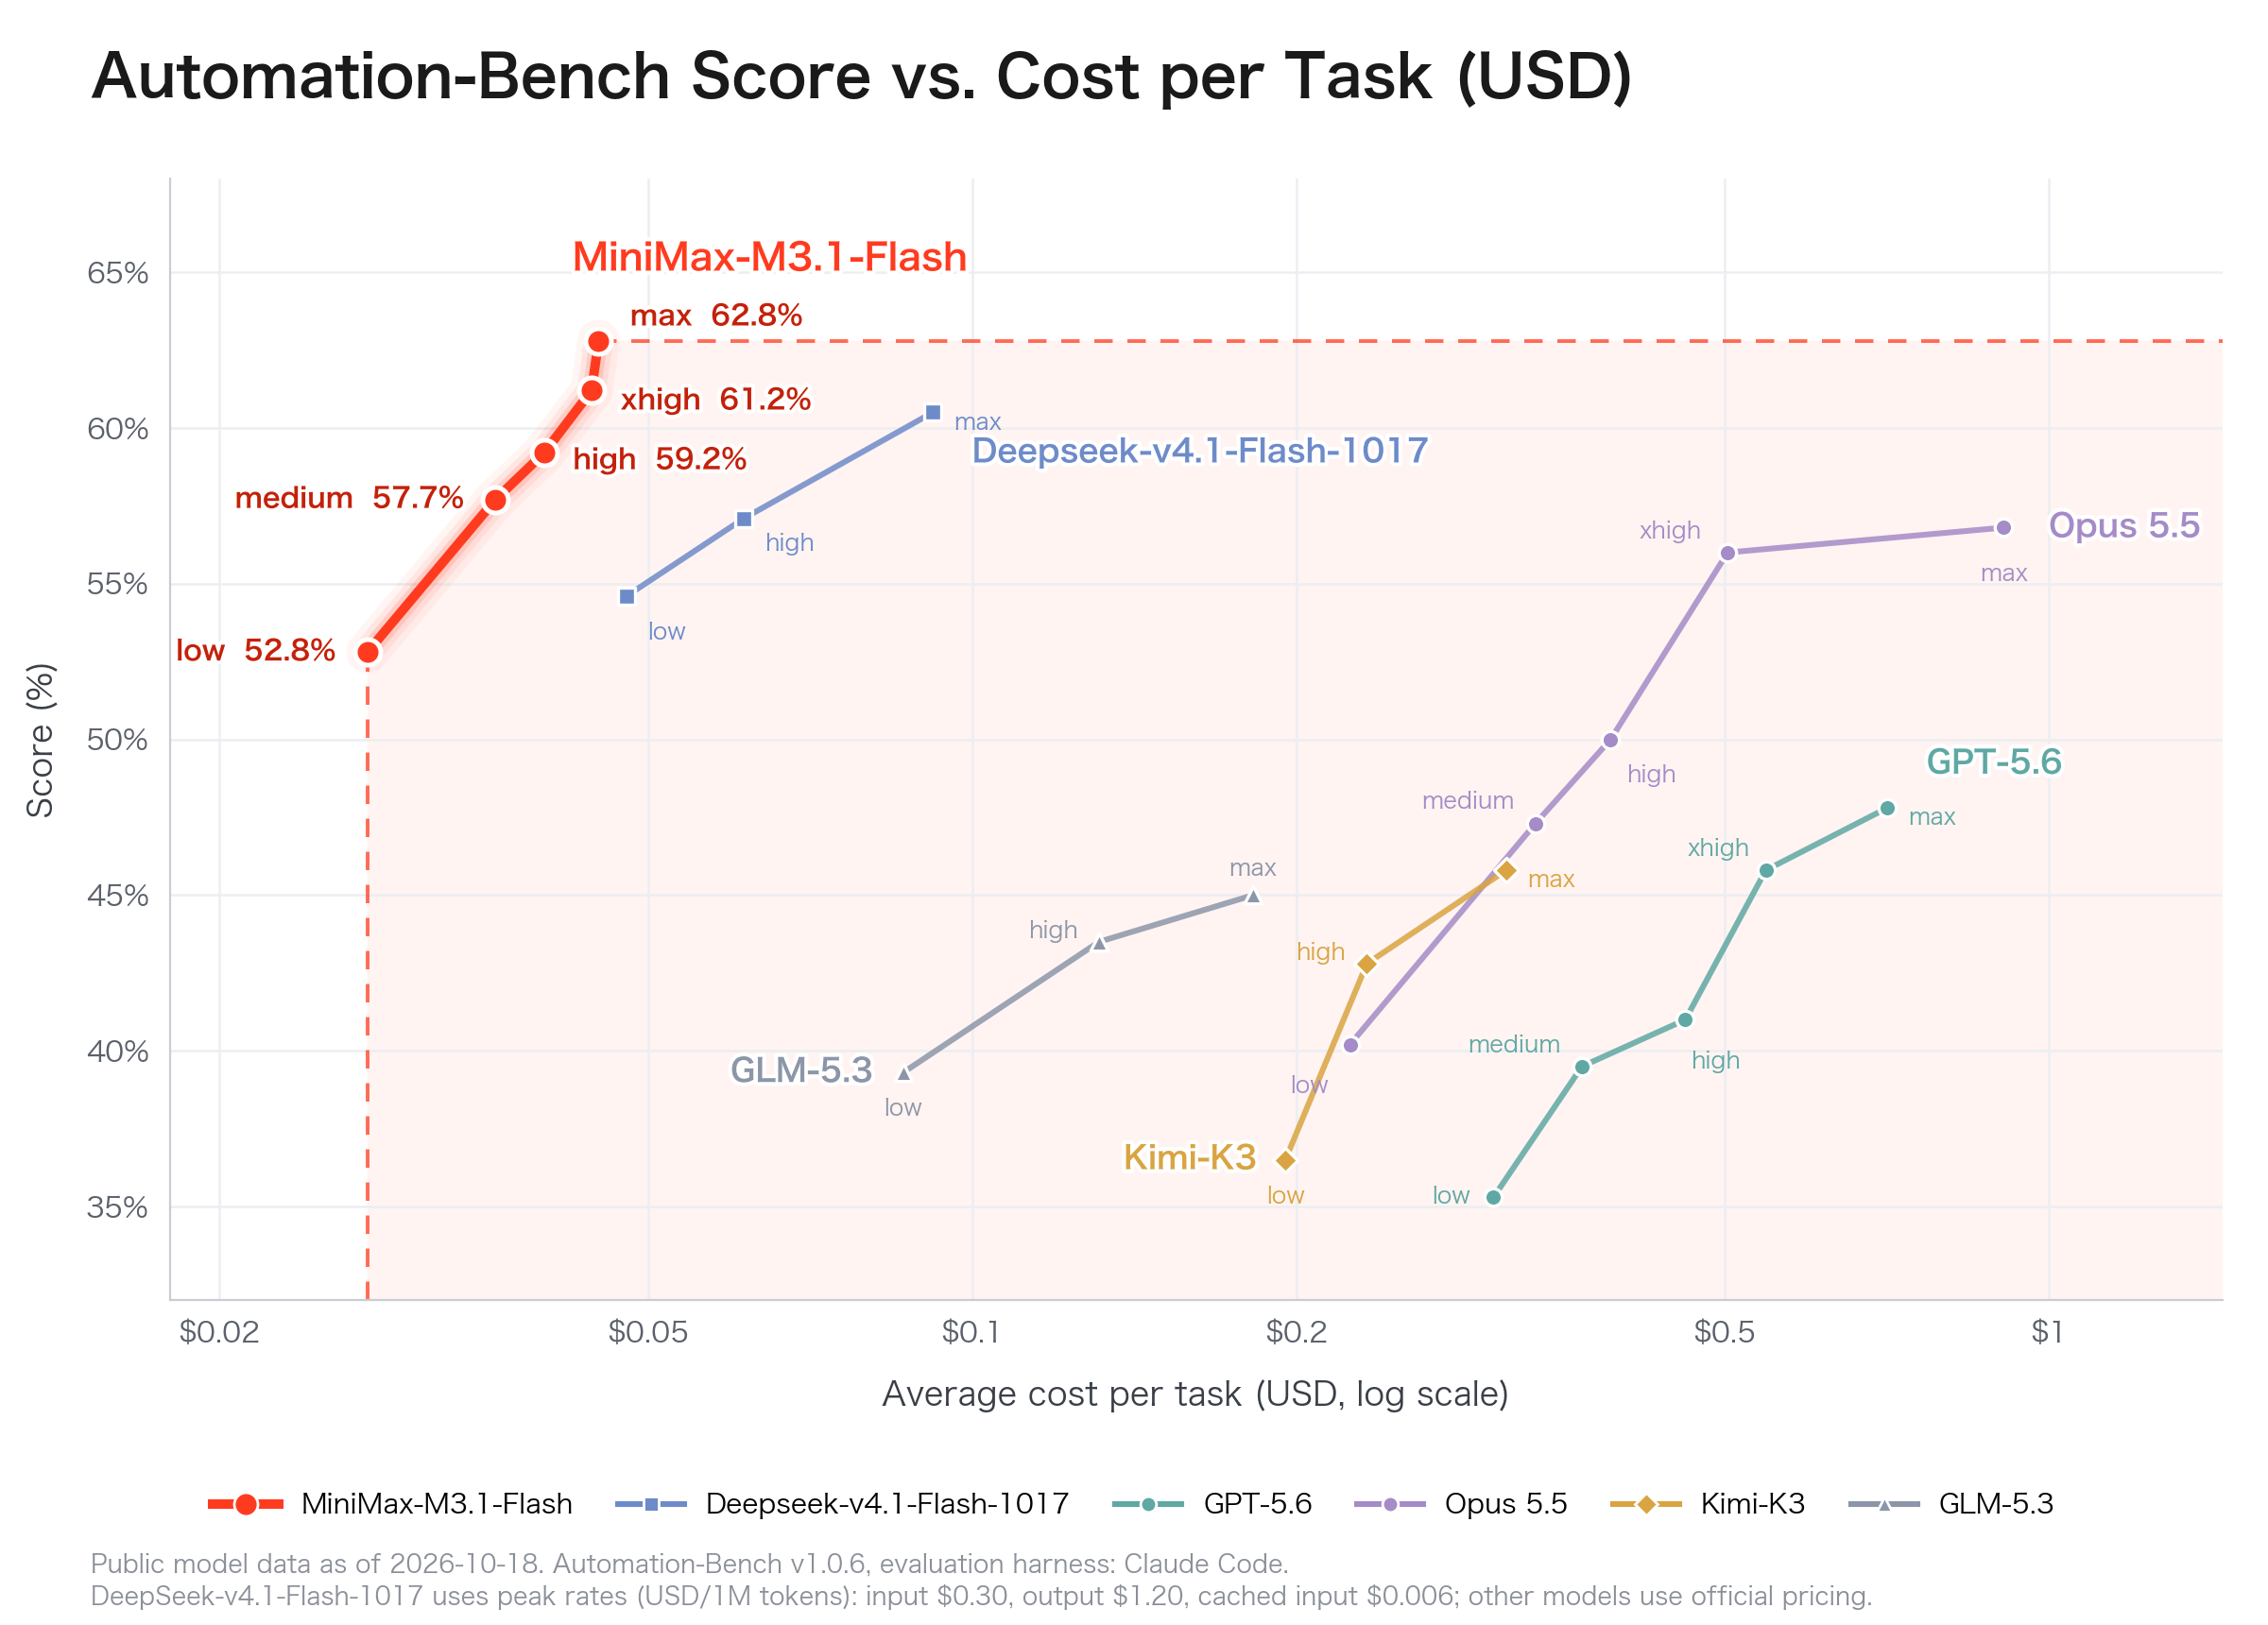
Oficjalny wykres MiniMax zależności wyniku Automation-Bench od kosztu. Oś pozioma jest logarytmiczna; dokładne koszty w dolarach nie są wydrukowane dla poszczególnych punktów MiniMax.
Uwagi do oceny oficjalnego wykresu wskazują Automation-Bench v1.0.6 z harness Claude Code i publiczne dane modeli na dzień 18 października 2026 r. DeepSeek używa szczytowych stawek tokenów; pozostałe modele używają oficjalnych cen. Szczegóły sprzętowe i przedziały ufności dla powtórzeń nie są określone.
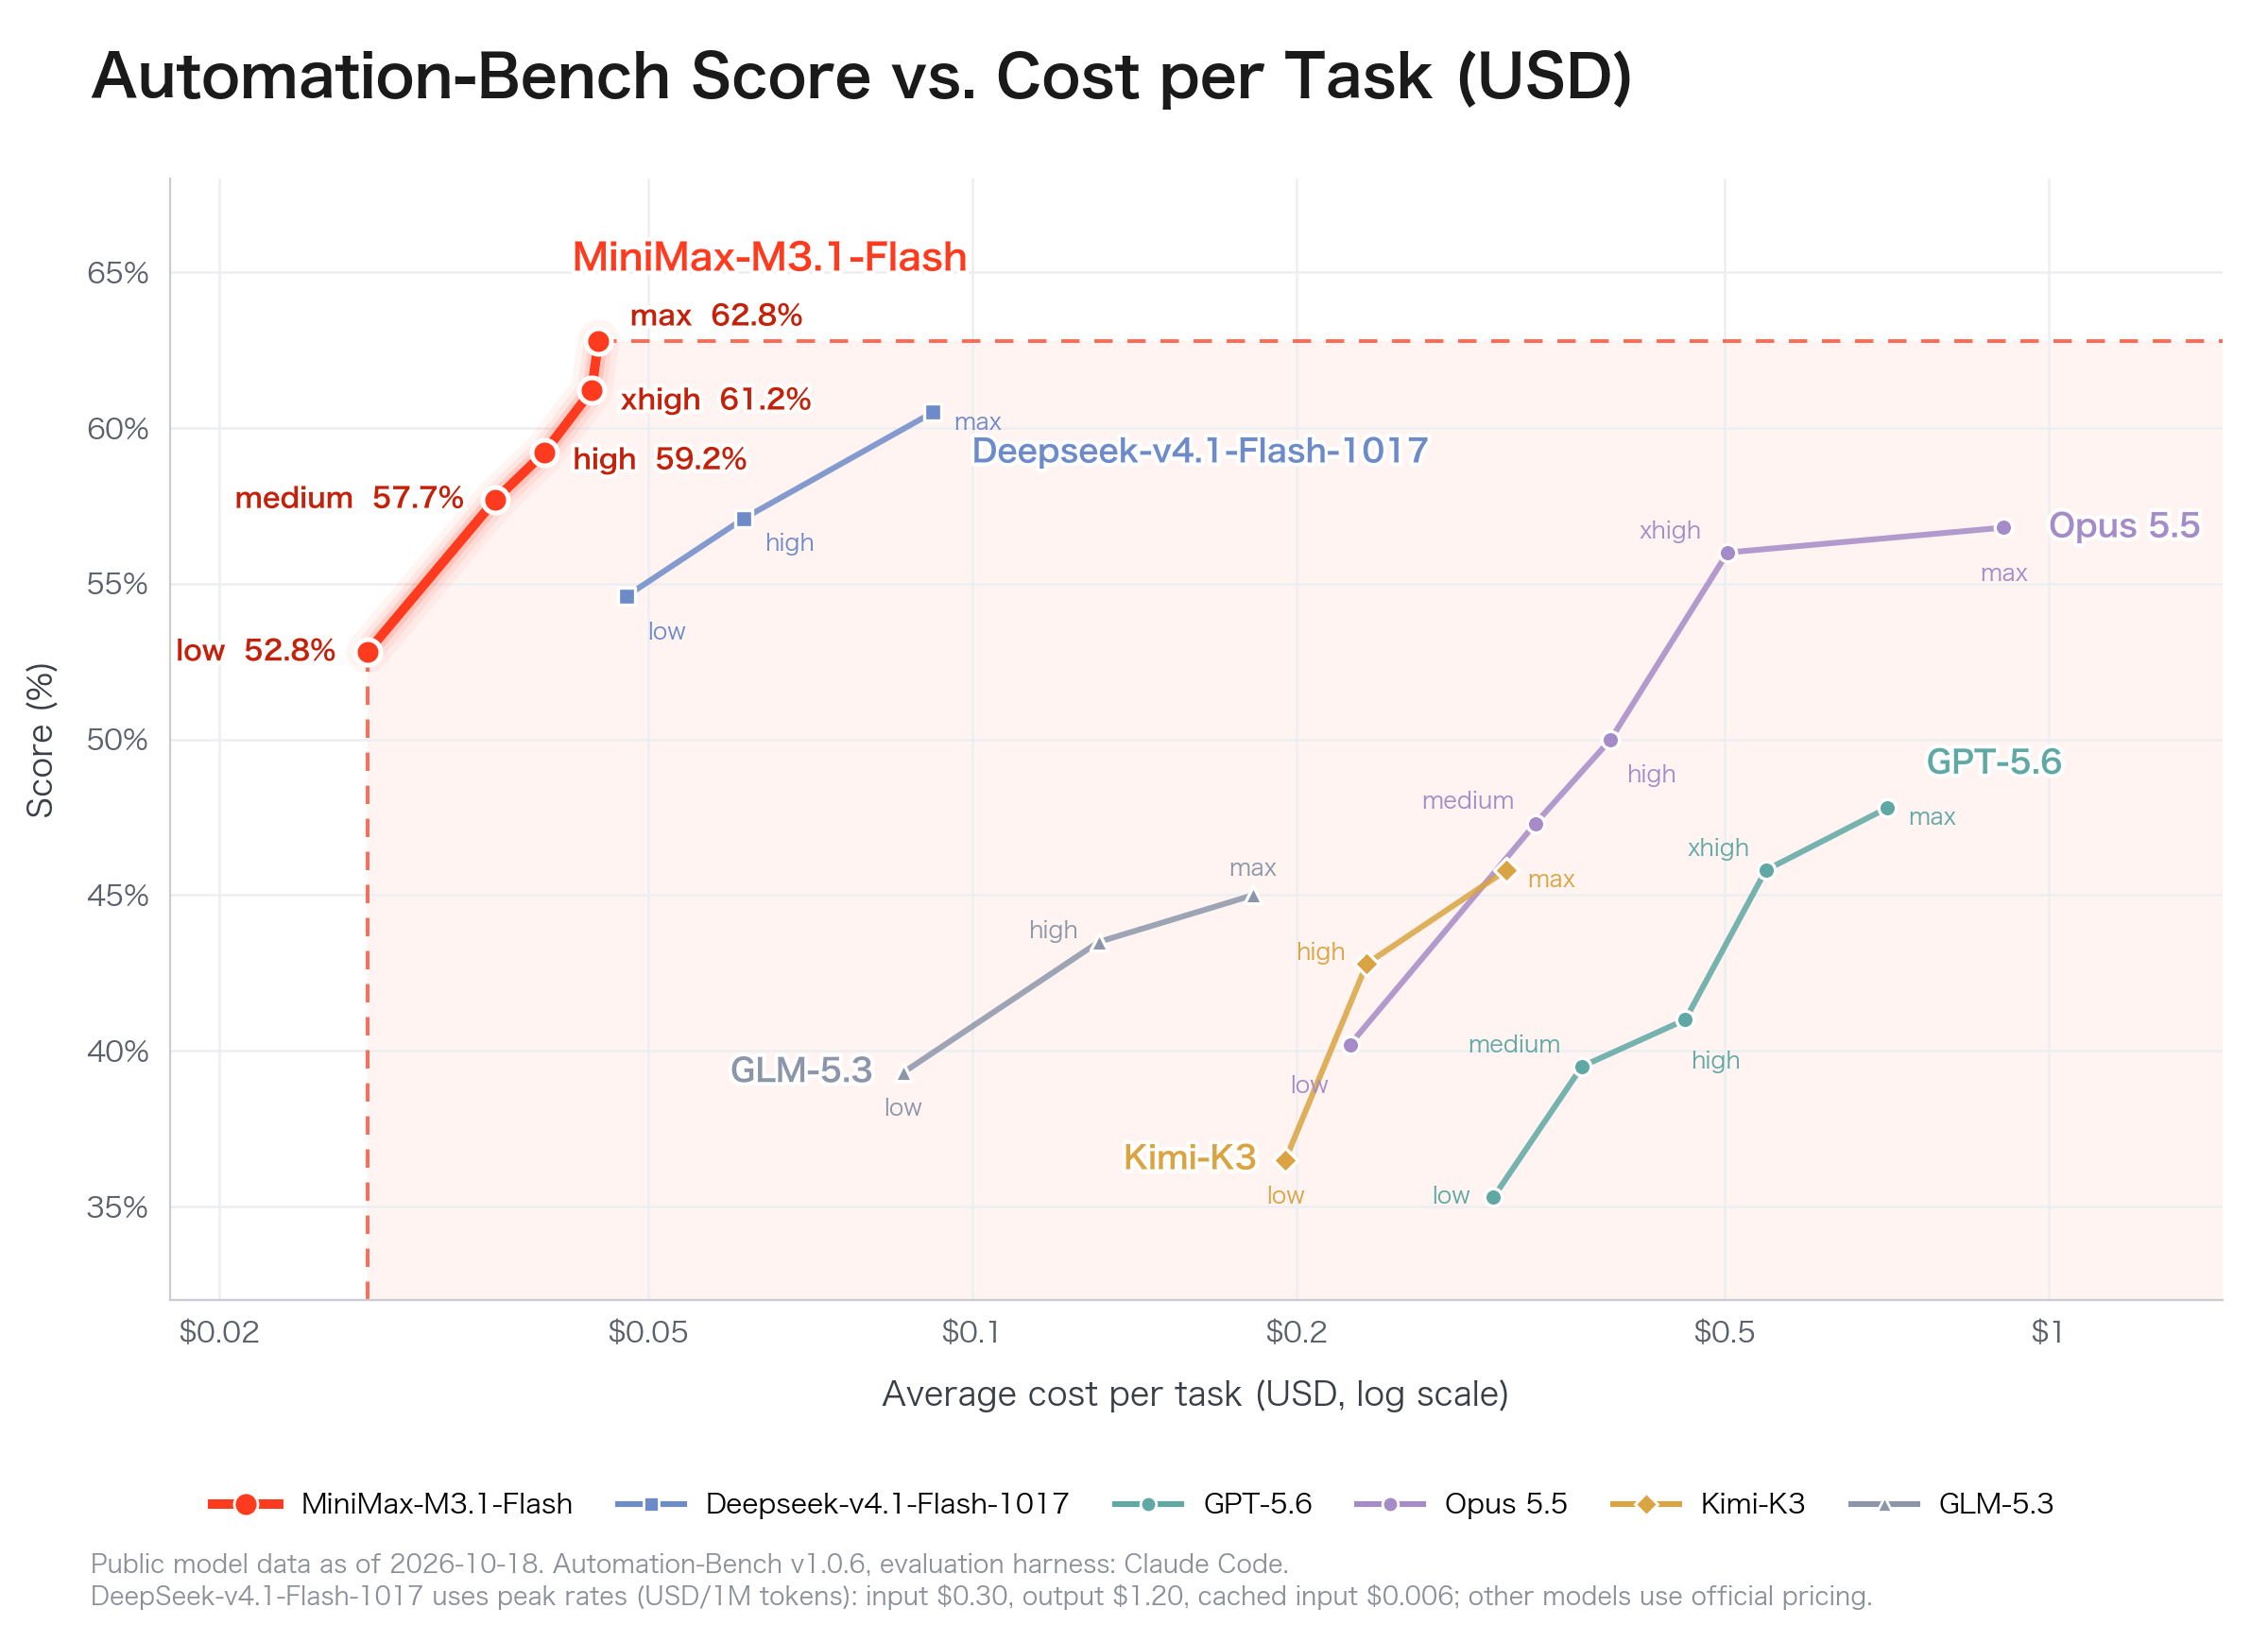
| Nakład rozumowania | Oznaczony wynik Automation-Bench |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
Obecna oficjalna tabela porównawcza i punkt maksymalnego wysiłku oba pokazują 62.8. Krzywa kosztu porównuje ustawienia wysiłku w konfiguracji dostawcy; nie ustala stałego kosztu dolarowego dla agenta produkcyjnego.
Etykietowany wynik rośnie o 10 punktów procentowych między low a max. Na potrzeby wdrożenia porównaj medium i wyższe wysiłki na stałym zestawie zadań, licząc nieudane próby i retry w całkowitych wydatkach. Wybierz ustawienie, które spełnia cel jakości przy najniższym zmierzonym koszcie per zaakceptowane zadanie.
Jak deweloperzy mogą uzyskać dostęp do MiniMax M3.1 Flash przez CometAPI?
Deweloperzy mogą uzyskać dostęp do MiniMax M3.1 Flash API w CometAPI. Publiczny katalog sprawdzony 20 października 2026 r. wyświetla identyfikator modelu minimax-m3.1-flash, mimo że jego URL zachowuje sufiks preview. Użyj identyfikatora modelu dostępnego na Twoim koncie, zamiast wyprowadzać identyfikator API z adresu URL strony.
Wyślij żądanie POST do https://api.cometapi.com/v1/chat/completions z nagłówkiem Authorization: Bearer YOUR_COMETAPI_KEY i Content-Type: application/json. W treści JSON ustaw model na minimax-m3.1-flash (jeśli włączony na Twoim koncie) i przekaż tablicę messages. Zobacz dokumentację CometAPI po szczegóły żądania.
Dlaczego używać CometAPI? Jego ujednolicony klucz API, kompatybilny format żądania i pulpit zużycia mogą uprościć pracę z wieloma dostawcami modeli. Dla MiniMax M3.1 Flash zestaw tę wygodę integracji z powyższymi cenami specyficznymi dla dostawcy i zweryfikuj funkcje dostępne na Twoim koncie.
Jakie agenty SI najbardziej skorzystają z MiniMax M3.1 Flash?
| Zastosowanie | Dlaczego może pasować | Uwagi wdrożeniowe |
|---|---|---|
| Automatyzacja korporacyjna | Mocne wyniki w Automation-Bench | Waliduj narzędzia i retry |
| Asystenci kodowania | Konkurencyjny wynik w DeepSWE | Uruchamiaj testy i przeglądaj łatki |
| Wsparcie klienta | Niskie ceny wejścia i cache | Monitoruj dokładność |
| Agenci badawczy | Okno kontekstu 1M | Sprawdzaj dowody i źródła |
| Agenci obsługi komputera | Zdolność w OSWorld | Radź sobie ze zmianami UI i odzyskiem |
| Przegląd bezpieczeństwa kodu | Wynik CyberGym | Niezależna weryfikacja |
Korzyści są najsilniejsze, gdy agent poprawnie ukończy wystarczająco wiele zadań, aby zrównoważyć koszty retry, orkiestracji i przeglądu. Produkcyjne użycie powinno mierzyć zarówno wydajność na poziomie modelu, jak i przepływu pracy.
Czy MiniMax M3.1 Flash to najlepsza wartość dla agentów SI?
MiniMax M3.1 Flash to mocna opcja dla wrażliwych kosztowo agentów obejmujących powtarzany kontekst i strukturyzowane narzędzia, ale najniższa cena tokena nie zawsze daje najniższy koszt per udane zadanie. Nieudane wywołania, dodatkowe retry i interwencja człowieka mogą zniweczyć oszczędności. Oceń współczynnik zaakceptowanych ukończeń, całkowity czas end-to-end, całkowity koszt per udane zadanie i wskaźnik interwencji człowieka.
FAQ
Dlaczego MiniMax M3.1 Flash może zwrócić pustą odpowiedź?
W natywnym, kompatybilnym z OpenAI API MiniMax tokeny myślenia zużywają budżet generowania. Zbyt mały limit może zakończyć żądanie z finish_reason ustawionym na length, zanim pojawi się widoczny tekst odpowiedzi. Sprawdź finish reason i zużycie tokenów, zwiększ budżet ukończenia, gdy to odpowiednie, i obsługuj reasoning_content oddzielnie od finalnej odpowiedzi. Potwierdź te same semantyki odpowiedzi na trasie zewnętrznego dostawcy.
Jak przechowywać historię wywołań narzędzi MiniMax M3.1 Flash?
Zachowaj pełną wiadomość asystenta, włącznie z wywołaniami narzędzi i treścią rozumowania, zanim dołączysz odpowiadające wyniki narzędzi. Zapisanie jedynie widocznej odpowiedzi może usunąć informacje potrzebne w następnym kroku. Utrzymuj identyfikatory wywołań narzędzi i kolejność wiadomości oraz zweryfikuj zachowanie odtwarzania, używając faktycznego endpointu dostawcy. Wytyczne MiniMax dotyczące historii konwersacji opisują wymagania natywnego API.
Jak zespoły mogą wykrywać zmiany trasowania MiniMax M3.1 Flash?
Utrzymuj mały zestaw regresyjny ze stałymi wejściami, oczekiwaną strukturą wyjścia i asercjami wywołań narzędzi. Rejestruj żądany model ID, zwrócony identyfikator modelu (gdy obecny), dostawcę, znacznik czasu i rozliczone zużycie. Uruchamiaj ponownie po aktualizacjach dostawców; stabilny alias sam w sobie nie dowodzi, że podstawowy checkpoint lub zachowanie nie uległy zmianie.
Jak etapować migrację do MiniMax M3.1 Flash?
Zacznij od zadań tylko do odczytu lub odtwarzanych, następnie przekieruj niewielką część ruchu produkcyjnego, zachowując przetestowany fallback. Zdefiniuj progi rollback dla nieprawidłowych wywołań narzędzi, timeoutów i nieudanych zadań przed zwiększeniem ruchu. Przeglądaj przykłady regresji, zamiast polegać tylko na średnich wynikach, ponieważ niewielka liczba kosztownych błędów może przeważyć niższe ceny tokenów.
Wnioski
MiniMax M3.1 Flash poprawia ekonomię autonomicznych agentów SI dzięki niedrogim tokenom, konfigurowalnemu rozumowaniu, dużemu oknu kontekstu i mocnym raportowanym wynikom w automatyzacji i kodowaniu. Jego kluczową przewagą jest równowaga między wydajnością, opóźnieniami i kosztem zadania – a nie absolutna przewaga w każdym benchmarku.
Deweloperzy powinni zweryfikować realne współczynniki ukończeń przepływów pracy i całkowite koszty agentów, a następnie wybrać trasę MiniMax M3.1 Flash, której aktywna konfiguracja, wspierane funkcje i rozliczenia odpowiadają ich wymaganiom.