
TLDR MiniMax M4 nie został wydany. MiniMax publicznie zobowiązał się do nowej generacji swoich modeli z serii M (oraz wideo Hailuo) w drugiej połowie 2026 roku. Obecnym flagowcem pozostaje MiniMax M3 (premiera 1 czerwca 2026: ~428B łącznie / ~23B aktywnych parametrów, kontekst 1M tokenów dzięki MiniMax Sparse Attention, natywna multimodalność, otwarte wagi, 59.0% na SWE-Bench Pro).
Śródocykliczne odświeżenie efektywności, Minimax M3.1 Flash, zadebiutowało 19 października 2026, zapewniając około 3× szybszą inferencję i ~70% niższe koszty agentowe. Deweloperzy mogą już dziś uzyskać dostęp do aktualnej linii MiniMax (w tym M3 i M3.1 Flash) poprzez ujednolicone bramy, takie jak CometAPI, dla uproszczonego routingu, monitoringu i kontroli kosztów.
Kluczowe wnioski
- MiniMax M4 nie jest wydany na dzień 20 października 2026. Firma jedynie zobowiązała się do „nowej generacji modeli z serii M i Hailuo w drugiej połowie 2026 roku”.
- Obecne modele produkcyjne: MiniMax M3 (1 czerwca 2026) oraz ukierunkowany na efektywność M3.1 Flash (19 października 2026).
- M3 wprowadził MSA (MiniMax Sparse Attention), umożliwiając praktyczny kontekst 1M tokenów, natywne rozumienie obrazu/wideo, mocne wyniki w kodowaniu/pracy agentów oraz otwarte wagi.
- M3.1 Flash priorytetyzuje szybkość i koszt (deklarowane ~3× przyspieszenie inferencji i 70% niższe koszty agentowe), zachowując 1M kontekstu i wejścia multimodalne; otwarte wagi spodziewane wkrótce po premierze.
- Raport z lipca 2026 opisał wewnętrzne przedsięwzięcie ~2,7 biliona parametrów (wewnętrznie nazywane M3 Pro) z możliwym wydaniem otwartych wag już w III kwartale 2026; nie zostało to publicznie zmaterializowane i jest odrębne od szerszego zobowiązania „nowej generacji”.
- Oczekiwane ulepszenia M4 (spekulacyjne, na podstawie dotychczasowej trajektorii): dalsze wzrosty w kodowaniu/pracy agentów, dopracowana efektywność długiego kontekstu, silniejsze możliwości multimodalne lub obsługa komputera oraz kontynuacja agresywnej polityki cenowej.
- Rekomendacja dostępu: używaj bramy multi-dostawcy, takiej jak CometAPI, aby kierować ruch przez MiniMax M3/M3.1 Flash (i przyszły M4) obok innych modeli czołowych z ujednoliconym rozliczaniem, obserwowalnością i logiką awaryjnego przełączania.
Czy MiniMax M4 naprawdę wkrótce nadejdzie?
Potwierdzone informacje
Główne pytanie nie brzmi, czy MiniMax rozwija przyszłe systemy AI, lecz czy istnieją konkretne dowody, że model o nazwie MiniMax M4 zbliża się do wydania.
MiniMax wydał M3 w czerwcu 2026 i oficjalnie uruchomił M3.1 Flash 19 października 2026. To potwierdzone wydanie pośrednie, nie dowód na harmonogram M4. Oficjalne ogłoszenie premiery.
Oficjalne archiwum badawcze obejmuje teraz M3.1 Flash. Nie znaleziono ogłoszenia premiery M4 w oficjalnych źródłach przeglądanych 20 października 2026.
| Kategoria dowodów | Ustalenie | Ocena |
|---|---|---|
| Oficjalne ogłoszenie M4 | Niezweryfikowane | Niepotwierdzone |
| Publiczny identyfikator modelu M4 | Niezweryfikowane | Niepotwierdzone |
| Wycieki zrzutów benchmarków M4 | Nie znaleziono niezależnie zweryfikowanych dowodów | Niepotwierdzone |
| Endpoint API M4 | Niezweryfikowane | Niepotwierdzone |
| Cennik M4 | Nieopublikowany | Nieznane |
| Wagi modelu M4 | Niezweryfikowane | Nieznane |
| Premiera MiniMax M3 | 1 czerwca 2026 | Potwierdzone |
| Wydanie M3.1 Flash | Wydano 19 października 2026; dostępny przez MiniMax API, M Plan i MiniMax Code | Potwierdzone |
Relacje społeczności / wycieki
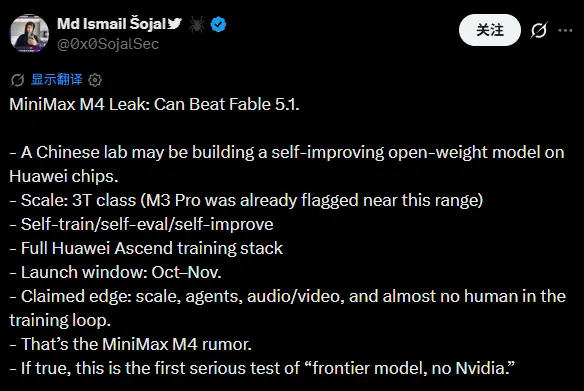
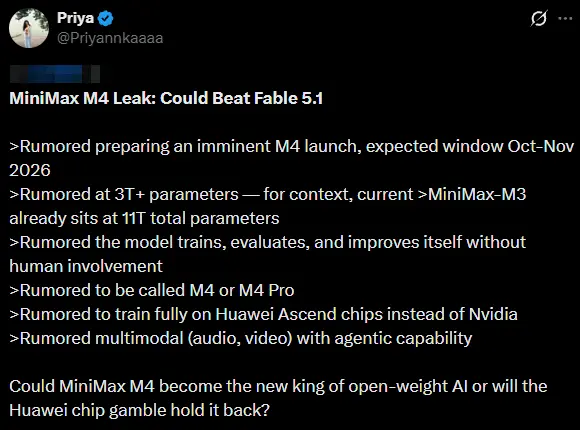
Dwa posty na X datowane na 27 września 2026 omawiają możliwe wydanie M4. Ustanawiają one, że te twierdzenia krążyły w społeczności, a nie że MiniMax je potwierdził. Oba traktowane są tutaj jako niezweryfikowane doniesienia społeczności; płatna weryfikacja autorów nie stanowi potwierdzenia wiarygodności twierdzeń.
W poście @0x0SojalSec autor sugeruje model o około trzech bilionach parametrów, wydanie otwartych wag oraz trening na sprzęcie Huawei Ascend. Czytelny fragment opisuje też pętlę, w której model uczestniczy w swoim własnym treningu i ewaluacji. To są twierdzenia autora posta, nie zweryfikowane specyfikacje M4.
Post Priyi (@Priyannkaaaa) sugeruje możliwe wydanie w październiku-listopadzie 2026 i liczbę parametrów przekraczającą trzy biliony. Zawiera też niezweryfikowane twierdzenie o wielkości poprzedniego modelu M3. To porównanie nie zostało przyjęte jako faktyczna baza w tym artykule.
Kiedy może zostać wydany MiniMax M4?
Wcześniejsze modele pozostają użytecznymi punktami odniesienia, w tym MiniMax M2.5 API w CometAPI. Ich daty ustanawiają historię, a nie prognozę kolejnego wydania.
MiniMax nie potwierdził daty premiery M4. Okno październik-listopad 2026 wspomniane w poście Priyi to plotka, nie oficjalny harmonogram; przytoczony fragment i jego ograniczenia omówiono w sekcji Relacje społeczności / wycieki. Historia wydawnicza rodziny modeli pokazuje zarówno główne generacje, jak i wersje pośrednie, ale przeszłe interwały premier nie pozwalają wiarygodnie przewidzieć następnego wydania.
| Kamień milowy | Oficjalny harmonogram wydania | Znaczenie |
|---|---|---|
| MiniMax M2.5 | 12 lutego 2026 | Kodowanie i produktywność |
| MiniMax M2.7 | 18 marca 2026 | Usprawnienia przepływów agentowych |
| MiniMax M3 | 1 czerwca 2026 | Kontekst 1M i multimodalność |
| M3.1 Flash | 19 października 2026 — oficjalne wydanie | Wydany model ukierunkowany na efektywność kodowania i agentów |
| MiniMax M4 | Nieogłoszony | Brak zweryfikowanego harmonogramu |
Formalne ogłoszenie produktu MiniMax byłoby najsilniejszym sygnałem. Dokumentacja API lub uwierzytelniony identyfikator modelu dostarczyłyby dodatkowych dowodów. Wyniki benchmarków i publiczne karty modelu umożliwiłyby ocenę ulepszeń technicznych, podczas gdy oficjalne ceny i limity stawek determinowałyby przydatność produkcyjną.
Cena MiniMax M4 — co sugerują wycieki i poprzednie generacje
Nie ma oficjalnych cen dla M4. Wszystkie poniższe liczby to ekstrapolacje oparte na aktualnych cennikach M3 i M3.1 Flash (USD, na milion tokenów, przybliżone na połowę października 2026):
| Model | Wejście / 1M | Wyjście / 1M | Buforowane wejście | Kontekst | Uwagi |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | „Stałe 50% rabatu” w cenniku; wyższy poziom dla >512k kontekstu |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% taniej niż M3; zoptymalizowany pod przepustowość agentów |
| Oczekiwany zakres M4 (spek.) | $0.20–$0.40 | $0.80–$1.50 | Podobna struktura zniżek | 1M+ | Prawdopodobnie pozostanie jednym z najtańszych czołowych modeli o otwartych wagach |
Źródła aktualnych cen: dokumentacja platformy MiniMax, niezależne agregatory i ogłoszenia premier.
MiniMax wielokrotnie pozycjonował swoje modele na ułamek kosztów wiodących zamkniętych modeli zachodnich, jednocześnie dorównując im lub przewyższając je na wybranych benchmarkach kodowania i pracy agentów. Pełny M4 prawdopodobnie kontynuowałby tę strategię, z możliwymi poziomami premium dla rozszerzonego kontekstu, priorytetowych opóźnień lub większego wysiłku rozumowania.
Rekomendacja CometAPI: zamiast bezpośrednio zarządzać wieloma kluczami API MiniMax i cennikami, kieruj ruch przez ujednoliconą bramę, taką jak CometAPI. Umożliwia to płynne przełączanie między M3, M3.1 Flash i (gdy będą dostępne) M4, automatyczne fallbacki, analitykę użycia i często lepszą efektywną cenę dzięki agregacji wolumenu — szczególnie cenne dla obciążeń agentowych spalających duże liczby tokenów.
Co MiniMax M3.1 Flash mówi o następnej generacji
MiniMax M3.1 Flash provides stanowi bardziej aktualny punkt odniesienia do oceny tego, co mógłby dostarczyć przyszły model MiniMax M4. Oficjalnie wprowadzony 19 października 2026, M3.1 Flash koncentruje się na przepływach agentowych, rozwoju oprogramowania, obsłudze komputera i cyberbezpieczeństwie, kładąc nacisk na szybszą inferencję i niższe koszty użytkowania. Te ulepszenia dostarczają użytecznych wskazówek na temat obecnych priorytetów inżynieryjnych MiniMax, choć nie ustanawiają daty wydania M4 ani nie potwierdzają jego przyszłych specyfikacji.
1. Niezawodność agentów staje się równie ważna jak surowa inteligencja
Jednym z najjaśniejszych motywów ogłoszenia M3.1 Flash jest nacisk na kończenie złożonych, wieloetapowych zadań. MiniMax raportuje ulepszenia w przepływach agentowych, kodowaniu, obsłudze komputera i automatyzacji przedsiębiorstw.
Ten kierunek sugeruje, że następna generacja modeli może być oceniana mniej przez izolowaną wydajność w pytaniach-odpowiedziach, a bardziej przez zdolność do niezawodnego ukończenia całych przepływów pracy.
Na przykład agent inżynierii oprogramowania może potrzebować przejrzeć repozytorium, zidentyfikować defekt, zmodyfikować kilka plików, uruchomić testy, zdiagnozować błędy i zweryfikować finalną poprawkę. Sukces zależy nie tylko od jakości rozumowania, ale także od doboru narzędzi, śledzenia stanu, odzyskiwania po błędach i spójności na wielu etapach.
Przyszły model M4 mógłby rozwinąć ten kierunek, poprawiając planowanie długohoryzontowe, redukując zbędne wywołania narzędzi i skuteczniej odzyskując po nieudanych działaniach. To rozsądne cele ewaluacyjne, a nie potwierdzone funkcje M4.
2. Efektywność inferencji może stać się kluczową przewagą konkurencyjną
MiniMax informuje, że M3.1 Flash zapewnia niemal trzykrotnie większą prędkość inferencji online niż poprzednik i redukuje całkowite koszty użycia o 70% dla zadań agentowych. Firma przypisuje te ulepszenia bardziej agresywnej rzadkości (sparsity).
Te twierdzenia podkreślają ważne rozróżnienie między inteligencją modelu a praktyczną efektywnością operacyjną. Model, który kończy zadanie z mniejszą liczbą ponowień, niższą latencją i mniejszą konsumpcją tokenów, może być bardziej wartościowy niż model osiągający nieco wyższy wynik benchmarku, ale wymagający znacznie więcej zasobów.
Dla potencjalnego wydania M4 istotne pytania obejmą, czy potrafi utrzymać wysoką przepustowość przy długotrwałych zadaniach, zachować jakość wyjścia przy ciaśniejszych budżetach inferencji i obniżyć całkowity koszt pomyślnego ukończenia zadania.
Raportowane ulepszenia M3.1 Flash to deklaracje firmy i powinny być niezależnie oceniane w porównywalnych obciążeniach, zanim zostaną uznane za ogólne gwarancje wydajności.
3. Kodowanie i obsługa komputera to obszary warte obserwacji
Ogłoszenie M3.1 Flash raportuje wynik 73.7% na DeepSWE v1.1, 61.7 na OSWorld V2 i 82% na CyberGym. Te rezultaty obejmują różne aspekty inżynierii oprogramowania, interakcji z komputerem i cyberbezpieczeństwa.
Razem stanowią bardziej użyteczny punkt wyjścia do oceny przyszłych modeli niż pojedynczy benchmark ogólnego przeznaczenia.
Jeśli MiniMax wprowadzi M4, deweloperzy powinni szukać dowodów, że poprawia on praktyczne ukończenie zadań, a nie tylko generuje wyższy wynik nagłówkowy. Użyteczne testy mogą obejmować naprawy błędów na poziomie repozytorium, przepływy cross-aplikacyjne, automatyzację przeglądarki, analizę podatności i odzyskiwanie po nieudanych wywołaniach narzędzi.
Porównania benchmarków powinny zachować wersję zbioru danych, środowisko wykonania, szkielet agenta, limity zasobów i metodologię oceny. Bez porównywalnych warunków różnice między wynikami modeli mogą nie odzwierciedlać rzeczywistych ulepszeń zdolności.
4. Długi kontekst i rozumowanie multimodalne nadal wymagają praktycznej ewaluacji
MiniMax M3 już wspiera okno kontekstu do miliona tokenów oraz natywne wejścia multimodalne, w tym obrazy i wideo. Wydanie M3.1 Flash zachowuje okno kontekstu miliona tokenów i łączy rozumienie multimodalne ze wzmocnionymi możliwościami zorientowanymi na agentów.
To oznacza, że samo większe okno kontekstu nie byłoby koniecznie przekonującym powodem do aktualizacji do M4.
Bardziej znaczące postępy mogłyby obejmować lepsze wyszukiwanie (retrieval) w dużych repozytoriach, większą spójność na długich dokumentach, bardziej dokładną interpretację dowodów wizualnych oraz bardziej niezawodną koordynację między percepcją a wykonywaniem narzędzi.
Na przykład agent deweloperski może potrzebować przejrzeć nagranie ekranu, zidentyfikować błąd interfejsu użytkownika, prześledzić odpowiedni kod aplikacji, wdrożyć poprawkę i zweryfikować wynik. Liczy się jakość kompletnego przepływu, a nie zdolność modelu do przetwarzania dużego wejścia w izolacji.
Te scenariusze reprezentują możliwe priorytety ewaluacyjne dla M4, nie możliwości ogłoszone przez MiniMax.
5. Przyszłe wydania modeli mogą być oceniane według kosztu na ukończone zadanie
Ogłoszenie M3.1 Flash wzmacnia znaczenie oceny ekonomii modelu na poziomie przepływu pracy. Ceny tokenów nie oddają pełnego kosztu użycia agenta.
Bardziej użyteczne porównanie uwzględnia prawdopodobieństwo pomyślnego ukończenia zadania, liczbę wymaganych prób, konsumpcję tokenów, koszty narzędzi, latencję i interwencje człowieka.
Deweloperzy przygotowujący się na przyszłe wydanie M4 powinni ustanowić bazę z obecnie dostępnych modeli i użyć tego samego zbioru zadań do porównania kolejnych wydań. Umożliwia to określenie, czy nowy model przynosi znaczące ulepszenia produktywności, a nie tylko zmienia rankingi benchmarków.
Jak silne są benchmarki MiniMax M3 i co M4 musiałby pobić?
MiniMax opublikował znaczący zestaw wyników benchmarków dla M3, zapewniając mierzalne cele dla przyszłego modelu. Poniższe wartości to raportowane wyniki M3, nie przewidywania M4.
| Benchmark | Raportowany wynik MiniMax M3 | Co ocenia | Cel weryfikacji dla M4 |
|---|---|---|---|
| SWE-Bench Pro | 59.0% | Realna inżynieria oprogramowania | Wyższa zweryfikowana rozwiązalność zadań |
| Terminal-Bench 2.1 | 66.0% | Wykonanie agenta w terminalu | Więcej udanych operacji end-to-end |
| SWE-fficiency | 34.8% | Efektywność zadań kodowania | Lepsza wydajność przy porównywalnych budżetach |
| KernelBench Hard | 28.8% | Optymalizacja jąder GPU | Więcej poprawnych i szybszych jąder |
| MCP Atlas | 74.2% | Zadania narzędziowe i MCP | Lepszy dobór i wykonanie narzędzi |
To wyniki raportowane przez dostawcę z ogłoszenia 1 czerwca 2026, nie niezależne replikacje. Zestawy mierzą różne rezultaty, więc ich procenty nie powinny być uśredniane do jednego wyniku dokładności.
Wydajność w kodowaniu i inżynierii oprogramowania
Co mamy potwierdzone (M3)
- SWE-Bench Pro: 59.0%
- Terminal-Bench 2.1: 66.0%
- Silne wyniki w realnych zadaniach naprawy błędów, rozwoju frontend/backend i optymalizacji jąder (wewnętrzne ewaluacje MiniMax wykazały wielogodzinną autonomiczną iterację).
Co dodaje M3.1 Flash: Deklaracje dalszych wzrostów na benchmarkach kodowania, agentowych i cyberbezpieczeństwa, plus dramatycznie wyższe tokenów-na-sekundę i niższy koszt na ukończoną trajektorię agenta.
Co pozostaje niepotwierdzone / oczekiwane dla M4: Wyższe bezwzględne wyniki na benchmarkach w stylu SWE-Bench i wieloturach interaktywnego kodowania, lepsze zarządzanie projektami długohoryzontowymi oraz poprawa zdolności utrzymania spójności w sesjach obejmujących wiele plików i wiele dni. Każdy model w skali 2.7T (jeśli wydany) można by oczekiwać, że podniesie sufit zdolności, choć liczba aktywnych parametrów i rzadkość (sparsity) zadecydują o realnym koszcie.
Efektywność długiego kontekstu i architektura
Potwierdzone: M3 wprowadził MSA (MiniMax Sparse Attention), zapewniając praktyczny kontekst 1M tokenów przy deklarowanych 1/20 kosztu obliczeniowego per token w porównaniu z poprzednią generacją gęstej uwagi, >9× przyspieszenie prefillingu i >15× dekodowania przy ekstremalnych długościach, przy zachowaniu zgodności z pełną uwagą w większości możliwości.
Oczekiwane ulepszenia: Udoskonalenia wzorców rzadkości, lepsze wsparcie dla jeszcze dłuższych kontekstów lub gęstszych retrieviali w oknie, niższy ślad pamięciowy dla self-hostingu oraz poprawione obchodzenie się z przeplatanymi długimi dokumentami multimodalnymi.
Zdolności multimodalne i obsługa komputera
Potwierdzone: Natywne rozumienie obrazów i wideo od pierwszych etapów treningu, plus wykazana obsługa komputera (operacje na desktopie) w MiniMax Code i harnessach agentów.
Oczekiwane dla M4: Ściślejsza integracja rozumienia wideo z planowaniem agenta, silniejsze pipeline’y dokument/zrzut ekranu -> kod oraz bardziej niezawodna kontrola wielu aplikacji na dłuższych horyzontach.
Przepływy agentowe, użycie narzędzi i samodoskonalenie
Potwierdzone: M2.7 już eksperymentował z rekurencyjnymi pętlami samodoskonalenia. M3 i M3.1 Flash kładą nacisk na współpracę multiagentową, dynamiczne wyszukiwanie narzędzi, długotrwałe zadania autonomiczne oraz pętle producent-weryfikator w MiniMax Code.
Oczekiwane: Bardziej odporne wielodniowe zespoły agentów, lepsze odzyskiwanie po porażkach narzędzi, natywne wsparcie dla większych ekosystemów narzędzi oraz ewentualnie kontynuacja technik samodoskonalenia lub poszukiwania ewolucyjnego na większą skalę.
Cena MiniMax M4 — co sugerują wycieki i poprzednie generacje
Nie ma oficjalnych cen dla M4. Wszystkie poniższe liczby to ekstrapolacje oparte na aktualnych cennikach M3 i M3.1 Flash (USD, na milion tokenów, przybliżone na połowę października 2026):
| Model | Wejście / 1M | Wyjście / 1M | Buforowane wejście | Kontekst | Uwagi |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | „Stałe 50% rabatu” w cenniku; wyższy poziom dla >512k kontekstu |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% taniej niż M3; zoptymalizowany pod przepustowość agentów |
| Oczekiwany zakres M4 (spek.) | $0.20–$0.40 | $0.80–$1.50 | Podobna struktura zniżek | 1M+ | Prawdopodobnie pozostanie jednym z najtańszych czołowych modeli o otwartych wagach |
MiniMax wielokrotnie pozycjonował swoje modele na ułamek kosztów wiodących zamkniętych modeli zachodnich, jednocześnie dorównując im lub przewyższając je na wybranych benchmarkach kodowania i pracy agentów. Pełny M4 prawdopodobnie kontynuowałby tę strategię, z możliwymi poziomami premium dla rozszerzonego kontekstu, priorytetowych opóźnień lub większego wysiłku rozumowania.
Rekomendacja CometAPI: zamiast bezpośrednio zarządzać wieloma kluczami API MiniMax i cennikami, kieruj ruch przez ujednoliconą bramę, taką jak CometAPI. Umożliwia to płynne przełączanie między M3, M3.1 Flash i (gdy będą dostępne) M4, automatyczne fallbacki, analitykę użycia i często lepszą efektywną cenę dzięki agregacji wolumenu — szczególnie cenne dla obciążeń agentowych spalających duże liczby tokenów.
MiniMax M3 vs M3.1 Flash vs oczekiwany kierunek M4
| Wymiar | M3 API w CometAPI (cze 2026) | MiniMax M3.1 Flash (paź 2026) | Oczekiwany kierunek M4 (H2 2026+) |
|---|---|---|---|
| Status | Działa, otwarte wagi | Działa, wagi wkrótce | Niewydany |
| Parametry (przybl.) | 428B łącznie / ~23B aktywnych | Podobna skala | Nieznane (możliwy większy MoE) |
| Kontekst | 1M tokenów (MSA) | 1M tokenów | 1M+ z dalszą poprawą efektywności |
| Kodowanie (SWE-Bench Pro) | 59.0% | Deklarowane dalsze wzrosty | Oczekiwane wyższe wyniki bezwzględne |
| Prędkość inferencji | Silna baza | ~3× szybciej (deklarowane) | Dalsza optymalizacja |
| Koszt agentowy | Konkurencyjny | ~70% niżej (deklarowane) | Kontynuacja agresywnego cenowania |
| Multimodalność | Natywne obrazy + wideo | To samo + dopracowane | Głębsza integracja |
| Otwarte wagi | Tak | Planowane wkrótce | Wysoce prawdopodobne |
| Cena API (wej/wyj) | $0.30 / $1.20 | $0.15 / $0.60 | Oczekiwany zakres $0.20–0.40 / $0.80–1.50 |
Dobór modelu wg przepływu pracy dewelopera
Użyj wydanego M3.1 Flash jako bieżącego kandydata do ewaluacji i zachowaj M3 oraz każdy ugruntowany przepływ M2.7 do porównań. Mierz zaakceptowane ukończenie zadań, ponowienia, interwencje człowieka i całkowity koszt w tym samym obciążeniu. Reguluj wysiłek świadomie zamiast zakładać, że maksymalne „myślenie” zawsze jest najlepszym punktem pracy.
M4 nie jest jeszcze działającym wyborem produkcyjnym. Najbardziej użyteczne przygotowanie to zbudowanie powtarzalnego zestawu benchmarków na istniejących modelach, aby przyszłe wydanie można było szybko ocenić.
Jak uzyskać dostęp do obecnych modeli MiniMax (i przygotować się na M4)
Czekając na M4, praktyczna ścieżka to użycie działających modeli:
- Uzyskaj klucz API MiniMax z oficjalnej platformy.
- Albo, dla niezawodności produkcyjnej, kieruj przez bramę multi-modelową taką jak CometAPI. CometAPI zapewnia pojedynczy endpoint i klucz, które mogą kierować na MiniMax M3, M3.1 Flash i innych dostawców, z wbudowanymi dashboardami użycia, obsługą limitów i możliwością przełączania modeli bez zmian w kodzie.
- Dla agentów kodujących sparuj model z MiniMax Code (desktop/CLI) lub otwartymi frameworkami, które już wspierają kompatybilne z Anthropic lub OpenAI endpointy MiniMax.
- Monitoruj oficjalne kanały MiniMax i katalogi agregatorów; w momencie pojawienia się nowego identyfikatora modelu serii M bramy takie jak CometAPI zazwyczaj szybko go eksponują.
To podejście minimalizuje uzależnienie i pozwala zespołom oceniać M3 vs M3.1 Flash (a docelowo M4) na realnych obciążeniach z konsekwentną obserwowalnością.
Wnioski
MiniMax M4 pozostaje przyszłym modelem zdefiniowanym przez jasne, lecz ogólne zobowiązanie firmy, a nie konkretne specyfikacje. Generacja M3 już ustanowiła MiniMax jako poważnego gracza z otwartymi wagami w kodowaniu, agentach i multimodalnej pracy z długim kontekstem; M3.1 Flash następnie przesunął granicę efektywności. Niezależnie od tego, jaką formę ostatecznie przyjmie „nowa generacja” w H2 2026 — czy to pod nazwą M3.5, M4, czy inną — odziedziczy solidne fundamenty rzadkiej uwagi, otwartych wag i agresyjnego cenowania.
Dla deweloperów i zespołów budujących produkcyjnych agentów dziś, rekomendacja jest prosta: zintegrować działające modele MiniMax (M3 i M3.1 Flash) przez elastyczną warstwę multi-dostawcy, taką jak CometAPI. Daje to natychmiastowe korzyści w możliwościach i kosztach oraz pozycjonuje Was do przyjęcia M4 w momencie, gdy pojawi się na publicznych endpointach — przy minimalnych zmianach w kodzie i pełnej widoczności wydajności i wydatków.