Specyfikacja techniczna Qwen3.8-Flash
| Specyfikacja | Qwen3.8-Flash |
|---|---|
| Dostawca | Alibaba / Qwen |
| Rodzina modeli | Qwen3.8 |
| ID modelu | qwen3.8-flash |
| Typ modelu | Wielomodalny model wnioskowania |
| Tryby wejścia | Tekst, obraz, wideo |
| Modalność wyjściowa | Tekst |
| Okno kontekstu | 1,000,000 tokens |
| Maksymalne wyjście | 128,000 tokens |
| Maksymalny budżet myślenia | 262,144 tokens |
| Tryb myślenia | Obsługiwany |
| Wywoływanie funkcji | Obsługiwane |
| Wbudowane narzędzia | Obsługiwane |
Aktualna dokumentacja API Qwen wymienia qwen3.8-flash jako produkcyjny model Qwen3.8 z oknem kontekstu 1M tokenów i maksymalnym wyjściem 128K. Obsługuje wejścia tekstowe, obrazowe i wideo, wywoływanie funkcji, wbudowane narzędzia oraz ustrukturyzowane wyjście.
W przypadku zadań wizualnych, udokumentowane limity obejmują do 16 megapikseli na obraz, do 2,048 adresów URL obrazów lub 250 obrazów Base64 oraz do 64 wideo o długości do dwóch godzin.
Czym jest Qwen3.8-Flash?
Qwen3.8-Flash to efektywny kosztowo, wielomodalny model wnioskowania od Alibaba z rodziny Qwen3.8, zaprojektowany do programowania, agentowych przepływów pracy, analizy długiego kontekstu i rozumienia wizualnego. Zapewnia tę samą klasę 1M-tokenowego kontekstu co Qwen3.8-Max, celując w istotnie niższy koszt API. Własne wytyczne Qwen dla deweloperów wprost rekomendują Qwen3.8-Flash, gdy potrzebne są podobne możliwości za niższą cenę, podczas gdy Qwen3.8-Max jest pozycjonowany jako mocniejsza opcja wnioskowania.
Model jest szczególnie interesujący, ponieważ „Flash” nie oznacza po prostu małego modelu. Produkcyjny model API łączy długokontekstowe wnioskowanie, wejście wielomodalne, użycie narzędzi i ustrukturyzowane wyjście w relatywnie niedrogim endpointcie.
Jakie są główne funkcje Qwen3.8-Flash?
- Kontekst 1M tokenów: Qwen3.8-Flash może przetwarzać niezwykle długie dokumenty i bazy kodu, co czyni go odpowiednim do analizy repozytoriów i długotrwałych sesji agentów.
- Zrozumienie wielomodalne: API akceptuje tekst, obrazy i wideo, pozwalając deweloperom łączyć kod, zrzuty ekranu, wykresy, dokumenty i wideo w jednym przepływie pracy.
- Tryb myślenia: Model obsługuje tryb myślenia Qwen, z udokumentowanym maksymalnym budżetem myślenia 262,144 tokenów.
- Obsługa agentów i narzędzi: Obsługiwane są wywoływanie funkcji i wbudowane narzędzia, w tym możliwości takie jak wyszukiwanie w sieci, wykonywanie kodu oraz powiązane narzędzia hostowane przez Qwen.
- Ustrukturyzowane wyjście: Deweloperzy mogą żądać ustrukturyzowanych odpowiedzi, co ułatwia integrację modelu w aplikacjach wymagających JSON lub wyników ograniczonych schematem.
- Rozumienie długich materiałów wideo: Dokumentacja wizualnego API wymienia wejścia wideo do dwóch godzin, co sprawia, że Qwen3.8-Flash nadaje się do analizy wideo, a nie tylko krótkich zadań opisywania obrazów.
Jakie są najlepsze przypadki użycia Qwen3.8-Flash?
Programowanie i inżynieria oprogramowania
Okno kontekstu 1M tokenów jest przydatne dla dużych repozytoriów, długich sesji debugowania i analizy kodu w wielu plikach. Obsługa wywoływania funkcji i wnioskowania sprawia, że model nadaje się także do agentów programistycznych, a nie tylko do uzupełniania kodu.
Przepływy pracy agentowe
Qwen3.8-Flash obsługuje wywoływanie funkcji i wbudowane narzędzia, pozwalając aplikacji umożliwić modelowi pobieranie informacji, wykonywanie kodu lub interakcję z systemami zewnętrznymi.
Analiza długich dokumentów
Milion-tokenowe okno kontekstu sprawia, że model jest odpowiedni dla dużych umów, dokumentacji technicznej, zbiorów badawczych i korporacyjnych baz wiedzy, gdzie w przeciwnym razie konieczne byłoby ciągłe dzielenie treści.
Analiza wideo i wizualna
Qwen3.8-Flash akceptuje zarówno obrazy, jak i wideo. Obecne limity wizualnego API pozwalają na wideo o długości do dwóch godzin, co ma znaczenie dla nagrań spotkań, samouczków, wykładów, demonstracji i analizy długich treści wizualnych.
Produkcyjna AI wrażliwa na koszty
To prawdopodobnie największa przewaga komercyjna modelu. Qwen wprost rekomenduje Flash jako tańszą alternatywę dla Qwen3.8-Max, co czyni go odpowiednim dla aplikacji o dużej skali, w których flagowa jakość wnioskowania nie jest konieczna przy każdym żądaniu.
Jakie są ograniczenia Qwen3.8-Flash?
Qwen3.8-Flash nie powinien być interpretowany jako najwyżej wydajny model w rodzinie Qwen3.8 tylko dlatego, że dzieli okno kontekstu 1M z Qwen3.8-Max.
Głównym kompromisem jest możliwości versus koszt: sam Qwen rekomenduje Qwen3.8-Max, gdy wymagana jest najsilniejsza jakość wnioskowania.
Drugą kwestią jest to, że okno kontekstu 1M nie oznacza, że każde żądanie powinno zawierać milion tokenów. Duże konteksty zwiększają wymagania obliczeniowe i deweloperzy powinni stosować wyszukiwanie, buforowanie oraz zarządzanie kontekstem, gdy cały kontekst nie jest potrzebny.
Wreszcie, deweloperzy powinni odróżniać hostowany qwen3.8-flash od otwartowagowego Qwen3.8-Flash-Next. Ten drugi to zapowiedź architektury i ma niezależnie udokumentowane wagi oraz architekturę; produkcyjny model API powinien być opisywany zgodnie z własną specyfikacją API.
Czy Qwen3.8-Flash nadaje się do produkcyjnych aplikacji API?
Tak, szczególnie gdy aplikacja potrzebuje wielomodalnego wnioskowania, długiego kontekstu, użycia narzędzi i relatywnie niskiego kosztu tokenów.
Jest to silniejszy kandydat produkcyjny niż Flash-Next, gdy wymagane jest po prostu wywołanie hostowanego API Qwen, ponieważ qwen3.8-flash jest wprost udostępniony jako produkcyjny model w dokumentacji API Qwen, z określonymi limitami kontekstu, wyjścia, narzędzi i modalności.
Dla maksymalnej jakości wnioskowania Qwen3.8-Max pozostaje bardziej odpowiednim wyborem. Dla obciążeń o dużej skali, gdzie koszt i przepustowość mają większe znaczenie, Qwen3.8-Flash jest bardziej ekonomiczną opcją.
Parametry API Qwen3.8-Flash
Standardowe żądanie kompatybilne z OpenAI może używać parametrów takich jak:
| Parametr | Przeznaczenie |
|---|---|
| model | qwen3.8-flash |
| messages | Konwersacja i wejście wielomodalne |
| temperature | Kontrola próbkowania |
| max_tokens | Maksymalna generowana odpowiedź |
| stream | Strumieniowanie odpowiedzi |
| tools | Definicje funkcji/narzędzi |
| tool_choice | Zachowanie wyboru narzędzia |
| response_format | Konfiguracja ustrukturyzowanego wyjścia |
| enable_thinking | Włącza tryb myślenia w obsługiwanych API Qwen |
Dokumentacja szybkiego startu używa OpenAI SDK z identyfikatorem modelu qwen3.8-flash. Przykład włącza wnioskowanie poprzez extra_body={"enable_thinking": True}.
Jak korzystać z API qwen3.8-flash w CometAPI
Krok 1: Uzyskaj dostęp do API
Zaloguj się do cometAPI. Jeśli nie jesteś jeszcze naszym użytkownikiem, zarejestruj się. Zaloguj się do swojego CometAPI console. Uzyskaj klucz API dostępu do interfejsu. Kliknij „Add Token” przy tokenie API w centrum osobistym, uzyskaj klucz tokena: sk-xxxxx i zatwierdź.
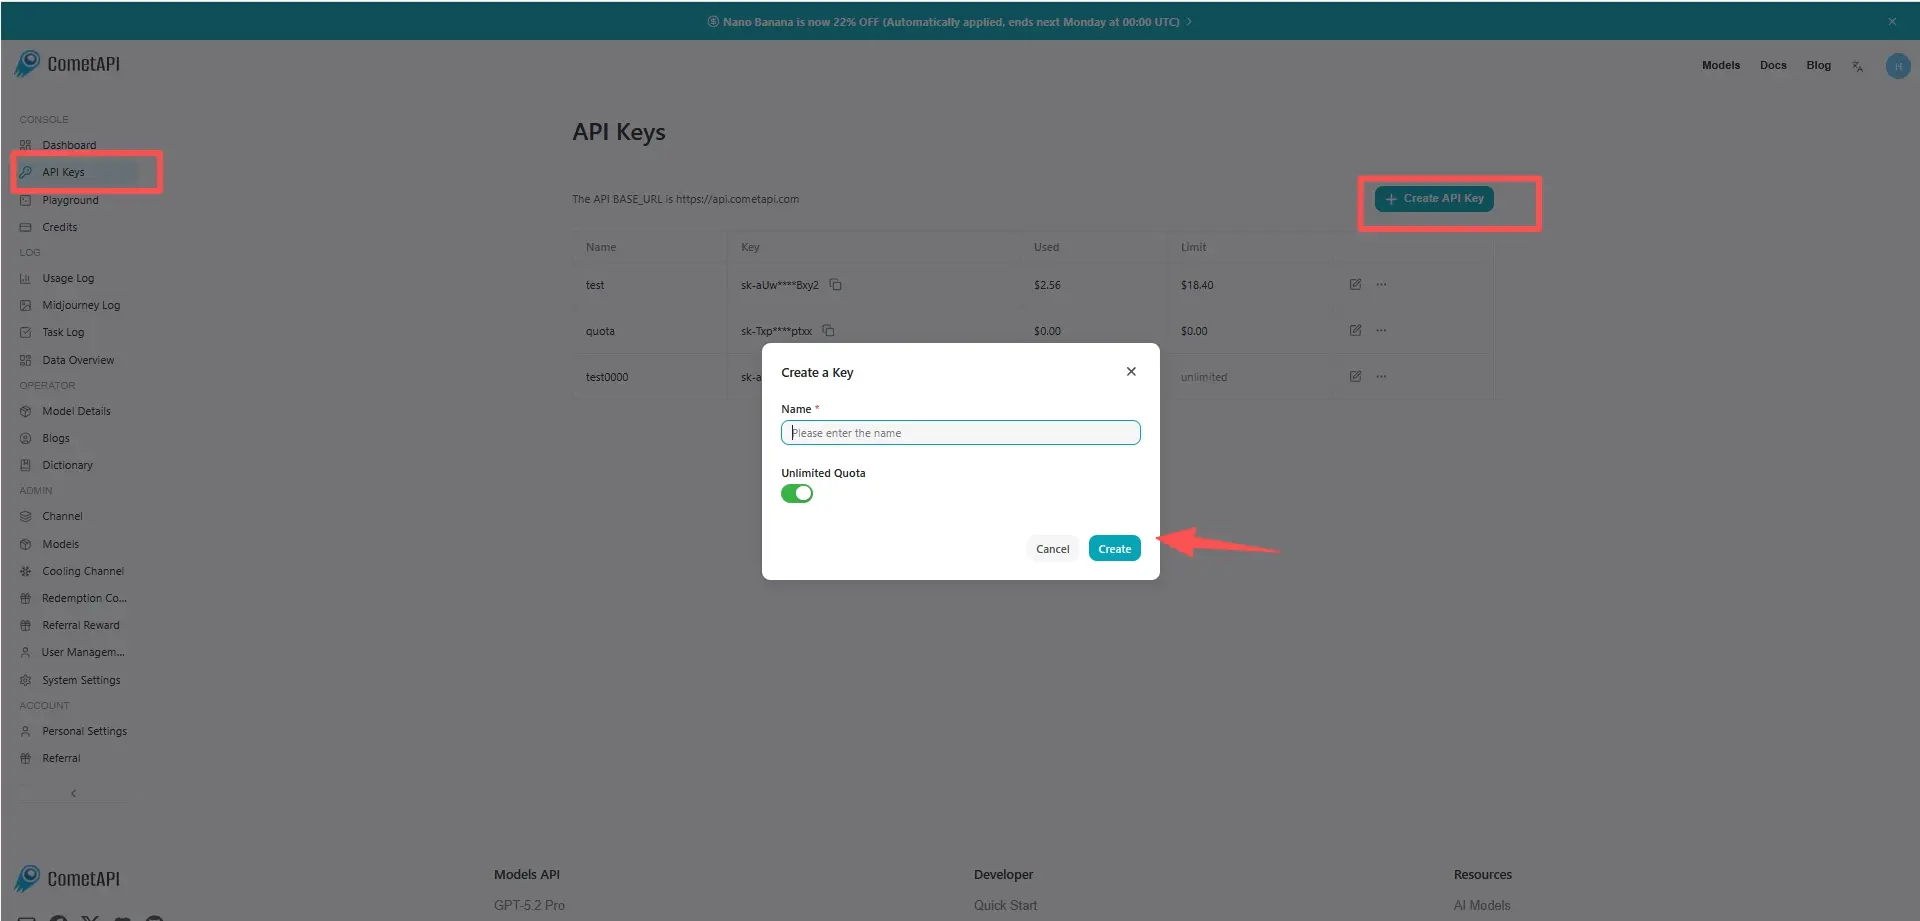
Krok 2: Wysyłaj żądania do API qwen3.8-flash
Wybierz endpoint „qwen3.8-flash”, aby wysłać żądanie API i ustaw ciało żądania. Metoda żądania i ciało żądania są dostępne w naszej dokumentacji API na stronie. Nasza strona udostępnia również test w Apifox dla Twojej wygody. Zastąp <YOUR_API_KEY> rzeczywistym kluczem CometAPI ze swojego konta.
Wstaw swoje pytanie lub prośbę w pole content — na to model odpowie. Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź. Obsługiwane są AI SDK, OpenAI Chat Completions, OpenAI Responses oraz interfejsy zgodne z Anthropic Messages.
Krok 3: Przetwarzaj odpowiedzi
API zwraca ustrukturyzowane propozycje odpowiedzi, w tym wygenerowany tekst, odwołania, metadane bezpieczeństwa oraz opcjonalne wyniki narzędzi. Dla żądań wielomodalnych treść wiadomości może być ustrukturyzowana z wejściami tekstowymi i obrazami, gdy wybrany endpoint CometAPI udostępnia obsługę wizji modelu.