

TL;DR
Muse Wonder, Claude Opus 5.5 i GPT-6 Sol to modele o wysokich możliwościach, pozycjonowane do kodowania i agentowych przepływów pracy. Nowy Muse Wonder od Meta kładzie nacisk na trwałą pamięć i długotrwałe wykonywanie; Opus 5.5 prowadzi w cytowanym zagregowanym indeksie inteligencji; GPT-6 Sol ma najniższe standardowe stawki wejścia i wyjścia dla krótkiego kontekstu w tym porównaniu, podczas gdy jego poziom dla długiego kontekstu jest wyceniany osobno. Wybieraj na podstawie jakości reprezentatywnych zadań, niezawodności i łącznego kosztu, a nie pojedynczego wyniku z rankingu.
Najważniejsze wnioski
- Ogólna inteligencja: Claude Opus 5.5 uzyskuje 58 wobec 52 dla Muse Wonder w raporcie Intelligence Index v4.3.
- Długohoryzontalne kodowanie: Muse Wonder notuje 78.8 na DeepSWE 1.1 i 53.1 na SWE-Marathon; Opus 5.5 ma 74.2 i 46.3 w tabeli Meta.
- Niskokosztowe rozumowanie: GPT-6 Sol zaczyna od $2 za wejście / $10 za wyjście na milion tokenów przez standardowe API krótkiego kontekstu OpenAI.
- Agenci z pamięcią: Muse Wonder wprowadza Active Memory i Active Focus.
- Dostępność ma znaczenie: Muse Wonder Full to oddzielny, bardziej ograniczony produkt niż dostępny dla deweloperów standardowy Muse Wonder.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol w skrócie
Wybierz Muse Wonder do trwałych agentów i długotrwałej inżynierii, Claude Opus 5.5 do szerokiego kodowania i pracy mocno opartej na terminalu, a GPT-6 Sol ze względu na niższe standardowe koszty tokenów w krótkim kontekście.
| Czynnik decyzyjny | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Zacznij testy od | Trwałe agenty i długotrwałe prace inżynieryjne | Kodowanie silnie oparte na terminalu i workflowy profesjonalne | Kodowanie i automatyzacja wrażliwe na budżet |
| Okno kontekstu | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Opublikowane mocne strony | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standardowe wej./wyj. $2/$10 za 1M tokenów |
| Standard: wejście/wyjście za 1M tokenów | $4 / $20 | $4 / $20 | $2 / $10; poziom krótkiego kontekstu |
| Dostęp u dostawcy | Meta Model API; Full to oddzielny produkt subskrypcyjny | Anthropic API | OpenAI API |
| Kryterium wyboru | Jakość zaakceptowanych zadań i łączny koszt | Jakość zaakceptowanych zadań i łączny koszt | Jakość zaakceptowanych zadań i łączny koszt |
| Producent | Meta | Anthropic | OpenAI |
| Data wydania | October 12, 2026 | September 22, 2026 | September 16, 2026 |
| Modalności wejściowe | Text, image, audio, video; udokumentowane wejścia PDF | Text, image | Text, image |
| Wyjście | Text | Text | Text |
| Wyróżniająca funkcja | Active Memory i Active Focus | Przepływy pracy z narzędziami i subagentami | Konfigurowalny wysiłek rozumowania i narzędzia API |
Ten przegląd podsumowuje datowane specyfikacje i opublikowane wyniki omówione poniżej. Wiersze benchmarków używają różnych metod ewaluacji, a niskie stawki tokenów nie przesądzają o niższym koszcie na jedno pomyślnie wykonane zadanie. Standardowy Muse Wonder i Muse Wonder Full to różne opcje dostępu.
Specyfikacje sprawdzono 13 października 2026 r. Obsługiwane modalności i funkcje zależą od wybranego endpointu i powierzchni wydania, w tym dostępności audio. Zdolności na poziomie modelu nie gwarantują wsparcia na każdej trasie bramki.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Przegląd i specyfikacje
Muse Wonder: Przepływy pracy trwałych agentów
Meta wprowadziła Muse Wonder i Muse Wonder Full 12 października 2026 r. Standardowy Muse Wonder kładzie nacisk na długotrwałe zadania profesjonalne, trwałą pamięć agenta i odzyskiwanie po przeszkodach. Active Memory ma służyć do przywoływania użytecznego wcześniejszego kontekstu, a Active Focus ma podtrzymywać postęp w pracy wieloetapowej. Meta wskazuje jako kluczowe scenariusze: kodowanie, badania, analizy finansowe i asystę osobistą.
Claude Opus 5.5: Profesjonalne kodowanie i użycie narzędzi
Claude Opus 5.5 celuje w kodowanie, rozumowanie i profesjonalne przepływy pracy z wieloma narzędziami. Anthropic wydał go 22 września 2026 r. Okno kontekstu to milion tokenów, a poniżej raportowane wyniki w kodowaniu pokazują mocne strony zależne od benchmarku.
GPT-6 Sol: Rozumowanie zorientowane na koszty
GPT-6 Sol ma łączyć silne rozumowanie i użycie narzędzi z relatywnie przystępnymi kosztami inferencji. Wspiera programistyczne przepływy pracy przez ekosystem API OpenAI. Jego standardowe stawki dla krótkiego kontekstu są niższe niż podane stawki Claude Opus 5.5, choć ekonomia end-to-end zależy też od ponowień i użycia tokenów rozumowania.
OpenAI opisuje GPT-6 Sol jako model do złożonego kodowania i agentowych przepływów pracy; ogłoszenie wydania zawiera wyniki ewaluacji użyte poniżej. Ten artykuł porównuje wskazane wersje modeli, a nie wszystkie nowsze modele w ofercie każdego dostawcy.
Architektura i sterowanie rozumowaniem
Cytowane tu źródła nie podają porównywalnego zestawienia liczby parametrów i architektury dla wszystkich trzech modeli. Nie ma więc podstaw do klasyfikacji „gęsty vs MoE”. Active Memory i Active Focus opisują możliwości agentowe Meta; nie zastępują ujawnionej architektury sieci. GPT-6 Sol udostępnia konfigurowalny wysiłek rozumowania, a raportowane wyniki Meta i Claude zależą również od wysiłku i ustawień ewaluacji. Traktuj te ustawienia jako część porównywanej konfiguracji, a nie zamienne miary nakładów obliczeniowych.
Wynik porównania: Wszystkie trzy oferują duże okna kontekstu i API dla deweloperów. Muse Wonder dokumentuje szersze modalności wejściowe na poziomie modelu; Opus 5.5 i GPT-6 Sol akcentują przepływy tekst–obraz. Pojemność kontekstu i dostępność funkcji należy jednak sprawdzać na wybranym endpointzie.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Wydajność
Opublikowane benchmarki i granice źródeł
Oficjalna karta modelu Meta oferuje bezpośrednie porównania Muse Wonder i Claude Opus 5.5. OpenAI publikuje wyniki GPT-6 Sol osobno, więc trzech modeli nie da się umieścić na jednej w pełni kontrolowanej liście bez ujednolicenia harnessów ewaluacyjnych, wersji i ustawień.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Wyższy wynik |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Oficjalna metodologia karty modelu rozróżnia testy wewnętrzne, ewaluacje stron trzecich i wyniki konkurentów raportowane przez dostawców. Tabela odtwarza podane wartości; nie stanowi jednolitego, niezależnie kontrolowanego testu we wszystkich wierszach.
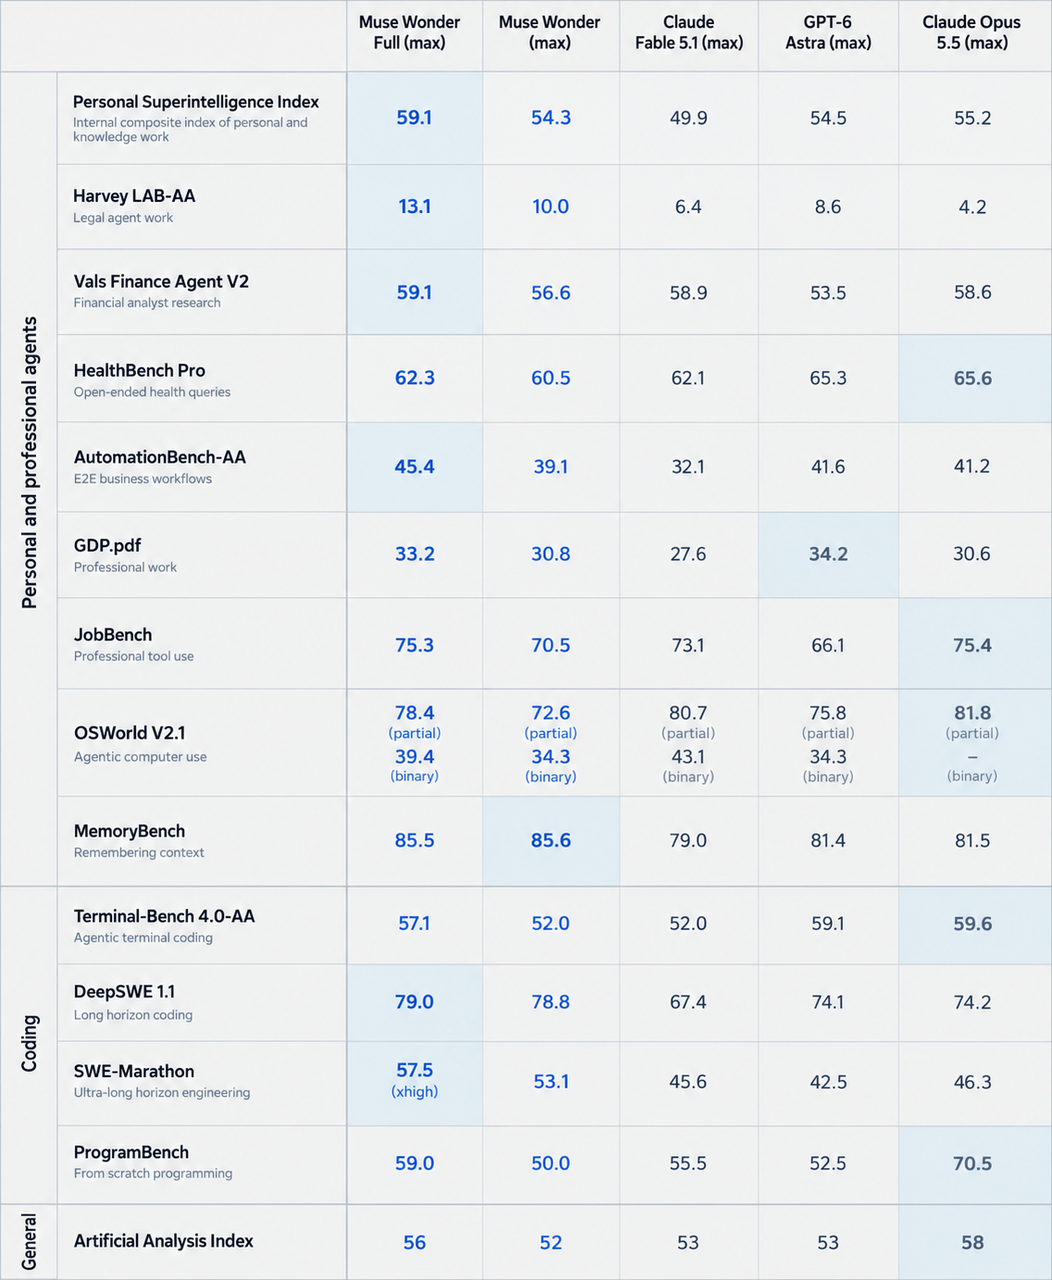
Oryginalna karta wyników benchmarków z karty modelu Muse Wonder od Meta, odtworzona bez przeredagowywania. Dodatkowy model OpenAI pokazany na tym oficjalnym obrazie to GPT-6 Astra, a nie GPT-6 Sol. Otaczające tabele identyfikują modele istotne dla tego artykułu.
Warunki oceny
DeepSWE v1.1 obejmuje 113 zadań w 91 repozytoriach i pięciu językach, ocenianych testami funkcjonalnymi i regresyjnymi przy użyciu pass@1; karta wyników Meta używa wyników Datacurve dla Muse Wonder i Opus 5.5. SWE-Marathon korzysta z testów projektowych i raportuje pass@1 od Abundant AI; harnessy agentów się różnią, a wynik Wonder Full jest oznaczony jako xhigh. ProgramBench używa mini-swe-agent i mierzy roll-outy zaliczające co najmniej 95% ukrytych testów, z wyłączonym internetem po konfiguracji. MemoryBench to wewnętrzny test Meta konwersacji 64K–100K tokenów oceniany przez sędziego LLM. Tych środowisk i metryk nie należy spłaszczać do jednego ogólnego wyniku dokładności.
Programowanie i inżynieria oprogramowania
Muse Wonder prowadzi w raportowanych wynikach DeepSWE 1.1 i SWE-Marathon. Claude Opus 5.5 prowadzi w Terminal-Bench 4.0-AA i ProgramBench. Ten podział sugeruje, że długohoryzontalna inżynieria, użycie narzędzi w wierszu poleceń i rekonstrukcja programów akcentują różne umiejętności.
Wyniki GPT-6 Sol i porównywalność między źródłami
| Opublikowana ocena OpenAI | GPT-6 Sol | Zgłoszona konfiguracja |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
Opublikowane wyniki ewaluacji OpenAI podają powyższe wartości. Wynik OSWorld dotyczy częściowej nagrody na zestawie offline v2026.08.08, a nie ścisłego wskaźnika ukończenia zadań. OpenAI zaznacza, że ewaluacje używały środowiska badawczego lub API; konfiguracje produkcyjne mogą się różnić.
Raportowane wyniki DeepSWE sugerują 10,0 punktu procentowego przewagi Muse Wonder nad GPT-6 Sol i 5,4 punktu nad Opus 5.5 względem GPT-6 Sol. To są różnice arytmetyczne między publikacjami, a nie kontrolowane oszacowania przewagi zależnej wyłącznie od modelu. Różne konfiguracje agentów, prompty, poziomy wysiłku i budżety narzędzi mogą wpływać na wynik.
Pamięć i długo działające agenty
Muse Wonder celuje w agentów, którzy muszą pamiętać wcześniejsze decyzje, odzyskiwać kontekst i kontynuować przerwaną pracę. Active Memory może pomóc asystentowi badawczemu zapamiętywać fakty specyficzne dla projektu, a Active Focus wspiera iteracyjne działania, gdy wcześniejszy plan nie zadziała. Te możliwości produktowe nie zastępują weryfikacji stanu, uprawnień, ścieżek audytu ani obowiązkowego potwierdzenia przez człowieka dla wrażliwych działań.
Wydajność Muse Wonder Full
Muse Wonder Full to oddzielna opcja produktowa. Meta oferuje standardowy Muse Wonder przez swoje API, natomiast Full jest ograniczony do subskrypcji Power Usage i Maximum Usage w Muse Code. Wyższy wynik nie czyni z Full zamiennika API dla standardowego modelu.
Raportowane przez Meta wyniki Wonder Full to 56 w Intelligence Index, 59.1 w Personal Superintelligence, 13.1 w Harvey LAB-AA i 45.4 w AutomationBench-AA. Uzyskuje też 79.0 na DeepSWE 1.1, 57.5 na SWE-Marathon, 85.5 na MemoryBench i 75.3 na JobBench. Te opublikowane wyniki dotyczą oddzielnie dostępowego produktu Full; nie są to nowe pomiary z porównania w wspólnym harnessie.
W porównaniu ze standardowymi wynikami Muse Wonder powyżej, Full poprawia 7 z tych 8 miar; MemoryBench jest minimalnie niższy: 85.5 vs 85.6. Opus 5.5 nadal prowadzi w raportowanym Intelligence Index z wynikiem 58.
Latencja i niezawodność
Cytowane dowody nie dostarczają dopasowanego porównania latencji dla trzech modeli. Mierz czas do pierwszego użytecznego wyjścia, medianę i 95. percentyl całkowitego czasu zadania, częstość timeoutów oraz ukończenia bez interwencji. Utrzymaj stałe: wejścia zadań, uprawnienia do narzędzi, współbieżność i kryteria akceptacji; zapisuj ustawienia wysiłku i budżety powtórzeń. Szybsza generacja tokenów sama w sobie nie oznacza szybszego ukończenia zadania wieloetapowego.
Wynik porównania: Muse Wonder prowadzi w cytowanych testach trwałej inżynierii, natomiast Opus 5.5 w cytowanych testach terminalowych i rekonstrukcji programów. GPT-6 Sol pozostaje kandydatem o niższej cenie tokenów, ale dostępne publikacje nie dowodzą rankingu jakości ani szybkości w równych warunkach dla całej trójki.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Koszty
Oficjalne ceny tokenów API
| Cena za 1M tokenów | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standardowe wejście | $4 | $4 | $2 |
| Standardowe wyjście | $20 | $20 | $10 |
| Zbuforowane wejście | $0.20 | $0.20 | $0.20 |
| Wejście dla długiego kontekstu | $4 | $4 | $4 |
| Wyjście dla długiego kontekstu | $20 | $20 | $15 |
| Zbuforowane wejście dla długiego kontekstu | $0.20 | $0.20 | $0.40 |
Meta publikuje $4 za wejście, $20 za wyjście i $0.20 za trafienia cache na milion tokenów. Anthropic podaje dla Opus 5.5 $4 za wejście, $20 za wyjście i $0.20 za trafienia cache na milion tokenów. Tabela cen OpenAI podaje dla GPT-6 Sol $2/$10 dla krótkiego kontekstu (wejście/wyjście) i $4/$15 dla długiego kontekstu; stawki za zbuforowane wejście również różnią się według poziomu. Zastosuj odpowiedni poziom kontekstu w żądaniu, tryb przetwarzania i warunki endpointu przed szacowaniem obciążenia.
Dla GPT-6 Sol żądania zawierające ponad 272,000 tokenów wejściowych są rozliczane według wyższych stawek:
- Tokeny wejściowe: 2× stawki standardowej, wzrost z $2 do $4 za milion tokenów.
- Zbuforowane tokeny wejściowe: 2× stawki standardowej, wzrost z $0.20 do $0.40 za milion tokenów.
- Tokeny wyjściowe: 1.5× stawki standardowej, wzrost z $10 do $15 za milion tokenów.
Wyższe stawki dotyczą całego żądania, a nie tylko tokenów przekraczających 272,000. Żądanie z 272,001 tokenami wejściowymi wchodzi więc do poziomu cenowego długiego kontekstu dla wszystkich swoich tokenów wejścia, zbuforowanego wejścia i wyjścia.
Dla porównania, Muse Wonder i Claude Opus 5.5 nie nakładają równoważnej premii cenowej za długi kontekst w ramach standardowych stawek API.
To rozróżnienie jest szczególnie ważne przy analizie dużych dokumentów, pracy na repozytoriach i długo działających agentach AI, gdzie przewaga cenowa krótkiego kontekstu GPT-6 Sol może się zawężać wraz ze wzrostem rozmiaru żądań.
Cennik i warunki rozliczeń CometAPI
W momencie przeglądu CometAPI podawało stawki dla Opus 5.5: $3.20 za wejście / $16 za wyjście oraz dla GPT-6 Sol: $1.60 za wejście / $8 za wyjście za milion tokenów. Są to niezależne stawki CometAPI i nie należy ich utożsamiać z oficjalnymi cenami dostawców powyżej. Potwierdź właściwą trasę, poziom kontekstu i warunki rozliczeń konta przed szacowaniem kosztu; ceny i warunki mogą się zmieniać.
Koszt na zaakceptowane zadanie
Oblicz koszt na zaakceptowane zadanie jako łączny rozliczony wydatek na model i narzędzia, w tym płatne ponowienia i fallbacki, podzielony przez liczbę wyników spełniających z góry określone kryteria akceptacji. Czas przeglądu przez człowieka rejestruj osobno lub przeliczaj przy użyciu jawnej stawki. Śledź nieudane żądania i faktyczne obciążenia niezależnie: sama porażka nie przesądza, czy żądanie zostało zafakturowane.
Wynik porównania: GPT-6 Sol ma najniższe wymienione standardowe stawki wejścia i wyjścia dla krótkiego kontekstu, podczas gdy Muse Wonder i Opus 5.5 mają te same stawki bazowe. Rzeczywisty koszt na zaakceptowane zadanie zależy od wybranej trasy rozliczeń, użycia cache, poziomów kontekstu, opłat za narzędzia, ponowień i nakładu przeglądu.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Porównanie i wybór
Wybór na podstawie możliwości i obciążenia
- Do szerokiego kodowania i pracy na terminalu zacznij od Claude Opus 5.5, ponieważ prowadzi w cytowanych wynikach Intelligence Index, Terminal-Bench i ProgramBench. Zweryfikuj go pod kątem refaktoryzacji, wykonywania narzędzi i spójności na poziomie programu.
- Do rozszerzonych projektów inżynieryjnych zacznij od Muse Wonder, ponieważ jego raportowane wyniki na DeepSWE i SWE-Marathon są silniejsze niż Opus 5.5. Mierz ukończenie zadań, odzyskiwanie po przeszkodach i łączny koszt zadania.
- Do trwałych agentów osobistych zacznij od Muse Wonder, bo oferuje Active Memory i Active Focus oraz ma wyższy raportowany wynik MemoryBench niż Opus 5.5. Testuj przywoływanie, korekty, ciągłość i izolację projektów.
- Do wieloetapowych przepływów z narzędziami oceń całą trójkę. Muse oferuje Active Focus, Opus akcentuje orkiestrację narzędzi, a GPT-6 Sol wspiera narzędzia Responses API. Porównuj kompletny stos agenta, w tym uprawnienia do narzędzi, ponowienia i obsługę stanu.
- Do dokumentów profesjonalnych i analiz oceń Muse Wonder lub Claude Opus 5.5. Muse ma wyspecjalizowane mocne strony, a Opus ma silniejszy cytowany zagregowany indeks. Używaj reprezentatywnych dokumentów i kryteriów akceptacji specyficznych dla zadania.
- Do automatyzacji o dużej skali i wysokiej wrażliwości na koszty zacznij od GPT-6 Sol, bo ma najniższe wymienione standardowe stawki tokenów dla krótkiego kontekstu. Sprawdź koszt zaakceptowanego zadania, poziomy kontekstu, latencję i ponowienia.
- Dla najwyższej opcji od Meta oceń Muse Wonder Full, jeśli jest dostępny. Ma wyższe raportowane wyniki w kilku wyspecjalizowanych zadaniach, ale jest oddzielny od standardowego modelu API. Potwierdź dostęp do subskrypcji i przydatność przed testami.
Profesjonalne kodowanie
Claude Opus 5.5 to dobry domyślny wybór dla zespołów wymagających szerokiej asysty inżynierskiej, zwłaszcza tam, gdzie liczą się wykonywanie narzędzi, refaktoryzacja i spójność na poziomie programu. Jego raportowane przewagi w Terminal-Bench i ProgramBench wzmacniają ten argument, choć zespoły powinny weryfikować cały stos agenta, a nie tylko model.
Automatyzacja na dużą skalę
GPT-6 Sol jest atrakcyjny, gdy żądań jest dużo i liczy się koszt. Nawet niewielki deficyt jakości może być akceptowalny w niskiego ryzyka, łatwych do sprawdzenia zadaniach, takich jak szkicowanie dokumentacji, ekstrakcja pól strukturalnych czy wyjaśnianie kodu. Przy długich autonomicznych przebiegach śledź łącznie jakość, tokeny, latencję i ponowienia.
Lista kontrolna oceny produkcyjnej
Ocena produkcyjna powinna śledzić sześć metryk: poprawność, mierzoną zaakceptowanymi odpowiedziami lub testami na zielono; niezawodność, mierzoną zadaniami ukończonymi bez ratunku przez człowieka; latencję, mierzoną czasem end-to-end; użycie tokenów, mierzone łączną liczbą rozliczonych tokenów wejścia i wyjścia; efektywność agenta, mierzoną wywołaniami narzędzi i korekcyjnymi ponowieniami; oraz efektywny koszt, liczony jako łączny wydatek podzielony przez liczbę zaakceptowanych zadań.
Wynik porównania: Krótka lista: Muse Wonder do zachowania stanu agenta i rozszerzonej inżynierii, Opus 5.5 do szerokich przepływów kodowania z silnym naciskiem na terminal, oraz GPT-6 Sol, gdy głównym ograniczeniem jest koszt tokenów. Promuj kandydata dopiero po spełnieniu progów jakości i niezawodności specyficznych dla zadań.
Gdzie można uzyskać dostęp do Muse Wonder, Claude Opus 5.5 i GPT-6 Sol?
Dostęp od oficjalnych dostawców
Użyj Meta Model API dla standardowego Muse Wonder, Anthropic API dla Opus 5.5 lub OpenAI API dla GPT-6 Sol. Muse Wonder Full jest dostępny poprzez wskazane plany subskrypcji Muse Code, a nie jako zamiennik standardowego modelu API. Sprawdź dostęp do konta, limity użytkowania i obsługiwane funkcje żądań dla wybranej trasy.
Dostęp przez CometAPI
Ujednolicona bramka może uprościć uwierzytelnianie, rozliczenia i trasowanie. Użyj modelu o wyższej wydajności do złożonych przeglądów architektury i tańszego modelu do powtarzalnego, niskiego ryzyka szkicowania. Identyfikator modelu i obsługiwany format żądania zawsze należy sprawdzić względem docelowego endpointu API.
Deweloperzy mogą uzyskać dostęp do Claude Opus 5.5 API w CometAPI oraz GPT-6 Sol API w CometAPI, aby ocenić reprezentatywne obciążenia. Potwierdź obsługiwaną powierzchnię API dla każdego modelu, zamiast zakładać, że wspólna bramka czyni wszystkie formaty żądań wymiennymi.
Wskazane trasy CometAPI obejmują Opus 5.5 i GPT-6 Sol. Ten artykuł nie ustanawia trasy CometAPI dla Muse Wonder ani Wonder Full; użyj potwierdzonej trasy dostawcy przy ocenie tych produktów.
Wnioski
Żaden pojedynczy model nie wygrywa we wszystkich obciążeniach. Muse Wonder jest najsilniejszym kandydatem do testów zachowania trwałego agenta i długotrwałych zadań inżynieryjnych. Claude Opus 5.5 jest mocnym kandydatem do szerokiego kodowania, pracy mocno opartej na terminalu i pracy z wiedzą, a także prowadzi w Artificial Analysis Intelligence Index raportowanym przez Meta. GPT-6 Sol oferuje najniższe standardowe ceny tokenów dla krótkiego kontekstu i jest atrakcyjny przy wrażliwości na koszty. Zespoły produkcyjne powinny dokonać ostatecznego wyboru, stosując jakość zaakceptowanych zadań, niezawodność, latencję, ponowienia, użycie narzędzi i łączny koszt na reprezentatywnych obciążeniach.
FAQ
Jak zespoły mogą uczciwie testować Muse Wonder, Opus 5.5 i GPT-6 Sol?
Użyj wydzielonego zestawu rzeczywistych zadań z ustalonymi kryteriami akceptacji, identycznymi artefaktami wejściowymi i udokumentowanymi uprawnieniami do narzędzi. Zapisuj wersję modelu, ustawienie wysiłku, harness agenta, limit czasu i budżet tokenów. Uruchamiaj powtarzane próby tam, gdzie wyniki się różnią, raportuj porażki oraz sukcesy i oddziel porównanie we wspólnym harnessie od porównania najlepiej skonfigurowanych systemów. To daje dowody odnoszące się do Twojego przepływu pracy, a nie ustawień benchmarków innego zespołu.
Czy bramka API może zachować stan agenta przy przełączaniu modeli?
Wspólny adres bramki sam w sobie nie gwarantuje przenośnego stanu konwersacji, identyfikatorów wywołań narzędzi ani odwołań do przechowywanych odpowiedzi. Utrzymuj kanoniczny, po stronie aplikacji, zapis wiadomości, wyników narzędzi i zweryfikowanego stanu zadania. Przetestuj semantykę stanu i narzędzi każdej trasy przed przekierowaniem trwającego zadania do innego modelu; w przeciwnym razie tańszy fallback może utracić informacje potrzebne do poprawnego zakończenia.
Jak zespoły powinny budżetować ponowienia i przegląd przez człowieka?
Zdefiniuj akceptowalny wynik przed testami, a następnie podziel łączny rozliczony wydatek na model i narzędzia przez liczbę wyników zaakceptowanych. Raportuj pracę przeglądową osobno lub wlicz ją przy użyciu podanej stawki godzinowej. Zliczaj nieudane próby, połączenia korygujące i modele fallback, i porównuj zarówno typowe, jak i kosztowne zadania. To pozwala uniknąć traktowania niższej ceny tokenów jako gwarantowanego spadku kosztu użytecznej pracy.
Co powinno obejmować testowanie agenta wrażliwego na pamięć?
Sprawdź, czy agent przywołuje istotne fakty, uwzględnia korekty, ignoruje nieaktualne instrukcje i utrzymuje izolację między projektami. Uwzględnij opóźnione follow-upy i sprzeczne aktualizacje, a nie tylko pojedynczy długi prompt. Sprawdzaj zachowanie pamięci na poziomie aplikacji i modelu, ponieważ trwałość, wyszukiwanie i usuwanie zależą od wdrożonego systemu.