
TLDR OpenAI Bel to niepotwierdzony wewnętrzny pretrening (nazwa kodowa), po raz pierwszy zgłoszony na X 25 sierpnia 2026 r. przez @synthwavedd. Twierdzenie opisuje ukończony model bazowy z ponad 10 bilionami łącznych parametrów — następcę wcześniejszego przebiegu o nazwie Doug — przeznaczony jako fundament dla systemów po GPT-6 i potencjalnie jako model na poziomie „progu AGI” po dalszym uczeniu ze wzmocnieniem.
Na dzień 13 października 2026 r. OpenAI nigdy nie używało nazwy Bel (ani Doug w publicznych materiałach produktowych), nie opublikowało liczby parametrów, daty wydania, benchmarków ani karty systemowej, a Bel nie jest dostępny przez API ani w ChatGPT.
Najważniejsze wnioski
- Bel pochodzi z jednego wpisu na X autorstwa @synthwavedd z 25 sierpnia 2026 r.; OpenAI nigdy go nie potwierdziło.
- Deklarowana skala: >10T łącznych parametrów, podobna klasą wielkości do GPT-4.5 według pierwotnego wpisu.
- Pozycjonowany w plotce jako następca „Douga” i baza dla systemów po GPT-6 / Astra po RL.
- GPT-6 Astra jest publicznie dostępny od początku września 2026 r. i jest obecnym flagowcem OpenAI.
- Nie istnieją niezależne benchmarki, data wydania, API, ceny ani wagi dla Bel.
- Claude Fable 5.5 pozostaje niezapowiedziany; obecnie najwyższy model Claude to Fable 5.1.
- Do zastosowań produkcyjnych dziś kieruj modele GPT-6 Astra / Sol / Luna oraz Claude przez jeden klucz w CometAPI, aby obniżyć koszty i uniknąć uzależnienia od dostawcy.
Czym jest OpenAI Bel?
OpenAI Bel (czasem zapisywany „BEL”) to nazwa kodowa krążąca w dyskusjach społeczności AI dla rzekomego, wielkoskalowego przebiegu pretreningu, który OpenAI miało rzekomo ukończyć w drugiej połowie sierpnia 2026 r. Według pierwotnego raportu Bel jest surowym modelem bazowym — niegotowym produktem — z ponad 10 bilionami łącznych parametrów. Jest przedstawiany jako następca wcześniejszego projektu wewnętrznego o nazwie Doug oraz jako zamierzona baza, która po dodatkowym uczeniu ze wzmocnieniem i post‑trainingu mogłaby zasilać systemy wykraczające poza GPT-6 Astra, potencjalnie osiągając poziom zdolności określany przez niektórych insajderów jako „próg AGI”.
Co istotne, Bel nie jest GPT-7, nie jest modelem ChatGPT, z którym użytkownicy mogą rozmawiać, i nie jest dostępny przez OpenAI API. Opisywany jest wyłącznie jako artefakt pretreningu — ogromna sieć neuronowa wytrenowana na tekście (i być może innych danych), która wciąż wymaga szerokiego dostrajania, alignmentu i prac nad bezpieczeństwem, zanim stanie się produktem nadającym się do wdrożenia.
Bel to zgłaszana nazwa kodowa prac OpenAI nad modelem bazowym. Twierdzenie przypisywane jest wpisowi z 25 sierpnia 2026 r. o ukończonym przebiegu pretreningu autorstwa @synthwavedd. Reprodukowany wpis utrzymuje, że model ma ponad 10 bilionów łącznych parametrów i jest następcą Douga. Te szczegóły pozostają twierdzeniami z jednego źródła: zrzut ekranu rejestruje twierdzenie, a nie uwierzytelniony wynik treningu OpenAI.
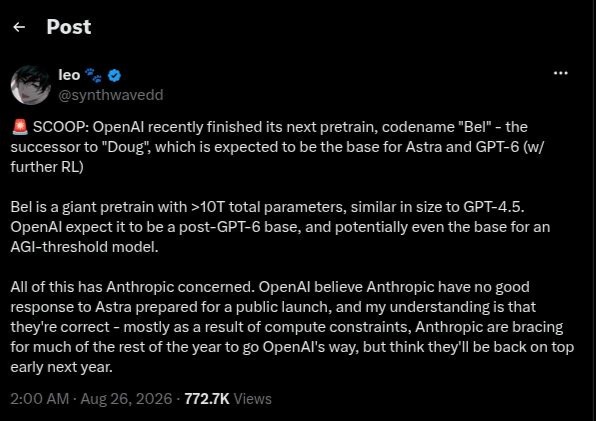
Zrzut ekranu został odtworzony z uchwycenia wpisu przez Mukhtadę. Pokazuje datę 26 sierpnia o 2:00 w kontekście czasu Dżakarty źródła, co odpowiada 25 sierpnia o 19:00 UTC. Jest to przechwycenie strony przez podmiot trzeci, a nie niezależne potwierdzenie liczby parametrów, statusu treningu czy prywatnych twierdzeń konkurencyjnych.
Oś czasu dowodów: Doug–Bel
Tło związane z Dougiem jest odrębne: publikacja SemiAnalysis z 7 sierpnia reprodukuje notatkę z 9 lipca, wzmiankującą większy model OpenAI o nazwie Doug. To wyprzedza wpis o Belu, ale nie uwierzytelnia przejścia Doug → Bel ani nie łączy którejkolwiek nazwy kodowej z wydanym produktem.
- 9 lipca 2026 r.: Notatka badawcza wzmiankująca większy model OpenAI o nazwie Doug została później odtworzona w artykule SemiAnalysis opublikowanym 7 sierpnia. Data notatki i data publikacji to różne kamienie milowe; to tło dotyczące Douga, a nie potwierdzenie Bela.
- 7 sierpnia 2026 r.: SemiAnalysis opublikowało artykuł odtwarzający wzmiankę o Dougu. Wyprzedza on twierdzenie o Belu, ale nie ustanawia linii Doug → Bel ani publicznej nazwy produktu.
- 25 sierpnia 2026 r.: Przypisywany wpis @synthwavedd ogłasza ukończenie pretreningu Bel i ponad 10 bilionów łącznych parametrów. Przechwycenie osoby trzeciej odtwarza to twierdzenie; nie jest to niezależna weryfikacja.
- 1 września 2026 r.: Raport Path to Astra cytowany w tym artykule dostarcza tła na temat odrębnego programu rozwoju modeli. Nie ustanawia tożsamości Bela, jego liczby parametrów ani związku z GPT-7 czy ewentualną nazwą GPT-6 Bel.
- 23 września 2026 r.: Krążąca relacja przypisuje oczekiwanie rzędu miesięcy wpisowi uzupełniającemu tego samego konta. Ponieważ oryginalna treść nie była bezpośrednio dostępna w trakcie przeglądu źródeł, pozostaje to nieweryfikowalną wskazówką czasową i nie stanowi zobowiązania co do uruchomienia.
- 12 października 2026 r. — punkt kontrolny przeglądu artykułu: Przypisywany wpis o Belu, doniesienia o Dougu oraz odrębny oficjalny raport cytowane tutaj nie ustanawiają komercyjnej tożsamości Bela. Ani GPT-7, ani GPT-6 Bel nie są potwierdzone przez ten łańcuch dowodów; ta data odnotowuje przegląd artykułu, a nie ogłoszenie modelu.
W zbliżonym okresie OpenAI publicznie omawiało nienazwany model wewnętrzny „znacznie bardziej zdolny niż GPT-6 Astra” w kontekście prac matematycznych (w tym wyników związanych z równaniami Naviera–Stokesa).
Dwie hipotezy nazewnicze: GPT-7 czy GPT-6 Bel?
Pretrening i wydanie produktu to różne kamienie milowe. Punkt kontrolny fundamentu może nadal wymagać dostrajania instruktażowego, uczenia ze wzmocnieniem, ewaluacji bezpieczeństwa, treningu korzystania z narzędzi i optymalizacji serwowania. Z jednego fundamentu może wynikać wiele produktów, a publiczny numer wersji nie identyfikuje przebiegu treningu. Raport Path to Astra dostarcza oficjalnego tła na temat uczenia ze wzmocnieniem, nie ustanawiając jednak tożsamości Bela.
Hipoteza 1 — GPT-7: Jeśli Bel reprezentuje materialnie nowy fundament wykraczający poza generację GPT-6, OpenAI mogłoby skomercjalizować pochodny model jako GPT-7. Ta interpretacja zależy od nowej generacji zdolności i decyzji o nazwie publicznej; ani rzekoma liczba parametrów, ani zgłaszane ukończenie pretreningu nie przesądzają o takim rezultacie.
Hipoteza 2 — GPT-6 Bel: OpenAI mogłoby zamiast tego utrzymać produkt pochodny od Bel w rodzinie GPT-6, potencjalnie używając etykiety takiej jak GPT-6 Bel dla ulepszonej lub wyspecjalizowanej oferty. To scenariusz nazewniczy do porównań redakcyjnych, nie ogłoszony produkt ani przeciek potwierdzony innym źródłem. Wewnętrzna nazwa kodowa nie musi pojawić się w nazwie komercyjnej.
Co pozostaje nierozstrzygnięte: Ten sam wysiłek treningowy może zasilić wiele produktów, przyjąć inną nazwę lub nie doczekać się publicznego wydania. Ostateczne potwierdzenie wymagałoby dokumentacji łączącej wysiłek treningowy Bel z faktycznym publicznym modelem i jego nazwą.
Porównanie OpenAI Bel z poprzednią generacją: co się poprawia?
Ponieważ brakuje konkretnych danych technicznych o Bel, każda dyskusja o ulepszeniach musi opierać się na (1) ogólnych twierdzeniach z przecieku, (2) znanej trajektorii GPT-4o → GPT-5.x → GPT-6 Astra oraz (3) zdolnościach demonstrowanych przez nienazwany model wewnętrzny użyty do prac w skali równań Naviera–Stokesa. Każdy potencjalny obszar poprawy omówiono osobno poniżej.
Skala i moc obliczeniowa pretreningu
Centralnym twierdzeniem jest skok poza poprzednie przebiegi wewnętrzne w reżim >10T parametrów. Jeśli to prawda, oznaczałoby to dalsze trzymanie się praw skalowania dla danych, parametrów i mocy obliczeniowej. Potwierdzone: OpenAI kontynuowało duże treningi i publicznie odnosiło się do modeli bardziej zdolnych niż Astra. Niepotwierdzone: konkretna liczba parametrów, FLOPs treningowe, mieszanka danych czy zmiany architektury (gęsta vs. mieszanka ekspertów, nowe mechanizmy uwagi itd.). Realistyczne oczekiwanie w oparciu o historię: lepsza efektywność próbkowania i szersze pokrycie wiedzy, ale malejące korzyści bez odpowiednich postępów w post‑trainingu i jakości danych.
Post‑training i alignment dla działań agentowych o długim horyzoncie
GPT-6 Astra już istotnie poprawiła wieloetapowe przepływy pracy, korzystanie z komputera oraz trzymanie się granic zadania. Silniejsza baza plus dalsze RL mogłyby przesunąć niezawodne działanie agentowe z horyzontów godzinnych w stronę wielodniowych lub wielotygodniowych przy mniejszym sterowaniu człowieka. Eksperyment multi‑agentowy związany z równaniami Naviera–Stokesa (tysiące koordynujących agentów) pokazuje, że OpenAI już działa w skali dużych rojów agentów na trudnych problemach. Kierunek zdolności potwierdzony: tak. Specyficzny wkład Bela: niepotwierdzony.
Rozumowanie naukowe i matematyczne
Sama Astra przyczyniła się do postępu matematycznego; silniejszy model wewnętrzny uzyskał sformalizowany wynik dotyczący Problemu Milenijnego. Większa, lepiej wytrenowana baza mogłaby dalej skrócić czas i koszt eksploracji trudnych przestrzeni poszukiwań w STEM. Potwierdzone: OpenAI intensywnie w to inwestuje. Specyficznie dla Bel: niepotwierdzone.
Korzystanie z komputera, narzędzi i niezawodność multimodalna
Astra ustanowiła nowe wyniki na benchmarkach korzystania z komputera i przeglądarki. Oczekuje się, że przyszłe bazy zmniejszą odsetek błędów na długich trajektoriach, poprawią rozumienie wizualne i poradzą sobie z bardziej złożonymi środowiskami programistycznymi. To spekulacja, ale spójna z mapą drogową produktu.
Wydajność, szybkość wnioskowania i koszt
Nawet jeśli baza jest większa, destylacja, lepsze architektury i własne układy scalone (OpenAI mówiło o własnych ASIC‑ach) mogą nadal zapewnić użyteczny stosunek koszt/efekt. Nie istnieją żadne konkretne twierdzenia o efektywności dla Bel.
Kiedy mogą zostać wydane OpenAI Bel lub GPT-7?
Przeglądane źródła nie ustanawiają oficjalnej daty premiery dla Bela ani modelu pochodnego od Bela jako GPT-7. Krążący opis wpisu z 23 września tego samego konta, mówiący o oczekiwaniu rzędu miesięcy, przypisywany jest temu samemu nieoficjalnemu źródłu co pierwotny przeciek. Jego pełna treść nie była bezpośrednio dostępna podczas tego przeglądu, więc nie powinna służyć do prognozowania okna premiery. Ukończony pretrening, jeśli to prawda, mógłby zostać uzupełniony o post‑training, ewaluacje, prace nad serwowaniem i etapowe wdrożenia.
| Scenariusz | Co by się wydarzyło | Co to implikuje |
|---|---|---|
| Szybsze domknięcie | Pozostałe ewaluacje i wdrożenie przebiegają stosunkowo szybko | Następca może pojawić się wcześniej |
| Wydłużony rozwój | Wymagane są dalsze treningi, działania łagodzące i prace serwujące | Termin przesuwa się dalej w czasie |
| Alternatywne wdrożenie | Model bazowy zasila wyspecjalizowane lub inaczej markowane systemy | Nie musi istnieć produkt o nazwie Bel |
Hipotetyczny Fable 5.5 nie ma zweryfikowanego harmonogramu w przeglądanych źródłach, więc przewidywanie kolejności wydań nie jest uzasadnione.
Czy Bel może przesunąć równowagę między OpenAI a Anthropic?
Otwarte pozostają trzy wiarygodne wyniki. Po pierwsze, Bel mógłby wprowadzić szeroki skok w pretreningu i poprawić późniejsze systemy do kodowania i rozumowania. Po drugie, przewaga może być wąska, z innymi dostawcami utrzymującymi prowadzenie w niezawodności agentów, latencji lub koszcie. Po trzecie, ogromna deklarowana skala może nie przełożyć się na proporcjonalne korzyści praktyczne. Dopóki nie ma powtarzalnych dowodów, właściwe ujęcie to możliwa odpowiedź konkurencyjna, a nie ogłoszony zwycięzca.
Praktyczne rekomendacje dla deweloperów i zespołów (CometAPI)
Podczas gdy branża czeka na oficjalne potwierdzenie Bela lub następnego dużego modelu bazowego OpenAI, systemy produkcyjne potrzebują dziś niezawodnego dostępu do modeli, które faktycznie istnieją. CometAPI zapewnia pojedynczy, zgodny z OpenAI endpoint (https://api.cometapi.com/v1) i jeden klucz API dający dostęp do 500+ modeli, w tym pełnej, obecnej rodziny GPT-6 (Astra, Sol, Luna i aktualizacje) oraz linii Claude od Anthropic (Fable 5.1, Opus 5.5, Sonnet 5.5 itd.).
Wnioski
Granica postępu w AI szybko się przesuwa. Bel może ostatecznie okazać się ważnym kamieniem milowym wewnętrznie, błędnie relacjonowaną nazwą kodową albo czymś pomiędzy. Dopóki OpenAI nie opublikuje konkretnych informacji, odpowiedzialne podejście to traktować te twierdzenia jako niezweryfikowane, jednocześnie maksymalizując wartość z modeli już dostępnych — i utrzymywać infrastrukturę na tyle elastyczną, by włączyć następną generację w chwili, gdy stanie się realna. Dla wielu zespołów taką elastyczność najłatwiej osiągnąć dziś poprzez zunifikowaną platformę taką jak CometAPI.