
TL;DR
OpenAI Decisions API i TypeSafe Jev zwracają ograniczone, oparte na prawdopodobieństwie decyzje zamiast zwykłej generowanej prozy. OpenAI używa GPT-6 Luna poprzez dedykowany endpoint; TypeSafe Jev to wyspecjalizowany model System One. Jev jest tańszy w publikowanych stawkach za tokeny wejściowe (0,042 USD vs 0,10 USD za milion), podczas gdy OpenAI ma natywną obsługę obrazów. Przedstawione tu dane dostawców nie przesądzają o zwycięzcy pod względem dokładności ani szybkości w bezpośrednim porównaniu.
Key Takeaways
- Cennik: Jev jest o 58% tańszy per token wejściowy w publikowanych stawkach bazowych.
- Architektura: OpenAI Decisions API używa GPT-6 Luna; Jev jest zaprojektowany pod przetwarzanie decyzji.
- Modalność: OpenAI obsługuje tekst i obrazy; Jev koncentruje się na tekście i danych strukturalnych.
- Benchmarki: Oświadczenia o szybkości opierają się na różnych liniach bazowych; porównuj na tym samym oznakowanym zbiorze.
- Wybór: Priorytetyzuj wsparcie multimodalne i integrację z OpenAI, albo przepustowość tekstu i koszt, zależnie od zastosowania.
At Glance: OpenAI Decisions API vs Jev
Poniższe zestawienie porównuje udokumentowane endpointy decyzji i publikowane stawki bazowe, sprawdzone 12 października 2026 r. Dostęp do modeli, limity i warunki świadczenia usług należy zweryfikować dla konta wdrożeniowego.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Tekst + obrazy | Tekst / tekst strukturalny |
| Question types | Predicate (prawdopodobieństwo warunku), choice (kategoria), score (rubryka) | Noul (prawdopodobieństwo warunku), choice (kategoria), score (poziomy) |
| Request questions | Tablica z nazwami | Obiekt kluczowany ID |
| Context limit | Nie określono w powiązanym przewodniku Decisions | 64K łącznie; stan + najdłuższe pytanie ≤32K |
| Base input cost / 1M | 0,10 USD | 0,042 USD |
| Output token cost | Brak opłat | Brak opłat |
| Vendor speed statement | Około 10× szybciej niż Responses API | 70–500 ms od końca do końca |
| Availability | Public beta | Wczesny dostęp w ogłoszeniu; zweryfikuj bieżący dostęp konta |
| Distinct advantage | Decyzje na podstawie obrazów | Niższy opublikowany koszt wejścia |
| Generative reasoning / coding | Nie jest kontraktem wyjściowym tego endpointu | Nie jest kontraktem wyjściowym tego endpointu |
Wiele przepływów pracy AI potrzebuje kategorii, prawdopodobieństwa lub wyniku — nie akapitu. Zgłoszenie wsparcia wymaga trasowania; agent musi wybrać zatwierdzoną akcję; kolejka przeglądowa powinna wskazać niepewne wejścia. Oba produkty traktują takie decyzje jako pierwszorzędne rezultaty API.
OpenAI udostępniło Decisions API w wersji beta 6 października 2026 r.. Jego endpoint GPT-6 Luna akceptuje tekst i obrazy. Jev to specjalistyczny model System One firmy TypeSafe AI do niegeneratywnej ewaluacji, z podejściem treningowym opisanym jako Reinforcement Learning for Calibrated Decisions (RLCD).
Typy pytań w tabeli obejmują trzy wspólne zadania. OpenAI predicate i Jev noul szacują, czy warunek jest spełniony, np. intencja zwrotu lub kwalifikowalność. Choice wybiera spośród zdefiniowanych kategorii, takich jak Billing, Technical i Shipping, do trasowania. Score ocenia wejście według rubryki lub poziomów, np. pilność lub priorytet. Te opisy konsolidują dwa przeglądy produktów; schematy żądań i semantyka prawdopodobieństw nadal wymagają obsługi specyficznej dla dostawcy.
What is OpenAI Decisions API and Jev?
OpenAI Decisions API i TypeSafe Jev to usługi AI skoncentrowane na decyzjach, zaprojektowane do przekształcania danych wejściowych w ustrukturyzowane, ograniczone wyjścia, a nie otwarty tekst. W przeciwieństwie do tradycyjnych dużych modeli językowych generujących wyjaśnienia lub odpowiedzi konwersacyjne, te API oceniają z góry zdefiniowane pytania i zwracają decyzje, prawdopodobieństwa lub wyniki. Czyni je to szczególnie użytecznymi w zautomatyzowanych przepływach pracy, takich jak trasowanie zgłoszeń klientów, klasyfikacja treści, ocena ryzyka i wybór narzędzi przez agentów AI, gdzie kluczowe są przewidywalne wyjścia i efektywne przetwarzanie.
OpenAI Decisions API jest zasilane przez GPT-6 Luna i działa przez endpoint /v1/decisions. Obsługuje zarówno wejścia tekstowe, jak i obrazowe, z trzema typami decyzji: predicate, choice i score. Jego główną zaletą jest połączenie kontekstowego rozumienia modelu ogólnego przeznaczenia z dedykowanym interfejsem decyzji, co czyni je odpowiednim do klasyfikacji multimodalnej i aplikacji już zintegrowanych z ekosystemem OpenAI.
TypeSafe Jev to z kolei wyspecjalizowany model decyzyjny dostępny przez endpoint /v1/systemone. Koncentruje się na ewaluacji tekstowej, używając trzech typów pytań: noul, choice i score. Jev kładzie nacisk na wydajne wnioskowanie, ustrukturyzowane przewidywania i kalibrację prawdopodobieństw, co czyni go atrakcyjnym wyborem do klasyfikacji na dużą skalę i zautomatyzowanych potoków decyzyjnych. Choć oba serwisy rozwiązują podobne problemy, różnice w architekturze, możliwościach wejścia, cenach i projekcie API mogą znacząco wpływać na to, który lepiej pasuje do konkretnej aplikacji.
Model Approach, Input Limits, and Scope
To porównanie dotyczy udokumentowanego zachowania API i pozycjonowania produktu. OpenAI udostępnia GPT-6 Luna przez endpoint decyzji, podczas gdy TypeSafe pozycjonuje Jev jako wyspecjalizowany model System One. Same te opisy nie przesądzają o przewadze w dokładności ani nie ujawniają wszystkich szczegółów implementacyjnych.
Jev dopuszcza 64K tokenów w całym żądaniu, z osobnym limitem 32K dla stanu i najdłuższego pytania. Wlicz instrukcje pytań i kryteria oraz współdzielone wejście. Powiązany przewodnik OpenAI Decisions nie podaje osobnego numerycznego limitu kontekstu dla tego endpointu; zweryfikuj obowiązujące limity zamiast zakładać, że ogólny rozmiar okna kontekstu modelu ma zastosowanie bez zmian.
Generatywne rozumowanie i benchmarki kodowania wykraczają poza zakres tych ograniczonych endpointów decyzyjnych. Do generowania wyjaśnień lub kodu oceniaj oddzielny endpoint generatywny. Wyniki dla bazowego modelu ogólnego przeznaczenia nie przesądzają o wydajności dla endpointu Decisions.
Accuracy and Latency
Przytoczone materiały dostawców nie dostarczają dopasowanego testu bezpośredniego, który przesądza o zwycięzcy pod względem dokładności lub latencji. Około 10× szybsze działanie OpenAI porównuje Decisions z Responses API. TypeSafe raportuje 70–500 ms latencji end-to-end i wskazuje, że jego publikowane ewaluacje były z reguły uruchamiane z laptopa na zachodzie USA.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | Brak dopasowanego testu w cytowanych źródłach | Brak dopasowanego testu w cytowanych źródłach | Brak zwycięzcy |
| Speed | Względna deklaracja dostawcy | Bezwzględny zakres dostawcy | Niewspółmierne |
| Calibration | Probabilities; osobne confidence dla choice/score | Probabilities; confidence wywiedzione dla choice/score | Testuj obserwowaną kalibrację |
| Text categorization | Wspierane | Wspierane | Obie opcje są viable |
| Visual categorization | Natywne obrazy | Brak natywnych obrazów | Przewaga OpenAI |
Probability Calibration and Review Thresholds
Model może być dokładny, ale słabo skalibrowany. Wśród przewidywań z przypisanym prawdopodobieństwem 0,90 dla wybranej klasy około 90% powinno być poprawnych, jeśli to prawdopodobieństwo jest skalibrowane na dystrybucji ewaluacyjnej. Nie podstawiaj pola API o nazwie confidence zamiast tego prawdopodobieństwa bez sprawdzenia jego definicji. Jev wywodzi swoje confidence dla Choice z rozkładu prawdopodobieństwa: confidence = (p_max − 1/n) / (1 − 1/n), gdzie n to liczba wyborów. Wynik Noul nie ma osobnego pola confidence. Mierz ECE i Brier score z właściwych prawdopodobieństw, obok precision, recall i macro F1; wybieraj progi przeglądu na podstawie oznakowanych przykładów.
Pricing and Cost per Accepted Decision
OpenAI podaje 0,10 USD za milion tokenów wejściowych dla /v1/decisions; Jev podaje 0,042 USD za milion tokenów wejściowych. Oba serwisy nie naliczają opłat za tokeny wyjściowe dla tych usług decyzyjnych. Na podstawie tych stawek bazowych Jev jest o 58% tańszy per token wejściowy. Mogą mieć zastosowanie regionalne dopłaty processing OpenAI i mnożniki dla długiego kontekstu; ponawianie prób, przetwarzanie wstępne i przeglądy mogą zwiększyć koszty przepływu pracy.
Załóż, że każde żądanie wykorzystuje 500 rozliczanych tokenów wejściowych w obu usługach. To są przykładowe obliczenia, nie faktury dostawców.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Koszt na zaakceptowaną poprawną decyzję = (wydatki na API + wydatki na ponawianie + wydatki na przegląd ludzki) / liczba zaakceptowanych poprawnych decyzji. Niska stawka per token może zostać zrównoważona przez wyższy odsetek błędnych trasowań lub eskalacji.
Dla konwencjonalnego workflow GPT-6 Luna tabela cen modeli CometAPI wymienia następujące stawki USD za milion tokenów, sprawdzone 12 października 2026 r. Są to stawki dla endpointu modelu; powiązana strona pokazuje przykład Responses API i nie przesądza o natywnym wsparciu /v1/decisions ani jego cenniku.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
Zwykłe tokeny wyjściowe GPT-6 Luna w CometAPI są rozliczane. Zachowaj tę estymację osobno od dwóch powyższych usług decyzyjnych, których opublikowana opłata za tokeny wyjściowe wynosi zero. Na przykład 500 tokenów wejściowych plus 20 tokenów wyjściowych kosztuje 0,000048 USD na żądanie w kontekście short, czyli 48 USD za milion żądań, przed innymi opłatami. Potwierdź odpowiedni tier i stawkę konta w katalogu modeli na żywo przed budżetowaniem.
Agent Workflows and Modality Tradeoffs
Oba mogą wybrać wywołanie narzędzia, ocenić, czy warunek strażniczy jest spełniony, lub przyznać wynik akcji. Żaden nie zastępuje autoryzacji, walidacji wejścia ani jawnych uprawnień do narzędzi. Dla automatyzacji wizualnych natywna obsługa obrazów w OpenAI upraszcza potok; dla czysto tekstowego trasowania niższy koszt bazowy Jev może być atrakcyjny.
Obsługa wyjścia różni się na granicy odpowiedzi. OpenAI zwraca answers array, z names identyfikującymi pytania; Jev zwraca answers object kluczowany przez question ID. Znormalizuj te struktury przed zastosowaniem wspólnych reguł biznesowych. Jev wywodzi confidence ze swojego rozkładu prawdopodobieństwa; nie zakładaj, że identycznie nazwane pola mają równoważne znaczenia u różnych dostawców. Waliduj etykiety i kalibruj progi przeglądu na danych aplikacji.
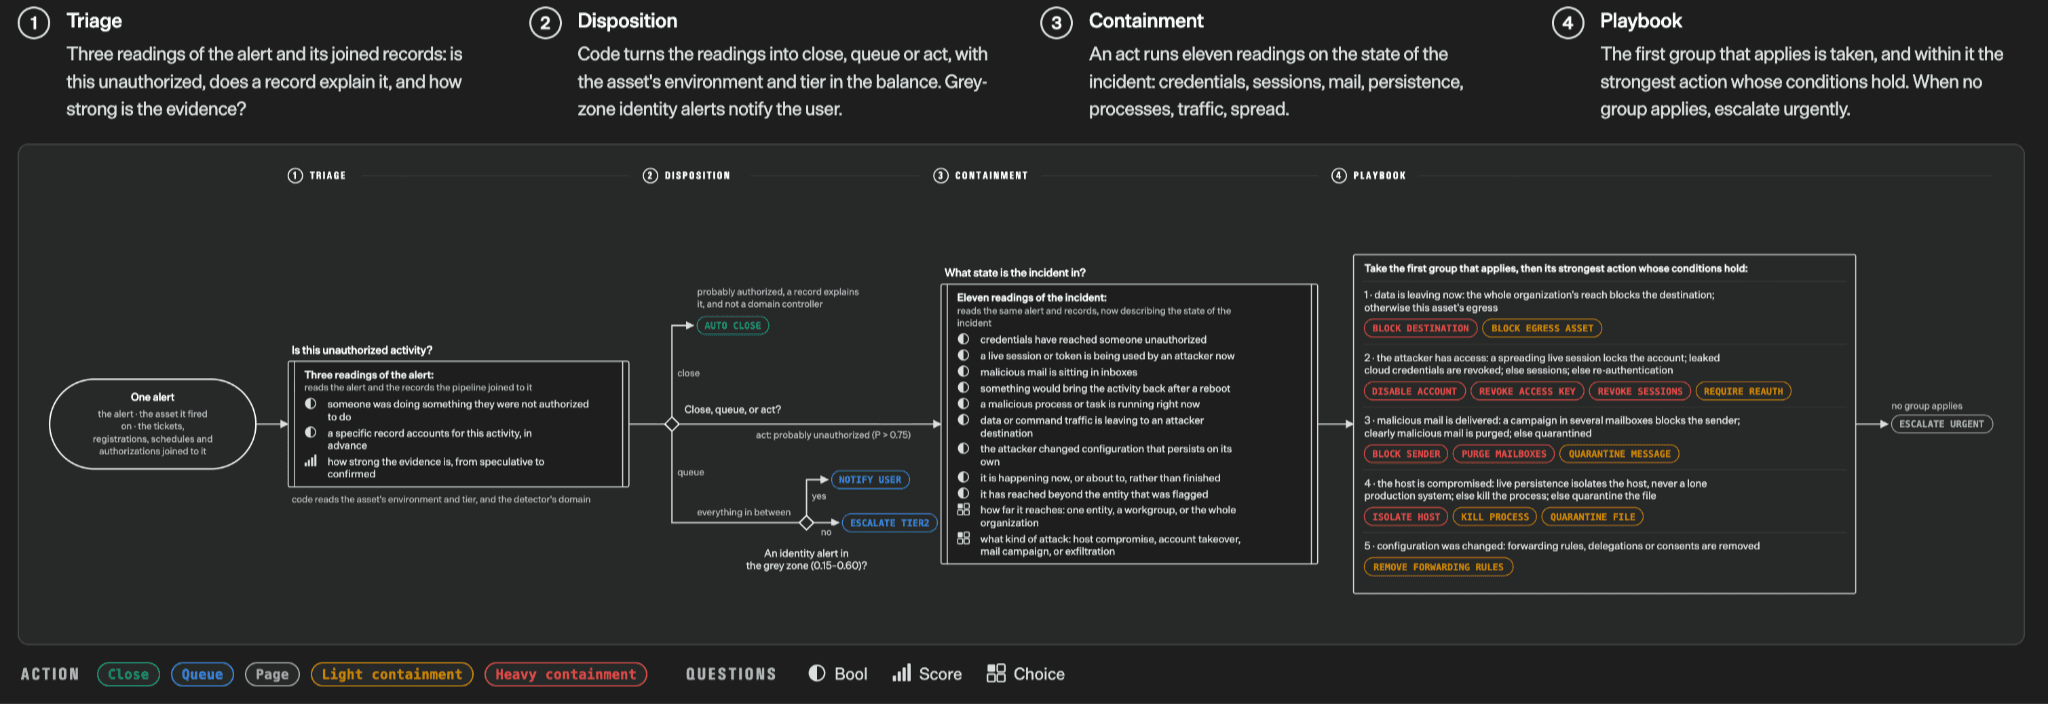
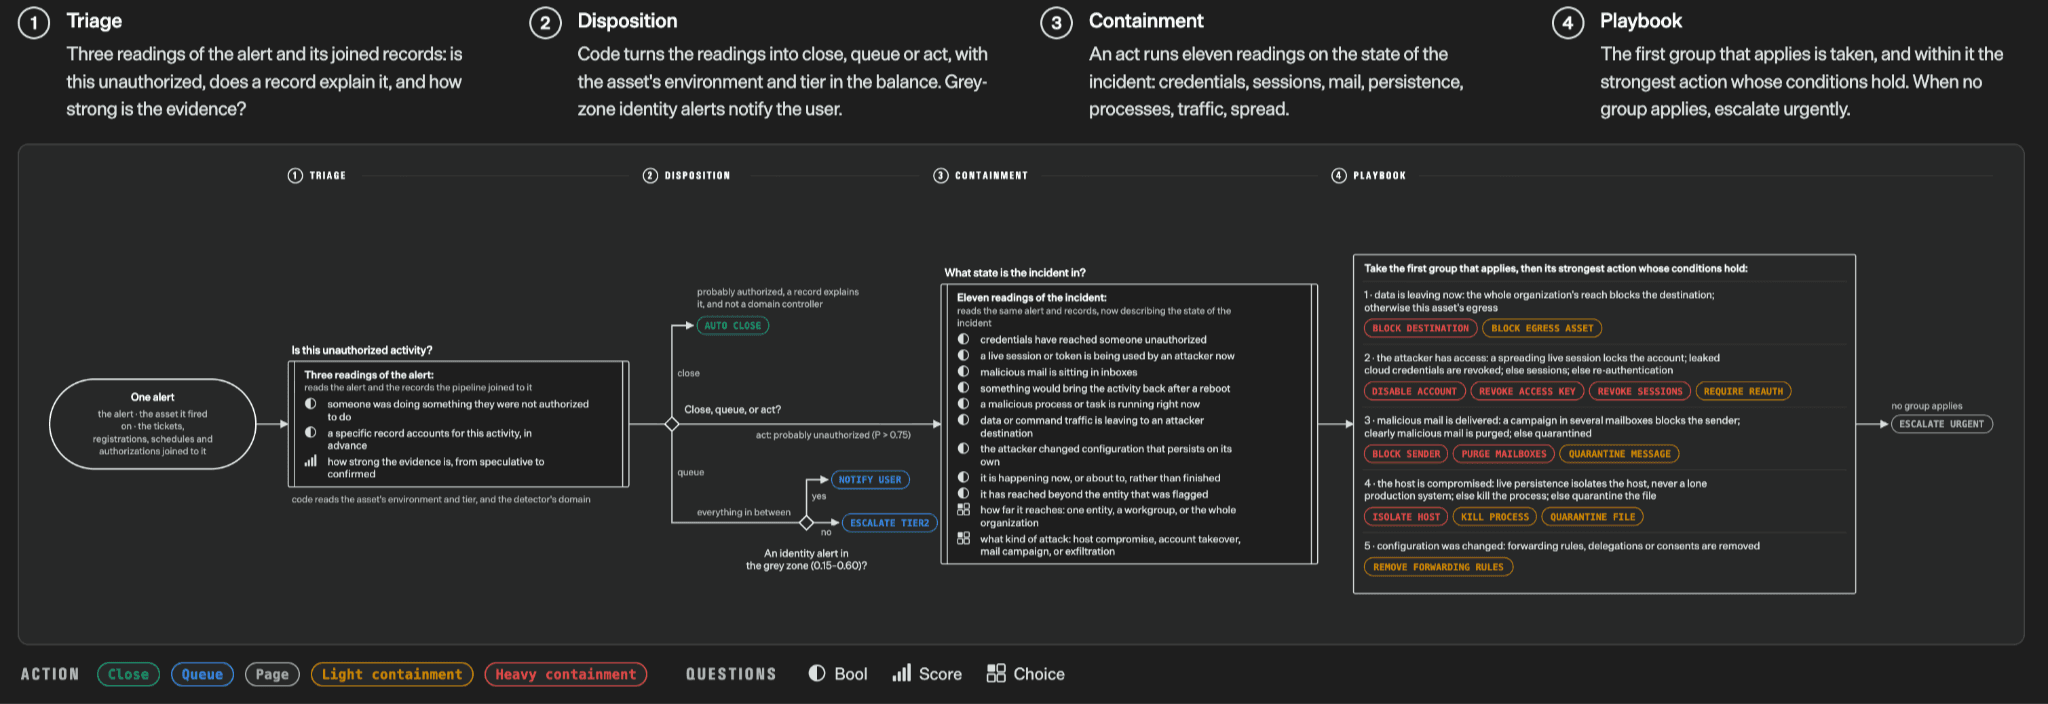
Źródło: Introducing System One Models & Jev; oryginalny obraz. To ilustruje kompozycję workflow, nie dopasowany benchmark wobec OpenAI Decisions API.
How API Usage Differs: OpenAI Decisions API vs Jev
Dostęp należy skonfigurować oddzielnie dla każdego dostawcy: każdy przykład poniżej używa własnego hosta i klucza API. OpenAI dokumentuje Decisions jako endpoint public-beta. W przypadku Jev potwierdź bieżący dostęp i poświadczenia w TypeSafe przed wdrożeniem. Dla obu usług zweryfikuj uprawnienia konta, dostępność regionalną, limity i warunki świadczenia usług; przykład żądania nie gwarantuje dostępu produkcyjnego. Dostęp stron trzecich do modelu generatywnego nie potwierdza sam w sobie wsparcia dla jego natywnego endpointu decyzyjnego.
How to use OpenAI Decisions API
Koncepcje się pokrywają, ale schematy żądań różnią się. OpenAI wysyła input i tablicę nazwanych questions; Jev używa state i obiektu questions kluczowanego przez question ID. Zaimplementuj adapter specyficzny dla dostawcy przed zastosowaniem wspólnej polityki decyzji.
Przekieruj zgłoszenie wsparcia z użyciem OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
How to use Jev API
Poniższe żądanie cURL używa endpointu System One Jev do klasyfikacji zgłoszenia wsparcia. Ustaw TYPESAFE_API_KEY w środowisku, umieść zgłoszenie w state i zdefiniuj department wewnątrz obiektu questions. Jego mapa criteria wymienia dozwolone etykiety trasowania i ich opisy. Po powodzeniu żądania odczytaj wpis department w answers i zweryfikuj wybraną etykietę przed trasowaniem zgłoszenia. Potwierdź, że identyfikator modelu jest dostępny na Twoim koncie.
Przekieruj zgłoszenie wsparcia z użyciem TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Keyed object |
| Question ID | name | Object key |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
Shared Review Policy for Selected-Class Probabilities
Zastosuj jawnie skalibrowany próg do prawdopodobieństwa wybranej klasy.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Ten przykład dla Pythona 3.10+ to warstwa polityki aplikacji, a nie parser odpowiedzi API. Każdy adapter dostawcy musi zwalidować odpowiedź i wydobyć prawdopodobieństwo wybranej klasy. Nie przekazuj surowego pola confidence Jev jako selected_probability. Dostarcz próg skalibrowany dla danego dostawcy, pytania i zbioru ewaluacyjnego; obsłuż odmowy i błędy transportowe przed wywołaniem tej polityki.
OpenAI Decisions API vs Jev: How to choose
Wybieraj w dwóch etapach. Najpierw przefiltruj wymogi wdrożeniowe: wejście obrazowe, dostęp do konta, limity wejścia i nakład integracyjny. Następnie porównaj kwalifikujące się usługi na tym samym oznakowanym zadaniu. Dla trasowania tekstowego sprawdź, czy niższa opublikowana cena wejścia Jev przekłada się na niższy koszt całkowity; dla decyzji zależnych od obrazów oceń natywną ścieżkę obrazów OpenAI. Porównuj błędne trasowania, kalibrację, latencję ogonową, ponawianie prób i przegląd ludzki przy uzgodnionym celu jakościowym. Poniższa tabela to lista wstępna, a nie dowód ogólnego zwycięzcy wydajności.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Supported | Supported | Najpierw benchmarkuj Jev pod koszt |
| Text categorization | Supported | Supported | Porównaj kalibrację |
| Screenshot inspection | Native | Requires vision preprocessing | OpenAI |
| Agent tool selection | Supported | Supported | Mierz wyniki end-to-end |
| Multimodal moderation | Text and images | Text only | OpenAI |
| Existing OpenAI stack | Native | New integration | OpenAI |
Dla automatyzacji biznesowej na dużą skalę, takiej jak trasowanie wsparcia i klasyfikacja tekstu, Jev warto priorytetyzować, gdy kluczowe są koszt wejścia i przepustowość. Dla zastosowań multimodalnych, w tym inspekcji zrzutów ekranu, moderacji wizualnej i decyzji opartych na obrazach, OpenAI Decisions API jest praktyczniejszą opcją z uwagi na natywną obsługę obrazów. Dla agentów AI i przepływów korporacyjnych wybór zależy od istniejącej infrastruktury, złożoności integracji i konsekwencji błędnych decyzji. OpenAI może oferować płynniejszą ścieżkę dla zespołów już używających jego ekosystemu, podczas gdy Jev zasługuje na rozważenie w obciążeniach tekstowych na dużą skalę. We wszystkich scenariuszach ostateczny wybór powinien opierać się na mierzonej dokładności, kalibracji prawdopodobieństw, latencji i całkowitym koszcie operacyjnym, a nie wyłącznie na nagłówkowych cenach.
How Should You Benchmark OpenAI Decisions API Against Jev?
Uruchom obie usługi na tych samych oznakowanych danych rzeczywistych, z dopasowanymi definicjami pytań i regionami klienta. Śledź accuracy, macro F1, ECE, Brier score, latencję p50/p95/p99, timeouty, odmowy, wskaźnik przeglądu oraz koszt w dolarach na poprawną zaakceptowaną decyzję.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | Jakość etykiet |
| Calibration | ECE, Brier score | Niezawodność prawdopodobieństw |
| Latency | p50 / p95 / p99 | Responsywność operacyjna |
| Reliability | 429 / timeout / refusal rate | Zachowanie w produkcji |
| Economics | Cost per accepted correct decision | Rzeczywisty koszt operacyjny |
Sugerowana procedura: zbuduj reprezentatywny, oznakowany zestaw; uwzględnij przypadki niejednoznaczne i spoza dystrybucji; wysyłaj semantycznie identyczne zadania; powtarzaj żądania wystarczająco, by mierzyć wariancję; kalibruj progi każdego systemu niezależnie; i porównuj koszt end-to-end, w tym eskalacje i ponowienia.
Conclusion
Wybierz OpenAI Decisions API, gdy decyzja zależy od dowodów obrazowych lub gdy istniejąca integracja z OpenAI redukuje nakład wdrożeniowy. Oceń Jev dla obciążeń decyzyjnych wyłącznie tekstowych, gdzie jego niższa publikowana stawka za token wejściowy może obniżyć wydatki na wnioskowanie. Mierz jakość etykiet, kalibrację, latencję ogonową i obciążenie przeglądu na tych samych danych aplikacji przed wyborem.
Jev ma niższą publikowaną bazową stawkę za token wejściowy; OpenAI Decisions API ma natywne wejście obrazów. Cytowane dane dostawców nie przesądzają o ogólnym zwycięzcy pod względem dokładności lub szybkości. Najlepszy wybór zależy od kosztu i jakości zaakceptowanych decyzji w kompletnym przepływie pracy.
Programiści mogą użyć GPT-6 Luna API w CometAPI, aby prototypować lekką klasyfikację w szerszym wielomodelowym workflow. Połączona strona modelu zawiera przykład Responses API. Dostęp do tego endpointu generatywnego nie przesądza o wsparciu dedykowanego endpointu /v1/decisions. To konwencjonalny prototyp generowania tekstu. Nie zwraca natywnego schematu odpowiedzi Decisions ani skalibrowanego rozkładu prawdopodobieństw klas. Zwaliduj zwróconą etykietę względem dozwolonych kategorii i obsłuż błędy API przed podłączeniem do działań downstream. Oddzielnie potwierdź natywne wsparcie /v1/decisions, jeśli ten endpoint jest wymagany.