TL;DR: Alibaba udostępniło Qwen4-Max 16 listopada 2026 r. jako flagowy model generacji Qwen4. Oficjalne oceny raportują lepszą wydajność w zadaniach branżowych i niższe koszty wykonania niż Qwen3.8-Max, co odzwierciedla poprawę efektywności tokenów oraz obniżone ceny API.
Najważniejsze informacje
- Wielkość modelu: Qwen4-Max ma 2,4 biliona parametrów bazowych, z 71 miliardami aktywowanymi na token.
- Okno kontekstu: Qwen4-Max obsługuje okno kontekstu o wielkości jednego miliona tokenów.
- Obsługa multimodalna: Qwen4-Max przyjmuje tekst, obrazy i wideo oraz generuje tekst.
- Funkcje dla deweloperów: Qwen4-Max obsługuje wywoływanie funkcji, strukturyzowane wyjścia, buforowanie kontekstu oraz wyszukiwanie w sieci.
- Opcje dostępu: Użytkownicy mogą uzyskać dostęp do Qwen4-Max poprzez obsługiwane aplikacje Qwen, rozliczane według użycia API QwenCloud oraz subskrypcje Token Plan.
Czym jest Qwen4-Max?
W oficjalnym ogłoszeniu Alibaba, Qwen opisuje Qwen4-Max jako „współpracownika AI” do pracy, tworzenia i eksploracji. Jego możliwości koncentrują się na rozumieniu celów, obsłudze narzędzi, reagowaniu na informację zwrotną z wykonania oraz dostarczaniu rezultatów w wielu etapach.
W tych przepływach pracy model zapewnia rozumowanie i koordynację. Operacje wykonują połączone aplikacje, narzędzia i środowiska uruchomieniowe.
Specyfikacja Qwen4-Max
Oficjalna strona modelu QwenCloud podaje następujące specyfikacje:
| Specyfikacja | Qwen4-Max |
|---|---|
| ID modelu | qwen4-max |
| Parametry bazowe | 2,4 biliona |
| Aktywowane parametry na token | 71 miliardów |
| Okno kontekstu | 1 milion tokenów |
| Wejście / wyjście | Tekst, obrazy i wideo / Tekst |
| Limity trybu standardowego | Maksymalne wejście: 991K; maksymalne wyjście: 131K tokenów |
| Limity trybu myślenia | Maksymalne wejście: 983K; maksymalne wyjście: 262K tokenów |
| Maksymalna długość rozumowania | 262K tokenów |
| Możliwości dla deweloperów | Wywoływanie funkcji, strukturyzowane wyjścia, buforowanie kontekstu oraz wyszukiwanie w sieci |
| Kompatybilność API | Protokoły API OpenAI i Anthropic |
Rozmiar kontekstu, limity wejścia i limity wyjścia reprezentują różne ograniczenia. Aplikacje muszą spełnić je łącznie i zarezerwować wystarczającą pojemność na generowane odpowiedzi oraz rozumowanie.
Jakie są główne funkcje Qwen4-Max?
Możliwości Qwen4-Max są szczególnie istotne, gdy zadanie obejmuje wiele dokumentów, narzędzi i kroków wykonania. Długie okno kontekstu zachowuje tło robocze, rozumienie wizualne poszerza dostępne dowody, a możliwości agenta pomagają przesunąć zadanie w kierunku realizacji.
Okno kontekstu o wielkości miliona tokenów i natywne rozumienie wizualne
Duże okno kontekstu pozwala przetwarzać powiązane materiały w ramach wspólnego kontekstu roboczego. Praktyczne zastosowania obejmują porównywanie umów, analizę zależności w plikach kodu oraz przegląd raportów wraz z dokumentami wspierającymi.
Natywne rozumienie wizualne rozszerza to na zrzuty ekranu, diagramy, skanowane strony i wideo. Użytkownik może dostarczyć rysunek techniczny lub zrzut interfejsu i poprosić model o interpretację w zestawieniu z pisemnymi wymaganiami.
W zadaniach obfitujących w dokumenty zachowanie nazw plików, dat i etykiet sekcji pomaga zorganizować materiał dowodowy i ułatwia weryfikację wynikowej analizy.
Kodowanie i profesjonalna obsługa narzędzi
Qwen4-Max obsługuje wywoływanie funkcji, co pozwala deweloperom łączyć go z bazami danych, usługami wyszukiwania, operacjami na plikach i systemami biznesowymi. Strukturyzowane wyjścia ułatwiają przekazywanie wyników modelu do kolejnych procesów oprogramowania.
Oficjalne demonstracje pokazują szersze przepływy pracy w oprogramowaniu. W tworzeniu gier model korzysta z silników takich jak Unity, Unreal Engine i Godot, aby budować sceny, implementować rozgrywkę i dopracowywać wyniki poprzez testy. W Blenderze koordynuje geometrię, materiały, oświetlenie i renderowanie.
Odtworzenie tych przepływów pracy wymaga odpowiedniego oprogramowania, zasobów i uprawnień do wykonania. Demonstracje pokazują, co model może osiągnąć w tych środowiskach.
Agenci długiego horyzontu i Live Delivery
Długie zadania stają się trudne do zarządzania, gdy użytkownicy nie mogą przeglądać postępów aż do zakończenia. Podejście Live Delivery w Qwen4-Max wprowadza wstępny użyteczny wynik, po którym następują kolejne aktualizacje.
W zadaniu badawczym agent może najpierw dostarczyć wstępne ustalenia i listę źródeł, a następnie rozszerzyć analizę i dodać wykresy. Użytkownicy mogą przeglądać każdą wersję i kierunkować dalszą pracę.
Qwen udostępnił także Qwen-Live-Delivery-Plugin. W przepływach pracy trwających godziny lub dłużej etapowe dostarczanie tworzy praktyczne punkty kontrolne do przeglądu jakości i korekty kierunku.
Architektura i efektywność tokenów
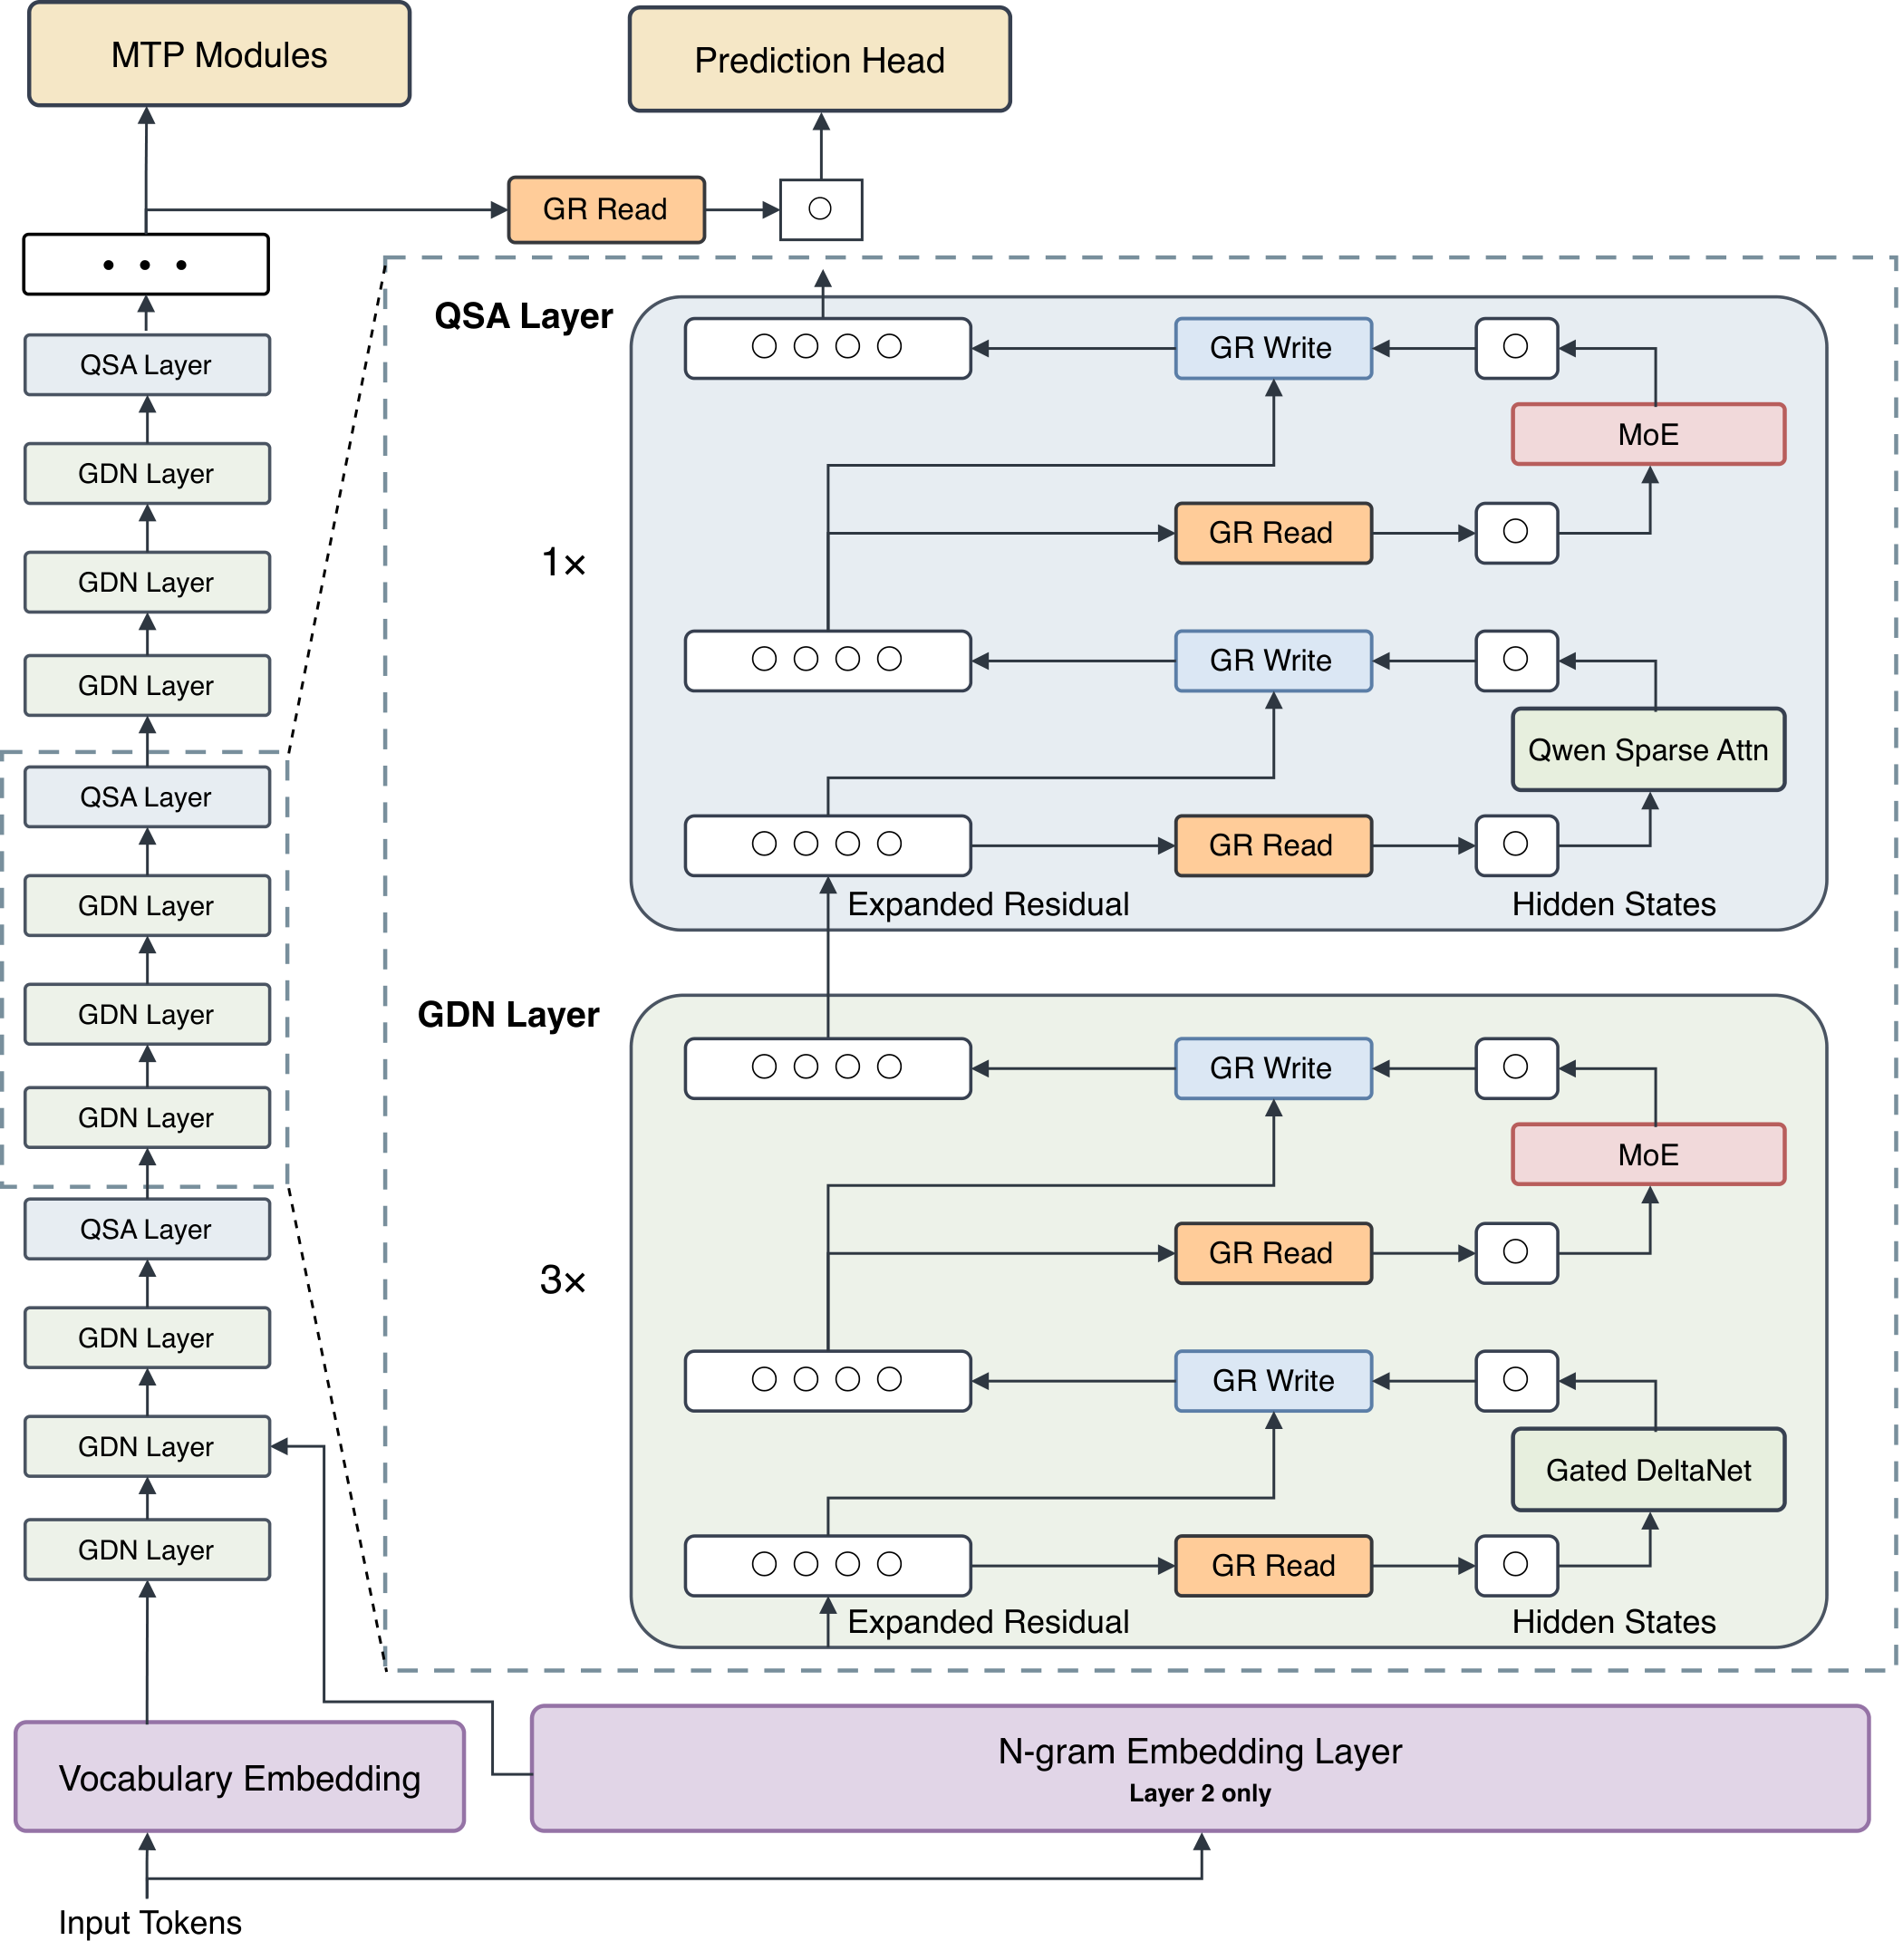
Qwen4-Max wprowadza kilka zmian w swojej rzadkiej architekturze mixture-of-experts:
- Gated DeltaNet i Qwen Sparse Attention: Łączą kompresję informacji historycznych z wybiórczą uwagą na istotny kontekst, ograniczając obliczenia dla długich sekwencji.
- Gated Residual: Używa czterech równoległych gałęzi rezydualnych i dynamicznych bramek, aby poprawić transfer informacji i stabilność treningu.
- N-gram Embedding: Dodaje 328 miliardów parametrów osadzeń n-gramowych do reprezentacji lokalnych wzorców tokenów poprzez operacje wyszukiwania (lookup), zwiększając pojemność przy relatywnie niewielkim dodatkowym koszcie obliczeniowym.
Dla użytkowników praktycznym testem jest to, czy te zmiany zmniejszają zasoby potrzebne do dostarczenia akceptowalnego wyniku. Opublikowane przez Qwen pomiary zużycia tokenów dostarczają dowodów na poprawę w ocenianych zadaniach.
Jak wypada Qwen4-Max? Oficjalne benchmarki i przykłady
Opublikowane benchmarki Qwen mierzą wydajność zadań, zużycie tokenów i koszty wykonania, a demonstracje ilustrują praktyczne przepływy pracy.
Wyniki benchmarków Qwen4-Max
Poniższe wyniki porównują Qwen4-Max z Qwen3.8-Max:
| Metryka | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Wynik Work360 | Wzrost z 47.74 do 52.69 |
| Zużycie tokenów w Work360 | Zmniejszone o około 24% przy Xhigh i 35% przy High |
| Zużycie tokenów w Terminal-Bench 4.0 | Zmniejszone o około 48% przy Xhigh i 49% przy High |
| Średni koszt zadania Work360 | Spadł z RMB 26.58 do RMB 11.16, około 58% mniej |
Spadek kosztów odzwierciedla zarówno niższe zużycie tokenów, jak i zrewidowane ceny API.
W aplikacjach, które wielokrotnie wywołują narzędzia, bardziej użyteczne jest porównanie kosztu na pomyślnie ukończone zadanie niż samych cen tokenów. Taniej wycenione żądanie przyniesie ograniczone oszczędności, jeśli przepływ pracy wymaga licznych ponownych prób lub ręcznych korekt.
Przykłady w badaniach finansowych i wytwarzaniu
Kilka oficjalnych przykładów dostarcza konkretne rezultaty i mierzalne wyniki.
W badaniach finansowych model łączy narzędzia danych rynkowych i wyszukiwanie, aby tworzyć robocze arkusze Excel i edytowalne raporty PowerPoint. Linki do źródeł i dopasowane wykresy pozwalają recenzentom prześledzić wnioski raportu do danych wspierających.
W przykładzie z wytwarzania model łączy parametryczne modelowanie, generowanie ścieżek narzędzi i informację zwrotną z symulacji. Zgłoszony nakład pracy człowieka na zaprogramowanie jednego detalu spadł z około 475 minut do 24 minut. Ten wynik dotyczy pokazanego detalu i środowiska narzędziowego i stanowi użyteczny punkt wyjścia do oceny podobnych procesów.
Jak interpretować wyniki
Wynik Work360 Qwen4-Max wzrósł z 47.74 do 52.69, o 4.95 punktu. Wskazuje to na silniejszą wydajność w ocenianych zadaniach branżowych, choć wyniki poszczególnych zadań mogą się różnić. Redukcje zużycia tokenów stanowią odrębny miernik efektywności, z różnymi oszczędnościami przy ustawieniach rozumowania High i Xhigh.
Zgłoszona 58% redukcja średniego kosztu zadania Work360 łączy niższe zużycie tokenów ze zrewidowanymi cenami API. Dla deweloperów istotne jest, czy te oszczędności przenoszą się na pomyślnie ukończone zadanie po uwzględnieniu ponownych prób i ręcznych korekt.
Demonstracje aplikacji dostarczają dowodów dotyczących konkretnych przepływów pracy i rezultatów. Wykorzystaj je do wskazania zadań wartych przetestowania, a następnie porównuj jakość ukończenia, nakład przeglądu i łączny koszt w spójnych warunkach narzędziowych.
Cennik Qwen4-Max: koszty API i opcje Token Plan
Qwen4-Max jest dostępny w modelu rozliczania API według użycia oraz w subskrypcjach Token Plan. Odpowiednia opcja zależy od tego, czy tworzysz aplikację, czy korzystasz z interaktywnego narzędzia AI.
Oficjalne ceny API rozliczanego według użycia
QwenCloud podaje następujące ceny dla regionu Singapur:
| Pozycja rozliczeniowa | Cena za 1 milion tokenów |
|---|---|
| Wejście standardowe | $1.50 |
| Wyjście | $4.50 |
| Wejście z pamięci podręcznej (implicit) | $0.075 |
| Odczyt pamięci podręcznej (explicit) | $0.075 |
Utworzenie pamięci podręcznej explicit kosztuje $1.875 za milion tokenów dla pamięci pięciominutowej i $3.00 dla godzinnej.
Zadanie wykorzystujące 100,000 niebuforowanych tokenów wejściowych i 10,000 rozliczanych tokenów wyjściowych kosztuje $0.195 w opłatach za tokeny modelu, z wyłączeniem dodatkowych płatnych narzędzi lub usług.
Wejście z pamięci podręcznej jest wycenione o 95% niżej niż wejście standardowe. Aplikacje, które wielokrotnie wysyłają te same instrukcje, definicje narzędzi lub prefiksy dokumentów, mogą obniżyć koszty wejścia poprzez lepsze wykorzystanie pamięci podręcznej.
Jak działa Token Plan
Token Plan wykorzystuje rozliczanie subskrypcyjne i odliczanie Credits. Obecnie na liście obsługiwanych modeli widnieje qwen4-max.
Na dzień 17 listopada 2026 r. strona dla regionu Singapur prezentuje następujące indywidualne plany miesięczne:
| Plan | Cena miesięczna | Miesięczne Credits |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
Strona reklamuje również promocję dla nowych użytkowników od $3. Uprawnienia i ostateczna kwota są widoczne podczas finalizacji zakupu.
Credits to jednostki rozliczeniowe subskrypcji, a nie bezpośrednia pula tokenów. Zużycie zależy od obowiązującego modelu i zasad narzędzi.
Zgodnie z dokumentacją Token Plan usługa jest przeznaczona do interaktywnego użytku w kompatybilnych narzędziach AI i jest obecnie dostępna w regionie Singapur.
Jak uzyskać dostęp do Qwen4-Max
Istnieją trzy praktyczne drogi: korzystanie z produktu Qwen, bezpośrednie połączenie przez QwenCloud lub konfiguracja kompatybilnego narzędzia AI. Każda ma inne wymagania konfiguracyjne, zwłaszcza dotyczące poświadczeń i punktów końcowych.
Korzystaj z aplikacji Qwen
W oficjalnym ogłoszeniu jako kanały dostępu wymieniono Qwen Studio, aplikację Qwen, QwenWork i Qoder.
Produkty te stanowią wygodny punkt wyjścia do testowania analizy dokumentów, asysty w kodowaniu i przepływów biurowych. Deweloperzy, którzy muszą kontrolować żądania, narzędzia i obsługę wyników, mogą przejść do bezpośredniej integracji z API.
Dostęp do API QwenCloud
Aby uzyskać dostęp do Qwen4-Max, zaloguj się do QwenCloud, uzyskaj klucz API dla wybranego regionu i skonfiguruj odpowiedni punkt końcowy z identyfikatorem modelu qwen4-max. QwenCloud zapewnia dostęp kompatybilny z OpenAI. Użytkownicy migrujący z wersji podglądowej powinni również przejrzeć parametry żądań i konfigurację rozliczeń.
Skonfiguruj narzędzia do kodowania i agentów
Dokumentacja Token Plan dostarcza wskazówek integracyjnych dla narzędzi, w tym Qwen Code, Cline, Cursor i OpenCode.
Konfiguracja zazwyczaj wymaga dedykowanego klucza API, odpowiedniego Base URL i nazwy modelu. Token Plan korzysta z odrębnej domeny punktu końcowego token-plan.maas.qwencloudapi.com, a jego kluczy nie można wymieniać z kluczami API rozliczanymi według użycia.
Postępuj zgodnie z przewodnikiem dla wybranego narzędzia, a następnie zweryfikuj konfigurację zadaniem obejmującym odczyt materiału, wykonanie operacji i sprawdzenie wyniku.
Kto powinien używać Qwen4-Max?
Warto ocenić Qwen4-Max, gdy powtarzalny przepływ pracy wymaga szerokiego kontekstu, wielu narzędzi i weryfikowalnego rezultatu.
- Deweloperzy mogą ocenić Qwen4-Max pod kątem zmian kodu w wielu plikach, tworzenia frontendu i agentów korzystających z zewnętrznych narzędzi.
- Zespoły biurowe i badawcze mogą używać go do analizy dokumentów, organizowania danych i przygotowywania raportów ze źródłami możliwymi do prześledzenia.
- Zespoły projektowe i treściowe mogą testować go w modelowaniu 3D, prototypach gier i przepływach wideo połączonych z profesjonalnym oprogramowaniem.
- Zespoły przedsiębiorstw mogą oceniać powtarzalne procesy z określonym dostępem do danych, interfejsami narzędzi i kryteriami akceptacji.
W przepływach finansowych, prawnych i medycznych używaj go do przetwarzania dowodów i wsparcia analitycznego, z kwalifikowanymi specjalistami przeglądającymi wnioski o poważnych konsekwencjach.
FAQ
Czy limit wyjścia Qwen4-Max to jeden milion tokenów?
Nie. Okno kontekstu i maksymalna długość wyjścia to oddzielne limity. QwenCloud podaje maksymalne wyjścia 131K tokenów w trybie standardowym i 262K tokenów w trybie myślenia. Żądania muszą również spełniać odpowiednie limity wejścia i kontekstu.
Wybrać API Qwen4-Max czy Token Plan?
Wybierz API rozliczane według użycia, gdy integrujesz Qwen4-Max z aplikacją lub usługą backendową. Token Plan jest przeznaczony do interaktywnego użytku w kompatybilnych narzędziach AI i używa subskrypcyjnych Credits. Obie opcje wymagają oddzielnych poświadczeń i punktów końcowych.
Czy mogę korzystać z Qwen4-Max za darmo?
Oficjalny dostęp do API i Token Plan to usługi płatne. Darmowy dostęp przez aplikacje Qwen, gdzie jest oferowany, podlega zasadom konta i użytkowania każdego produktu; nie stanowi darmowego limitu API.
Czy mogę pobrać Qwen4-Max do lokalnego wdrożenia?
Na dzień 17 listopada 2026 r. Qwen nie udostępnił otwartych wag dla Qwen4-Max, więc oficjalne wydanie nie oferuje możliwego do pobrania modelu do lokalnego wdrożenia. Qwen ogłosił plany stopniowego udostępniania jako open source mniejszych modeli z serii Qwen4.
Wnioski
Qwen4-Max to mocny kandydat do analizy długich dokumentów, złożonego kodowania i przepływów pracy obejmujących wiele narzędzi. Oficjalne oceny pokazują wyższe wyniki i niższe koszty zadań niż Qwen3.8-Max w raportowanych obciążeniach.
Zacznij od reprezentatywnego zadania, które ma już jasne kryteria akceptacji. Porównaj jakość wyjścia, czas ręcznych korekt, czas wykonania i łączny koszt. Usprawnienia w tych obszarach stanowią praktyczną podstawę do rozszerzenia użycia Qwen4-Max na podobne przepływy pracy.