
TL;DR
Claude Haiku 5.5 to najszybszy mały model Anthropic w trybie standardowym do zadań o dużej skali i wrażliwych na opóźnienia. Łączy okno kontekstu 1 miliona tokenów, standardowy limit wyjścia 128K, adaptacyjne rozumowanie oraz bazowe stawki zaczynające się od $0.10 za milion tokenów wejściowych i $0.50 za milion tokenów wyjściowych. Stawki rosną, gdy prompt przekracza 100,000 tokenów. Do złożonego kodowania i dłuższej pracy agentowej lepszym wyborem pozostają Sonnet 5.5 i Opus 5.5. Cennik CometAPI Standard jest o 20% niższy od oficjalnych stawek, zaczynając od $0.08 za milion tokenów wejściowych i $0.40 za milion tokenów wyjściowych. Strona modelu CometAPI jest aktywna i informuje o produkcyjnym dostępie do API.
Key Takeaways
- Oficjalne wydanie: 7 października 2026; Claude API model ID: claude-haiku-5-5.
- Stawki startowe API: $0.10 za wejście i $0.50 za wyjście za milion tokenów dla promptów do 100K tokenów. CometAPI: $0.08 za wejście i $0.40 za wyjście za milion tokenów przy 80% oficjalnej ceny Standard.
- Kontekst i wyjście: 1M tokenów kontekstu i 128K tokenów standardowego wyjścia.
- Fokus: klasyfikacja, ekstrakcja dokumentów, routing, wsparcie oraz delegowane zadania agentowe.
- Nowszy tokenizator może zliczać około 30% więcej tokenów dla tego samego tekstu; oceniaj koszt na zaakceptowane zadanie, a nie tylko cenę za token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 to lekki członek obecnej rodziny Claude, opracowany do obsługi dużych wolumenów żądań, gdzie kluczowe są responsywność i ekonomika operacyjna. Jego główne zastosowania obejmują przetwarzanie dokumentów, wsparcie konwersacyjne, ekstrakcję informacji i kompaktowe zadania subagentów. Anthropic w swoim przeglądzie modelu potwierdza datę premiery, możliwości i identyfikatory na platformie.
Claude Haiku 5.5 to pierwszy model Haiku obsługujący konfigurowalne poziomy effort, umożliwiające deweloperom wymianę głębokości rozumowania, latencji i zużycia tokenów w obrębie tego samego modelu.
What Are the Key Features of Claude Haiku 5.5?
Adaptacyjne myślenie i regulowany effort
Haiku 5.5 potrafi decydować, kiedy i jak intensywnie rozumować, a parametr effort daje deweloperom możliwość zbalansowania jakości odpowiedzi, latencji i zużycia tokenów. Domyślny effort to medium. Dla prostej klasyfikacji preferowany może być niski effort; dla niejednoznacznej ekstrakcji lub kroków planowania narzędzi wyższe ustawienie może być uzasadnione.
Przetwarzanie dużych kontekstów
Okno kontekstu 1M tokenów umożliwia ujęcie długich dokumentów i obszernych historii rozmów w jednym żądaniu. Deweloperzy nadal powinni stosować wyszukiwanie, przycinanie i cache’owanie tam, gdzie to właściwe: długie konteksty mogą niepotrzebnie zwiększać koszt i wprowadzać kompromisy dokładności, zwłaszcza powyżej progu cenowego 100K.
Niski koszt i wysokie tempo przetwarzania
Nowe stawki startowe $0.10/$0.50 czynią powtarzane krótkie żądania znacząco tańszymi niż w poprzedniej generacji Haiku w przeliczeniu na token. Jednocześnie Anthropic dokumentuje zmieniony tokenizator: identyczny tekst generuje około 30% więcej tokenów niż w Haiku 4.5. Rzeczywiste oszczędności na poziomie zadań mogą więc być mniejsze niż wynikałoby to z nagłówkowych obniżek stawek.
Obsługa komputera i delegowane zadania agentowe
Opublikowane ewaluacje wskazują na lepszą wydajność w zadaniach interakcji z komputerem i wspomaganych narzędziami niż w poprzednim modelu Haiku. Czyni to Haiku 5.5 przydatnym dla ograniczonych kroków agentów, lecz skuteczna automatyzacja wciąż zależy od silnych uprawnień narzędzi, odporności na błędy i akceptacji działań ryzykownych przez człowieka.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic raportuje wyraźne wzrosty w zadaniach wiedzy profesjonalnej, obsłudze komputera, kodowaniu i rozumowaniu. Poniższe wyniki używają zgłoszonych ustawień ewaluacji; wyników z różnych benchmarków nie należy łączyć w jeden „wynik inteligencji”.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, offline subset, partial credit | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, no tools | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, with tools | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, no tools | 6.4% | 46.4% | 61.6% |
Standardowa konfiguracja ewaluacyjna w system card dla Haiku 5.5 używa adaptacyjnego myślenia na max effort, domyślnego próbkowania i pięciu prób, chyba że zaznaczono inaczej; domyślne ustawienie produktu to medium, więc wyniki nagłówkowe nie są gwarancjami dla domyślnych ustawień. OSWorld używa 82 zadań offline, bez dostępu do internetu, 1080p i limitu 500 akcji. Wynik 72.4% to punktacja z częściowym kredytem; ścisły wskaźnik zaliczeń to 37.1%. GDPval-AA i AA-Briefcase są raportowane przez Anthropic z niezależnie przeprowadzonych ewaluacji Artificial Analysis.
Terminal-Bench 4.0 używa Claude Code w trybie --bare z włączonymi zabezpieczeniami. Haiku 5.5 używa max effort, bez modelu awaryjnego i bez wychodzącego dostępu do internetu, z 10 próbami na zadanie; Sonnet 5.5 używa pięciu prób i fallbacku dla niektórych oflagowanych żądań. Haiku 4.5 korzysta z ustalonego budżetu myślenia 63,999-token. Te różnice konfiguracyjne mają znaczenie przy interpretacji 39.2% wobec 70.6%.
Opublikowane wyniki benchmarków dostarczają podane powyżej wyniki. OSWorld korzysta z podzbioru offline; Humanity's Last Exam rozdziela uruchomienia z narzędziami i bez, a Chartography działa bez narzędzi. To wyniki zgłoszone przez dostawcę, a nie niezależne pomiary w uniwersalnej konfiguracji. Anthropic podaje szczegóły ewaluacji w system card Haiku 5.5; odtwórz odpowiednie ustawienia effort, narzędzi, scaffoldu i budżetu przed porównaniem własnych rezultatów. Podsumowanie premiery nie określa kompletnego wspólnego środowiska testowego dla każdego wiersza.
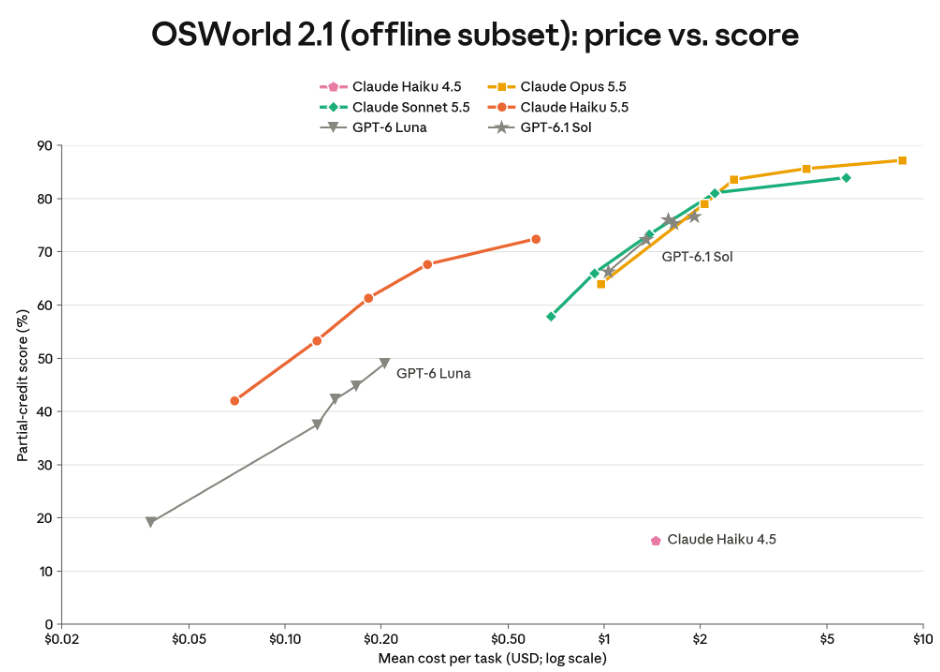
Oficjalna grafika ewaluacyjna Anthropic powyżej została odtworzona z system card. Dostarcza dodatkowych informacji o ocenianych konfiguracjach; nie jest to nowy benchmark przygotowany dla tego artykułu.
Benchmark Interpretation
Poprawa w OSWorld sugeruje, że Haiku 5.5 stał się znacząco bardziej użyteczny w ustrukturyzowanych zadaniach graficznych. Jednak 70.6% Sonnet 5.5 wobec 39.2% Haiku 5.5 w Terminal-Bench wskazuje na utrzymującą się przewagę większego modelu w agentowym kodowaniu. Wybieraj modele zgodnie z kosztem porażki i trudnością rzeczywistego workflow.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Wymiar | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Kontekst | 200K | 1M | 1M |
| Maks. standardowe wyjście | 64K | 128K | 128K |
| Standardowy input / MTok | $1 | $0.10 do 100K; $0.50 powyżej | $2 |
| Standardowy output / MTok | $5 | $0.50 do 100K; $2.50 powyżej | $10 |
| Rozumowanie | Rozszerzone myślenie z ustalonym budżetem tokenów | Adaptacyjne; domyślnie medium | Adaptacyjne; domyślnie high |
| Względna latencja | Szybka | Najszybsza w trybie standardowym | Szybka |
| Głębokość kodowania | Ograniczone zadania | Silniejsze subagenty | Bardziej złożone kodowanie |
| Typowe zastosowanie | Starsze wdrożenia małych modeli | Przepływy o dużej skali | Złożone przepływy produkcyjne |
Wspólne specyfikacje: wszystkie trzy modele przyjmują wejścia tekstowe i obrazowe oraz generują wyjścia tekstowe. Można je wywoływać przez Claude API i obsługiwane platformy partnerskie; identyfikatory modeli i dostęp do kont zależą od dostawcy. Przytoczona dokumentacja produktu nie określa liczby parametrów ani szczegółów architektury.
Haiku 5.5 to rozsądny pierwszy wybór do weryfikowalnych i powtarzalnych zadań. Sonnet 5.5 staje się atrakcyjniejszy tam, gdzie lepszy osąd ogranicza powtarzające się nieudane wywołania, ponowienia narzędzi lub korekty ludzkie. Opus 5.5 to opcja dla szczególnie wymagających, wieloetapowych zadań.
Porównanie latencji dotyczy trybów standardowej prędkości. Kwalifikacja szybkości firmy Anthropic wyklucza Opus Fast Mode z twierdzenia o najszybszym modelu. Szczegóły architektury, takie jak liczba parametrów, nie są ustalane przez te poziomy produktu. Wejście tekst+obraz z wyjściem tekstowym różni się od generowania obrazów.
Porównanie możliwości podąża za specyfikacjami modeli Anthropic. Dostęp do platformy zależy od wybranego dostawcy i konta; żaden poziom modelu nie implikuje opublikowanej liczby parametrów.
Workload Selection
| Obciążenie | Praktyczny domyślny wybór | Dlaczego |
|---|---|---|
| Klasyfikacja e‑maili | Haiku 5.5 | Krótkie, powtarzalne, weryfikowalne decyzje |
| Ekstrakcja pól z dokumentów | Haiku 5.5 | Kosztowo efektywne przetwarzanie strukturalne |
| Triage wsparcia | Haiku 5.5 | Szybkie odpowiedzi i eskalacja |
| Subagenty do kodowania | Haiku 5.5 | Tani przeszukiwacz plików i ograniczone edycje |
| Złożone debugowanie | Sonnet 5.5 | Lepsze wyniki w benchmarkach kodowania |
| Wieloetapowe rozumowanie wysokiej stawki | Opus 5.5 | Bardziej zdolny model z wyższej półki |
| Mieszane obciążenie | Haiku + Sonnet | Routing według złożoności i pewności |
How Much Does Claude Haiku 5.5 Cost?
Dlaczego Haiku 5.5 jest reklamowany jako „około 75% tańszy”, skoro cena za token spadła o 90%?
Wartość 90% opisuje redukcję stawek Standard za wejście i wyjście dla promptów do 100,000 tokenów; dłuższe prompty otrzymują 50% redukcję. Anthropic podaje, że Haiku 5.5 kosztuje średnio około 75% mniej w eksploatacji, uwzględniając rozkład długości żądań w poprzednim modelu i zmiany w liczbie tokenów na zadanie. Tokenizacja to jeden z czynników: ten sam tekst może zostać policzony jako około 30% więcej tokenów, więc szacunki kosztów powinny używać zliczeń wykonanych nowym modelem.
Oficjalne ceny Anthropic mają dwa pasma długości promptu. Stawki w pierwszej tabeli to oficjalne ceny w USD za milion tokenów; poniższe porównanie CometAPI stosuje 20% zniżki do oficjalnych stawek Standard za wejście i wyjście.
| Kategoria stawek | Prompt do 100K | Prompt powyżej 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| 5-minute cache write | $0.125 | $0.625 |
| 1-hour cache write | $0.20 | $1.00 |
| Cache read | $0.01 | $0.05 |
| Batch input (50% off) | $0.05 | $0.25 |
| Batch output (50% off) | $0.25 | $1.25 |
Oficjalne stawki Standard, cache i Batch pokazano powyżej, sprawdzone 8 października 2026 r. Długość promptu wybiera pasmo cenowe; wyższe pasmo dotyczy całego żądania, a nie tylko tokenów powyżej 100K. Stawki CometAPI Standard poniżej odpowiadają odpowiednim oficjalnym stawkom Standard pomnożonym przez 0.8. To porównanie nie zakłada, że zniżka bramki łączy się ze zniżkami Batch lub cache.
| Długość promptu | Kategoria tokenów | Official Standard / MTok | CometAPI / MTok |
|---|---|---|---|
| Do 100K tokenów | Input | $0.10 | $0.08 |
| Do 100K tokenów | Output | $0.50 | $0.40 |
| Powyżej 100K tokenów | Input | $0.50 | $0.40 |
| Powyżej 100K tokenów | Output | $2.50 | $2.00 |
Example: 100,000 short requests per month
Załóżmy, że każde żądanie zużywa 2,000 tokenów wejściowych i 500 tokenów wyjściowych; każde żądanie pozostaje poniżej progu 100K. Pomijamy cache promptów, narzędzia i ponowienia oraz dla ilustracji zakładamy identyczną liczbę tokenów w modelach.
| Model / provider | Input/miesiąc | Output/miesiąc | Suma/miesiąc |
|---|---|---|---|
| Haiku 4.5 — official Standard | $200 | $250 | $450 |
| Haiku 5.5 — official Standard | $20 | $25 | $45 |
| Sonnet 5.5 — official Standard | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
W tym przykładzie 100,000 żądań zużywa 200 milionów tokenów wejściowych i 50 milionów tokenów wyjściowych. Koszt wejścia w CometAPI to 200 × $0.08 = $16, a koszt wyjścia to 50 × $0.40 = $20, razem $36 miesięcznie wobec oficjalnych $45: oszczędność $9, czyli 20%. Scenariusz wyklucza cache, narzędzia i ponowienia oraz używa stałych liczników tokenów; mierz koszt na zaakceptowane zadanie na reprezentatywnych danych wejściowych, ponieważ nowszy tokenizator zmienia zliczenia tokenów.
Porównanie $450 do $45 to ilustracja stałej redukcji stawek o 90%, a nie obietnica 90% oszczędności dla równoważnych realnych obciążeń. W ogłoszeniu premiery Anthropic raportuje około 75% niższy średni koszt działania po uwzględnieniu długości żądań i zmian w użyciu tokenów. Ponownie policz reprezentatywne wejścia i mierz koszt ukończonego zadania, zanim oszacujesz własne oszczędności.
Where Can You Access Claude Haiku 5.5?
Official access and cloud platforms
Haiku 5.5 jest dostępny przez Claude API i obsługiwane platformy na Amazon Web Services, Google Cloud i Microsoft Azure, zgodnie z ogłoszeniem o dostępności firmy Anthropic. Bezpośredni identyfikator modelu w Claude API to claude-haiku-5-5; Amazon Bedrock używa anthropic.claude-haiku-5-5. Używaj danych uwierzytelniających wydanych przez wybranego dostawcę i sprawdzaj jego bieżące wymagania dotyczące dostępu do konta.
Third-party access through CometAPI
Strona modelu CometAPI wymienia claude-haiku-5-5 jako dostępny, ze stawkami Standard zaczynającymi się od $0.08 za milion tokenów wejściowych i $0.40 za milion tokenów wyjściowych dla promptów do 100K, czyli 20% poniżej odpowiednich oficjalnych stawek. Użyj klucza wydanego przez CometAPI z endpointem i formatem żądania CometAPI; to oddzielna ścieżka dostępu od bezpośredniego dostępu do Anthropic API. Sprawdź stronę live pod kątem dostępności, pasm cenowych i szczegółów integracji.
Przy zmianie dostawców lub aktualizacji z Haiku 4.5, zweryfikuj identyfikatory modeli, ponownie policz tokeny oraz przetestuj limity odpowiedzi i obsługę konwersacji. Szczegóły wdrożenia i zmiany niezgodne wstecz znajdziesz w przewodniku migracyjnym Anthropic.
Migration Validation
- Zaktualizuj identyfikator modelu i zweryfikuj pola żądania specyficzne dla endpointu.
- Ponownie policz tokeny z aktualnym tokenizatorem, w tym stabilne prefiksy i definicje narzędzi.
- Przetestuj ustawienia adaptacyjnego myślenia, rozkłady latencji i parsowanie bloków odpowiedzi.
- Sprawdź wywołania narzędzi, procedury odzyskiwania po błędach i wszelkie ograniczenia kont dotyczące przechowywanych bloków thinking.
- Porównaj p50/p95 latencję, odsetek zaakceptowanych zadań i łączną liczbę rozliczanych tokenów.
- Stosuj stopniowe wdrażanie i ścieżkę wycofania dla krytycznych biznesowo workflow.
- Wstępne wypełnianie asystenta jest zabronione
Przewodnik migracyjny Haiku 5.5 wyjaśnia zachowanie tokenizatora, identyfikatory i zgodność żądań. Pomiń temperature, top_p i top_k. Jeśli zostaną podane explicite, temperature musi wynosić 1, a top_p 0.99; dowolna wartość top_k lub podanie jednocześnie temperature i top_p skutkuje błędem 400.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 nie jest uniwersalnym substytutem większych modeli. Złożone kodowanie i rozumowanie o długim horyzoncie pozostają istotnymi wyróżnikami Sonnet i Opus. Dłuższe prompty również kosztują więcej, więc okno 1M tokenów należy stosować selektywnie. Adaptacyjne rozumowanie wprowadza zmienność liczby generowanych tokenów i latencji; benchmarki nie ustanawiają gwarancji dla pojedynczego workflow biznesowego.
Automatyzacja wrażliwa na ryzyko powinna walidować strukturalne wyniki, ograniczać uprawnienia narzędzi zewnętrznych, prowadzić dzienniki audytu i wymagać przeglądu przed działaniami o konsekwencjach. Kieruj niepewne zadania do silniejszych modeli zamiast polegać wyłącznie na niższej bazowej cenie tokenu w Haiku.
Conclusion
Dla przetwarzania o dużej skali z mierzalnymi kryteriami akceptacji, Claude Haiku 5.5 to atrakcyjna aktualizacja: niższe ceny wejścia, większy kontekst, adaptacyjne rozumowanie i lepsze opublikowane ewaluacje. Do złożonego programowania i niejednoznacznego podejmowania decyzji Sonnet 5.5 lub Opus 5.5 mogą przynieść lepszą ekonomię całości, zmniejszając liczbę ponowień i korekt. Wygrywająca strategia to benchmarkowanie całego workflow i routing żądań według trudności.
FAQ
Jak granica cenowa 100K w Haiku 5.5 wpływa na workflow z cache?
Długość promptu określa, które pasmo stawek ma zastosowanie; nie szacuj opłaty tylko na podstawie nowego tekstu ani nie zakładaj, że tylko nadwyżkowe tokeny korzystają z wyższej stawki. Policz całe żądanie dla wybranego modelu, wliczając historię i definicje narzędzi, a następnie uzgodnij użycie wejścia, zapisu do cache, odczytu z cache i wyjścia z odpowiednim pasmem. Porównaj faktury na reprezentatywnych żądaniach z cache przed ustaleniem budżetu produkcyjnego.
Czy bloki thinking Haiku 5.5 można odtwarzać między kontami?
Działają tylko na koncie, które je utworzyło, lub na z nim powiązanym. Jeśli niepowiązane konto wyśle przechowany blok thinking, API odrzuci go, zanim model go zobaczy; żądanie wciąż może się powieść bez tego rozumowania. Zobacz oficjalny przewodnik migracyjny. Zachowaj bloki rozmowy i używaj konta źródłowego lub powiązanego przy kontynuacji workflow z narzędziami. Zmianę bramki lub konta należy przetestować wprost; zgodność nazwy modelu nie gwarantuje, że przechowane bloki thinking pozostaną użyteczne.
Dlaczego Haiku 5.5 może uciąć odpowiedź, którą Haiku 4.5 kończył?
Nowszy tokenizator może zliczać więcej tokenów dla tego samego tekstu, więc niezmieniony limit max_tokens może utrzymać mniej równoważnego wyjścia. Adaptacyjne myślenie może też zużywać budżet wyjścia. Sprawdź stop_reason i usage, przelicz prompty nowym modelem i dostrój limity wyjścia na realnych zadaniach, zamiast kopiować ustawienia z poprzednika.
Jak dobierać progi routingu w Haiku 5.5?
Użyj oznakowanej próbki z rzeczywistego obciążenia, aby zmierzyć odsetek zaakceptowanych zadań, koszt korekt i latencję. Kieruj żądania, które nie przechodzą jawnej walidacji lub wykraczają poza przetestowany zakres zadania, do silniejszego modelu. Strojenie progu oprzyj na łącznym koszcie workflow, w tym ponowieniach i eskalacji, i monitoruj go po zmianach w promptach, narzędziach lub effort.