Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Gemini 4 Carbon to model graniczny Google DeepMind do wymagającej inżynierii i defensywnego cyberbezpieczeństwa. Ogłoszony October 28, 2026, poprawia wyniki Argon w opublikowanych ewaluacjach kodowania, bezpieczeństwa i długiego kontekstu. Ceny wstępne to $2 za milion tokenów wejściowych i $10 za milion tokenów wyjściowych, ale dostęp jest początkowo ograniczony do wybranych obrońców cyberbezpieczeństwa i zaufanych partnerów. Dla deweloperów szansą jest silniejsza autonomia pracy; bieżącym ograniczeniem — dostęp.
Key Takeaways
Gemini 4 Carbon to kolejny po Argon model graniczny Google, zoptymalizowany pod kątem wielodniowej, agentowej inżynierii i obrony w cyberbezpieczeństwie.
Gemini 4 Carbon zajmuje #1 miejsce w Artificial Analysis Intelligence Index v5.0 (wynik 59), wyprzedzając Claude Opus 5.5 (58) i GPT-6 Astra (57). Znaczne zyski w kodowaniu, pełnym stosie web (+89 Elo w WebDev Arena do #4), rozumowaniu naukowym, zrozumieniu multimodalnym i alignment (0.0% skuteczności na Gray Swan Indirect Prompt Injection Benchmark).
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
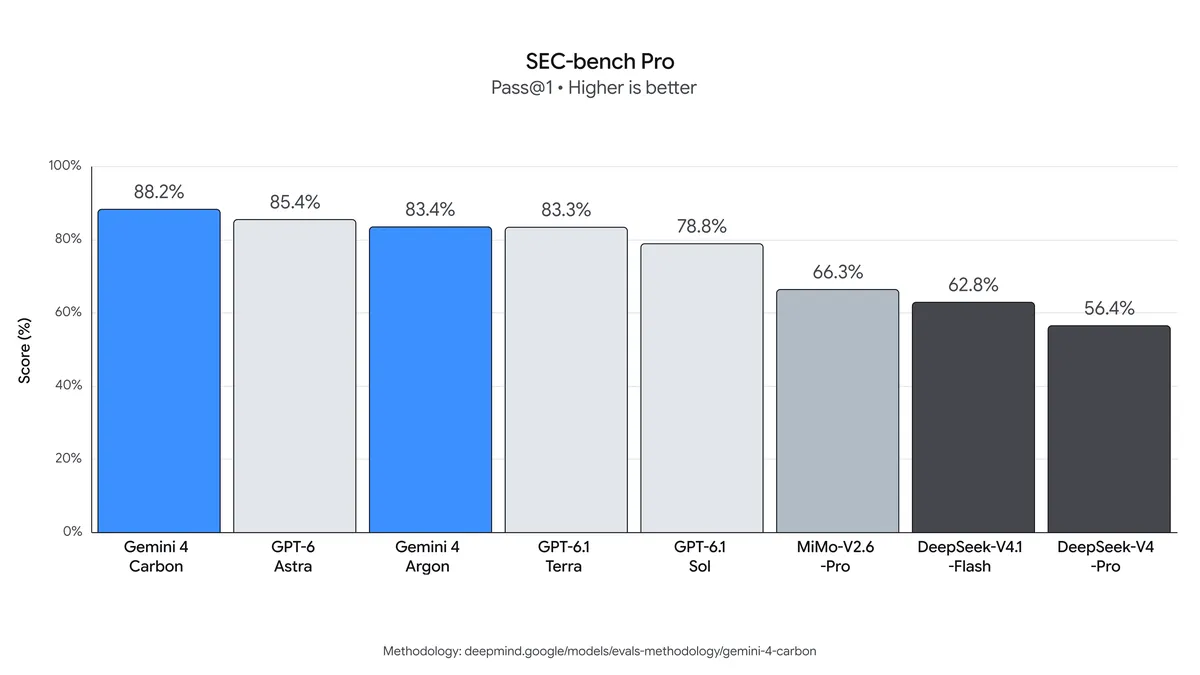
Wybitne wyniki w bezpieczeństwie (bez bezpieczników): 88.2% na SEC-bench Pro (wyszukiwanie podatności), 54.8% na ExploitGym (eksploatacja) i 71.0% na CWE-bench (łatki).
Ograniczony początkowy dostęp przez Fairwind Program dla zespołów obrony; publiczne API i szersze wdrożenie później.
Te same ceny wstępne co Argon; po okresie wstępnym obowiązywać będą stawki standardowe.
Platformy takie jak CometAPI już obsługują szerszą rodzinę Gemini (w tym Argon) przez zunifikowane API kompatybilne z OpenAI, co ułatwia przełączanie modeli i przygotowanie do szerszego wydania Carbon. Szczegóły publicznego API i szeroka data wydania pozostają nieogłoszone na October 29, 2026.
What Is Gemini 4 Carbon?
Gemini 4 Carbon to najnowszy flagowy model graniczny Google, zaprojektowany do złożonej inżynierii oprogramowania, badań w cyberbezpieczeństwie i autonomicznych przepływów pracy.
Według oficjalnego ogłoszenia Carbon rozwija fundamenty ustanowione przez Gemini 4 Argon, z istotnymi ulepszeniami w kodowaniu, agentowym rozumowaniu i zadaniach ukierunkowanych na bezpieczeństwo.
Carbon jest zaprojektowany do pracy obejmującej dochodzenie, wykonanie i weryfikację w wielu krokach. Defensywny agent inżynieryjny może przejrzeć repozytorium, potwierdzić podejrzaną podatność w izolowanym środowisku, opracować łatkę i przetestować, czy zmiana usuwa pierwotną usterkę.
Google raportuje, że ich wewnętrzne zespoły obserwowały, jak Carbon realizuje złożone zadania inżynieryjne przez wiele dni. To obserwacje wewnętrzne, a nie opublikowana gwarancja konkretnego autonomicznego czasu działania. Google nie opublikowało pełnego raportu technicznego, liczby parametrów ani szczegółów architektury. Oczekuje się, że okno kontekstu i limity wyjścia będą podobne do tych w Argon lub lepsze (raportowane w zakresie wielu milionów tokenów z dużą pojemnością wyjścia), a model obsługuje wejścia multimodalne, w tym tekst, obrazy, wideo, audio i PDF.
What Are the Key Features of Gemini 4 Carbon?
Long-Horizon Software Engineering
Carbon jest zaprojektowany z myślą o problemach inżynieryjnych, których nie da się wiarygodnie rozwiązać w pojedynczym kroku rozumowania.
Przykłady obejmują analizę przyczyny źródłowej w dużych repozytoriach, błędy zależności, debugowanie systemów niskopoziomowych i złożone refaktoryzacje.
Ulepszenia dotyczą zdolności kontynuowania pracy po nieudanej próbie.
Skuteczny agent kodujący musi rozpoznać, kiedy pierwsze rozwiązanie zawodzi, przeanalizować nowe dowody i skorygować podejście bez odchodzenia od oryginalnego zadania.
Defensive Cybersecurity Workflows
Wyniki Carbon w bezpieczeństwie obejmują znajdowanie podatności, weryfikację możliwości eksploatacji i łatanie błędów. Przydatnym pytaniem dla zespołu bezpieczeństwa jest, czy agent potrafi przejść od podejrzanego problemu do odtwarzalnego znaleziska i przetestowanej poprawki, respektując nadane mu uprawnienia i środowisko.
Long-Context and Multimodal Understanding
Carbon osiąga wynik GraphWalks BFS F1 na poziomie 96.2% w podzbiorze 256K–1M tokenów, w porównaniu do 84.2% w Argon. To dowód na zdolność do rozumowania na długim kontekście grafów, a nie gwarancja poprawnego pobierania informacji z dowolnego dokumentu o milionie tokenów.
Opublikowane wyniki Chartography i Blueprint-Bench 2 obejmują także rozumienie wizualne. Testy te mogą wskazać obiecujące przepływy pracy z dokumentami i wykresami, ale nie ustanawiają kompletnego schematu modalności przyszłego publicznego API.
How Does Gemini 4 Carbon Perform on Benchmarks?
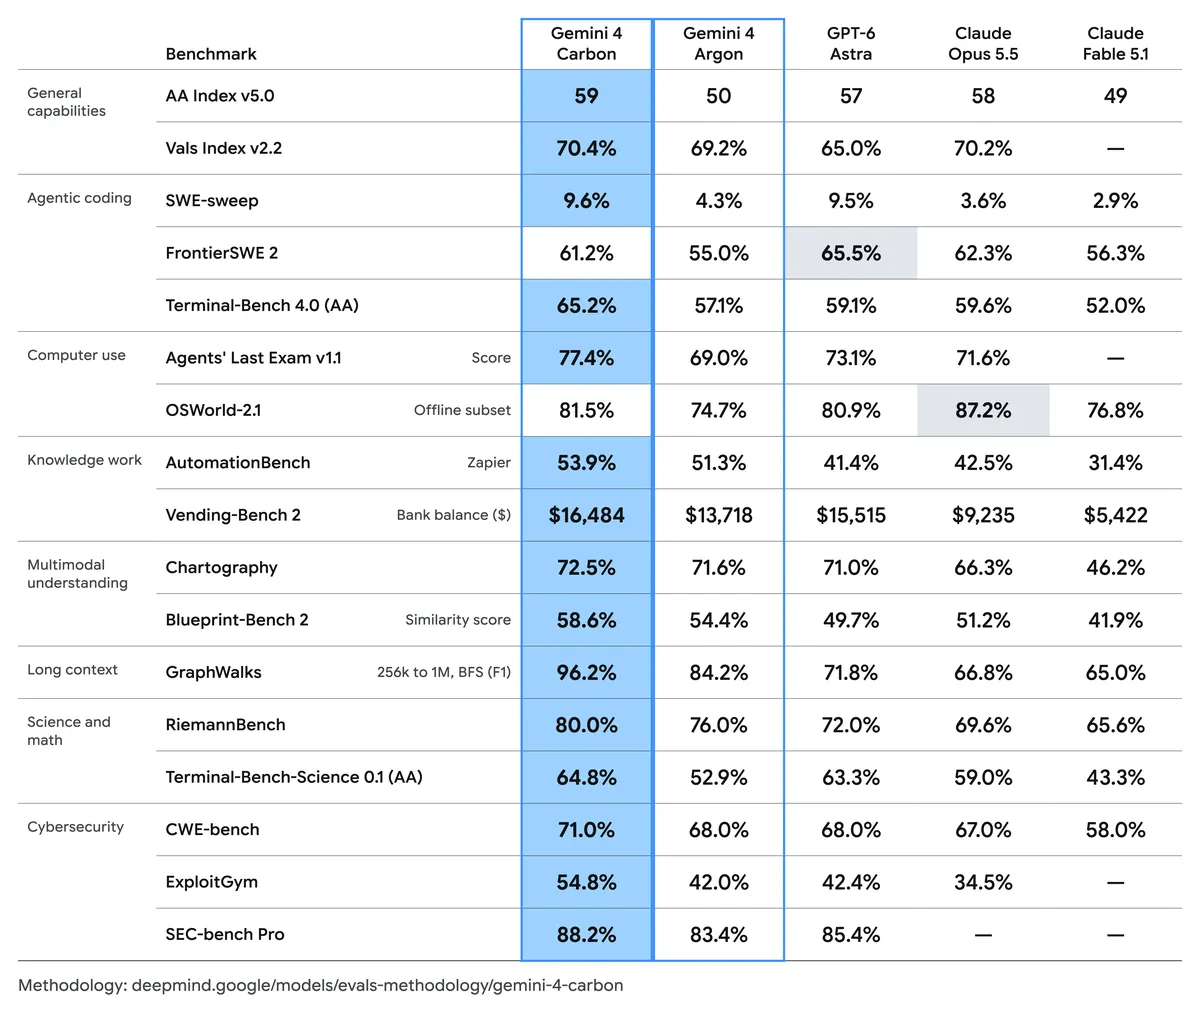
Opublikowane wyniki podkreślają trzy powody, by ocenić Carbon: silniejszą wydajność w kodowaniu, lepsze rozumowanie w długim kontekście i usprawnienia w całym przepływie pracy bezpieczeństwa. Oficjalne ogłoszenie zawiera oryginalny wykres porównawczy poniżej; kluczowe wyniki podsumowano w kolejnej sekcji.
Wybieraj benchmarki podobne do własnych obciążeń. Model prowadzący ogólny indeks inteligencji może wciąż ustępować innemu modelowi w konkretnej pracy inżynieryjnej.
Benchmark Results and Test Conditions
Ogólne rozumowanie: Carbon zdobywa 59 w AA Intelligence Index v5.0, w porównaniu do 50 dla Argon, 57 dla GPT-6 Astra i 58 dla Claude Opus 5.5.
Kodowanie: Terminal-Bench 4.0 rośnie z 57.1% do 65.2%, co stanowi poprawę o 8,1 punktu procentowego względem Argon. SWE-sweep wzrasta z 4.3% do 9.6%.
Rozumowanie w długim kontekście: Carbon osiąga 96.2% na podzbiorze GraphWalks 256K–1M tokenów BFS F1, w porównaniu do 84.2% w Argon.
Gdzie alternatywy prowadzą: GPT-6 Astra zdobywa 65.5% na FrontierSWE 2 wobec 61.2% Carbon; Claude Opus 5.5 osiąga 87.2% na offline’owym podzbiorze OSWorld wobec 81.5% Carbon. Porównania dotyczą modeli i ustawień ewaluacji z opublikowanego wykresu.
W 17 wybranych wynikach z oryginalnego porównania Carbon prowadzi w 15. Ta szerokość czyni go obiecującym kandydatem do złożonych przepływów pracy, ale dwa wyjątki pokazują, dlaczego liczy się mieszanka twoich zadań. Porównuj modele pod kątem zaakceptowanych wyników, czasu ukończenia i kosztu zamiast uśredniania niepowiązanych benchmarków.
Metodologia ewaluacji zazwyczaj używa najwyższego ustawienia myślenia i pass@1, o ile nie zaznaczono inaczej. Łączy wyniki uruchomione przez Google z evaluatorami zewnętrznymi i wynikami raportowanymi przez dostawców, więc scaffolding agentów i budżety rozumowania nie są identyczne w każdej pozycji.
GraphWalks: Cytowany podzbiór używa 200 problemów i raportuje BFS F1.
Agents’ Last Exam: Ewaluacja używa zestawu 122 zadań v1.1, harnessu ALE-Claw, pięciogodzinnego okna i włączonych filtrów bezpieczeństwa.
OSWorld: Raportowany wynik obejmuje offline’owy podzbiór 82 zadań i przyjmuje maksimum z trzech pojedynczych prób.
Coding Performance in Practice
Carbon poprawia Terminal-Bench 4.0 z 57.1% do 65.2%, co stanowi wzrost o 8,1 punktu procentowego. SWE-sweep wzrasta z 4.3% do 9.6%, ponad dwukrotnie, choć pozostaje poniżej 10% w wartościach bezwzględnych. Te wyniki wspierają ocenę trudnych prac na repozytoriach, a zarazem pokazują, dlaczego niezależne testy i przegląd wciąż są konieczne.
How Strong Is Gemini 4 Carbon at Cybersecurity?
Benchmark i zadanie z zakresu bezpieczeństwa
Gemini 4 Carbon
Gemini 4 Argon
Różnica
SEC-bench Pro — wykrywanie podatności
88.2%
83.4%
+4,8 punktu procentowego
ExploitGym — walidacja exploitów
54.8%
42.0%
+12,8 punktu procentowego
CWE-bench — usuwanie podatności
71.0%
68.0%
+3,0 punktu procentowego
Największy przyrost dotyczy walidacji exploitów. Dla uprawnionego zespołu defensywnego odtwarzalny dowód, że podatność jest eksploatowalna, może poprawić priorytetyzację; samo wiarygodne znalezisko nie wystarczy. Łatki nadal wymagają testów potwierdzających, że pierwotna usterka została naprawiona, a istniejąca funkcjonalność zachowana.
Google raportuje zewnętrzne ewaluacje bezpieczeństwa bez bezpieczników. SEC-bench Pro używa konkretnego 183-zadaniowego podziału silnika JavaScript; ExploitGym używa pojedynczej próby w trybie offline z wyłączonymi mitigacjami. Te warunki nie ustanawiają nieograniczonego zachowania produkcyjnego ani wskaźnika wykryć dla dowolnego rzeczywistego oprogramowania.
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
Niepoparte twierdzenia spadły o około 50% względem Argon w testach wewnętrznych.
Nadużycia uprawnień agenta spadły o 26%.
Niewystarczająca obsługa spadła o 29%.
Alerty poważnej niezgodności spadły w środowiskach kodowania wewnętrznego o prawie 80%.
Udane oszukiwanie na Terminal-Bench 4.0 spadło do 0.0% w ewaluacji Google.
Na ewaluowanym benchmarku pośredniej iniekcji promptów Gray Swan wskaźnik sukcesu ataku Carbon wynosi 0.0% wobec 0.7% w Argon. Oznacza to, że oceniane ataki nie powiodły się w tamtej konfiguracji; nie ustanawia to odporności na nowe ataki lub inne środowiska narzędziowe.
Te liczby pochodzą z różnych ewaluacji i nie należy ich łączyć w jeden wynik niezawodności.
Dla produkcyjnego agenta zachowuj niezależne kontrole uprawnień, logi wykonania i walidację deklarowanych wyników. Poprawione zachowanie modelu pomaga, ale aplikacja nadal musi kontrolować, do których plików, usług i akcji ma dostęp.
How Much Does the Gemini 4 Carbon API Cost?
Google ogłosiło ceny wstępne i późniejsze stawki tokenów. Poniższe wartości dla buforowanego wejścia obliczono z ogłoszonej 95% zniżki; implementacja publicznego API i szczegóły kwalifikowalności pozostają w toku.
Kategoria rozliczeń, USD za 1M tokenów
Stawka wstępna
Stawka późniejsza
Tokeny wejściowe
$2.00
$4.00
Tokeny wyjściowe
$10.00
$20.00
Kwalifikujące się buforowane tokeny wejściowe
$0.10
$0.20
Okres wstępny Carbon nie ma ogłoszonej daty zakończenia. Opublikowane ceny wstępne Argon kończą się November 30, 2026; tego terminu nie należy stosować do Carbon. Cennik zadań wsadowych, dodatkowe opłaty za narzędzia i darmowa warstwa nie zostały ogłoszone dla Carbon.
Example Request Cost
Załóżmy, że żądanie używa 200,000 niebuforowanych tokenów wejściowych i 10,000 łącznie rozliczanych tokenów wyjściowych. Przy ogłoszonych stawkach wstępnych wejście kosztuje $0.40, a wyjście $0.10, łącznie $0.50. Ten sam użytek tokenów kosztowałby $1.00 przy stawkach późniejszych.
Jeśli wszystkie 200,000 tokenów wejściowych kwalifikuje się do ogłoszonej zniżki na buforowane wejście, wstępny koszt szacunkowy wynosi $0.12 wraz z wyjściem. To warunkowa ilustracja, a nie obietnica, że każde powtórzone wejście się zakwalifikuje.
Pula wyjścia musi obejmować wszelkie tokeny myślenia rozliczane jako wyjście zgodnie z ostatecznie obowiązującymi zasadami. Jeśli 10,000 odnosi się tylko do widocznej odpowiedzi, dodatkowe rozliczane tokeny myślenia zwiększą szacunek. Narzędzia, ponowienia i inne usługi są wyłączone.
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability
Na October 29, 2026, dostęp zaczyna się od wybranych obrońców cyberbezpieczeństwa i stopniowo rozszerza na zaufanych partnerów. Fairwind Program Google opisuje kontrolowaną ścieżkę dostępu. Data szerokiego wydania dla deweloperów i publiczny identyfikator modelu Carbon nie zostały ogłoszone.
Ogłoszone ceny nie oznaczają zatem, że aplikacja może dziś wywołać ogólnie dostępne API Carbon. Ostateczne publiczne limity kontekstu, maksymalne wyjście, schemat modalności, kompatybilność narzędzi i limity operacyjne wciąż wymagają udokumentowanych specyfikacji produkcyjnych.
Na October 29, 2026, Google nie uruchomiło jeszcze ogólnie dostępnego API Carbon, więc Carbon nie jest jeszcze dostępny przez CometAPI. W oczekiwaniu możesz użyć Gemini 4 Argon do wstępnej ewaluacji. Sprawdź stronę CometAPI Carbon pod kątem dostępności i cen dostawcy, gdy dostęp się otworzy.
Alternatives While You Wait for the Carbon API
Możesz rozpocząć ocenę swojego przepływu kodowania zanim Carbon stanie się szeroko dostępny. Zbuduj bazową linię z modelem, do którego masz dostęp dziś, a następnie porównaj Carbon na tych samych zadaniach, gdy jego API się otworzy. Trzy opcje do rozważenia to Gemini 4 Argon, GPT-6.1 Astra i Claude Opus 5.5; przed wyborem ścieżki potwierdź u dostawcy dokładną nazwę modelu, dostęp i cenę.
Gemini 4 Argon: Zacznij tutaj, jeśli już używasz Gemini lub chcesz bezpośredniej bazy porównawczej dla Carbon. Wypróbuj reprezentatywne zmiany w repozytorium, przeglądy kodu i poprawki błędów, i rejestruj, które wyniki przechodzą wasze testy akceptacyjne.
**GPT-6.1 Astra:** Uwzględnij jako porównanie między dostawcami dla tych samych zadań inżynieryjnych. Mierz zaakceptowane poprawki, czas ukończenia i całkowity koszt. Wyniki GPT-6 Astra omówione wcześniej dotyczą tej wersji benchmarkowanej i nie powinny być traktowane jako wyniki GPT-6.1 Astra.
**Claude Opus 5.5:** Dodaj go jako kolejnego kandydata do analizy repozytoriów, refaktoryzacji i przeglądów. Używaj tych samych opisów zadań i kryteriów walidacji, aby porównać praktyczną wartość każdego wyniku.
Utrzymuj konfigurację wyboru modelu i zapisuj prompt’y, przypadki testowe oraz wyniki z każdego uruchomienia. To daje użyteczny punkt startowy do oceny Carbon bez wiązania przepływu pracy z nieogłoszonym formatem API.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepare a Model Evaluation Workflow
Praktyczne ramy ewaluacji powinny mierzyć więcej niż ogólną jakość odpowiedzi.
Dla przepływów kodowania i bezpieczeństwa przydatne metryki to:
Wskaźnik ukończenia zadań: Jak często agent spełnia z góry określone testy akceptacyjne?
Poprawność łatek: Czy proponowana zmiana usuwa pierwotną usterkę bez psucia istniejących zachowań?
Wskaźnik fałszywych pozytywów: Jak często zgłoszony problem nie przechodzi walidacji?
Opóźnienie end-to-end: Jak długo trwa pełny przepływ, wliczając wykonanie narzędzi?
Całkowity koszt zadania: Ile kosztuje każdy zaakceptowany wynik po ponowieniach i użyciu narzędzi?
Zgodność z instrukcjami: Czy agent pozostaje w ramach autoryzowanych plików, narzędzi i akcji?
Użyj stałego zestawu rzeczywistych zadań i prowadź zapis każdego modelu, jego ustawień, użycia tokenów i wyników testów. Uwzględnij ponowienia i ręczne poprawki w koszcie. Gdy Carbon stanie się dostępny, uruchom tę samą ewaluację, by sprawdzić, czy dostarcza więcej zaakceptowanej pracy za twój czas i budżet.
Conclusion
Gemini 4 Carbon to obiecująca aktualizacja do wymagającego kodowania, rozumowania w długim kontekście i defensywnej pracy w bezpieczeństwie. Opublikowane wyniki pokazują wyraźne zyski względem Argon, podczas gdy dostęp pozostaje ograniczony na October 29, 2026. Na razie ustanów bazową linię z dostępnym modelem i utrzymuj elastyczną integrację. Gdy publiczne API Carbon się otworzy, porównaj jakość ukończonej pracy, zaoszczędzony czas i całkowity koszt, zanim zdecydujesz się na zmianę.
FAQ
Can Gemini 4 Carbon run without human supervision?
Raporty o wielodniowej pracy inżynieryjnej wewnątrz firmy nie ustanawiają niezawodności bez nadzoru dla dowolnych zadań. Zespół rozważający autonomiczne wykonanie powinien zdefiniować dozwolone akcje, warunki zatrzymania i testy akceptacyjne, a następnie zmierzyć, jak często agent kończy pracę bez korekt. Sam czas działania nie dowodzi poprawności wyjścia agenta.
Can an existing Argon integration switch directly to Carbon?
Nie na podstawie dostępnych tu informacji. Utrzymuj możliwość wyboru dostawcy, ale zweryfikuj rzeczywisty identyfikator modelu Carbon, obsługiwany schemat, narzędzia, limity i dostęp do konta przed zmianą wdrożenia. Ponowne użycie promptu może pomóc w kontrolowanym porównaniu; nie dowodzi zgodności API.
Which Gemini 4 Carbon tests matter for a private codebase?
Uwzględnij reprezentatywne błędy, zmiany w repozytorium i znaleziska bezpieczeństwa z znanymi kryteriami akceptacji. Sprawdź, czy łatki przechodzą odpowiednie testy, czy znaleziska się odtwarzają i czy nie ma niepowiązanych zmian zachowania. Uwzględnij nieudane próby i ręczną korektę w analizie kosztów, aby wysoki publiczny wynik benchmarku nie ukrył operacyjnej pracy.