
TL;DR
Kimi K3.1 Pro zapewnia mocniejsze możliwości w zakresie kodowania, CAD i badań finansowych na bazie fundamentu K3 Moonshot AI, oferując okno kontekstu o wielkości miliona tokenów. Opublikowany wynik Terminal-Bench 4.0 na poziomie 65,7% lokuje go blisko Claude Opus 5.5 w porównaniu Moonshot. Standardowy model nadaje się do obciążeń wrażliwych na koszty; Highspeed oferuje około 2–3× szybsze generowanie przy tych samych deklarowanych możliwościach.
Oba modele są dostępne poprzez CometAPI’s Kimi K3.1 Pro API.Standardowe ceny CometAPI to 1,60 USD za milion tokenów wejściowych i 8,00 USD za milion tokenów wyjściowych. Ten przewodnik wyjaśnia benchmarki, porównuje koszty i pokazuje, jak wywołać obie wersje. Dane i ceny sprawdzono 24 października 2026 r.
Key Takeaways
- Kimi K3.1 Pro to ulepszenie po treningu: bazuje na fundamencie K3 (MoE) i obsługuje okno kontekstu 1 048 576 tokenów.
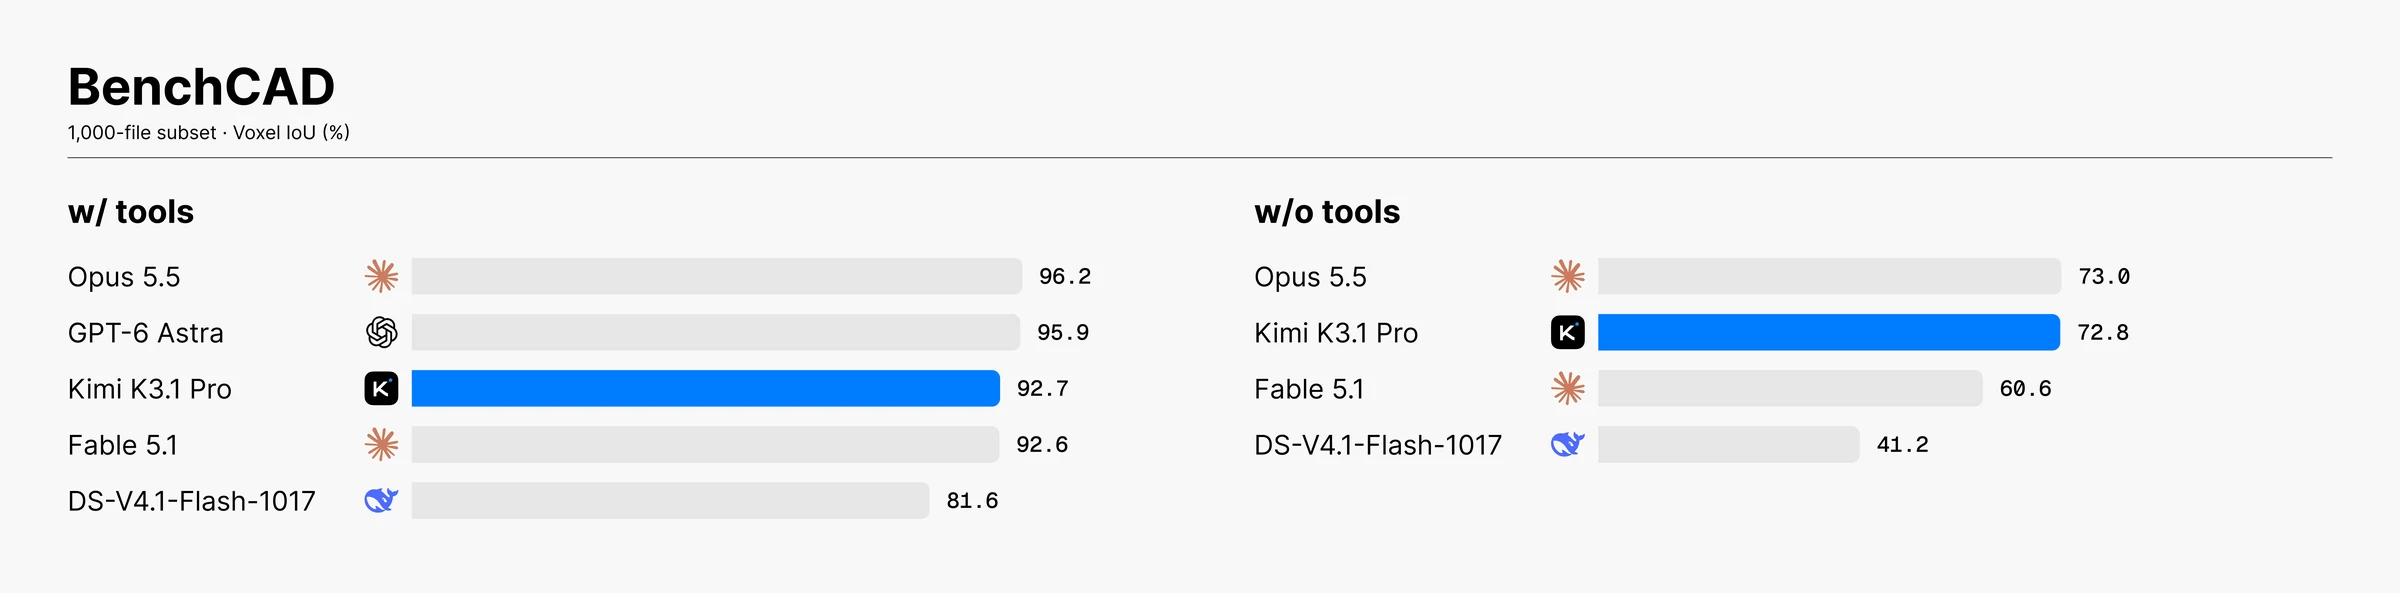
- Kimi K3.1 Pro wzmacnia przepływy pracy agentów: Moonshot raportuje 65,7% na Terminal-Bench 4.0 oraz 92,7% Voxel IoU na BenchCAD z narzędziami.
- Kimi K3.1 Pro Highspeed priorytetowo traktuje szybkość odpowiedzi: deklarowana szybkość generowania jest około 2–3× większa niż w wersji standardowej, przy tych samych możliwościach modelu.
- Dostęp do Kimi K3.1 Pro API jest dostępny przez CometAPI: standardowe stawki za wejście i wyjście są o 20% niższe niż opublikowane oficjalne stawki w USD; ceny Highspeed wymagają osobnego sprawdzenia na koncie.
- Hostowany dostęp do Kimi K3.1 Pro wyprzedza publikację pełnych wag: Moonshot planuje opublikować kompletne wagi do 4 listopada 2026 r.
What Exactly Is Kimi K3.1 Pro?
Kimi K3.1 Pro to flagowy duży model językowy od Moonshot AI z Pekinu (月之暗面), wydany 23 października 2026 r. Nie jest to całkowicie nowy model bazowy. Zamiast tego jest to mocno doszkolona wersja wcześniejszego Kimi K3 (wprowadzony w lipcu 2026 r.), z użyciem znacząco większych zasobów obliczeniowych na etapie post-treningu, skoncentrowanych na łącznym uczeniu ze wzmocnieniem w setkach domen downstream.
Moonshot opisuje go jako „nasz najbardziej zaawansowany otwarto-wagowy model klasy 3T do tej pory”. Model zachowuje tę samą podstawową architekturę co K3:
- 2,8 biliona łącznych parametrów
- 104 miliardy aktywnych parametrów na token (rzadka konstrukcja Mixture-of-Experts)
- Natywne okno kontekstu o wielkości 1 miliona tokenów
- Obsługa multimodalna (tekst, obrazy i wideo jako wejście)
- Zawsze włączone rozumowanie (brak trybu bez rozumowania)
Wariant towarzyszący, Kimi K3.1 Pro Highspeed, zapewnia 2–3× prędkość inferencji wersji standardowej Pro za dwukrotną cenę, co czyni go odpowiednim do bardziej interaktywnych lub wrażliwych na opóźnienia zastosowań.
Pełne wagi modelu mają zostać publicznie udostępnione do 4 listopada 2026 r., co uczyniłoby K3.1 Pro jednym z najsilniejszych modeli z otwartymi wagami.
Kimi 3.1 Pro Technical Specifications
| Specification | Details |
|---|---|
| Model Family | Seria Kimi K3.1 (pierwszy model) |
| Base | Doszkolony Kimi K3 |
| Total Parameters | 2,8 biliona |
| Active Parameters | 104 miliardy (MoE) |
| Context Window | 1 048 576 tokenów |
| Max Output | Do ~944K–1M tokenów (konfigurowalne) |
| Input Modalities | Tekst, Obraz, Wideo |
| Output | Tekst |
| Reasoning | Zawsze włączone (poziomy wysiłku: low / high / max) |
| Tool Calling | Obsługiwane |
| Structured Output (JSON) | Obsługiwane |
| API Model IDs | kimi-k3.1-pro, kimi-k3.1-pro-highspeed |
| Open Weights | Do 4 listopada 2026 r. |
Kimi K3.1 Pro Benchmarks: Coding, CAD, and Finance
Poniższa tabela wykorzystuje oceny z wydania Moonshot. Są to wyniki benchmarków zgłaszane przez dostawcę, a nie niezależnie odtworzony test między dostawcami.
Wskaźniki halucynacji spadły gwałtownie: Moonshot raportuje, że fałszywe twierdzenia spadły z 23,4% w K3 do około 8,3% (lub mniej w testach wewnętrznych). Modelowanie i badania związane z finansami również znacznie się poprawiły.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Note |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% | Agenci kodujący na realistycznych zadaniach terminalowych |
| BenchCAD, with tools (Voxel IoU) | 92,7% | 96,2% | 95,9% | Rekonstrukcja 3D / CAD |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | Zadania dokumentowe i biurowe |
| Frontier Finance | 58,6 | 56,7 | 45,0 | Finanse |
| SWE-Marathon | 51,7% | 46,3% | 42,5% | Inżynieria oprogramowania z długim horyzontem |
| Humanity’s Last Exam (with tools) | 70,0% | 67,7% | 57,2% | Szeroka wiedza i rozumowanie |
| Kimi Hallu Bench Hard, with tools (lower is better) | 8,3% | 15,0% | 5,5% |
Coding benchmarks show frontier-level agent performance
Na Terminal-Bench 4.0 różnica względem Claude Opus 5.5 wynosi 0,7 punktu procentowego; przewaga nad GPT-6 Astra to 7,5 punktu. Czyni to K3.1 Pro istotnym kandydatem dla agentów inżynierskich działających w terminalu, ale konfiguracja ewaluacji ma równie duże znaczenie co wynik nagłówkowy.
Należy zauważyć, że niektóre niezależne testy agentów kodujących pokazują bardziej mieszane rezultaty w zależności od dokładnej ramy testowej i długości sesji, a K3.1 Pro czasem generuje dłuższe, bardziej rozwlekłe ślady rozumowania.
Kimi K3.1 Pro improves 3D creation and vision
BenchCAD mierzy jakość rekonstrukcji z wielokrotnych renderów poprzez generowany kod CAD. Jego wynik Voxel IoU mierzy nakładanie się geometrii, więc 92,7% nie należy odczytywać jako 92,7% wskaźnik zaliczeń zadań. Porównanie „z narzędziami” od Moonshot używa podzbioru 1000 przypadków i lokuje K3.1 Pro poniżej Opus 5.5 i GPT-6 Astra pod tym względem.
Model wykazuje też duże wzrosty względem Kimi K3 w zadaniach widzenie–język (np. +0,11 mAP50 na liście Ultralytics auto-annotation) oraz w egzaminach z analityki danych (zaliczone 42/43 pytania).
What’s New in Kimi K3.1 Pro Compared With Kimi K3?
Najbardziej klarownym powodem rozważenia aktualizacji jest poprawa realizacji pracy wieloetapowej. Poniższa tabela porównuje K3 i K3.1 Pro w ramach zgłaszanych przez Moonshot ocen.
| Evaluation | Kimi K3 | Kimi K3.1 Pro | Improvement |
|---|---|---|---|
| Kimi Code Bench 3.0 Long-horizon | 55,95% | 61,2% | +5,25 punktu |
| Internal Financial Modeling | 50,4 | 57,6 | +7,2 punktu |
| Internal Financial Research | 58,8 | 70,4 | +11,6 punktu |
| Internal Business Operation | 8,9 | 37,0 | ~4,2× wydajności |
| Kimi Hallu Bench Hard with tools, claim-level errors | 23,4% | 8,3% | ~64,5% redukcji |
Są to jednak pojedyncze porównania benchmarków. Nie należy interpretować tego jako uniwersalnej poprawy wydajności agentów o 4,2×.
Kimi K3.1 Pro reduces factual errors
Wykres rozdziela wyniki bez narzędzi od trudniejszej ewaluacji z narzędziami; wartość 8,3% dotyczy tej drugiej.
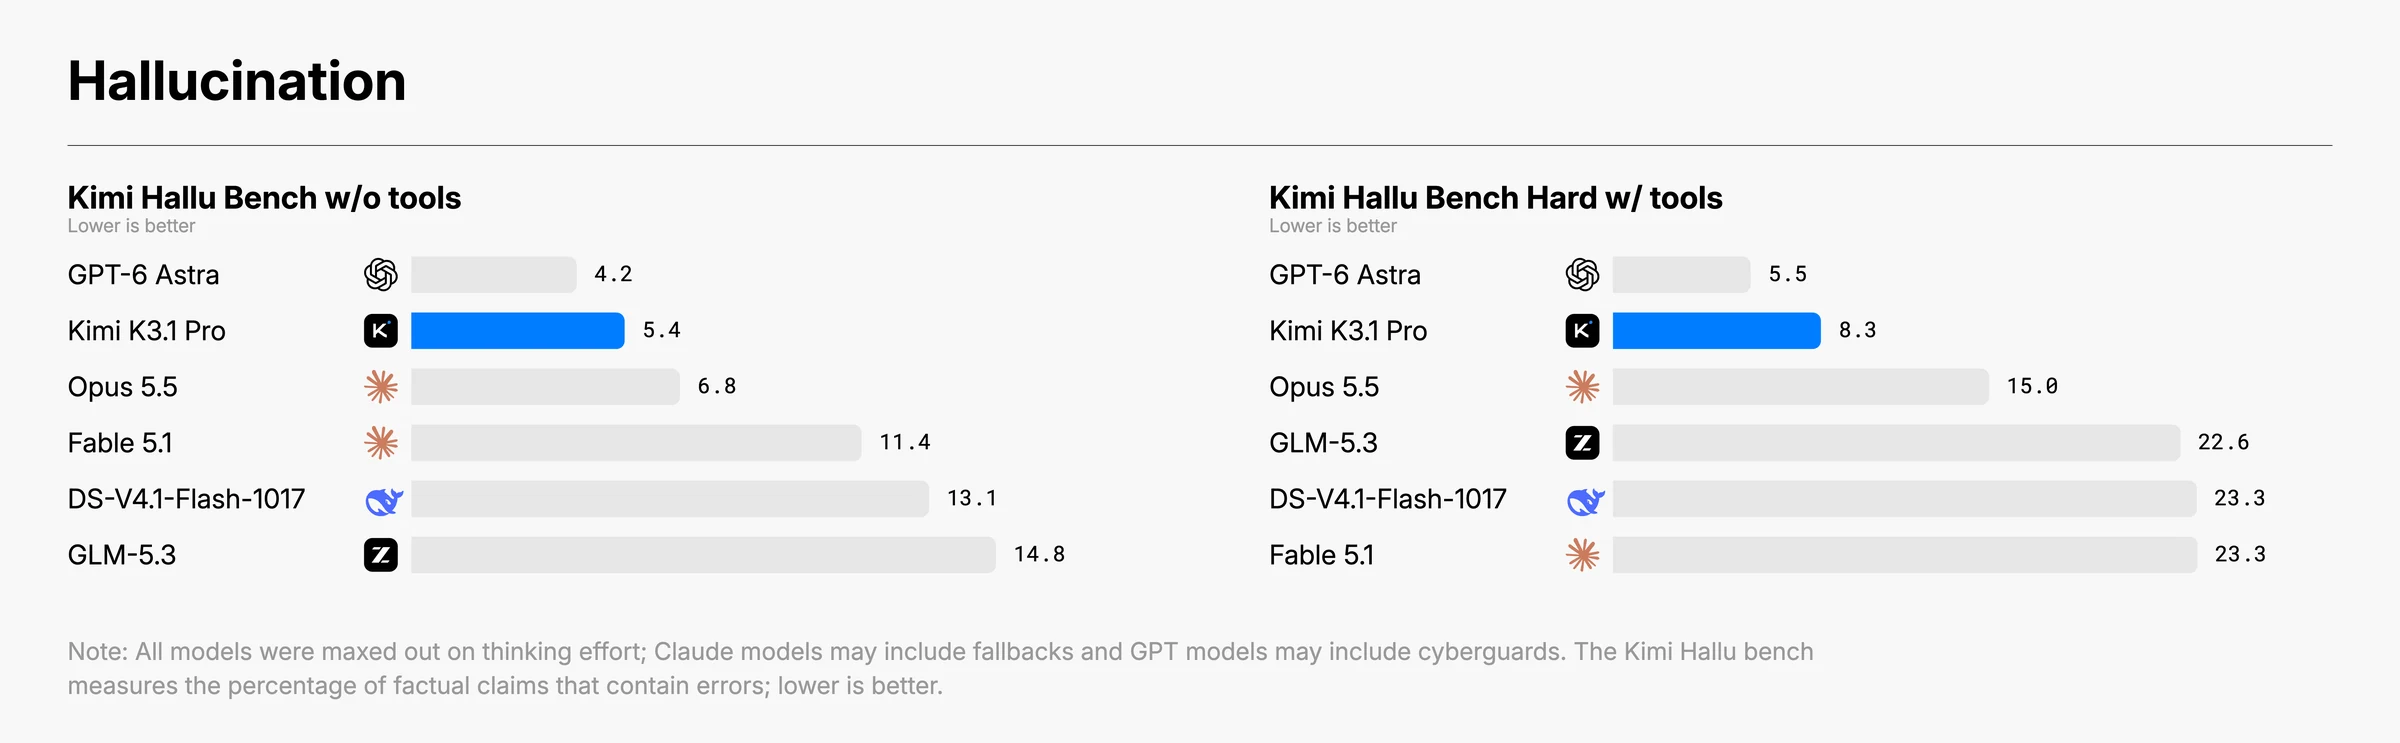
Rozróżnienie między dokładnością benchmarków a niezawodnością w rzeczywistości jest istotne. Ta ewaluacja celowo używa trudnych promptów, które prawdopodobnie ujawniają błędy faktograficzne. Jej wyniki nie reprezentują średniego wskaźnika halucynacji modelu w codziennych rozmowach.
Kimi K3.1 Pro introduces a deliberate cybersecurity trade-off
Moonshot AI usunął wybrane dane szkoleniowe i zadania RL związane z cyberbezpieczeństwem, aby zmniejszyć ofensywne możliwości w tym obszarze, jednocześnie zachowując ogólny poziom wydajności w programowaniu.
W wewnętrznej ewaluacji xdev-bench-hard przy pass@3 nieograniczony checkpoint uzyskał 90,5%, a wersja wydana 81,0%. Ta różnica odzwierciedla celowy wybór treningowy, a nie gwarancję, że wydany model nie może zostać niewłaściwie użyty. Zobacz official cybersecurity evaluation dla warunków i ograniczeń.
Kimi K3.1 Pro vs Highspeed: Which Version Should You Choose?
| Decision factor | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Model capabilities | Standardowe, flagowe możliwości | Te same deklarowane możliwości |
| Output speed | Bazowa | Około 2–3× szybciej |
| Best starting workload | Analiza wsadowa, długie raporty, zadania w tle | Interaktywne asystenty kodowania i badań |
| CometAPI model ID | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
Użyj wersji standardowej, gdy koszt jest ważniejszy niż natychmiastowe generowanie. Wybierz Highspeed, gdy użytkownicy czekają na wynik, a następnie zmierz efekt na ukończonych zadaniach zamiast zakładać, że szybciej generowana treść bezpośrednio przekłada się na ten sam całkowity zysk czasowy.
Na przykład, jeśli agent kodujący spędza większość czasu na uruchamianiu testów, instalowaniu zależności lub czekaniu na narzędzia zewnętrzne, przyspieszenie generowania może dać stosunkowo niewielką poprawę end-to-end.
Access Both Kimi K3.1 Pro Versions Through CometAPI
CometAPI udostępnia Kimi K3.1 Pro i Kimi K3.1 Pro Highspeed poprzez kompatybilny z OpenAI endpoint Chat Completions. Integracja pozostaje taka sama przy przełączaniu wersji; zmień identyfikator modelu, aby wybrać wariant.
- Utwórz klucz API w swoim koncie CometAPI i udostępnij go aplikacji jako zmienną środowiskową COMETAPI_API_KEY.
- Zainstaluj OpenAI Python SDK, następnie ustaw base URL klienta na
https://api.cometapi.com/v1. - Użyj kimi-k3.1-pro dla wersji standardowej lub kimi-k3.1-pro-highspeed dla Highspeed.
python -m pip install --upgrade openaiimport osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["COMETAPI_API_KEY"], base_url="https://api.cometapi.com/v1",)response = client.chat.completions.create( model="kimi-k3.1-pro", # Or "kimi-k3.1-pro-highspeed" messages=[ { "role": "user", "content": "Suggest three tests for a CSV import feature.", } ],)print(response.choices[0].message.content)
Poniższy przykład powłoki wywołuje bezpośrednio Highspeed. Wykorzystuje tę samą zmienną środowiskową COMETAPI_API_KEY.
Kimi K3.1 Pro API Pricing: Official Rates vs CometAPI
Tabela porównuje opublikowane stawki w USD za jeden milion tokenów dla niebuforowanego wejścia i generowanego wyjścia, sprawdzone 24 października 2026 r. Standardowe stawki CometAPI dla K3.1 Pro są o 20% niższe od oficjalnych. Przed wyborem wersji Highspeed sprawdź bieżące stawki na swoim koncie.
| Model | Official input | Official output | CometAPI input | CometAPI output |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $1.60 | $8.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | Sprawdź ceny na koncie | Sprawdź ceny na koncie |
Nie należy zakładać, że zniżka wersji standardowej ma zastosowanie do Highspeed. Odczyty/zapisy cache, opłaty za narzędzia, podatki i ponowienia nie są ujęte w tym porównaniu.
Przy oficjalnych stawkach API, K3.1 Pro jest około 33,3% tańszy niż K3 dla niebuforowanych tokenów wejściowych i wyjściowych.
Dla żądań bez cache i dodatkowych usług rozliczanych, koszt to:
Koszt = (Liczba tokenów wejściowych × Stawka wejściowa + Liczba tokenów wyjściowych × Stawka wyjściowa) / 1,000,000
Na przykład, przetworzenie 100 000 niebuforowanych tokenów wejściowych i wygenerowanie 10 000 tokenów wyjściowych kosztuje około 0,24 USD przez standardowe API K3.1 Pro w CometAPI, w porównaniu z 0,30 USD przy oficjalnej stawce dostawcy.
Szacuj wydatki produkcyjne na podstawie udanych zadań, uwzględniając wszelkie ponowienia lub użycie tokenów rozumowania wykazane w rejestrach rozliczeń. Niższa stawka za token nie gwarantuje niższego całkowitego kosztu, jeśli przepływ pracy generuje więcej tokenów lub wymaga dodatkowych prób.
Put Kimi K3.1 Pro to Work: Four Practical Starting Points
Wybierz mały przepływ pracy z wynikiem, który możesz zweryfikować.
| Workflow | A practical first project | Acceptance checks |
|---|---|---|
| Software engineering | Napraw powtarzalny błąd w repozytorium i dodaj test regresji. | Istotne testy przechodzą; poprawka rozwiązuje problem bez niepowiązanych zmian. |
| CAD and 3D creation | Wygeneruj część parametryczną na podstawie opisanych wymiarów. | Sprawdź wymiary, poprawną geometrię, edytowalność i zgodność eksportu. |
| Financial research | Uzgodnij wybrane liczby między raportami rocznymi a arkuszem. | Zweryfikuj każdą liczbę względem źródła i niezależnie sprawdź formuły. |
| Long-context research | Porównaj wymagania w zbiorze dokumentów technicznych. | Sprawdź lokalizacje dowodów, wersje dokumentów i pokrycie sprzecznych stwierdzeń. |
Do ewaluacji sukces ukończonych zadań jest bardziej miarodajny niż liczba wygenerowanych linii kodu.
What Are the Limitations of Kimi K3.1 Pro?
- Rozumowanie pozostaje włączone. K3.1 Pro obsługuje poziomy wysiłku low, high i max, przy czym domyślnie udokumentowany jest max. Nie zakładaj, że dostępny jest tryb bez rozumowania.
- Długie wejścia mają koszty operacyjne. Duże okno kontekstu może zwiększyć czas przetwarzania wejścia i zużycie tokenów. Wybieraj istotny materiał i oceniaj buforowanie zamiast wysyłać domyślnie całe archiwum.
- Odpowiedź API nie realizuje zewnętrznego przepływu pracy. Twoja aplikacja dostarcza wykonanie narzędzi, stan zapisu i walidację wyjścia; wynik benchmarku z narzędziami nie oznacza, że te możliwości są dostępne w gołym wywołaniu API.
- Hostowany dostęp i pobieralne wagi to różne kamienie milowe. Na 24 października pełne wydanie wag K3.1 Pro pozostaje zaplanowane na 4 listopada 2026 r.; przejrzyj wydanie i licencję przed planowaniem samodzielnego hostowania.
Zachowanie API opisano w Kimi API guide; dostępność wag w release announcement.
Conclusion
Kimi K3.1 Pro warto ocenić, gdy Twoja aplikacja zależy od wieloetapowego kodowania, badań dokumentów lub pracy z narzędziami. Zgłaszane zyski względem K3 i niższe standardowe stawki API stwarzają praktyczny powód, by przetestować aktualizację. Zacznij od wersji standardowej, mierz jakość i koszt akceptowanych zadań, a wybierz Highspeed tam, gdzie szybsze generowanie istotnie poprawia doświadczenie użytkownika. Użyj model CometAPI, aby sprawdzić dostęp i bieżące ceny przed integracją powyższych przykładów.