
TL;DR
Muse Ember to najmniejszy multimodalny model rozumowania firmy Meta, zbudowany do zadań agentowych o dużej skali, takich jak routing, ekstrakcja, wywoływanie narzędzi i skupione programowanie. Meta wprowadziła Muse Ember 9 listopada 2026.
Jego okno kontekstu o 1,048,576 tokenach mieści obszerny materiał źródłowy. Meta oferuje dostęp przez Model API i Muse Code; CometAPI wymienia muse-ember, a status aktywacji omówiono poniżej. Zacznij od powtarzalnego zadania, którego wynik można zweryfikować, a następnie porównaj koszt na udany rezultat, uwzględniając rozumowanie, narzędzia i ponowienia.
Najważniejsze wnioski
- Rola: Muse Ember został zbudowany do powtarzalnego wykonywania przez agenta, w tym klasyfikacji, ekstrakcji, wywołań narzędzi i ograniczonych zadań programistycznych.
- Wejścia i pojemność: Muse Ember akceptuje tekst, obrazy, audio i wideo, z oknem kontekstu 1M tokenów i maksymalnie 512K tokenów wyjściowych.
- Wydajność: Wyniki Meta faworyzują Muse Ember na kilku benchmarkach agentowych, natomiast niezależne testy analityczne pokazują, że niskie ceny tokenów nie zawsze przekładają się na najniższy koszt zadania.
- Cennik: Żądania powyżej 200K tokenów wejściowych wchodzą w wyższy próg cenowy; całkowity koszt zadania zależy również od rozumowania i użycia narzędzi.
- Dostęp: Meta Model API i Muse Code są dostępne; listing CometAPI obecnie oznacza model jako Coming soon.
Do czego najlepiej nadaje się Muse Ember?
Muse Ember obsługuje kroki wykonawcze w przepływie pracy agenta, podczas gdy większy model zarządza planowaniem. Pasuje do zadań o dużej skali z jasnymi wejściami, ograniczonym zakresem i wynikiem, który Twoja aplikacja może zweryfikować. Jego podstawowe zadania to:
- Klasyfikacja i routing: Oznaczanie próśb i kierowanie ich do właściwej kolejki lub usługi.
- Ekstrakcja: Zamiana dokumentów i mediów na ustrukturyzowane pola z dowodami źródłowymi.
- Wywoływanie narzędzi: Wybór funkcji i dostarczenie argumentów, które Twoja aplikacja wykonuje.
- Przetwarzanie wsadowe: Zastosowanie powtarzalnej operacji do plików lub rekordów.
Routing zgłoszeń wsparcia
Praktyczny przepływ wsparcia może poprosić Ember o wyodrębnienie referencji zamówienia, przypisanie kategorii i zaznaczenie brakujących informacji. Twoja aplikacja może zweryfikować referencję względem swoich rekordów przed skierowaniem zgłoszenia. Trzymaj zwroty, zmiany kont i inne konsekwentne działania za własnymi kontrolami autoryzacji aplikacji.
Ekstrakcja dokumentów z dowodami
W przypadku przetwarzania faktur lub umów poproś zarówno o wyodrębnioną wartość, jak i o stronę lub fragment, który ją potwierdza. Traktuj brakujące i nieczytelne pola jako jawne wyniki zamiast zachęcać model do zgadywania. To daje rekordy, które recenzenci mogą sprawdzić bez ponownego czytania każdego dokumentu.
Skupiona praca programistyczna
Nadaj pracownikowi programistycznemu mały zakres odpowiedzialności: pliki, które może zmienić, zachowania do zachowania i testy definiujące ukończenie. Przykład równoległej migracji kodu od Meta ilustruje ten podział pracy. Otaczający agent uruchamia polecenia i sprawdza wyniki; odpowiedź modelu sama w sobie nie jest dowodem, że zmiana zdała testy.
Wizualizacja premiery Muse Ember towarzyszy przewodnikowi po łączeniu modelu wykonawczego z większym modelem planującym.
Meta mówi, że Muse Ember jest pierwszym modelem szkolonym z użyciem Muse Wonder Full, rozszerzając strategię wykorzystywania większych modeli do tworzenia modeli wyspecjalizowanych.
Specyfikacja Muse Ember
Podstawowe specyfikacje są następujące:
| Specyfikacja | Muse Ember |
|---|---|
| Deweloper | Meta Superintelligence Labs |
| Data ogłoszenia | November 9, 2026 |
| Kategoria modelu | Multimodalne rozumowanie i wykonanie przez agenta |
| Okno kontekstu | 1,048,576 tokens |
| Maksymalne wyjście | 524,288 tokens |
| Modalności wejściowe | Tekst, obrazy, audio, wideo |
| Wejścia plikowe | Obsługiwane przez Responses API |
| Modalność wyjściowa | Tekst |
| Poziom rozumowania | Minimal, Low, Medium, High, XHigh, Max |
| Domyślny poziom rozumowania | Max |
| Wywoływanie narzędzi | Obsługiwane |
| Ustrukturyzowane wyjście | Obsługiwane |
| Osadzanie wyników wyszukiwania | Obsługiwane przez Model API |
Meta nie udostępniła wag Muse Ember ani nie ujawniła liczby parametrów. Limity żądań i tokenów obowiązują per zespół, a wszystkie klucze API w danym zespole współdzielą przydział modelu.
Kontekst i multimodalne wejścia
W przypadku przepływów PDF Meta wyodrębnia tekst z pierwszych 100 stron i obrazy z pierwszych 50, więc podziel dłuższe pliki przed przetwarzaniem. Prześlij materiał potrzebny do zadania; tokeny rozumowania współdzielą limit 524,288 tokenów wyjściowych z odpowiedzią końcową.
Używaj zrzutów ekranu, gdy układ ma znaczenie, skanów do ekstrakcji dokumentów, audio do analizy spotkań i wideo do zdarzeń rozwijających się w czasie. Transkrypcja wystarcza do streszczenia tekstowego. Pliki są obsługiwane przez Responses API, a wyniki zwracane jako tekst.
Konfigurowalny nakład rozumowania
Muse Ember oferuje sześć poziomów rozumowania: Minimal, Low, Medium, High, XHigh i Max. Meta domyślnie ustawia Max; żaden z nich nie jest nieobsługiwany i nie zwraca HTTP 400. Zacznij od niższego poziomu w rutynowym routingu i klasyfikacji, a następnie zwiększaj go tylko wtedy, gdy wzrost odsetka zaakceptowanych odpowiedzi uzasadnia dodatkową latencję i koszt tokenów wyjściowych.
Wywoływanie narzędzi i ustrukturyzowane wyjście
Muse Ember obsługuje wywoływanie narzędzi i ustrukturyzowane wyjście. Wywołania narzędzi łączą decyzje modelu z funkcjami aplikacji, a ustrukturyzowane wyjście ułatwia weryfikację wyodrębnionych pól i przekazanie ich do kolejnego kroku.
Ten obrazowy wynik zgłoszenia wsparcia przekazuje aplikacji routującej kategorię, priorytet i flagę do przeglądu:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API obsługuje także osadzanie wyników wyszukiwania i przepływy sterowania komputerem. Połączona aplikacja dostarcza narzędzia, wykonuje działania i kontroluje uprawnienia.
Jak Muse Ember wypada w benchmarkach?
Wyniki premiery Meta używają maksymalnego nakładu rozumowania. Agents’ Last Exam obejmuje podzbiór Linux w wewnętrznej ewaluacji Meta, a Terminal-Bench korzysta z najlepszego opublikowanego harnessu każdego modelu. Łączą zewnętrznie raportowane wyniki Artificial Analysis z wewnętrznymi ewaluacjami Meta; Personal Superintelligence Index to wewnętrzny indeks złożony Meta, a nie oddzielna niezależna lista.
Wyniki benchmarków Muse Ember
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 używa mini-swe-agent dla Muse Ember, Claude Code dla Haiku 5.5 i Codex dla GPT-6 Luna. To nie są identyczne środowiska wykonawcze. OSWorld 2.1 raportuje zarówno wyniki z częściowym kredytem, jak i binarne, a PerceptionBench obejmuje narzędzia. Wyniki Artificial Analysis Intelligence Index pochodzą z wersji 5 opublikowanej 9 listopada 2026.
Analiza benchmarków Muse Ember
Wykonanie przez agenta to najmocniejsza strona Muse Ember.
Na AutomationBench-AA Muse Ember uzyskuje 37.8, w porównaniu z 13.9 dla Haiku 5.5 i 20.2 dla GPT-6 Luna. Wspiera to pozycjonowanie Muse Ember jako modelu do end-to-endowych przepływów biznesowych i powtarzalnych operacji agentowych.
Wydajność w kodowaniu jest konkurencyjna, ale nie zawsze wyższa.
Muse Ember uzyskuje 40.9 na Terminal-Bench 4.0 i 46 na Coding Agent Index-AA. Jednak uzyskuje 27.2 na FrontierCode 2.0-AA, poniżej 34.9 Haiku 5.5. Sugeruje to, że Muse Ember jest użytecznym kandydatem do ograniczonych podzadań programistycznych, podczas gdy trudniejsze prace inżynierskie należy testować wobec silniejszych alternatyw.
Wyniki multimodalne i sterowania komputerem są obiecujące.
Muse Ember uzyskuje 80.6 na PerceptionBench z narzędziami i 69.5 na OSWorld 2.1 przy ocenie z częściowym kredytem. Wyniki te wspierają jego pozycjonowanie w przepływach pracy obejmujących rozumienie wizualne i interakcję z komputerem.
Ogólna inteligencja jest porównywalna z Haiku 5.5.
Muse Ember i Haiku 5.5 oba zaokrąglają do 36 na Artificial Analysis Intelligence Index, przed GPT-6 Luna z wynikiem 28. Do decyzji o wyborze połącz tę szeroką porównawczą miarę z wynikami specyficznymi dla zadań powyżej.
Inteligencja Muse Ember vs. koszt na zadanie
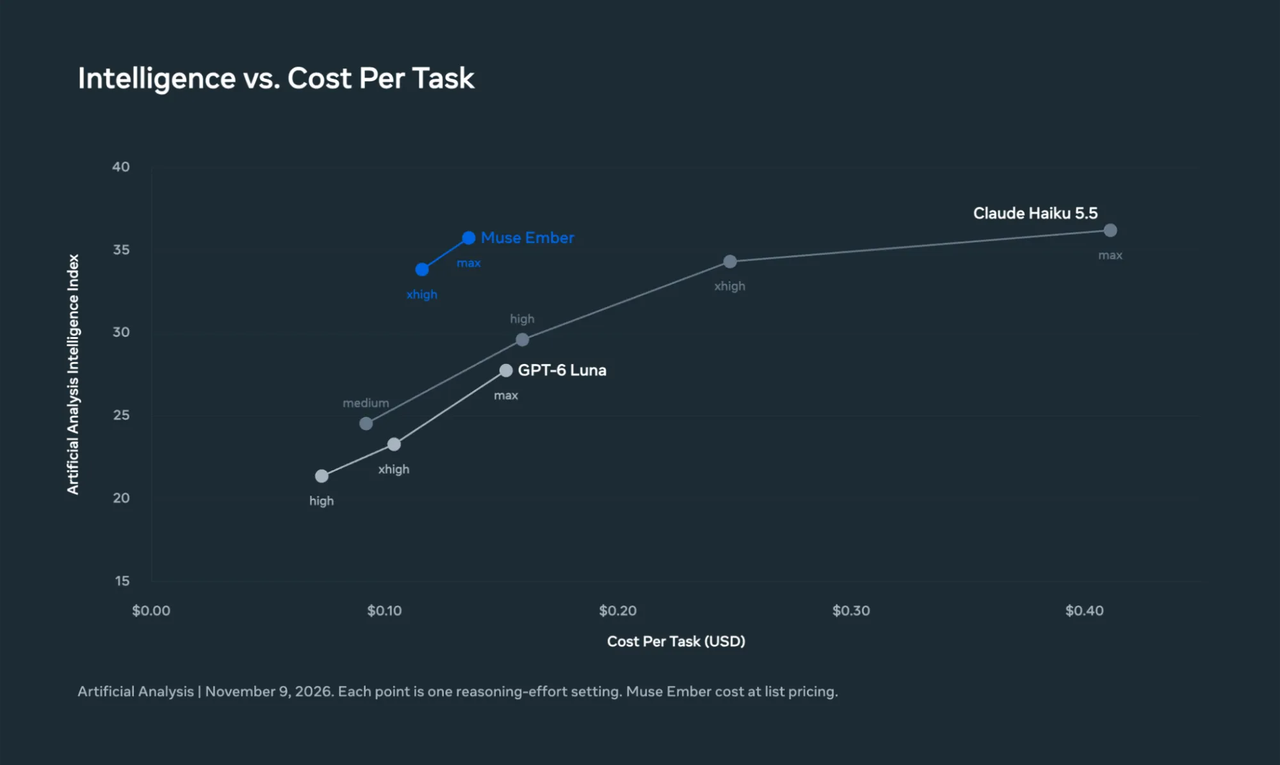
Wykres Meta porównuje wyniki Artificial Analysis Intelligence Index z szacowanym kosztem na zadanie przy różnych ustawieniach nakładu rozumowania.
Przy maksymalnym nakładzie rozumowania Muse Ember uzyskuje 35.8 na Artificial Analysis Intelligence Index przy szacowanym kosztu $0.136 na zadanie. Haiku 5.5 uzyskuje 36.2 przy $0.411, a GPT-6 Luna 27.8 przy $0.152. Na tym benchmarku Ember zbliża się do wyniku Haiku za około jedną trzecią kosztu zadania i przewyższa Lunę przy nieco niższym koszcie.
Szacunki używają zużycia tokenów benchmarku i cen katalogowych. Następna ocena pokazuje, dlaczego aktywność narzędzi ma znaczenie przy wyborze modelu do konkretnego przepływu pracy.
Niezależne wyniki analizy danych
Listopadowa ocena analizy danych od Plotly z 10 listopada 2026 przetestowała 43 pytania w Plotly Studio Embedded na syntetycznym zbiorze danych o energii wiatrowej. Muse Ember działał przez OpenRouter; raportowane koszty używają cen dostępnych w czasie działania każdego modelu. To wyniki specyficzne dla obciążenia, a nie test rozliczeń natywnego API Meta.
| Metryka oceny | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Liczba zaliczonych pytań | 38/43 | 38/43 | 37/43 |
| Całkowity koszt testu | $1.04 | $0.13 | $0.38 |
| Mediana czasu na pytanie | 28 seconds | 18 seconds | 14 seconds |
Dla tego obciążenia analitycznego GPT-6 Luna dostarczyła tę samą liczbę 38/43 zaliczonych pytań co Ember za jedną ósmą całkowitego kosztu, z niższą medianą czasu odpowiedzi. Haiku było najszybsze — 14 sekund na pytanie, z wynikiem 37/43. Luna jest silniejszym kandydatem startowym dla podobnego kosztowo wrażliwego przepływu analitycznego; sam niski rate tokenów Ember nie czyni go najtańszym wyborem.
Plotly stwierdziło, że Muse Ember wykonywał średnio 78 zapytań przy pytaniach obejmujących ukryte wzorce, w porównaniu z medianą 25 wśród testowanych modeli. Dodatkowa aktywność narzędzi zwiększyła zużycie tokenów i całkowity koszt.
Test pokazał też mocne strony: Muse Ember poprawnie odpowiedział na wszystkie 20 jasno zdefiniowanych pytań analitycznych, wszystkie pięć niejednoznacznych, wszystkie pięć niemożliwych próśb i wszystkie trzy kontrole jakości danych. Najbardziej trudził się z ukrytymi wzorcami w danych.
Plotly uruchomiło każdy model raz i zaobserwowało odchylenie do trzech pytań przy powtórkach innych modeli. Traktuj różnicę 38 vs 37 jako niewielką; wyraźniejsza różnica dotyczy tu użycia narzędzi i całkowitego kosztu.
Muse Ember vs Muse Wonder vs Muse Spark
Wybierz model Muse według odpowiedzialności, którą ma ponosić: planowanie, główna pętla agenta lub powtarzalne wykonanie.
| Wymiar | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Rola główna | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| Główna mocna strona | Planowanie, długo trwające zadania, złożone kodowanie | Kodowanie i przepływy agentowe | Powtarzalne podzadania i wywołania narzędzi |
| Typowe obciążenie | Inżynieria w skali repozytorium | Główna pętla agenta | Klasyfikacja, routing, ekstrakcja |
| Identyfikator modelu w API | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Okno kontekstu | 1M tokens | 1M tokens | 1M tokens |
| Domyślny poziom rozumowania | Max | High | Max |
| Standardowa cena wejścia / 1M | $4.00 | $1.25 | $0.10 |
| Standardowa cena wyjścia / 1M | $20.00 | $4.25 | $0.50 |
Tabela używa cen tokenów Meta w trybie Standard. Ceny Ember dotyczą tu żądań do 200K tokenów wejściowych; Wonder i Spark nie mają długokontekstowej premii Ember.
Wybór modelu Muse
Wybierz Wonder do trudnego planowania, inżynierii w skali repozytorium i odzyskiwania w długich sekwencjach kroków. Wybierz Spark do uruchamiania głównego kodowania lub pętli agenta. Wybierz Ember do powtarzalnych podzadań z niezależnie weryfikowalnymi wynikami, takich jak routing, ekstrakcja i ukierunkowane zmiany plików.
Na przykład migracja repozytorium może przypisać analizę zależności większemu modelowi, a wąsko zdefiniowaną zmianę pliku — Ember. Przekazanie powinno wymienić pliki, oczekiwane zachowanie i kryteria odbioru. Ten podział ma sens tylko wtedy, gdy koordynacja i przegląd mniejszych zadań kosztują mniej niż wykonanie całej pracy głównym modelem.
Aby wybrać między nimi, uruchom te same reprezentatywne zadania na swoich kandydatach z tymi samymi kryteriami akceptacji. Najpierw odrzuć konfiguracje, które nie osiągają wymaganej stopy sukcesu lub celu latencji. Wśród zaliczających porównaj całkowity wydatek podzielony przez zaakceptowane wyniki, uwzględniając ponowienia i wywołania narzędzi. Przypisz Ember typy zadań, w których obniża ten koszt, a nierozwiązane przypadki kieruj z powrotem do Spark lub Wonder.
Ile kosztuje Muse Ember?
Tabela zestawia oficjalne stawki Meta ze szacunkiem rabatu 20% dla CometAPI, w USD na milion tokenów. Każde pole pokazuje Meta / szacowany po rabacie. Listing CometAPI nie publikuje jeszcze taryfy na żywo; użyj rabatowych liczb do planowania budżetu.
| Koszt na 1M tokenów (Meta / szacunek z rabatem 20%) | Do 200K tokenów wejściowych | Powyżej 200K tokenów wejściowych |
|---|---|---|
| Wejście | $0.10 / $0.08 | $0.30 / $0.24 |
| Buforowane wejście | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Wyjście | $0.50 / $0.40 | $1.50 / $1.20 |
Łączna liczba tokenów wejściowych żądania, w tym buforowane wejście, określa próg. Żądanie powyżej 200K tokenów wejściowych używa wyższych stawek dla całego żądania, włącznie z jego wyjściem. Z previous_response_id Meta, przechowywana historia konwersacji liczy się do sumy wejścia.
Typowe koszty żądań Muse Ember
Przy niebuforowanym wejściu i 20K naliczanych tokenach wyjściowych, w tym rozumowaniu, żądanie z 200K wejściem kosztuje $0.0300 w stawkach Meta lub $0.0240 w scenariuszu z rabatem 20%. Zwiększenie wejścia do 220K przenosi całe żądanie do wyższego progu: te same 20K wyjścia podnoszą łączny koszt do $0.0960 w stawkach Meta lub szacunkowo $0.0768 z rabatem. Te przykłady nie obejmują osobnych opłat za narzędzia. Utrzymanie istotnego kontekstu w niższym progu może zaoszczędzić więcej niż sam 20% rabat.
| Scenariusz | Tokeny wejściowe | Naliczane tokeny wyjściowe | Koszt Meta | Koszt CometAPI |
|---|---|---|---|---|
| Standardowe żądanie | 200K | 20K | $0.0300 | $0.0240 |
| Długie konteksty | 220K | 20K | $0.0960 | $0.0768 |
Tokeny rozumowania liczą się jako naliczane wyjście. W natywnym API Meta osadzanie wyszukiwania kosztuje dodatkowe $2.50 za 1,000 zapytań, a Ember nie ma wariantu Contributor-mode. Powyższe porównanie cen tokenów nie stosuje 20% rabatu do osobnych opłat za narzędzia.
Jak uzyskać dostęp do Muse Ember
Listing CometAPI: strona modelu identyfikuje model jako muse-ember, ale jego status w katalogu to Coming soon na dzień 16 listopada 2026. Obserwuj tę stronę pod kątem aktywacji i cen; aby uzyskać dostęp już teraz, użyj Meta Model API lub Muse Code.
Przez Meta Model API: użyj muse-ember-1.0 z https://api.meta.ai/v1. Natywne API obsługuje formaty Responses, Chat Completions i Messages. Wejścia plikowe używają Responses. Utrzymuj razem punkt końcowy i identyfikator modelu danego dostawcy przy konfigurowaniu klienta.
Limity natywnego API i inne dostępy: Meta podaje 3,000 żądań na minutę i 4,000,000 tokenów na minutę na zespół, współdzielone przez klucze API zespołu. Muse Ember jest również dostępny w Muse Code. Sprawdź limity wybranej ścieżki dostępu przy szacowaniu wsadu i użyj przewodnika integracji Meta do konfiguracji natywnego API.
Jakie są ograniczenia Muse Ember?
Trzy czynniki określają, czy Ember pasuje do Twojego kolejnego przepływu pracy:
- Złożona inżynieria pozostaje zależna od obciążenia. Ember ustępuje Haiku 5.5 na FrontierCode 2.0-AA mimo lepszego wyniku na Terminal-Bench. Wąskie zwycięstwo w kodowaniu nie potwierdza przydatności do każdej zmiany w skali repozytorium.
- Długi kontekst i niskie ceny tokenów nie gwarantują niskiego kosztu zadania. Duże żądania przechodzą do wyższego progu cenowego, a powtarzane używanie narzędzi może zużyć tyle tokenów, że zniweluje niski koszt za token.
- Obsługa narzędzi nadal wymaga aplikacji. Otaczający system wykonuje wywołania, kontroluje uprawnienia i weryfikuje wyniki. Zdolność modelu do zażądania działania sama w sobie nie zapewnia niezawodnego przepływu pracy.
Wnioski
Wdrażaj Ember tam, gdzie kryteria akceptacji są wystarczająco jasne, by je mierzyć. Użyteczne pierwsze wdrożenie to krok o dużej skali, który już ma znany wynik, taki jak routing oznaczonych zgłoszeń lub ekstrakcja pól z przeglądanych dokumentów. Porównaj koszt na udane zadanie, wskaźniki błędów i latencję z obecnym modelem zanim rozszerzysz jego rolę. Te dowody pokażą, czy Ember obniża koszt Twojego przepływu pracy przy zachowaniu potrzebnej jakości.
FAQ
Jak weryfikować wyniki ekstrakcji Muse Ember?
Zbuduj zestaw referencyjny dokumentów z odpowiedziami sprawdzonymi przez ludzi, w tym z brakującymi polami, nieczytelnymi skanami i sprzecznymi wartościami. Mierz dokładność per pole zamiast traktować każde poprawne JSON jako sukces. Sprawdź, czy każda wyodrębniona wartość jest wsparta cytowanym fragmentem źródła i kieruj niezgodności do przeglądu. Oddziela to niezawodność formatowania od niezawodności faktów.
Kiedy podzadanie Muse Ember powinno wrócić do głównego agenta?
Zdefiniuj warunki eskalacji przed wykonaniem: wymagany plik jest poza przypisanym zakresem, źródła się nie zgadzają, kontrola odbioru wielokrotnie zawodzi lub zadanie wymaga decyzji, do której pracownik nie był uprawniony. Zwróć dowody, podjęte kroki i nierozwiązaną kwestię do głównego agenta. Jasne przekazanie jest bardziej użyteczne niż pozwalanie pracownikowi na nieograniczone rozszerzanie zadania.
Co logować podczas testów Muse Ember w produkcji?
Rejestruj dokładnego dostawcę i identyfikator modelu, ustawienie rozumowania, tokeny wejściowe i naliczane tokeny wyjściowe, tokeny buforowane, liczbę wywołań narzędzi, ponowienia, latencję i wynik końcowej akceptacji. Przechowuj wynik walidacji obok rekordu użycia, aby móc obliczyć koszt na zaakceptowane zadanie. Porównuj podobne typy zadań osobno; średnia między routingiem, kodowaniem i długimi dokumentami może ukryć, gdzie model pomaga, a gdzie dodaje koszt.
Jak zapobiegać podwójnym działaniom w przepływie pracy Muse Ember?
Uczyń aplikację odpowiedzialną za tożsamość działania i stan ukończenia. Dla operacji takich jak tworzenie zgłoszenia przypisz stabilny klucz operacji, sprawdź, czy została już ukończona, i użyj wsparcia idempotencji API miejsca docelowego, gdy jest dostępne. Po upłynięciu limitu czasu sprawdź status działania przed ponownym próbą. Ten projekt zapobiega traktowaniu niepewnej odpowiedzi jako dowodu, że pierwotne działanie nigdy nie nastąpiło.