Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Step 5 Preview to flagowy model AI StepFun do inżynierii oprogramowania, badań finansowych i złożonych przepływów pracy agentów. Łączy konkurencyjne wyniki z opłacalnym inferencją, choć rezultaty różnią się między benchmarkami. Deweloperzy mogą uzyskać do niego dostęp przez hostowane API lub wdrożyć jego otwarte wagi, zależnie od budżetu, infrastruktury i wymagań wydajnościowych.
Kluczowe wnioski
Architektura: Step 5 Preview używa rzadkiej architektury MoE z łączną liczbą 600B parametrów i 27B aktywnych na token, co równoważy pojemność modelu i efektywność inferencji.
Kontekst i wsparcie multimodalne: Model obsługuje okno kontekstu 1M tokenów, wejścia tekstowe, obraz i wideo, oraz do 64K tokenów wyjściowych poprzez hostowane API.
Wyniki w benchmarkach: Step 5 Preview osiąga 67,7% na DeepSWE v1.1 i 66,4% na FrontierFinance, choć ustępuje kilku konkurentom na Terminal-Bench v4.
Cennik API: StepFun pobiera $1.00 za niecache’owane wejście, $0.10 za cache’owane wejście i $2.70 za wyjście na milion tokenów.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Elastyczność wdrożenia: Deweloperzy mogą skorzystać z hostowanego API StepFun lub samodzielnie hostować opublikowane wagi, używając zgodnych frameworków, takich jak vLLM, SGLang i Transformers.
Czym jest Step 5 Preview?
Step 5 Preview to duży wielomodalny model rozumowania opracowany przez StepFun (阶跃星辰). Celuje w obciążenia wymagające rozszerzonego rozumowania, wielokrotnego uruchamiania narzędzi oraz analizy dużych kolekcji informacji. StepFun zapewnia dostęp przez hostowane API i publikuje możliwe do pobrania wagi modelu.
W odróżnieniu od asystentów ogólnego przeznaczenia, optymalizowanych głównie pod kątem odpowiedzi konwersacyjnych, Step 5 Preview kładzie nacisk na wykonanie agentowe: zdolność planowania, używania narzędzi, inspekcji wyników pośrednich, korygowania błędów i kontynuowania w kierunku złożonego celu.
Specyfikacja (karta modelu i dokumentacja API powyżej)
Step 5 Preview
Deweloper
StepFun
Identyfikator modelu
step-5-preview
Kategoria modelu
Wielomodalny model rozumowania i agentowy LLM
Architektura
Rzadka Mixture-of-Experts
Łączna liczba parametrów
Około 600B
Aktywne parametry na token
Około 27B
Proporcja aktywnych parametrów
Około 4,5%
Okno kontekstu
Do 1M tokenów
Obsługiwane wejścia
Tekst, obrazy i wideo w hostowanym API
Maksymalne wyjście w hostowanym API
64k tokenów
Główne wyjście
Tekst
Tryby rozumowania
low, medium, high; reasoning_effort w Chat Completions
Wywoływanie narzędzi
Obsługiwane
Strukturyzowane wyjście
JSON Mode i JSON Schema w hostowanym API
Buforowanie promptów
Obsługiwane
Status hostowanego API
Dostępne od 19 października 2026
Hostowane API dokumentuje maksymalne wyjście 64k tokenów, podczas gdy karta modelu wymienia możliwość generowania sekwencji do 1M tokenów. To drugie nie jest obietnicą, że hostowany endpoint zaakceptuje 1M-tokenową odpowiedź. Dla przykładów samohostowanych w vLLM skonfigurowany budżet sekwencji 1M obejmuje łącznie wejście i wyjście; dostępna pamięć KV-cache i współbieżność mogą zmniejszyć użyteczną pojemność.
Jak działa architektura MoE 600B/27B
Konwencjonalny gęsty transformer aktywuje większość swoich parametrów podczas inferencji. Step 5 Preview zamiast tego używa rzadkiego trasowania do wyboru odpowiednich ekspertów. Przy około 27B aktywnych parametrach z 600B, około 4,5% całkowitej liczby parametrów uczestniczy w typowych obliczeniach dla tokenu.
To rozróżnienie pomaga wyjaśnić strategię opłacalności modelu. Jednak 27B aktywnych nie oznacza śladu wdrożenia 27B. Pełne wagi ekspertów nadal muszą być przechowywane i dostępne, co sprawia, że pojemność pamięci GPU, równoległość ekspertów i przepustowość łączy międzysieciowych to kluczowe kwestie.
Obsługiwane wejścia i limity wyjścia
Hostowane API akceptuje tekst, obrazy i wideo, z oknem kontekstu do 1M tokenów i maksymalnym wyjściem 64k tokenów. Te wejścia obsługują zadania takie jak analiza repozytoriów, badania dokumentów finansowych i interpretacja wizualna. W przypadku samohostowania używalna długość sekwencji zależy od konfiguracji runtime, dostępnej pamięci i współbieżności.
Wsparcie multimodalne i możliwości API mogą różnić się między konfiguracjami hostowanymi i samodzielnie wdrożonymi.
Jak Step 5 Preview wypada w benchmarkach?
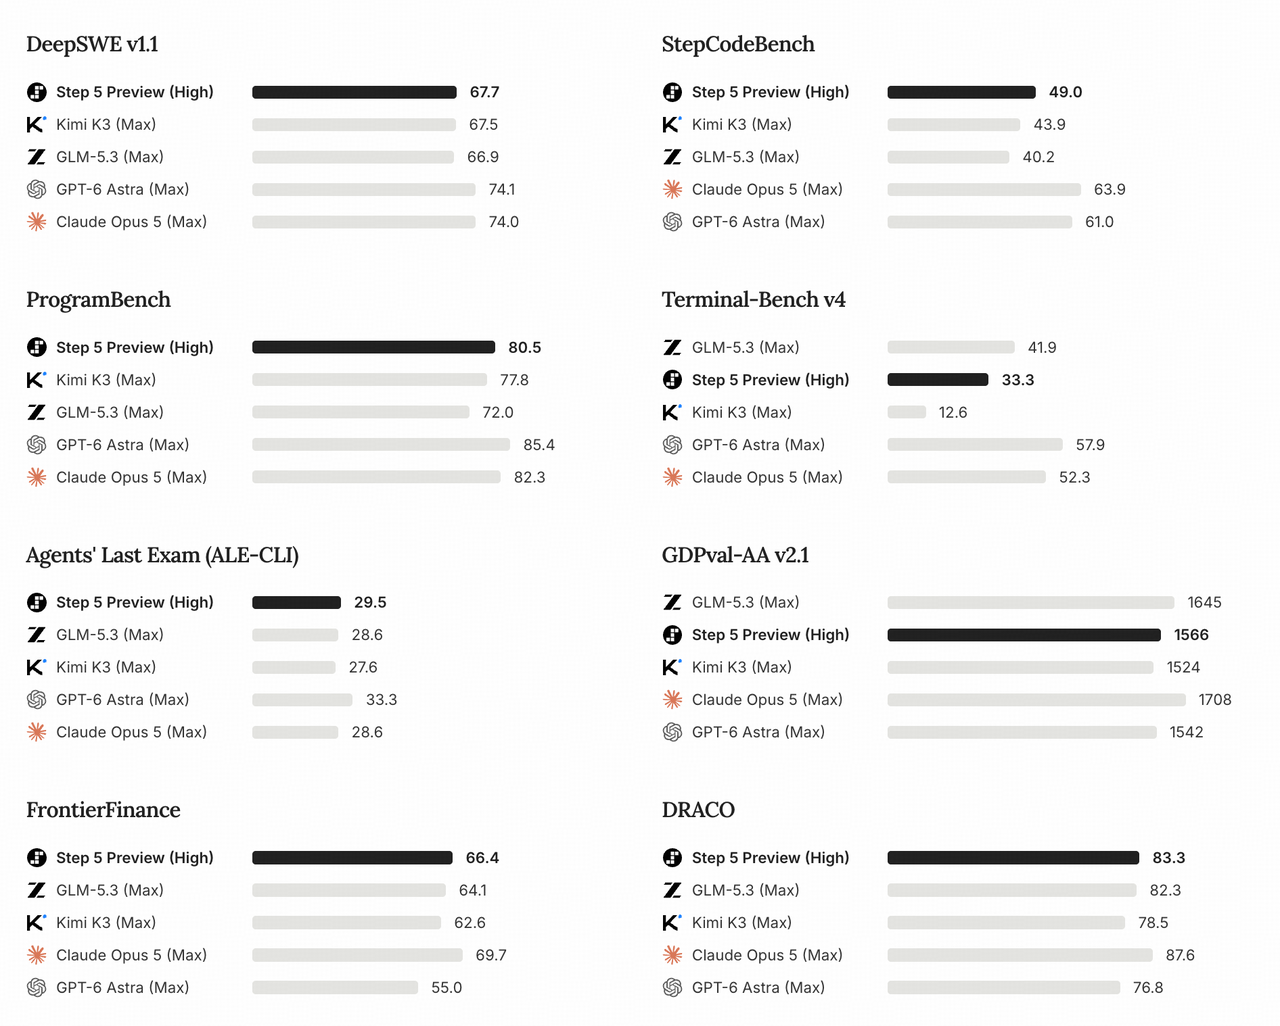
Poniższe to wyniki raportowane przez StepFun. Step 5 Preview używa ustawienia High; modele porównawcze używają Max. Dopasowanie nazw etykiet nie ustanawia równych nakładów obliczeniowych, a opublikowane wyniki nie mierzą opóźnienia aplikacyjnego ani kosztu na udane zadanie.
Oryginalny oficjalny wykres podsumowuje wyniki oceny wydawcy. Poniższe tabele wyodrębniają wyniki w kodowaniu, rozumowaniu i finansach istotne dla tej analizy.
Wydajność w kodowaniu i zadaniach agentowych
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
Wyniki to procenty; wyższe wartości oznaczają lepszą wydajność na danym benchmarku. DeepSWE v1.1 używa harnessu SWE-agent z temperature=1.0 i top_p=0.95; StepCodeBench raportuje avg@4, a ProgramBench raportuje pass rate. Każdy benchmark mierzy inne zadanie w swojej konfiguracji ewaluacyjnej, więc procenty nie są wymiennymi miarami dokładności. Opublikowane porównanie nie ustanawia identycznego sprzętu ani budżetów wykonania między modelami.
Na DeepSWE v1.1 Step 5 Preview uzyskuje 67,7%, nieznacznie wyprzedzając Kimi K3 i GLM-5.3. Sugeruje to konkurencyjną wydajność dla agentów kodujących pracujących z repozytoriami i automatycznymi zadaniami inżynierii oprogramowania.
ProgramBench dostarcza kolejnego pozytywnego sygnału. Step 5 Preview osiąga 80,5%, wobec 77,8% dla Kimi K3 i 72,0% dla GLM-5.3.
Jednak Terminal-Bench v4 ujawnia istotne ograniczenie: wynik 33,3% Step 5 Preview pozostaje w tyle za GLM-5.3 z 41,9%, podczas gdy GPT-6 Astra osiąga 57,9%. Wniosek jest taki, że Step 5 Preview jest konkurencyjny w zadaniach inżynierii oprogramowania zorientowanych na repozytoria, ale jego względna przewaga nie rozciąga się jednolicie na wykonanie terminalowe i złożone debugowanie.
Wydajność w rozumowaniu i wiedzy
Benchmark
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
Step 5 Preview uzyskuje 93,5% na GPQA Diamond, dorównując Kimi K3 i pozostając w tyle za GPT-6 Astra z 96,1%. Na AA-LCR v1.1 jego wynik 88,3% jest nieco poniżej 88,7% Kimi K3 i powyżej 80,7% GPT-6 Astra. Ustępuje także Kimi K3 i GPT-6 Astra na Humanity’s Last Exam i CritPt. Wyniki wskazują na konkurencyjną wiedzę i rozumowanie w długim kontekście, ze względnymi mocnymi stronami zależnymi od zadania.
Badania finansowe i wyceny
Badania finansowe to jeden z najbardziej wyróżniających się obszarów zastosowań Step 5 Preview. Model jest zaprojektowany do łączenia rozumowania ilościowego, pozyskiwania dowodów i ustrukturyzowanej analizy. Te możliwości są szczególnie istotne dla wyceny, interpretacji dokumentów finansowych i badań inwestycyjnych.
StepFun wprowadził FinStepBench, aby oceniać badania finansowe na wielu etapach, od gromadzenia informacji po formułowanie obronnych wniosków.
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
Wyższe wyniki wskazują na silniejszą wydajność w benchmarku. FinStepBench jest rozwijany przez StepFun, dlatego niezależna weryfikacja jest szczególnie ważna.
Step 5 Preview osiąga 66,4% na FrontierFinance, wyprzedzając Kimi K3, GLM-5.3 i GPT-6 Astra w raportowanych konfiguracjach. Jednak Claude Opus 5 pozostaje na prowadzeniu z 69,7%.
Wynik FinStepBench DeepResearch jest szczególnie godny uwagi. Step 5 Preview osiąga 55,8%, wobec 48,9% Kimi K3 i 53,3% GLM-5.3. Sugeruje to, że model może dobrze sprawdzać się w przepływach badań finansowych wymagających pozyskiwania, syntezy i rozszerzonej analizy.
Jego wynik CorporateValuation przedstawia bardziej zniuansowany obraz. Przy 60,6% Step 5 Preview znacznie ustępuje 77,3% GPT-6 Astra. Dlatego Step 5 Preview nie należy uznawać za uniwersalnie lepszy do analizy finansowej. Jego względna pozycja jest silniejsza w DeepResearch niż w CorporateValuation, co wspiera ocenę specyficzną dla zadania zamiast szerokiego roszczenia o wyższości finansowej.
W zastosowaniach produkcyjnych wyniki finansowe nadal wymagają niezależnie weryfikowanych obliczeń, udokumentowanych założeń i możliwych do prześledzenia dowodów źródłowych.
Step 5 Preview vs inne modele AI
Step 5 Preview konkuruje zarówno z hostowanymi alternatywami, jak i z proprietarnymi usługami frontier. Wyniki benchmarków pomagają zidentyfikować kandydatów; dostęp do API, obsługa wejść, kontrola wdrożenia i rzeczywisty koszt pracy determinują, który kandydat pasuje do aplikacji produkcyjnej.
Step 5 Preview oferuje udokumentowany checkpoint rzadkiej MoE 600B/27B i opcję samohostowania. W przypadku alternatyw dostępność wag, liczba parametrów, limity kontekstu i akceptowane wejścia zależą od modelu i endpointu. Opublikowane benchmarki mogą pomóc zbudować shortlistę; reprezentatywne zadania z zakresu kodowania i badań ujawniają, jak każda usługa zachowuje się w praktyce.
Step 5 Preview vs Kimi K3
Step 5 Preview wypada nieco lepiej na DeepSWE v1.1, ProgramBench i FrontierFinance. Kimi K3 pozostaje konkurencyjny w rozumowaniu i niektórych innych ocenach technicznych. Praktyczna różnica dotyczy mniej decydującej przewagi inteligencji, a bardziej kosztu, warunków serwowania i niezawodności specyficznej dla zadania dostępnej dla deweloperów.
Step 5 Preview vs GLM-5.3
Step 5 Preview prowadzi nad GLM-5.3 w kilku ocenach finansowych i rozwoju oprogramowania. Jednak mocniejszy wynik GLM-5.3 na Terminal-Bench v4 sugeruje przewagę w raportowanych zadaniach zorientowanych na terminal. Dla agentów kodujących porównuj udane modyfikacje repozytorium, błędy w wywołaniach narzędzi, czas wykonania i poprawność poprawek, zamiast polegać na jednym wynikowym wskaźniku.
Step 5 Preview vs GPT-6 Astra i Claude Opus 5
Modele proprietarne klasy frontier na ogół wypadają lepiej w najtrudniejszych benchmarkach inżynierii oprogramowania. Główną zaletą Step 5 Preview jest to, że zbliża się do konkurencyjnych możliwości w wybranych obciążeniach, oferując jednocześnie otwarte wagi do wdrożenia i relatywnie przystępne ceny API.
Wybierz model premium, gdy koszt błędu jest wysoki i dodatkowa dokładność zadania uzasadnia większy wydatek. Rozważ Step 5 Preview, gdy większe znaczenie mają cena, kontrola wdrożenia i powtarzalne wykonanie przez agenta.
Ile kosztuje API Step 5 Preview?
Wartość Step 5 Preview zależy zarówno od możliwości zadaniowych, jak i kosztu operacyjnego. Przepływy agentowe mogą obejmować dziesiątki wywołań, powtarzalne pobieranie dokumentów i ponowienia, więc niższa cena tokenu pomaga tylko wtedy, gdy model niezawodnie kończy zadanie. Koszt na pomyślnie ukończone zadanie jest użytecznym uzupełnieniem stawek poniżej.
Dostępność API i ceny tokenów
Ten snapshot z 19 października 2026 porównuje natywne stawki API StepFun (https://platform.stepfun.ai/docs/en/guides/pricing/details) ze stawkami CometAPI podlinkowanymi w sekcji porównania modeli. Wszystkie ceny w dolarach amerykańskich za milion tokenów. Usługi mają różne warunki rozliczeń, cache i endpointów; „nie podano” oznacza, że źródłowy snapshot artykułu nie podaje stawki dla cache’owanego wejścia.
Model
Kanał usługi
Model ID
Niecache’owane wejście / 1M tokenów
Cache’owane wejście / 1M tokenów
Wyjście / 1M tokenów
Step 5 Preview
Natywne API StepFun
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Nie podano
$12.00
GLM-5.3
CometAPI
glm-5.3
$1.12
Nie podano
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (warstwa krótkiego kontekstu)
Nie podano
$40.00 (warstwa krótkiego kontekstu)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Nie podano
$20.00
Warstwa krótkiego kontekstu GPT-6 Astra obowiązuje do 272 000 tokenów; cytowane stawki dla długiego kontekstu to $16 za wejście i $60 za wyjście na milion tokenów. Podane stawki nie obejmują narzędzi, ponowień i infrastruktury. Dostępność Step 5 Preview przez CometAPI nie jest ustanowiona tym porównaniem; poniższy przykład Step 5 Preview używa natywnego endpointu StepFun.
Stawka wejściowa przy trafieniu w cache jest o 90% niższa od stawki niecache’owanej. Cena niecache’owana obejmuje zapis nowej treści do cache, podczas gdy billing wyjścia obejmuje zarówno tokeny rozumowania, jak i końcowej odpowiedzi. Powtarzalny tekst promptu uzyskuje niższą stawkę tylko wtedy, gdy usługa raportuje kwalifikujące trafienie w cache; sama widoczna długość odpowiedzi zaniża rozliczane wyjście.
Przykładowe kalkulacje kosztów
Obciążenie API
Niecache’owane wejście
Cache’owane wejście
Wyjście
Szacunkowy koszt
Krótkie zapytanie analityczne
10K
0
5K
$0.0235
Średni przepływ kodowania
100K
0
20K
$0.154
Powtarzalne żądanie agenta
10K
90K
20K
$0.073
Analiza dużego dokumentu
500K
0
30K
$0.581
Długi kontekst z cache
100K
400K
50K
$0.275
Wzór kosztu: C = (Tu × Pu + Tc × Pc + To × Po) / 1 000 000, gdzie Tu/Tc/To oznaczają odpowiednio niecache’owane wejście, cache’owane wejście i rozliczane tokeny wyjścia, a Pu/Pc/Po to ich ceny za milion tokenów.
Rozważ dwa żądania StepFun z tymi samymi 100 000 tokenami wejściowymi i 20 000 rozliczanymi tokenami wyjścia:
Trafienie w cache nie nastąpiło: wszystkie 100 000 tokenów wejścia są niecache’owane. Koszt = (100 000 × $1.00 + 20 000 × $2.70) / 1 000 000 = $0.154.
Trafienie w cache: 90 000 tokenów wejścia kwalifikuje się do stawki cache, a 10 000 pozostaje niecache’owane. Koszt = (10 000 × $1.00 + 90 000 × $0.10 + 20 000 × $2.70) / 1 000 000 = $0.073.
Przykład z trafieniem w cache oszczędza $0.081, czyli około 52,6%, przy tej samej objętości wejścia i wyjścia. Oszczędność zależy od kwalifikującego trafienia w cache raportowanego przez usługę. Oba przykłady nie obejmują kosztów narzędzi zewnętrznych, ponowień i infrastruktury.
Same ceny tokenów nie determinują modelu o najlepszej wartości. Agent wymagający kilku ponowień może być droższy niż model o wyższej cenie, który odnosi sukces za pierwszym razem. Dla wiarygodnego porównania kosztów używaj kosztu na pomyślnie ukończone zadanie obok cen tokenów.
Czy Step 5 Preview jest open source i czy można go uruchomić lokalnie?
StepFun publikuje możliwe do pobrania wagi przez oficjalne repozytoria na Hugging Face, z wariantami FP8, BF16 i NVFP4 dostępnymi na 19 października 2026. Dostęp do wag umożliwia samodzielne wdrożenie, ale nie czyni modelu równoważnym z małym modelem gęstym pod względem wymagań pamięci.
Dostępne pliki obejmują checkpoint Step 5 Preview, wersję BF16 i wersję NVFP4.
Terminologia ma znaczenie: Step 5 Preview udostępnia otwarte wagi na podstawie StepFun Model License 1.0 (https://huggingface.co/stepfun-ai/Step-5-Preview/blob/main/LICENSE.txt). Licencja zawiera atrybucję specyficzną dla modelu i warunki licencji komercyjnej. Oceń te warunki pod kątem planowanego użycia i dystrybucji przed wdrożeniem.
FP8 z vLLM: 4 × NVIDIA B300 lub 8 × NVIDIA H200, serwowanie API kompatybilnego z OpenAI.
BF16 z vLLM: 8 × NVIDIA B300 lub 16 × NVIDIA H200, serwowanie API kompatybilnego z OpenAI.
FP8 z SGLang: 4 × NVIDIA B300, serwowanie API kompatybilnego z OpenAI; FP8 z Transformers: 8 × NVIDIA H200 do offline’owej generacji.
To konfiguracje referencyjne, a nie gwarantowane minima dla każdego checkpointu, runtime’u, długości kontekstu czy ustawień współbieżności. Rzadkie aktywacje zmniejszają obliczenia, ale przechowywanie wag ekspertów i pamięć KV cache pozostają głównymi czynnikami.
Model 600B stawia także wyzwania wykraczające poza pojemność pamięci, w tym komunikację wielo-GPU, kompatybilność frameworków, ładowanie checkpointów i przepustowość w długim kontekście. Dla zespołów bez dużych klastrów GPU hostowane API jest zwykle bardziej praktycznym punktem startowym.
Jak deweloperzy mogą używać API Step 5 Preview?
StepFun wspiera interfejs Chat Completions kompatybilny z OpenAI. Ustaw zmienną środowiskową STEPFUN_API_KEY przed uruchomieniem poniższego przykładu w Pythonie; max_tokens ogranicza wygenerowane wyjście tego żądania. Użyj klucza API i warunków rozliczeń dla wybranej platformy regionalnej: ten przykład zachowuje endpoint api.stepfun.ai, podczas gdy powyższe ceny w dolarach pochodzą z międzynarodowej platformy StepFun.
Przykład w Pythonie: wyślij ograniczone żądanie tekstowe do API StepFun i wydrukuj zwróconą odpowiedź.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Przeanalizuj ryzyka architektoniczne migracji "
            "monolitycznej aplikacji do architektury mikroserwisów."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Przed użyciem produkcyjnym potwierdź akceptowane parametry i limity generacji wybranego endpointu StepFun. Wysiłek rozumowania, caching promptów, schematy narzędzi i budżety wyjścia mogą wpływać na niezawodność, opóźnienie i ostateczny rachunek.
Step 5 Preview w przepływach agentowych
Przeczytaj dokumentację repozytorium i odpowiednie pliki.
Zidentyfikuj żądaną zmianę i zaproponuj plan.
Zmodyfikuj wybrane fragmenty kodu i uruchom testy przez narzędzia zewnętrzne.
Model generuje wnioskowanie i żądania narzędzi; aplikacja zapewnia rzeczywisty dostęp do plików, środowiska wykonawcze, uprawnienia i kontrole bezpieczeństwa. Sama zdolność modelu nie gwarantuje autonomicznego wykonania.
Alternatywne API modeli w CometAPI
CometAPI zapewnia dostęp do alternatywnych modeli podlinkowanych powyżej przez wspólną usługę integracyjną. Wybierz udokumentowany endpoint i format żądania każdego modelu, a następnie porównaj współczynniki powodzenia, użycie tokenów, ponowienia i opóźnienie end-to-end na tym samym obciążeniu.
Powyższy przykład używa natywnego endpointu StepFun. Przejście na bramę wymaga potwierdzonej dostępności Step 5 Preview oraz udokumentowanego identyfikatora modelu, endpointu i warunków rozliczeń tej bramy.
Kiedy wybrać Step 5 Preview?
Wybierz do kodowania w repozytoriach i badań opartych na obszernych dokumentach, gdy testy reprezentatywne potwierdzą niezawodne wyniki. Jego długi kontekst oraz opublikowane wyniki w kodowaniu i finansach czynią go kandydatem, podczas gdy wyniki na Terminal-Bench v4 i CorporateValuation pokazują, dlaczego testy specyficzne dla obciążenia mają znaczenie.
Wybierz hostowane API, gdy chcesz zacząć bez operowania dużym klastrem GPU. Porównuj koszt na zaakceptowane zadanie, wskaźniki trafień w cache, ponowienia i opóźnienie; duże okno kontekstu nie gwarantuje szybkich odpowiedzi ani niższego łącznego kosztu.
Wybierz samohostowanie, gdy kontrola wdrożenia uzasadnia obciążenia sprzętowe i operacyjne. Zarezerwuj budżet na pełne przechowywanie wag ekspertów, KV cache, komunikację między GPU i wymagania licencyjne. Dla doniosłych prac finansowych lub inżynierskich uwzględnij weryfikację źródeł, wykrywanie błędów i przegląd ludzki.
FAQ
Jak wybrać poziom wysiłku rozumowania w Step 5 Preview?
Zacznij od małego zestawu reprezentatywnych zadań i porównaj low, medium i high używając tych samych kryteriów akceptacji. Rejestruj poprawność, rozliczane wyjście, opóźnienie i awarie narzędzi. Użyj najniższego ustawienia, które konsekwentnie spełnia próg jakości; opublikowane wyniki High nie przewidują zachowania low ani medium. Postępuj zgodnie z przewodnikiem konfiguracji rozumowania i ustaw reasoning_effort explicite w Chat Completions podczas porównań.
Dlaczego żądanie Step 5 Preview może zatrzymać się przed 64k tokenów wyjściowych?
Dokumentowane maksimum to sufit, a nie docelowa długość. Żądanie może zatrzymać się wcześniej, ponieważ osiągnęło swój budżet max_tokens, zwróciło naturalne zakończenie lub wygenerowało wywołanie narzędzia, które aplikacja musi obsłużyć. Sprawdź zwrócony powód zakończenia i wszelkie żądania narzędzi przed automatycznym ponowieniem. Krótsza ukończona odpowiedź nie wskazuje na błąd okna kontekstu.
Jak testować wejścia wideo Step 5 Preview?
Zacznij od krótkiego, reprezentatywnego klipu i pytania, którego odpowiedź możesz zweryfikować. Specyfikacja wejścia wideo hostowanego API akceptuje wideo przez URL, Base64 lub referencję stepfile; udokumentowane formaty obejmują MP4, QuickTime i Matroska. Dla wejścia przez URL dokumentacja określa pojedyncze pliki MP4 poniżej 128 MB i zaleca mniej niż pięć minut. Potwierdź limity formatu i rozmiaru przed batchingiem i testuj pytania temporalne oraz rozpoznawanie pojedynczych klatek.
Które metryki ujawniają rzeczywisty koszt agenta Step 5 Preview?
Mierz zaakceptowane ukończenia zadań, łączne tokeny wejścia i wyjścia w całej konwersacji, trafienia w cache, ponowienia, opłaty za narzędzia zewnętrzne i czas upływający. Podziel łączny koszt wykonania przez liczbę pomyślnie ukończonych zadań, utrzymując stałe kryterium sukcesu dla modeli. To oddaje ekonomiczny efekt tańszego wywołania, które wymaga więcej prób, lub runu o wyższym wysiłku, który redukuje późniejsze błędy.
Podsumowanie
Step 5 Preview warto ocenić, gdy aplikacja potrzebuje przetwarzania w długim kontekście, powtarzalnego użycia narzędzi lub kontroli nad wdrożeniem modelu. Opublikowane przez StepFun wyniki czynią go kandydatem do kodowania w repozytoriach i badań finansowych, podczas gdy Terminal-Bench v4 i CorporateValuation pokazują obszary, gdzie wymienione alternatywy uzyskują wyższe wyniki. Porównuj modele, używając stałych kryteriów akceptacji, kosztu na zaakceptowane zadanie i opóźnienia end-to-end. W przypadku samohostowania uwzględnij koszty infrastruktury i wymagania licencyjne w decyzji.