
GPT-6 Astra e Claude Fable 5.1 chegaram com apenas dois dias de diferença: Astra foi lançado em 3 de setembro, enquanto Fable 5.1 foi lançado em 1º de setembro. Apesar da proximidade, suas diferenças mais importantes surgem no formato dos benchmarks, na execução de ferramentas e na economia do cache.
A semelhança acaba quando a carga de trabalho começa. As avaliações de lançamento da OpenAI colocam Astra à frente em vários testes de programação, ciência, uso de computador e trabalho profissional, enquanto os benchmarks publicados pela Anthropic mostram Fable 5.1 liderando no Humanity’s Last Exam. Fable 5.1 também tem um preço oficial de leitura de cache mais baixo, o que pode mudar materialmente a economia de agentes de longa duração.
Portanto, a pergunta útil não é simplesmente qual modelo tem a pontuação de benchmark mais alta. A questão prática é qual modelo conclui sua carga de trabalho de forma mais confiável e econômica.
Resposta curta: Astra é o padrão mais forte para agentes com execução pesada, programação, uso de computador e fluxos de trabalho científicos orientados por ferramentas. Fable 5.1 é especialmente atraente para raciocínio amplo e difícil, trabalho assíncrono de longa duração e aplicações que reutilizam repetidamente contextos muito grandes em cache.
GPT-6 Astra vs Claude Fable 5.1 em resumo
| Especificação | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Desenvolvedor | OpenAI | Anthropic |
| Data de lançamento | Sep 3, 2026 | Sep 1, 2026 |
| ID do modelo na API | gpt-6-astra | claude-fable-5-1 |
| Janela de contexto | 1,050,000 tokens | 1,000,000 tokens |
| Saída máxima | 128,000 tokens | 128,000 tokens |
| Modalidades de entrada | Text, images | Text, images |
| Modalidade de saída | Text | Text |
| Corte de conhecimento | Apr 30, 2026 | Jun 2026 |
| Raciocínio | low / medium / high / xhigh / max | Adaptive, always on |
| Esforço padrão | — | high |
| Entrada / saída oficial | $10 / $50 per MTok | $10 / $50 per MTok |
| Leitura de cache oficial | $1 / MTok | $0.25 / MTok |
| Precificação de contexto longo | Higher tier above 272K input | Standard model rate across 1M context |
| Posicionamento principal | End-to-end execution, coding, computer use | Demanding reasoning, long-horizon agents |
Informações e preços verificados em 7 de setembro de 2026. As especificações e os preços dos provedores podem mudar após a publicação.
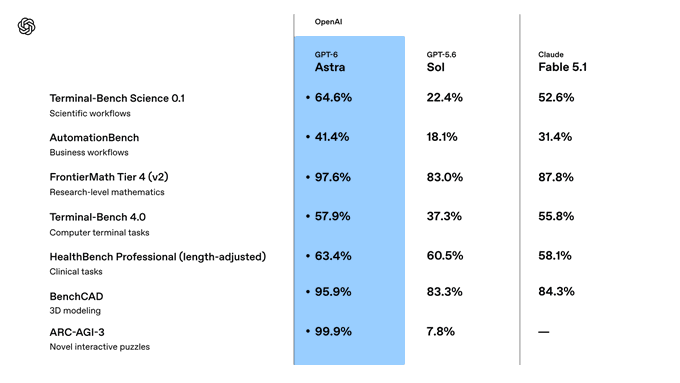
Fonte: OpenAI official benchmark
O que é GPT-6 Astra?
A OpenAI introduziu GPT-6 Astra em 3 de setembro de 2026 como seu modelo mais capaz para trabalhos profissionais difíceis e de ponta a ponta. Em vez de focar em perguntas isoladas, Astra é projetado para concluir fluxos de trabalho complexos que combinam raciocínio, programação, pesquisa, interação com computador e criação de documentos. Ele pode trabalhar em várias etapas, usar ferramentas e contextos fornecidos e se adaptar quando os usuários revisam requisitos ou mudam de direção durante uma tarefa. As notas de lançamento da OpenAI destacam aplicações como produção de documentos, planilhas e apresentações que seguem instruções e modelos específicos.
O modelo oferece janela de contexto de 1.050.000 tokens e saída máxima de 128.000 tokens, permitindo processar grandes bases de código, coleções extensas de documentos ou históricos de agentes de longa duração em um único fluxo. Seu esforço de raciocínio pode ser configurado em low, medium, high, xhigh ou max, permitindo que desenvolvedores equilibrem velocidade de resposta e profundidade computacional de acordo com a dificuldade de cada tarefa.
O que é Claude Fable 5.1?
Anthropic Anthropic lançou Claude Fable 5.1 em 1º de setembro de 2026 como seu modelo de mais alto nível para raciocínio exigente e trabalho agente de longo horizonte. Ele se baseia no Claude Fable 5 com melhorias em tarefas de programação de longa duração, pesquisa em múltiplas etapas e criação ou análise de documentos, planilhas e apresentações. A Anthropic o recomenda para cargas de trabalho em que raciocínio sustentado e execução confiável importam mais do que velocidade bruta de resposta — especialmente quando Claude Opus 5 em configurações de esforço mais alto não oferece desempenho suficiente.
De acordo com a especificação oficial do Claude Fable 5.1, o modelo oferece uma janela de contexto de 1 milhão de tokens e saída máxima de 128.000 tokens. Isso lhe dá capacidade suficiente para examinar repositórios grandes, registros empresariais extensos, coleções de pesquisa ou trajetórias prolongadas de agentes sem dividir agressivamente o material em solicitações separadas. Ele aceita entradas de texto e imagem e produz saída em texto, com corte de conhecimento em junho de 2026.
Comparação de benchmarks: Astra vence mais linhas, mas não todas as importantes
Uma comparação de benchmark entre fornecedores concorrentes requer mais cautela do que uma comparação normal de geração a geração. A OpenAI testou Fable 5.1 em várias avaliações de lançamento do Astra, enquanto a Anthropic usou seus próprios frameworks e, em alguns casos, uma versão de tarefa mais recente. Isso torna mais limpas as comparações nos testes em que definições e configurações relatadas se alinham bem o suficiente para apoiar uma decisão direta.
GPT-6 Astra vs Claude Fable 5.1 :which is better for Coding and Agentic Software
Programação é uma das áreas de força mais claras do Astra. Na tabela de lançamento publicada pela OpenAI, Astra marca 57.9% versus 55.8% no Terminal-Bench 4.0, 74.1% versus 67.4% no DeepSWE v1.1 e 63.9% versus 57.8% em uma avaliação interna de migração de banco de dados.
| Benchmark de programação | GPT-6 Astra | Claude Fable 5.1 | Resultado |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% | Astra +2.1 pts |
| DeepSWE v1.1 | 74.1% | 67.4% | Astra +6.7 pts |
| FrontierCode 1.1 Extended | 64.5% | 63.6% | Astra +0.9 pts |
| FrontierCode 1.1 Main | 53.3% | 50.9% | Astra +2.4 pts |
| Migração de banco de dados, interna | 63.9% | 57.8% | Astra +6.1 pts |
Astra representa um avanço substancial para modelos focados em execução: seus resultados publicados lideram Fable 5.1 no Terminal-Bench 4.0, DeepSWE v1.1 e na avaliação de migração de banco de dados, reforçando sua vantagem quando o código precisa ser executado, testado e verificado entre ferramentas.
A conclusão não é que Fable 5.1 seja fraco em programação. A Anthropic o descreve como seu modelo mais capaz para projetos de programação ambiciosos, e seu próprio resultado no CursorBench 3.2.0 chega a 73.4%. A diferença está na forma da carga de trabalho: a vantagem do Astra torna-se mais convincente quando a programação é misturada com execução de shell, navegação de repositório, verificação e outras ferramentas.
Vencedor para engenharia de software com execução pesada: Astra. Um agente de repositório de longa duração é uma decisão mais apertada porque coerência sustentada, comportamento de cache e eficiência de tokens podem importar tanto quanto uma pontuação de benchmark.
GPT-6 Astra vs Fable 5.1 :which is better for Reasoning and Science
A comparação de raciocínio é mais interessante porque não há varredura. As avaliações publicadas pela OpenAI relatam Astra em 97.6% no FrontierMath Tier 4, 96.0% no GPQA Diamond e 64.6% no Terminal-Bench Science 0.1. Fable 5.1 registra 87.8%, 93.7% e 52.6%, respectivamente, na mesma comparação.
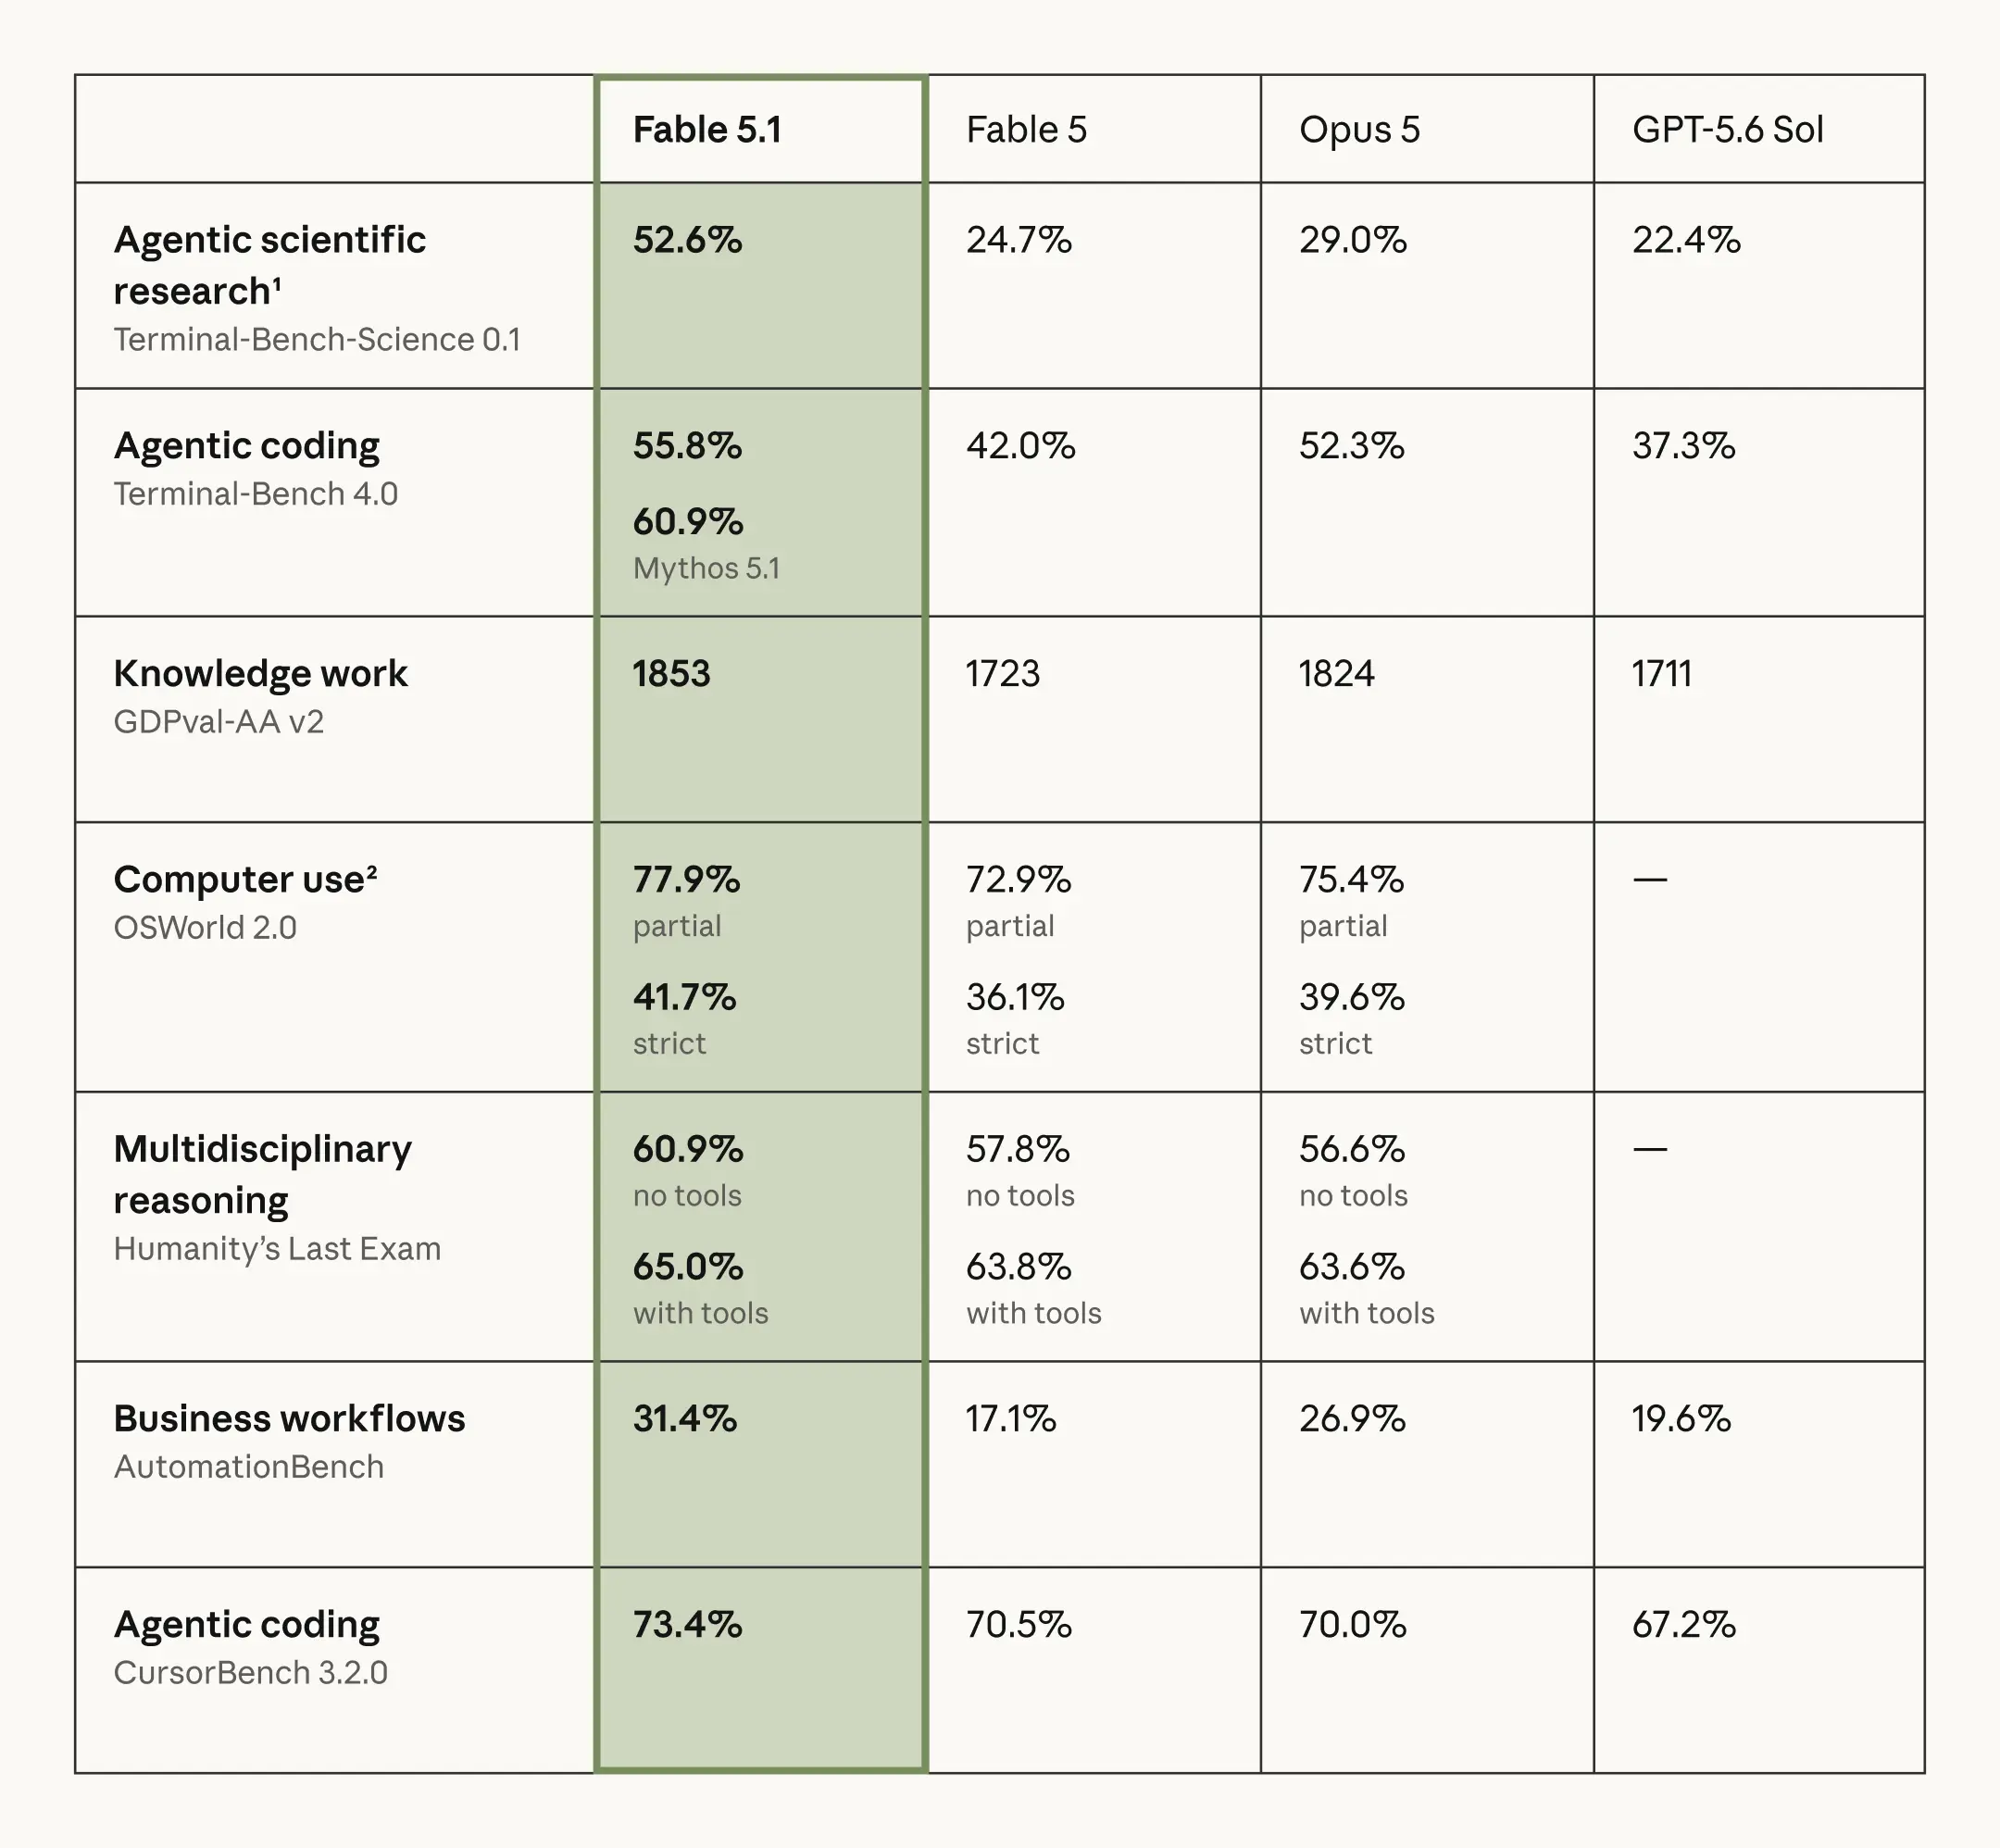
Fable 5.1 reverte o resultado no Humanity’s Last Exam com ferramentas, marcando 65.0% contra 57.2% do Astra. A tabela oficial de benchmark da Anthropic relata independentemente o mesmo resultado de 65.0% para Fable 5.1.
| Benchmark de raciocínio / ciência | GPT-6 Astra | Claude Fable 5.1 | Vencedor |
|---|---|---|---|
| FrontierMath Tier 4 v2 | 97.6% | 87.8% | Astra |
| GPQA Diamond | 96.0% | 93.7% | Astra |
| Terminal-Bench Science 0.1 | 64.6% | 52.6% | Astra |
| Humanity's Last Exam, com ferramentas | 57.2% | 65.0% | Fable 5.1 |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 | Fable 5.1 |
Essa distinção importa. FrontierMath e Terminal-Bench Science enfatizam solução de problemas matemáticos ou científicos especializados, especialmente quando o raciocínio interage com ferramentas e ambientes externos. Humanity’s Last Exam é mais amplo e multidisciplinar. Uma leitura prática é que Astra parece mais forte em raciocínio técnico profundo executado por ferramentas, enquanto Fable 5.1 mantém uma vantagem em avaliações de raciocínio de fronteira mais amplas.
Fonte: Anthropic official benchmark
Uso de computador e trabalho profissional favorecem GPT-6 Astra
Uma comparação direta OSWorld Astra versus Fable 5.1 seria enganosa. A nota de benchmark da Anthropic diz que Fable 5.1 usa a versão de tarefas dos autores de agosto de 2026. Seu gráfico reporta 77.9% parcial e 41.7% estrito, mas essas cifras não são equivalentes ao resultado de 72.6% da OpenAI.
| Benchmark profissional | GPT-6 Astra | Claude Fable 5.1 | Resultado |
|---|---|---|---|
| AutomationBench | 41.4% | 31.4% | Astra +10.0 pts |
| BenchCAD | 95.9% | 84.3% | Astra +11.6 pts |
| Terminal-Bench Science | 64.6% | 52.6% | Astra +12.0 pts |
A OpenAI também treina especificamente Astra para produzir documentos, planilhas e apresentações e diz que ele é projetado para executar fluxos de trabalho profissionais em múltiplas etapas em vez de apenas gerar o componente de texto. Fable 5.1 também é construído para agentes de longa duração, operação de navegador, pesquisa, programação e fluxos de trabalho de documentos profissionais, mas Astra atualmente tem evidências publicadas mais fortes para execução mediada por computador e produção de artefatos.
Vencedor para agentes de uso de computador e automação profissional: Astra.
GPT-6 Astra vs Claude Fable 5.1 Contexto longo: 1.05M vs 1M é a comparação errada
Astra tecnicamente tem a janela de contexto maior: 1.05 milhão de tokens versus 1 milhão do Fable 5.1. Essa diferença de 5% é improvável que decida uma arquitetura de produção. A precificação dentro da janela de contexto pode.
A regra de precificação de contexto longo da OpenAI se aplica quando uma solicitação contém mais de 272K tokens de entrada: taxas de entrada e cache dobram, enquanto a taxa de saída sobe 1.5 vezes para a solicitação completa. As taxas efetivas do Astra tornam-se, portanto, $20 de entrada, $2 de entrada em cache e $75 de saída por MTok.
A especificação do Fable 5.1 documenta uma janela de contexto de 1M com $10 de entrada, $50 de saída e $0.25 de leituras de cache por MTok. Para aplicações que rotineiramente carregam 300K, 500K ou 900K tokens em uma solicitação, o tamanho nominal da janela de contexto, portanto, conta apenas metade da história.
Para contextos muito grandes, Fable 5.1 tem uma economia de tabela de preços mais limpa, especialmente quando grande parte do contexto pode ser cacheada.
GPT-6 Astra vs Claude Fable 5.1 Preços: mesmo preço de base, economia de agentes muito diferentes
Nas taxas oficiais Standard, os dois modelos começam empatados em entrada e saída de texto não cacheados.
| Componente de preço | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Entrada / MTok | $10.00 | $10.00 |
| Saída / MTok | $50.00 | $50.00 |
| Escrita de cache por 5 min / MTok | $12.50 | $12.50 |
| Leitura de cache / MTok | $1.00 | $0.25 |
| Desconto de entrada/saída em lote | 50% | 50% |
| Sobretaxa de contexto longo | Above 272K input | None across standard 1M context |
O número-chave não é $10 ou $50. É $0.25. A Anthropic reduziu a taxa de leitura de cache do Fable 5.1 para $0.25 por milhão de tokens, um quarto do preço padrão de $1 do Astra para entrada cacheada e um oitavo da taxa de cache de contexto longo de $2 do Astra.
Isso pode importar enormemente para um loop de agente. Uma aplicação de longa duração pode carregar repetidamente um prompt de sistema grande, definições de ferramentas, contexto de repositório e documentos de referência ao longo de dezenas de turnos. Quando o prefixo estável é lido repetidamente do cache, a precificação de cache se compõe de uma maneira que um benchmark de turno único nunca captura.
A estimativa de carga de trabalho da Anthropic diz que o preço de cache mais baixo pode reduzir o custo típico de carga de trabalho do Fable 5.1 em cerca de 25% e o custo de cargas altamente agênticas em até aproximadamente 45%. São estimativas do fornecedor, não garantias universais, mas mostram por que a economia de cache merece sua própria dimensão de comparação.
Isso torna Fable 5.1 mais barato?
Não automaticamente. Um modelo com tokens mais caros ainda pode produzir uma fatura menor se resolver a tarefa com menos tokens, menos tentativas, menos chamadas de ferramenta falhas ou menor tempo de relógio. É por isso que o custo por tarefa bem-sucedida é mais informativo do que o preço por milhão de tokens.
O veredito de precificação prática é dividido: Fable 5.1 vence a tabela de preços para cargas de trabalho muito pesadas em cache e de contexto muito longo. Astra ainda pode vencer em custo por tarefa concluída quando sua vantagem de execução reduz materialmente tentativas, uso de tokens ou tempo de execução.
Preços na CometAPI estreitam a decisão para a qualidade da carga de trabalho
Ambos os modelos estão disponíveis via CometAPI. A API GPT-6 Astra na CometAPI começa em $8 por milhão de tokens de entrada, enquanto a API Claude Fable 5.1 na CometAPI começa na mesma taxa de $8 de entrada. Isso é 20% abaixo da taxa base de entrada dos provedores.
| Precificação na API | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Entrada / saída oficial | $10 / $50 | $10 / $50 |
| Entrada / saída na CometAPI | $8 / $40 | $8 / $40 |
| Redução vs taxa base oficial | 20% | 20% |
Isso cria uma configuração de produção útil: em vez de decidir apenas com base em tabelas públicas de benchmark, os desenvolvedores podem avaliar a mesma carga de trabalho contra ambos os IDs de modelo por meio de um ambiente de API único e comparar taxa de resultado aceito, consumo de tokens, latência, falhas de ferramentas e gasto total. Preços e regras de cobrança podem mudar, portanto, o orçamento de produção deve usar a configuração da API ao vivo em vez de codificar os valores deste artigo.
Uso de ferramentas e design de agentes: objetivo similar, filosofia diferente
Ambos os modelos são projetados para agentes, mas suas APIs expõem filosofias diferentes. GPT-6 Astra suporta um ambiente rico em ferramentas na Responses API. O conjunto de ferramentas suportadas pela OpenAI inclui busca na web, busca em arquivos, geração de imagens, code interpreter, shell hospedado, Apply Patch, uso de computador, MCP e busca de ferramentas. Esforço de raciocínio configurável permite que uma aplicação decida quanto compute gastar.
O modelo de raciocínio do Fable 5.1 é diferente: o pensamento adaptativo está sempre habilitado, com effort usado para orientar a profundidade. A Anthropic também adicionou esforço por mensagem, mensagens de sistema com escopo por turno e atualizações legíveis de progresso entre chamadas de ferramentas, particularmente úteis em sessões autônomas longas.
GPT-6 Astra, portanto, parece otimizado para amplitude de ferramentas e controle de ambiente de ponta a ponta, enquanto Fable 5.1 parece otimizado para raciocínio persistente de longo horizonte e continuidade do agente. Nenhum estilo arquitetural é universalmente superior; sua camada de orquestração importa tanto quanto o modelo bruto.
Por que restrições de segurança e implantação importam para GPT-6 Astra e Claude Fable 5.1
A OpenAI descreve Astra como seu primeiro modelo a atingir o limite Critical de cibersegurança da empresa e implanta salvaguardas adicionais em torno de fluxos de trabalho de alta capacidade. O mesmo anúncio descreve monitoramento de produção e interrupção de tarefa quando um agente pode exceder seu escopo autorizado.
Fable 5.1 usa uma arquitetura de salvaguardas diferente. A Anthropic afirma que algumas solicitações de cibersegurança e biologia identificadas por suas salvaguardas podem ser roteadas para modelos menos capazes. Isso significa que uma pontuação de produção pode refletir tanto o modelo subjacente quanto as salvaguardas ao seu redor.
Esse é outro motivo pelo qual tabelas de benchmark entre fornecedores não devem ser tratadas como comparações de laboratório perfeitamente controladas. Avaliações corporativas devem incluir recusas, comportamento de fallback, interrupção de tarefa, requisitos de auditoria, retenção de dados e controles de privacidade, em vez de considerá-los apenas após a seleção do modelo.
GPT-6 Astra vs Claude Fable 5.1: qual modelo você deve escolher?
| Carga de trabalho | Modelo recomendado | Por quê |
|---|---|---|
| Agente autônomo de uso de computador | Astra | Evidência publicada mais forte de uso de computador e execução profissional |
| Terminal agêntico / engenharia de software | Astra | Lidera resultados do Terminal-Bench, DeepSWE e migração de banco de dados |
| Fluxos científicos com ferramentas | Astra | Resultados fortes em FrontierMath, GPQA e Terminal-Bench Science |
| Raciocínio amplo de fronteira | Fable 5.1 | Lidera HLE com ferramentas e o Intelligence Index |
| Agente assíncrono de longa duração | Fable 5.1 | Projetado para trabalho agêntico de longo horizonte e atualizações de progresso |
| Solicitações de 300K–1M tokens | Fable 5.1 | Evita a sobretaxa de contexto longo do Astra em precificação padrão |
| Reuso pesado de cache de prompt | Fable 5.1 | Leituras de cache oficiais a $0.25/MTok |
| Automação de documentos / planilhas / apresentações | Astra | Posicionamento mais forte em trabalho profissional e geração de artefatos |
| Repositório grande com contexto cacheado repetido | Fable 5.1 | A economia de cache pode dominar loops de agentes repetidos |
| Cargas de trabalho mistas | Teste ambos | Forças diferentes tornam o roteamento de carga mais útil que um vencedor universal |
Se sua aplicação pede ao modelo para agir, Astra geralmente deve ser o primeiro modelo a ser testado. Se a aplicação pede ao modelo para pensar por muito tempo sobre um contexto muito grande e reutilizado repetidamente, Fable 5.1 merece atenção igual ou maior.
GPT-6 Astra vs Claude Fable 5.1: qual é melhor no geral?
Não há resultado limpo de 10–0. Astra vence mais das linhas diretamente comparáveis publicadas pelos fornecedores, com vantagens particularmente consistentes em execução de programação, ferramentas científicas, uso de computador e automação profissional. Para desenvolvedores construindo um agente que precisa operar software em vez de apenas discutir o que fazer, isso é uma vantagem substancial.
As vitórias do Fable 5.1 são mais estreitas, mas estrategicamente importantes. Seu resultado de 65.0% no Humanity’s Last Exam e pontuação mais forte no Intelligence Index mostram que Astra não domina simplesmente o raciocínio geral. Fable 5.1 também tem vantagem estrutural de preço para agentes pesados em cache e solicitações que usam grande fração da janela de contexto de um milhão de tokens.
A mudança mais profunda é que a seleção de modelos de fronteira está migrando de “qual chatbot dá a resposta mais inteligente?” para “qual sistema termina este trabalho corretamente com o menor custo total?”
Como compará-los para sua própria aplicação
Um leaderboard público deve estreitar sua lista, não tomar sua decisão de produção. Construa um conjunto de avaliação fixo a partir de tarefas reais. Execute material de entrada idêntico contra ambos os modelos, preserve permissões de ferramenta equivalentes e meça não apenas se a resposta final parece boa, mas se a tarefa realmente é bem-sucedida.
Para uma aplicação agêntica, métricas úteis incluem sucesso total da tarefa, taxa de aceitação humana, falhas de chamadas de ferramentas, retentativas, tempo até conclusão, entrada não cacheada, leituras de cache, tokens de saída e gasto total na API.
Uma métrica simples de implantação é gasto total na API ÷ tarefas concluídas aceitas.
Esse número pode reverter uma decisão baseada em benchmark. Um modelo que cobra mais por token pode ser mais barato se precisar de menos retentativas. Um modelo com cache barato pode se tornar dramaticamente mais barato ao longo de um loop de agente de 50 turnos. Um modelo que pontua mais alto isoladamente pode perder quando suas ferramentas, camada de recuperação e critérios reais de aceitação são introduzidos.
Como Astra e Fable 5.1 estão disponíveis via CometAPI, a estratégia de produção mais forte não é necessariamente se comprometer permanentemente com um provedor. Mantenha o modelo configurável, avalie ambos contra os mesmos critérios de aceitação e roteie cada carga de trabalho para o modelo que realmente tem melhor desempenho.
Perguntas frequentes
GPT-6 Astra é melhor que Claude Fable 5.1?
Astra é mais forte em vários benchmarks diretamente comparáveis de programação, ciência e trabalho profissional, incluindo Terminal-Bench, DeepSWE, FrontierMath e AutomationBench. Fable 5.1 lidera no Humanity’s Last Exam com ferramentas e no Artificial Analysis Intelligence Index. Nenhum modelo vence todas as dimensões.
Qual modelo é melhor para programação?
GPT-6 Astra é o melhor modelo para programação, especialmente para programação agêntica e execução. A comparação publicada pela OpenAI relata 57.9% para Astra versus 55.8% para Fable 5.1 no Terminal-Bench 4.0, com vantagens maiores do Astra no DeepSWE e na avaliação de migração de banco de dados. Claude Fable 5.1 permanece altamente competitivo para trabalho de repositório de longa duração, mas Astra tem evidências gerais mais fortes em programação.
Qual modelo é melhor para contexto longo?
Claude Fable 5.1 é a melhor escolha para cargas de trabalho de contexto longo, especialmente para solicitações muito grandes e uso repetido de cache de prompt. Ambos os modelos oferecem cerca de um milhão de tokens de contexto, mas o GPT-6 Astra aplica taxas mais altas quando a entrada excede 272K tokens, enquanto Fable 5.1 mantém uma estrutura de taxas mais simples e oferece leituras de cache substancialmente mais baratas.
Qual deles é mais barato?
Nenhum modelo é mais barato na taxa base padrão — estão empatados; Claude Fable 5.1 é mais barato para cargas de trabalho pesadas em cache e de contexto muito longo. A precificação base oficial é $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída para ambos os modelos. Via CometAPI, GPT-6 Astra e Fable 5.1 atualmente começam em $8 por milhão de tokens de entrada e $40 por milhão de tokens de saída. Fable 5.1 ganha vantagem de custo quando leituras de cache de prompt ou a sobretaxa de contexto longo do Astra se tornam materiais.
Os desenvolvedores devem usar apenas um deles?
Não necessariamente. Suas forças são suficientemente complementares para que uma estratégia de avaliação ou roteamento multi-modelo supere escolher um único modelo para todas as solicitações. Teste cargas de trabalho reais de produção e compare o custo por tarefa concluída aceita em vez de depender de uma única pontuação de benchmark.