
TLDR Benchmarks vazados e testes furtivos no Arena.ai em meados de setembro de 2026 posicionam o ainda não lançado Gemini 4 Pro, do Google, como o novo líder de fronteira, superando GPT-6 Astra e Claude Fable 5.1 em engenharia de software, tarefas agentivas, trabalho do conhecimento, raciocínio e benchmarks multimodais.
Principais destaques
- Gemini 4 Pro lidera avaliações vazadas no DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) e várias outras suítes agentivas/de raciocínio.
- Ele tem preços de tabela inferiores aos de GPT-6 Astra ($12/$60) e Claude Fable 5.1 ($10/$50), ao mesmo tempo que iguala ou supera suas janelas de contexto da classe de 1M.
- Testes furtivos no Arena.ai sob nomes placeholder (por exemplo, gemini-3.8-flash) produziram demos de destaque em SVG, Three.js e codificação agentiva.
- Rumores de RSI (autoaperfeiçoamento recursivo) circulam, mas faltam evidências públicas de melhoria autônoma em ciclo fechado do próprio Gemini 4.
- O Google confirmou pesado investimento em um modelo base Gemini 4 maior; o cronograma de lançamento público permanece não oficial.
- Plataformas como a CometAPI já agregam Gemini, GPT-6 Astra, Claude Fable/Opus e centenas de outros modelos por trás de um endpoint compatível com OpenAI a tarifas competitivas — ideal para avaliar a nova fronteira quando for lançado.
O que sabemos sobre o Gemini 4? (Vazamentos, fontes e contexto verificado)
Em 20 de setembro de 2026, o Gemini 4 Pro ainda não recebeu anúncio oficial do Google, card do modelo ou endpoint público de API. Tudo além das declarações anteriores do Google sobre investir em um “modelo base Gemini 4 maior” (lucros de julho de 2026) vem de vazamentos da comunidade, testes cegos no Arena.ai e tabelas de benchmarks em circulação.
Fontes e alegações-chave incluem:
- O vazador Pankaj Kumar e postagens subsequentes (por volta do início a meados de setembro) mencionaram um checkpoint interno Pro com lançamento público esperado em outubro e uma possível variante Flash-Lite antes.
- Vários desenvolvedores relataram acessar um modelo de alta capacidade rotulado como “gemini-3.8-flash” (ou placeholders semelhantes) no Arena.ai. As saídas incluíam geração complexa de SVG (por exemplo, pelicano em uma bicicleta, borboletas mecânicas em Three.js), geração de JSON longa e não repetitiva e forte comportamento agentivo. Alguns usuários alegaram detalhes de backend como contexto de vários milhões de tokens, tetos de saída de 256k, memória entre sessões e capacidades nativas de ferramentas/internet.
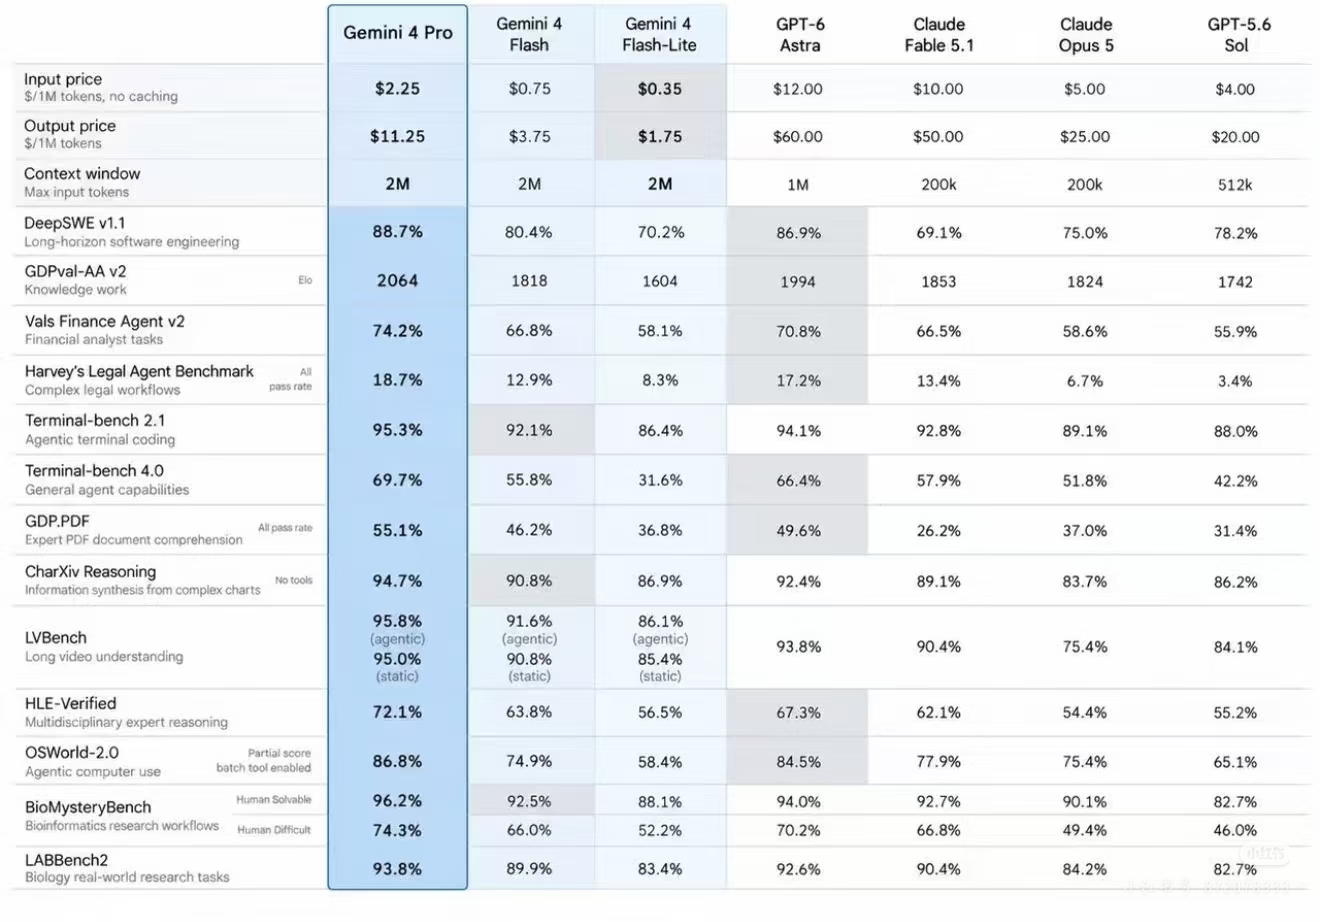
- Uma tabela de comparação amplamente compartilhada lista o Gemini 4 Pro contra Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 e GPT-5.6 Sol.
- O Google não confirmou os testes no Arena nem a tabela. O padrão histórico mostra que a empresa frequentemente realiza avaliações furtivas em plataformas públicas semanas antes dos lançamentos formais.
Janela de contexto
A tabela vazada mostra 2M de tokens máximos de entrada para a família Gemini 4 — o dobro do 1M do GPT-6 Astra e muito acima dos 200k da linha Claude Fable/Opus 5 (algumas variantes do Claude ofereceram janelas efetivas maiores por outros mecanismos). Relatos separados de ghost-routing sugeriram tetos de 10M; estes permanecem não verificados.
Preço do Gemini 4 (números vazados)
A tabela em circulação lista:
- Gemini 4 Pro: $2.25 entrada / $11.25 saída por 1M de tokens (sem cache).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
Esses valores são substancialmente mais baixos que os $12/$60 reportados do GPT-6 Astra e os $10/$50 do Claude Fable 5.1 (o Fable 5.1 oferece descontos agressivos de leitura de cache que podem reduzir o custo efetivo para cargas agentivas). A precificação oficial atual do Gemini 3.x Pro está na faixa de $2–$4 de entrada / $12–$18 de saída dependendo do comprimento do contexto, então os números vazados do Pro são plausíveis como ajuste de próxima geração.
Os preços públicos reais só serão conhecidos no lançamento. Historicamente, o Google usa tarifas de tokens competitivas e camadas gratuitas para impulsionar a adoção.
Desempenho do Gemini 4 Pro: mergulho nos benchmarks vazados
A tabela em circulação coloca o Gemini 4 Pro no topo de quase todas as categorias. Esses números são não oficiais e não verificados pelo Google ou por laboratórios independentes no momento da escrita. Devem ser tratados como sinais direcionais e não como rankings definitivos.
Engenharia de software e codificação agentiva
- DeepSWE v1.1 (engenharia de software de longo horizonte): 88.7% (vs. GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (codificação agentiva no terminal): 95.3% (vs. Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (capacidades gerais de agentes): 69.7% (maior diferença relativa sobre Flash e concorrentes).
Trabalho do conhecimento e tarefas profissionais
- GDPval-AA v2 (Elo, trabalho do conhecimento): 2064 (único modelo acima de 2000; Astra 1994, Fable 1853).
- Vals Finance Agent v2: 74.2%.
- Harvey’s Legal Agent Benchmark (fluxos jurídicos complexos, taxa de aprovação total): 18.7%.
Raciocínio, multimodal e especializado
- CharXiv Reasoning (síntese de informação a partir de gráficos complexos, sem ferramentas): 94.7%.
- LVBench (compreensão de vídeo longo): 95.8% agentic / 95.0% static.
- HLE-Verified (raciocínio especializado multidisciplinar): 72.1%.
- OSWorld-2.0 (uso agentivo do computador, pontuação parcial, ferramenta em lote habilitada): 86.8%.
- BioMysteryBench e LABBench2 (bioinformática e fluxos de trabalho de pesquisa em biologia): pontuações líderes tanto em subconjuntos resolvíveis por humanos quanto nos difíceis.
Esses resultados, se direcionalmente precisos, mostram força particular em cargas agentivas de longo horizonte, multietapas, com uso de ferramentas — exatamente a área onde GPT-6 Astra e Claude Fable 5.1 foram posicionados como líderes após seus lançamentos no começo de setembro.
Testes qualitativos no Arena reforçam o panorama: gerações complexas de SVG e Three.js do modelo furtivo foram julgadas superiores ou altamente competitivas em comparação lado a lado com o Astra pela comunidade.
Como o Gemini 4 vai funcionar?
O Gemini 4 (Pro) ainda não foi lançado, portanto qualquer descrição de “como ele vai funcionar” baseia-se necessariamente nas declarações oficiais do Google, em detalhes limitados vazados sobre um checkpoint interno inicial, na trajetória da série Gemini 3.x e em inferências de engenharia razoáveis. Nada abaixo deve ser tratado como especificações confirmadas.
Treinamento principal e abordagem de escala
O Google descreveu o Gemini 4 como sua “execução de pré-treinamento mais ambiciosa até agora”, construída sobre um modelo base significativamente maior que as gerações anteriores. O objetivo explícito é permanecer competitivo na fronteira, especialmente em codificação e agentes autônomos.
Isso implica:
- Maior contagem de parâmetros ou capacidade mais efetiva (via mistura de especialistas, melhor esparsidade ou escalonamento mais denso).
- Investimento de computação mais pesado durante o pré-treinamento.
- Continuidade na ênfase em dados de treinamento multimodais (texto, imagem, vídeo, áudio, código, trajetórias de uso de ferramentas).
Espera-se que o modelo sirva como um novo baseline de alta capacidade a partir do qual variantes rápidas no estilo Flash possam ser derivadas posteriormente.
Inferência e estilo de raciocínio
Descrições vazadas de um checkpoint inicial “argon” mencionam um modo de Alto esforço de pensamento que levava cerca de 2.4 minutes para uma única geração e suportava um limite de saída dramaticamente maior (reportado em 256k tokens versus ~64k anteriores).
Isso aponta para:
- Caminhos opcionais de raciocínio intensivos em computação (semelhantes em espírito aos modos de pensamento estendido ou “esforço máximo” em modelos concorrentes).
- Capacidade de gastar mais computação interna em problemas difíceis antes de produzir uma resposta.
- Melhor suporte para saídas longas e coerentes como codebases completas, planos multietapas ou relatórios extensos.
É provável que os usuários possam controlar a troca entre velocidade/custo e profundidade de raciocínio, assim como hoje com os modelos Gemini Flash, que oferecem níveis baixo/médio/alto de pensamento.
Áreas de foco de capacidade
Com base nas observações públicas de Sundar Pichai e na trajetória de desenvolvimento:
- Codificação e engenharia de software Desempenho mais forte em longo horizonte: refatorações multifile, depuração em repositórios, loops de autocorreção e taxas de conclusão mais altas em tarefas de software realistas.
- Comportamento autônomo/agentivo Capacidade aprimorada de planejar, usar ferramentas, observar resultados intermediários, se recuperar de erros e continuar rumo a um objetivo ao longo de muitas etapas. Isso se apoia diretamente nos recursos de uso de computador e agentivos já presentes no Gemini 3.5/3.8 Flash.
- Confiabilidade em longos contextos Relatos da comunidade mencionam alvos na faixa de 1.5 milhão de tokens (ou mais). A meta prática não é apenas janelas maiores, mas melhor fidelidade de recuperação e menos degradação ao trabalhar com documentos muito longos, codebases ou rastros de agentes de muitas horas.
- Compreensão e geração multimodal Manipulação nativa de texto + imagem + vídeo + áudio, com ganhos esperados em raciocínio espacial, compreensão de vídeo e interações de voz/agente em tempo real (construindo sobre os modelos Gemini 3.8 Live de setembro de 2026).
- Uso de ferramentas e saídas estruturadas Chamadas de função mais robustas, execução de código, ancoragem de busca e saídas estruturadas no estilo JSON/XML para integração confiável em aplicativos e agentes.
Como difere do Gemini 3.x
- Escala: Modelo base explicitamente maior em vez de refinamento incremental.
- Capacidade de saída: Limites de tokens mais altos vazados habilitam gerações mais longas em uma única passagem.
- Profundidade de raciocínio: Modos de alto esforço mais pronunciados para problemas difíceis.
- Foco agentivo: Maior ênfase em trabalho autônomo sustentado e multietapas, em vez de tarefas de curto horizonte ou de uma única volta.
- Posicionamento: Pretendido como o novo modelo Pro de fronteira, enquanto a linha Flash continua a iterar rapidamente visando velocidade e eficiência de custos.
Relação com Autoaperfeiçoamento Recursivo (RSI)
Executivos do Google têm ligado publicamente o grande CAPEX de IA da empresa à meta de longo prazo de autoaperfeiçoamento recursivo — sistemas que podem melhorar significativamente a si mesmos ou os processos que produzem a próxima geração. Pesquisas relacionadas (como o artigo Dream-RSI) mostram agentes melhorando suas próprias estratégias de exploração sem alterar pesos do modelo.
O Gemini 4 Pro superará GPT-6 e Claude Fable 5.1?
| Categoria | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Observações |
|---|---|---|---|---|
| Preço de entrada / saída | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× mais barato que o Astra |
| Janela de contexto | 2M | 1M | 200k | Vantagem significativa para o Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Forte liderança em codificação |
| GDPval-AA v2 (Elo, trabalho do conhecimento) | 2064 | 1994 | 1853 | Líder em trabalho do conhecimento |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Capacidades gerais de agentes |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Uso de computador |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Raciocínio especializado |
| LVBench (vídeo) | 95.8% / 95.0% | 93.8% | 90.4% | Força multimodal |
| Pesquisa Bio / LAB | Maiores pontuações | Forte | Competitivo | Fluxos de trabalho científicos |
O Gemini 4 Pro lidera todas as linhas principais da tabela, muitas vezes por margem significativa, enquanto seu preço alegado é muito mais agressivo do que o de GPT-6 Astra ou Claude Fable 5.1.
Observações importantes
- Esta tabela não é um comunicado oficial do Google. Em 20 de setembro de 2026, o Google ainda não publicou card do modelo, endpoint de API, preços ou benchmarks confirmados para o Gemini 4 Pro. Os números se originam de fontes da comunidade / avistamentos no Arena / vazamentos de checkpoint interno (codinome relacionado a “argon”).
- Algumas planilhas em circulação anteriormente foram depois sinalizadas como preditivas ou parcialmente copiadas. Trate cada porcentagem específica e os preços como não verificados até confirmação do Google.
- A janela de contexto do Claude Fable 5.1 está listada aqui como 200k, o que é menor do que a cifra de 1M comumente relatada na documentação oficial da Anthropic. Isso pode refletir uma configuração específica de avaliação ou um erro na planilha vazada.
- GPT-6 Astra e Claude Fable 5.1 permanecem os únicos modelos de fronteira totalmente públicos e avaliados de forma independente no momento. Rastreadores de terceiros, como o Artificial Analysis, ainda os mostram como muito próximos no geral (com diferentes pontos fortes).
Realidade prática atual (20 de setembro de 2026)
| Modelo | Status | Melhor para | Nível de preço |
|---|---|---|---|
| Gemini 4 Pro | Não lançado (alegado forte) | Longo contexto, codificação, agentes, multimodalidade, custo | Muito agressivo (alegado) |
| GPT-6 Astra | Lançado | Matemática, uso de computador, terminal, automação, ciber | Premium |
| Claude Fable 5.1 | Lançado | Agentes de longo horizonte, raciocínio, qualidade de código, eficiência de cache | Premium |
| Gemini 4 Flash / Flash-Lite | Variantes irmãs alegadas | Velocidade + cargas sensíveis a custo | Extremamente baixo |
Conclusões rápidas
- Dominante em toda a linha: o Gemini 4 Pro fica em 1º lugar em todas as categorias listadas, muitas vezes com margem clara.
- Pontos fortes particulares: codificação/agentes de longo horizonte (DeepSWE, Terminal-bench), trabalho do conhecimento, multimodal (vídeo + gráficos) e domínios especializados (finanças, jurídico, biologia, uso de computador).
- Posicionamento de preço: cerca de 1/5 do preço de GPT-6 Astra e Claude Fable 5.1 tanto em entrada quanto em saída, enquanto entrega pontuações mais altas.
Astra enfatiza uso de computador, níveis de segurança cibernética e descoberta científica; Fable 5.1 enfatiza trabalho do conhecimento de longa duração e codificação com proteções refinadas e menores custos de leitura de cache. O perfil vazado do Gemini 4 Pro parece mais forte em engenharia de software agentiva ampla e raciocínio multimodal.
Como os desenvolvedores podem se preparar: recomendações da CometAPI
Enquanto aguardam o acesso oficial ao Gemini 4 Pro, as equipes se beneficiam de um gateway unificado que já suporta a fronteira atual (série Gemini 3.x, GPT-6 Astra, Claude Fable 5.1 / Opus 5 e 500+ outros modelos). A CometAPI oferece exatamente isso: um único endpoint compatível com OpenAI, uma chave de API, cobrança pague conforme o uso normalmente 20–40% abaixo das tarifas diretas dos fornecedores e a capacidade de trocar modelos com a alteração de um único parâmetro.
Fluxo de trabalho prático:
- Prototipe pipelines agentivos nos atuais Gemini Flash/Pro, GPT-6 Astra e Claude Fable 5.1 via CometAPI.
- Faça benchmarks dos mesmos prompts entre modelos para estabelecer baselines.
- Quando o Gemini 4 Pro (e suas variantes Flash) aparecer no catálogo da CometAPI — historicamente a plataforma adiciona novos modelos do Google rapidamente — troque o ID do modelo e refaça as avaliações com mudanças mínimas de código.
- Use o painel de custos para acompanhar o gasto de tokens entre provedores e roteie tráfego de alto volume ou sensível à latência para o modelo mais econômico e capaz.
Essa abordagem elimina a gestão de múltiplas chaves, reduz o risco de aprisionamento em fornecedor e posiciona as equipes para adotar o Gemini 4 Pro no primeiro dia de disponibilidade pública.
O Gemini 4 Pro, se os vazamentos forem direcionalmente corretos, representa a aposta mais forte do Google até agora para retomar a fronteira em engenharia de software agentiva e raciocínio multimodal de longo contexto. A combinação de desempenho alegado, grande contexto e preços agressivos o tornaria uma consideração padrão para muitas cargas de produção. Até o lançamento oficial e as avaliações independentes chegarem, o caminho prudente é o benchmarking contínuo nos modelos de fronteira existentes — facilmente feito por meio de plataformas que já unificam o acesso. Fique atento ao anúncio formal; as próximas semanas provavelmente esclarecerão quanto do hype se traduz em realidade de produção.
Perguntas frequentes
O Gemini 4 Pro foi lançado?
Não. Conforme o catálogo mais recente e as declarações do Google (de meados ao fim de setembro de 2026), ele ainda não foi lançado publicamente nem listado com um ID de modelo oficial.
Qual é a data de lançamento prevista do Gemini 4 Pro?
Vazadores apontam para outubro de 2026 (com alguma especulação para o fim de setembro). O Google não deu uma data oficial. Trate como uma janela pendente de confirmação via catálogo de API ou post no blog.
O Google alcançou RSI com o Gemini 4 Pro?
Evidências públicas mostram uso avançado de loops agentivos para refinamento de modelos e pesquisa em melhoria recursiva em nível de estratégia (por exemplo, Dream-RSI). Alegações de RSI completo produzindo o modelo não têm suporte de verificação independente.
Como ele se compara ao GPT-6 Astra e ao Claude Fable 5.1 em benchmarks?
Gráficos da comunidade vazados afirmam liderança em várias suítes de agentes/codificação. Pontuações oficiais e independentes para um Gemini 4 Pro lançado ainda não existem. Dados públicos atuais favorecem avaliar os modelos disponíveis (Astra e Fable 5.1) nas suas tarefas.
Devo esperar pelo Gemini 4 Pro antes de construir?
Não. Lance com os modelos mais fortes disponíveis hoje (acessíveis via CometAPI ou APIs diretas), mantenha conjuntos de avaliação prontos e adote o novo modelo se e quando testes independentes e internos justificarem a troca.
Onde posso acessar facilmente os modelos de fronteira atuais?
Provedores unificados como a CometAPI oferecem acesso compatível com OpenAI a modelos da classe GPT-6 Astra, Claude Fable 5.1, modelos Gemini atuais e outros, com faturamento simplificado e troca facilitada. Verifique a lista de modelos ao vivo e a documentação para os IDs e preços mais recentes.