Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
GLM-5.3 Flash против GLM-5.3: какую модель Z.ai следует использовать?
Краткий вывод:
- GLM-5.3 Flash: оптимизирован для низкой задержки и стоимости, немного уступает по глубине рассуждений и сложным задачам, чаще с более жёсткими ограничениями по контексту/мультимодальности.
- GLM-5.3 (базовая версия): максимальное качество, шире контекст и функциональность (включая мультимодальность и инструменты), выше стоимость и задержки.
Сравнение по ключевым осям
1) Спецификации
- Параметры/размер:
- Flash: компактнее/дистиллированный или более агрессивно квантованный вариант; упор на скорость.
- База: больше параметров и/или активных экспертов; упор на качество.
- Контекстное окно:
- Flash: как правило короче или с более строгими лимитами.
- База: обычно длиннее и устойчивее на длинных контекстах.
- Инструменты/функции:
- Flash: поддерживает базовые режимы (чат, функции/Tools) с приоритетом скорости.
- База: полный набор функций, включая расширенные режимы и более стабильное поведение.
2) Архитектура
- Flash:
- Часто использует дистилляцию, агрессивные оптимизации графа, квантование, сжатые активации, возможно урезанное число экспертов (если MoE).
- Настроен на быстрый первый токен и высокую пропускную способность (batching).
- База:
- Полная архитектура (например, более глубокие слои/ширина, больше экспертов), менее агрессивные компромиссы качества.
- Лучше на сложных рассуждениях, планировании, долговременных зависимостях.
3) Кодовые бенчмарки (coding)
- Flash:
- Отлично справляется с автодополнением, быстрыми подсказками, шаблонным кодом, короткими задачами; хорош для IDE-интерактива.
- На комплексных задачах (многошаговая логика, системный дизайн, редкие библиотеки) точность обычно ниже.
- База:
- Выше точность на HumanEval/MBPP-подобных и многошаговых задачах, лучше справляется с тестами/edge-case’ами и рефакторингом большого кода.
4) Мультимодальность (текст+изображение/аудио/видео)
- Flash:
- Часто поддержка ограниченная или упрощённая (например, только базовый vision-инпут/меньшие лимиты разрешения/длины).
- Оптимизирован для скорости в типичных кейсах распознавания, но слабее в детальном визуальном анализе.
- База:
- Более полная мультимодальная поддержка, лучше детальность и устойчивость на сложных визуальных задачах, расширенные режимы вывода.
5) Скорость и производительность
- Flash:
- Низкая латентность первого токена, высокая скорость генерации, отличная масштабируемость по RPS, предсказуемые задержки под нагрузкой.
- База:
- Выше задержка и ниже throughput при прочих равных; может требовать более мощные инстансы.
6) Стоимость/ценообразование
- Flash:
- Ниже цена за токен ввода/вывода; экономически выгоден для высоких объёмов и продакшн-чатов.
- База:
- Дороже за токен; окупается там, где критична точность и снижение ошибок стоит дороже, чем токены.
7) Доступ через API
- Flash:
- Обычно тот же API и форматы запросов; часто более щедрые квоты на RPS/скорость. Поддержка streaming по умолчанию.
- База:
- Те же эндпоинты/совместимость; иногда строже лимиты или более высокая стоимость при тех же лимитах.
8) Сценарии использования
- Flash:
- Высоконагруженные ассистенты и чат-виджеты, автодополнение кода, быстрые классификации/ранжирование, RAG с короткими ответами, инструментальное вызовы с жёсткими SLA, A/B тесты на больших потоках.
- База:
- Агентные цепочки с многошаговыми рассуждениями, сложная генерация кода/анализ репозиториев, длинные контексты (обзоры документов), точный визуальный разбор, задачи с повышенными требованиями к качеству.
Практические рекомендации по выбору
- Если важны скорость, масштаб и стоимость на токен — начните с GLM-5.3 Flash; при деградации качества на критичных задачах переведите конкретные маршруты на GLM-5.3.
- Для гибридной архитектуры используйте роутинг: Flash как дефолт, база — для запросов с высокой сложностью (детектировать по эвристикам: длина контекста, необходимость инструментов, уровень неуверенности).
- В IDE/автодополнении — Flash; в код-ревью и генерации сложных модулей — база.
- В мультимодальных сценариях, требующих детальности, — база; для быстрых визуальных подсказок — Flash.
Примечание: конкретные цифры (параметры, окна контекста, цены, официальные бенчмарки) зависят от поставщика и версии. Если пришлёте ссылки на официальные спецификации или прайс, я подготовлю точную сравнительную таблицу с цифрами.
Deon GoodwinКоманда исследователей AI-моделей и API
GLM-5.3 Flash — лучший вариант по умолчанию для большинства продакшен-нагрузок: он добавляет нативный визуальный ввод и контекст на 1 млн токенов, при этом его стандартная цена за токены существенно ниже. GLM-5.3 остаётся более сильным выбором, когда глубина кодирования, сложное долгосрочное рассуждение или производительность в кибербезопасности важнее, чем стоимость.
Это не противостояние «малой» и «большой» модели. Flash — это MoE с 320B суммарно и 18B активных параметров, обученный на новой мультимодальной базе с гибридным разрежённым и линейным вниманием. Флагман — это , причём улучшения GLM-5.3 достигнуты масштабированным постобучением на базе GLM-5.2.
Выбирайте Flash для мультимодального кодирования, понимания документов, браузерных или GUI-агентов, массовой автоматизации и чувствительных к цене приложений.
Выбирайте флагман для самых сложных задач уровня репозиториев, более глубокого рассуждения с инструментами и исследований в защитной кибербезопасности.
Обе модели поддерживают контекст на 1 млн токенов, всегда включённое рассуждение, вызов функций, потоковую выдачу и развёртывание с открытыми весами.
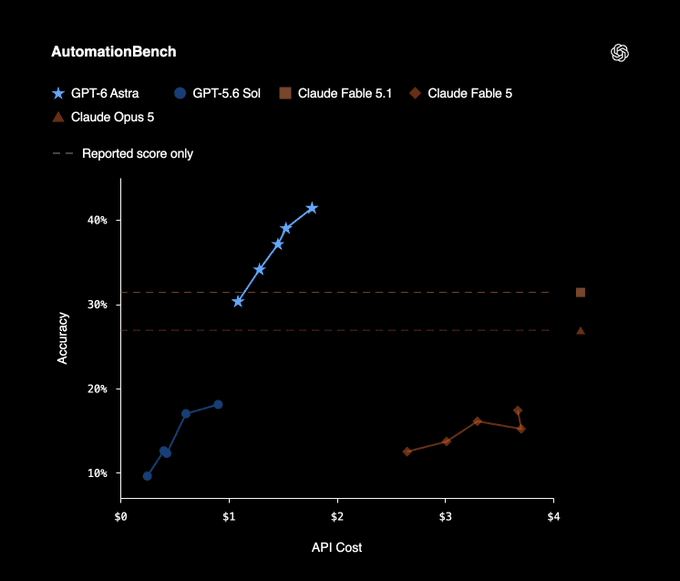
По сопоставимым бенчмаркам Z.ai флагман лидирует в DeepSWE, NL2Repo, HLE с инструментами и Agents’ Last Exam; Flash лидирует в AutomationBench, Toolathlon и GDPval-AA v2.
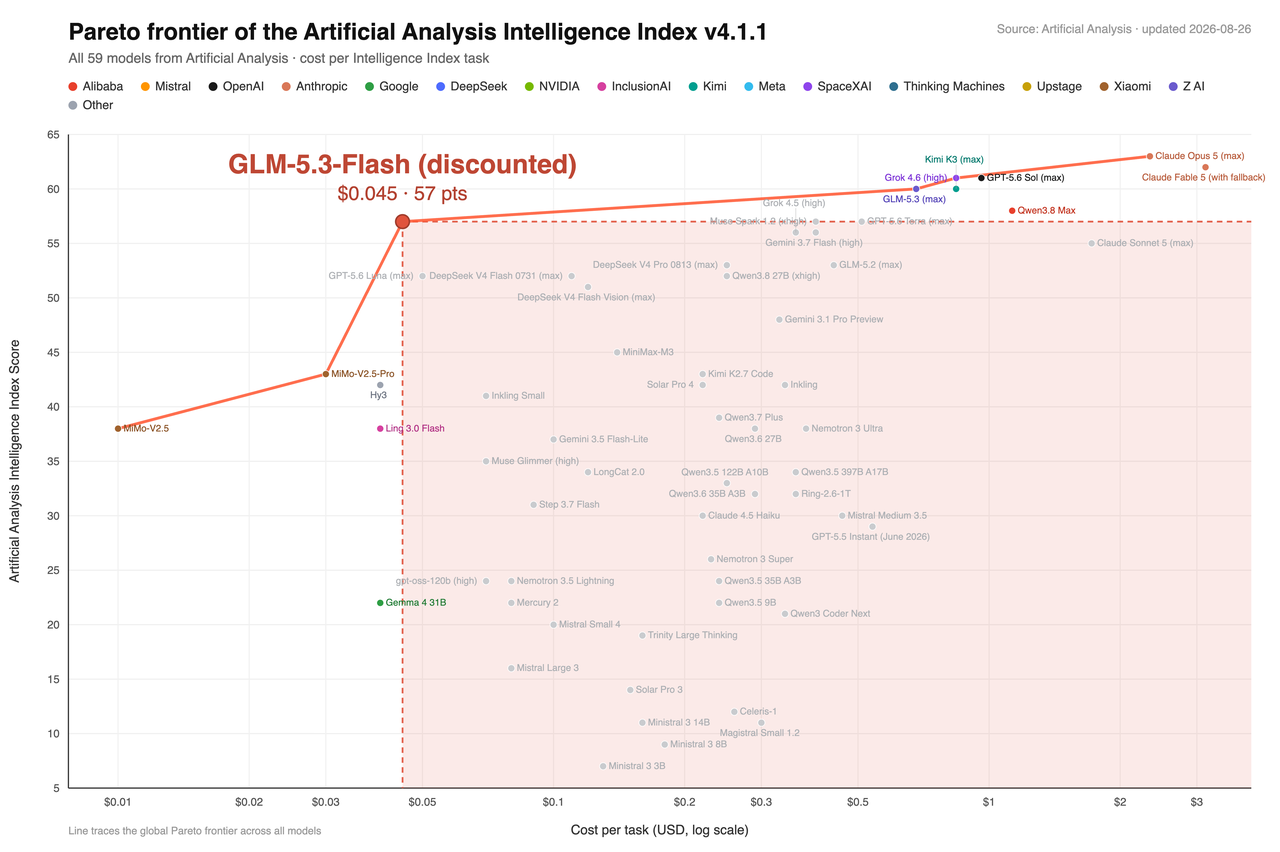
Независимые тесты дают флагману более высокий Intelligence Index и более быструю генерацию, тогда как Flash имеет немного меньшее время до первого токена и значительно более низкую смешанную стоимость.
GLM-5.3 Flash vs GLM-5.3 кратко
Dimension
GLM-5.3 Flash
GLM-5.3
Practical result
Positioning
Эффективная нативно-мультимодальная кодовая и агентная модель
Флагманская текстовая модель для рассуждения, кодирования, длинных агентов и кибербезопасности
Зависит от нагрузки
Model size
320B всего / 18B активно
744B всего / 40B активно
Flash активирует на 55% меньше параметров
Base model
Новая 30T-токенная мультимодальная база
Та же база, что и у GLM-5.2; прирост — за счёт постобучения
Z.ai позиционирует Flash как первую нативно мультимодальную модель серии GLM-5. У неё 320B суммарных и 18B активных параметров, но «Flash» не стоит понимать как «маленькая». Полная контрольная точка остаётся очень большой; эффективность достигается за счёт активации меньшего поднабора экспертов и переработки стека внимания.
Базовая модель обучена на 30-триллионном мультимодальном корпусе. Нативное зрение интегрировано в цикл кодирования, позволяя модели анализировать скриншоты, отрисованные интерфейсы, диаграммы, макеты страниц и другие визуальные сигналы перед уточнением следующего действия.
Спецификации GLM-5.3 Flash
Specification
GLM-5.3 Flash
Developer
Z.ai / Zhipu AI
Model ID
glm-5.3-flash
Model type
Нативно мультимодальная модель Mixture-of-Experts
Total / active parameters
320B / 18B
Layers
45
Architecture
Гибридное разрежённое внимание + линейное внимание; mHC; MTP
Training corpus
Мультимодальный корпус предподготовки на 30T токенов
Input modalities
Текст и визуальные входы, включая изображения и поддерживаемые видео/файлы
Флагманская модель оптимизирована для сложной разработки ПО, «длинных» агентов и кибербезопасности. Z.ai отмечает, что она использует ту же базу, что и GLM-5.2; апгрейд достигнут за счёт масштабированного постобучения, а не новой предобучающей выборки.
Официальный репозиторий указывает чекпоинт на 744B суммарных параметров и 40B активных. По сравнению с Flash, она активирует более чем вдвое больше параметров на токен и выделяет большую ёмкость для сложного многошагового рассуждения.
Спецификации GLM-5.3
Specification
GLM-5.3
Developer
Z.ai / Zhipu AI
Model ID
glm-5.3
Model type
Флагманская текстовая модель Mixture-of-Experts
Total / active parameters
744B / 40B
Base model
База GLM-5.2; все улучшения GLM-5.3 — из постобучения
Открытые веса по отдельной лицензии GLM-5.3; сопроводительный код — Apache-2.0
Источники: документация флагмана Z.ai и официальный репозиторий GLM-5.
Архитектура: почему Flash дешевле, не будучи маленьким
Flash чередует блоки линейного внимания с блоками разрежённого внимания и использует mHC вокруг компонентов внимания и MoE. Его механизм IndexPool сжимает четыре ключевых вектора индексатора в один. Z.ai сообщает о 3,01× меньших вычислительных затратах внимания на слой и 4,44× меньшем KV‑кэше на слой по сравнению с флагманом при длине последовательности 1 млн токенов.
Это сравнения на уровне архитектуры и они не являются гарантированными множителями латентности end-to-end. Реальная скорость API зависит также от железа, квантизации, батчинга, длины рассуждений, софта сервинга и загрузки провайдера.
Гибридная архитектура внимания GLM-5.3-Flash и сравнение вычислений/кэша для длинного контекста.
Производительность в бенчмарках: где каждая модель выигрывает
Наиболее корректно отделять бенчмарки, заявленные вендором, от независимых API-замеров. Даже при совпадении названий бенчмарков версии каркасов, конфигурации инструментов, управление контекстом и усилие на рассуждение могут отличаться. Таблица ниже использует максимально совпадающие значения из оценки флагмана и оценки Flash; небольшие расхождения трактуются как направленные, а не окончательные.
Benchmark
GLM-5.3 Flash
GLM-5.3
Higher score
What it tests
Terminal-Bench 2.1
84.3
88.2
GLM-5.3
Терминал и агентное кодирование
DeepSWE v1.1
63.4
66.9
GLM-5.3
Инженерия ПО
NL2Repo
56.3
58.0
GLM-5.3
Генерация репозиториев
Toolathlon Verified
78.4
73.0
Flash
Использование инструментов
AutomationBench
48.8
48.2
Почти паритет / Flash
Автоматизация компьютерного использования
Agents’ Last Exam
26.3
28.5
GLM-5.3
Длинные агентные рассуждения
HLE with tools
55.3
62.5
GLM-5.3
Сложное рассуждение с инструментами
GDPval-AA v2
1773 Elo
1769 Elo
Почти паритет / Flash
Профессиональная интеллектуальная работа
Источники: оценка флагмана и оценка Flash. Сравнивайте направленно, так как конфигурации могут отличаться.
Кодирование и инженерия репозиториев
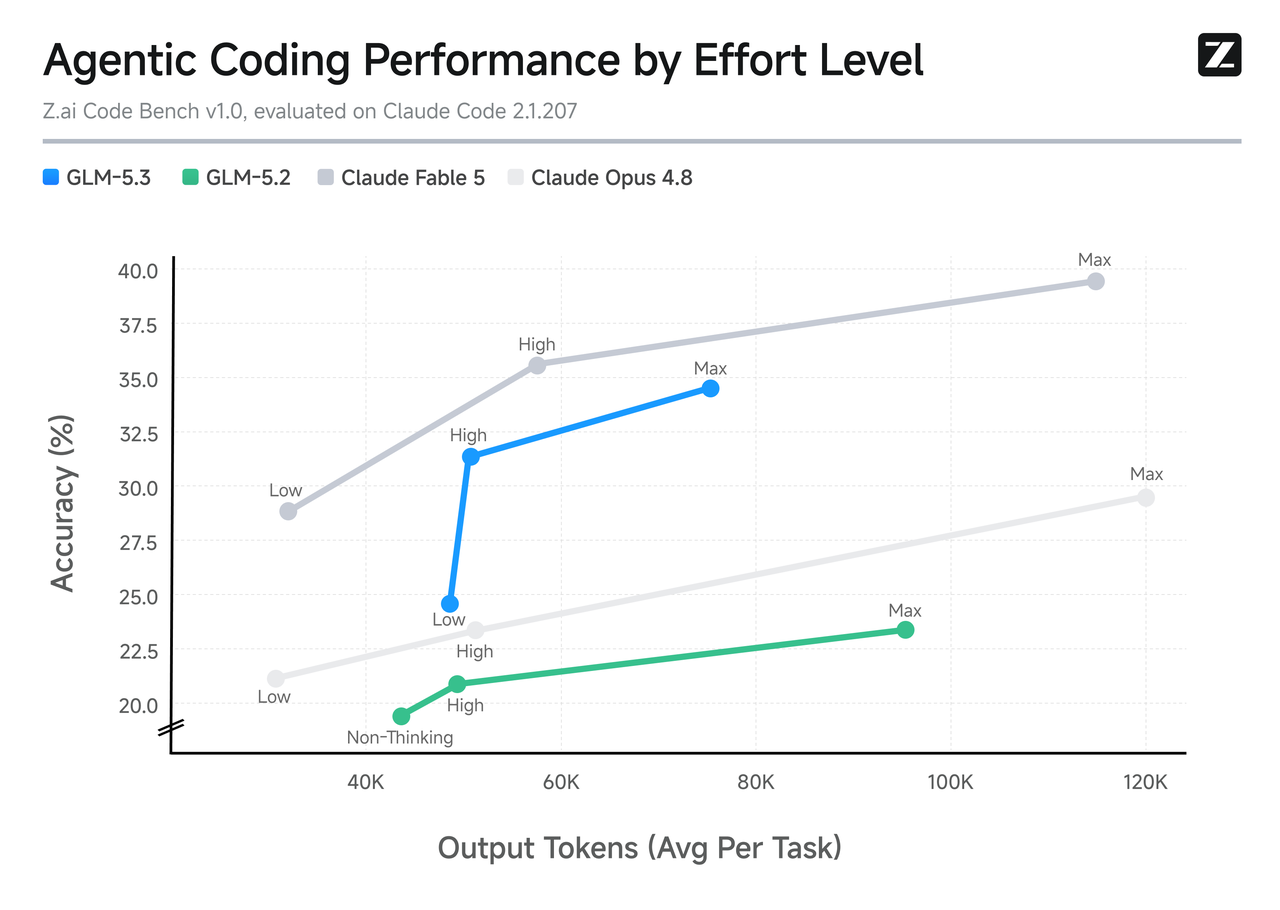
У флагмана выше потолок производительности. Он обгоняет Flash на 3,5 пункта в DeepSWE и на 1,7 пункта в NL2Repo. На Z.ai Code Bench v1.0, при оценке обеих моделей с использованием Claude Code 2.1.207, флагман достигает 34,5% на max effort, тогда как Flash — 29,0% — преимущество в 5,5 пункта.
При этом Flash остаётся достаточно конкурентоспособным, чтобы быть первой моделью для рутинного обслуживания репозиториев, генерации тестов, отладки, рефакторинга и высокообъёмных кодовых агентов. Эскалируйте только самые трудные задачи или неудачные траектории к флагману.
Шестибенчмарковая оценка Z.ai для GLM-5.3-Flash и других моделей кодирования/агентов.
Источник: официальная документация Z.ai по Flash
Точность агентного кодирования GLM-5.3 и использование выходных токенов на различных уровнях усилия.
Источник: официальная документация Z.ai по флагману
Инструменты, автоматизация и интеллектуальная работа
Flash не повсеместно слабее. Он набирает 78,4 на Toolathlon Verified против 73,0 у флагмана и немного опережает в AutomationBench 48,8 против 48,2. В GDPval-AA v2 — фактически паритет. Это делает Flash особенно привлекательным, когда задача — не один крайне сложный цепочный рассуждательный кейс, а надёжная координация инструментов по множеству недорогих запросов.
Независимые метрики интеллекта, скорости и латентности
Independent measurement
GLM-5.3 Flash
GLM-5.3 (max)
Result
Artificial Analysis Intelligence Index
57
60
GLM-5.3
Output speed
50.2 токенов/с
76.6 токенов/с
GLM-5.3
Time to first token
1.49 с
1.61 с
Flash
Context window
1M
1M
ПАРИТЕТ
Blended price in AA comparison
$0.10 / 1M токенов
$0.90 / 1M токенов
Flash
Источник: сопоставление API от Artificial Analysis.
Этот независимый результат важен для коррекции предположения «Flash означает быстрее». Flash начинает отвечать чуть раньше, но у протестированного флагманского эндпоинта скорость генерации выше после начала вывода. Рассматривайте эти измерения как снимки, зависящие от провайдера, а не неизменные свойства моделей.
Граница «стоимость–интеллект» по Artificial Analysis, воспроизведённая в официальной документации Z.ai по Flash.
Источник: официальная документация Z.ai по Flash
Мультимодальность: у Flash явное преимущество
Flash принимает визуальные входы и интегрирует их в агентные воркфлоу. Он может анализировать скриншоты, изображения страниц, диаграммы, состояния интерфейса, записи экрана и поддерживаемые файлы, затем использовать визуальные данные при кодировании или работе инструментов. Флагман на данный момент поддерживает только текстовый ввод.
Frontend и design-to-code: Flash может анализировать эталонный скриншот и валидировать итоговую отрисовку.
Документы и офисные сценарии: Flash способен рассуждать о структуре страниц, диаграммах, макете и размещении изображений.
Браузер и компьютерное использование: Flash комбинирует визуальное состояние с вызовами инструментов и итеративными исправлениями.
Текстовая работа по репозиториям: флагман предпочтителен, когда вход — код и текст, а задача требует максимальной глубины рассуждения.
Длинный контекст и управление рассуждением
GLM-5.3 Flash поддерживает контекст на 1 млн токенов и до 128K выходных токенов; GLM-5.3 предоставляет те же лимиты. Обе модели держат рассуждение включённым и принимают уровни усилия low, high и max. Z.ai рекомендует max для сложного кодирования и воспроизведения бенчмарков.
Ёмкость контекста не является ключевым различием. Отличается экономичность работы с длинными последовательностями и объём рассуждения на самых сложных задачах. Flash архитектурно дешевле на длинном контексте; у флагмана выше потолок качества.
Кибербезопасность: специализация GLM-5.3
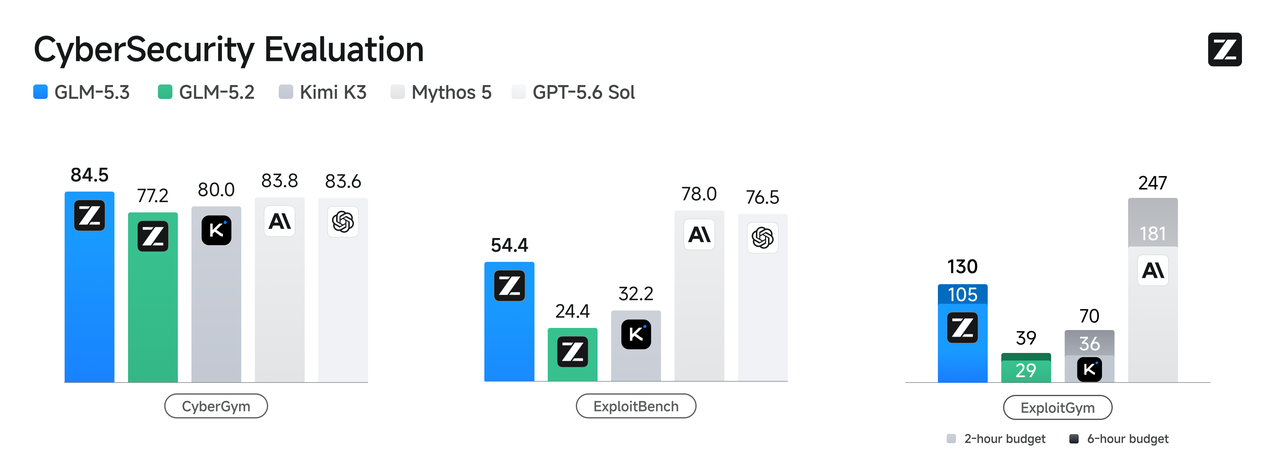
Кибербезопасность — наиболее отличительная способность флагмана. Z.ai сообщает 84,5 на CyberGym и 54,4 на ExploitBench. При нормированных бюджетах 2 и 6 часов он завершил 105 и 130 задач ExploitGym.
У Flash нет эквивалентного фокуса запуска или сопоставимого публичного набора по кибербезопасности. Для code review, безопасной разработки и санкционированного поиска уязвимостей используйте флагман как основную модель и держите в процессе человеческое одобрение, изолированные инструменты, журналы аудита и контроль раскрытия.
Производительность GLM-5.3 в задачах обнаружения уязвимостей и построения эксплуатационных цепочек.
Источник: официальная документация Z.ai по кибербезопасности
Стоимость и развёртывание
Цены API
Z.ai указывает цену для Flash $0.15 за миллион входных токенов и $0.50 за миллион выходных до акций, против $1.40 и $4.40 для флагмана.
Access route
Flash input
Flash cached
Flash output
5.3 input
5.3 cached
5.3 output
Z.ai standard list
$0.15
$0.03
$0.50
$1.40
$0.26
$4.40
Z.ai promotional Flash rate
$0.075
$0.015
$0.25
$1.40
$0.26
$4.40
CometAPI route
$0.06
Check live route
$0.20
$1.12
Check live route
$3.528
Цены — USD за 1 млн токенов. Источники: цены Z.ai, маршрут Flash и маршрут GLM-5.3. Акции могут меняться.
Пример месячной стоимости
Для нагрузки в 100 млн входных токенов и 20 млн выходных, текущие тарифы CometAPI дают оценку $10.00 для Flash и $182.56 для флагмана, без учёта эффектов кэша или стоимости инструментов. В этом примере Flash снижает счёт за токены примерно на 94,5%.
Flash проще обслуживать, чем флагман, но это не модель для потребительских GPU. Чекпоинт 320B, мультимодальные компоненты, KV‑кэш и контекст на 1 млн требуют серьёзной инфраструктуры. Самостоятельный хостинг привлекателен, когда контроль над данными, кастомный сервинг или устойчиво высокая загрузка оправдывают операционные затраты.
Какую модель выбрать?
Выберите GLM-5.3 Flash, если:
Нужны понимание изображений, скриншотов, диаграмм, документов, браузера или GUI.
Вы запускаете высокообъёмных кодовых агентов, исследовательские процессы или бизнес-автоматизацию.
Нужна сильная работа с инструментами и интеллектуальной работой при минимальной цене за токен.
Нужен контекст на 1 млн, но вы не хотите флагманскую экономику на каждый запрос.
Планируете self-host и 320B/18B практичнее, чем 744B/40B.
Выберите GLM-5.3, если:
Решаете самые сложные задачи уровня репозиториев или «длинные» инженерные задачи.
Ваша оценка больше вознаграждает глубокое рассуждение, чем низкую стоимость.
Нужен более высокий результат на DeepSWE, HLE с инструментами или Agents’ Last Exam.
Строите санкционированные процессы защитной безопасности или поиска уязвимостей.
Более высокий коэффициент успеха окупает примерно порядок разницы в цене за токен.
Матрица решений по кейсам
Workload
Recommended starting model
Why
High-volume chat and automation
GLM-5.3 Flash
Намного ниже стоимость; сильная работа с инструментами
Visual coding and UI debugging
GLM-5.3 Flash
Нативный визуальный ввод
Document, chart, and Office analysis
GLM-5.3 Flash
Мультимодальные профессиональные воркфлоу
Routine repository maintenance
Start with Flash
Эскалируйте провалы или необычно сложные задачи
Difficult repository-scale engineering
GLM-5.3
Более высокий потолок кодирования
Long-horizon research with tools
GLM-5.3
Сильнее в HLE-with-tools
Defensive security and vulnerability discovery
GLM-5.3
Специализированные кибер-тренировки и бенчмарки
Cost-sensitive self-hosting
GLM-5.3 Flash
Меньшая активная и суммарная нагрузка
Uncertain mixed workload
Hybrid routing
Flash по умолчанию; эскалация на флагман
Лучшая продакшен-стратегия: маршрутизируйте, не заменяйте
Для большинства команд не нужно делать эксклюзивный выбор. Используйте Flash как маршрут по умолчанию, а затем эскалируйте только задачи с высокой сложностью, провалившие валидацию, чувствительные по безопасности или с ожидаемой экономической ценностью, оправдывающей премию флагмана.
Отправляйте визуальные, рутинные и высокообъёмные задачи в Flash.
Измеряйте долю принятых результатов, токены, латентность, отказы инструментов и объём вмешательств человека.
Эскалируйте провальные или высокорисковые текстовые задачи во флагман.
Пропускайте security-чувствительную работу через дополнительные авторизации и песочницы.
Оптимизируйте под стоимость за принятый результат, а не под ранг бенчмарка или цену по отдельности.
Как протестировать обе модели через CometAPI
CometAPI предоставляет маршруты GLM-5.3 Flash и GLM-5.3 за одним и тем же OpenAI-совместимым base URL. Создайте API-ключ, затем прогоните одну и ту же текстовую задачу через оба идентификатора модели. Для честного теста держите неизменными промпт, уровень усилия на рассуждение, определения инструментов, максимальный вывод и критерии приёма.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Для мультимодальной оценки используйте актуальную документацию по маршруту Flash, чтобы проверить поддерживаемую схему содержания изображений. Сравнение с флагманом должно использовать текстовый эквивалент, так как он не принимает визуальные входы.
Ограничения этого сравнения
Ряд показателей по кодированию и агентам предоставлен вендором. Независимая репродукция может использовать другие инструменты, промпты и настройки инференса.
Совпадающие названия бенчмарков не гарантируют одинаковые версии каркасов или стратегии управления контекстом.
Снижения вычислений внимания и KV‑кэша на уровне архитектуры напрямую не предсказывают латентность API.
Цены, акции, доступность моделей, лимиты и возможности маршрутов могут меняться; проверяйте актуальные страницы моделей перед развёртыванием.
Открытые веса не делают ни один из чекпоинтов дешёвым для self-host при полном контексте.
Возможности по кибербезопасности — двойного назначения и требуют авторизации, песочниц, логирования, экспертного ревью и ответственного раскрытия.
Вывод
GLM-5.3 Flash — практичный дефолт. Он сохраняет длинный контекст, добавляет нативное зрение, показывает сильные результаты в работе с инструментами и профессиональными задачами и настолько меняет экономику, что позволяет существенно расширить масштаб применения. GLM-5.3 — модель для эскалации: дороже, только текст, но сильнее на самых сложных задачах по кодированию, рассуждению и кибербезопасности.
Итог — по нагрузке: начинайте с Flash, меряйте реальную долю принятых результатов и маршрутизируйте во флагман только тогда, когда его дополнительная рассуждательная ёмкость приносит достаточно успешных исходов, чтобы окупить премию.
Часто задаваемые вопросы
Лучше ли GLM-5.3 Flash, чем GLM-5.3?
Не всегда. Flash лучше по цене, мультимодальности и ряду бенчмарков по инструментам/автоматизации. Флагман сильнее на самых трудных задачах кодирования, рассуждения с инструментами и кибербезопасности.
Является ли GLM-5.3 Flash маленькой моделью?
Нет. У неё 320B суммарных параметров и 18B активных на токен. Она эффективнее, чем флагман с 744B/40B, но всё ещё требует существенного железа для self-host.
Какая модель дешевле?
Flash на порядок дешевле. Стандартная цена Z.ai примерно в десять раз ниже цены флагмана, а текущие маршруты CometAPI показывают ещё больший разрыв при активных акциях.
Какая модель быстрее?
Зависит от метрики и провайдера. Artificial Analysis измерил чуть меньшее время до первого токена у Flash, но более высокую скорость вывода у флагмана.
Какая модель поддерживает изображения?
Flash поддерживает нативный визуальный ввод. Флагман пока поддерживает только текст.
Обе модели поддерживают контекст на 1 млн токенов?
Да. Flash поддерживает контекст 1M и до 128K вывода; флагман — те же лимиты.
Какая модель лучше для кодирования?
Используйте Flash для рутинных и высокообъёмных кодовых агентов. Используйте флагман для самых сложных задач уровня репозиториев или когда стоимость ошибки выше разницы в цене.
Какая модель лучше для кибербезопасности?
Флагман. Z.ai специально обучал и оценивал его для обнаружения уязвимостей и построения эксплуатационных цепочек. Используйте только в санкционированных, контролируемых средах.
Обе модели можно self-host?
Да. В репозитории Z.ai указаны доступные чекпоинты и поддерживаемые фреймворки сервинга, но обе — крупные инфраструктурные проекты.
What is the best deployment strategy?
Используйте Flash как маршрут по умолчанию и эскалируйте сложные, провальные или чувствительные по безопасности текстовые задачи во флагман. Измеряйте стоимость за принятый результат.
Best fit
Маршрутизация по умолчанию, мультимодальные агенты, масштаб
Самые ответственные сложные текстовые и security-задачи