
TL;DR
Claude Haiku 5.5 และ GPT-6 Luna เป็นโมเดลการให้เหตุผลราคาประหยัดสำหรับงานโหลด API ปริมาณสูง ทั้งสองมีราคาเริ่มต้นที่ $0.10 ต่อโทเค็นอินพุตหนึ่งล้าน และ $0.50 ต่อโทเค็นเอาต์พุตหนึ่งล้าน Haiku ได้คะแนนสูงกว่าในหกการเปรียบเทียบที่เผยแพร่ในเอกสารเปิดตัวของ Anthropic Luna รักษาอัตราโทเค็นฐานสำหรับพรอมต์สูงสุด 272K โทเค็นอินพุต เมื่อเทียบกับเกณฑ์ 100K ของ Haiku สำหรับนักพัฒนา ตัวชี้วัดสำคัญคือ อัตราการยอมรับ เวลาแฝงแบบ End-to-End ความเข้ากันได้ของ API และต้นทุนต่อผลลัพธ์ที่ผ่านเกณฑ์—ต้นทุนรวมของความพยายามทั้งหมดหารด้วยจำนวนเอาต์พุตที่ผ่านการตรวจสอบที่กำหนดไว้ล่วงหน้า
Key Takeaways
- Haiku 5.5 นำในการเปรียบเทียบการใช้งานคอมพิวเตอร์ OSWorld 2.1 ที่อ้างถึง 72.4% เทียบกับ 48.9% ของ Luna
- บน Terminal-Bench 4.0 ผลลัพธ์ที่อ้างถึงคือ 39.2% สำหรับ Haiku และ 16.4% สำหรับ Luna
- ทั้งสองมีราคาเริ่มต้นเท่ากันสำหรับพรอมต์ระยะสั้น แต่ระดับราคาที่สูงกว่าของ Haiku เริ่มหลัง 100K โทเค็นพรอมต์ ขณะที่ของ Luna อยู่ที่ 272K
- หน้าข้อมูลโมเดลแบบความพยายามสูงสุดของ Artificial Analysis (ตรวจเมื่อ 9 ตุลาคม 2026) แสดงความเร็วเอาต์พุต 240.6 โทเค็น/วินาทีสำหรับ Haiku และ 123.0 โทเค็น/วินาทีสำหรับ Luna; อัตราผ่านไม่รวมเวลารอโทเค็นแรก
- เริ่มจาก Haiku สำหรับงานใช้งานคอมพิวเตอร์และเทอร์มินัลที่สะท้อนในเบนช์มาร์กที่แชร์ไว้; พิจารณา Luna สำหรับพรอมต์ขนาดใหญ่ รักษาโมเดลปัจจุบันไว้จนกว่าการนำร่องที่เป็นตัวแทนจะยืนยันการปรับปรุงที่เป็นประโยชน์
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 เปิดตัวเมื่อ 7 ตุลาคม 2026 ผสมผสานการอนุมานราคาต่ำกับการให้เหตุผลที่ปรับได้ การใช้เครื่องมือ คอนเท็กซ์ยาว และอินพุตแบบข้อความและภาพ แอปพลิเคชันทั่วไป ได้แก่ การแยกข้อมูลจากเอกสาร การสืบค้นฐานข้อมูล การสนับสนุนลูกค้า และซับเอเจนต์น้ำหนักเบา
GPT-6 Luna: Overview
GPT-6 Luna เปิดตัวเมื่อ 22 กันยายน 2026 ตำแหน่งสำหรับงานโฟกัสที่ทำงานที่สเกล รวมถึงการจัดประเภท การแยกข้อมูล ข้อมูลโครงสร้าง ความช่วยเหลือด้านโปรแกรมมิง และการประมวลผลเอกสารยาว การตั้งค่าการให้เหตุผลที่ยืดหยุ่นรวมถึงการตั้งค่าแบบไม่มีการให้เหตุผลสำหรับงานที่เรียบง่าย
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | 7 ตุลาคม 2026 | 22 กันยายน 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 โทเค็น | 1,050,000 โทเค็น |
| Maximum output (standard API) | 128,000 โทเค็น | 128,000 โทเค็น |
| Input | ข้อความและภาพ | ข้อความและภาพ |
| Output | ข้อความ | ข้อความ |
| Reasoning | ปรับได้ ระดับต่ำถึงสูงสุด | ตั้งแต่ None ถึงสูงสุด |
| Default effort | ระดับกลาง | ระดับกลาง |
| Knowledge cutoff | มิถุนายน 2026 | 18 พฤษภาคม 2026 |
| Tool use | มี | มี |
| Structured output | มี | มี |
| Open weights | ไม่มี | ไม่มี |
| Architecture and parameter count | ไม่ได้ระบุในเอกสารทางการที่อ้างถึง | ไม่ได้ระบุในเอกสารทางการที่อ้างถึง |
ข้อกำหนดใช้เอกสารโมเดล API มาตรฐานของผู้ขาย ตรวจเมื่อ 9 ตุลาคม 2026: Haiku's standard API specifications และ Luna's standard API specifications โครงสร้างและจำนวนพารามิเตอร์ไม่ได้ระบุไว้เนื่องจากแหล่งนี้ไม่ได้ยืนยัน
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
หกรายการข้างต้นเป็นการทำซ้ำผลการเปรียบเทียบที่เผยแพร่โดย Anthropic ในช่วงเปิดตัว ตรวจเมื่อ 9 ตุลาคม 2026 เป็นการเปรียบเทียบที่ Anthropic เผยแพร่ รวมถึงผลลัพธ์อิสระที่นำมาเผยแพร่ ไม่ใช่การทดสอบใหม่สำหรับบทความนี้ GDPval-AA และ AA-Briefcase เป็นคะแนน Elo; ช่องว่างร้อยละคือจุดเปอร์เซ็นต์ ครอบครัวเบนช์มาร์กเหล่านี้วัดงานต่างกันและไม่ควรเฉลี่ยเป็นผู้ชนะสากล
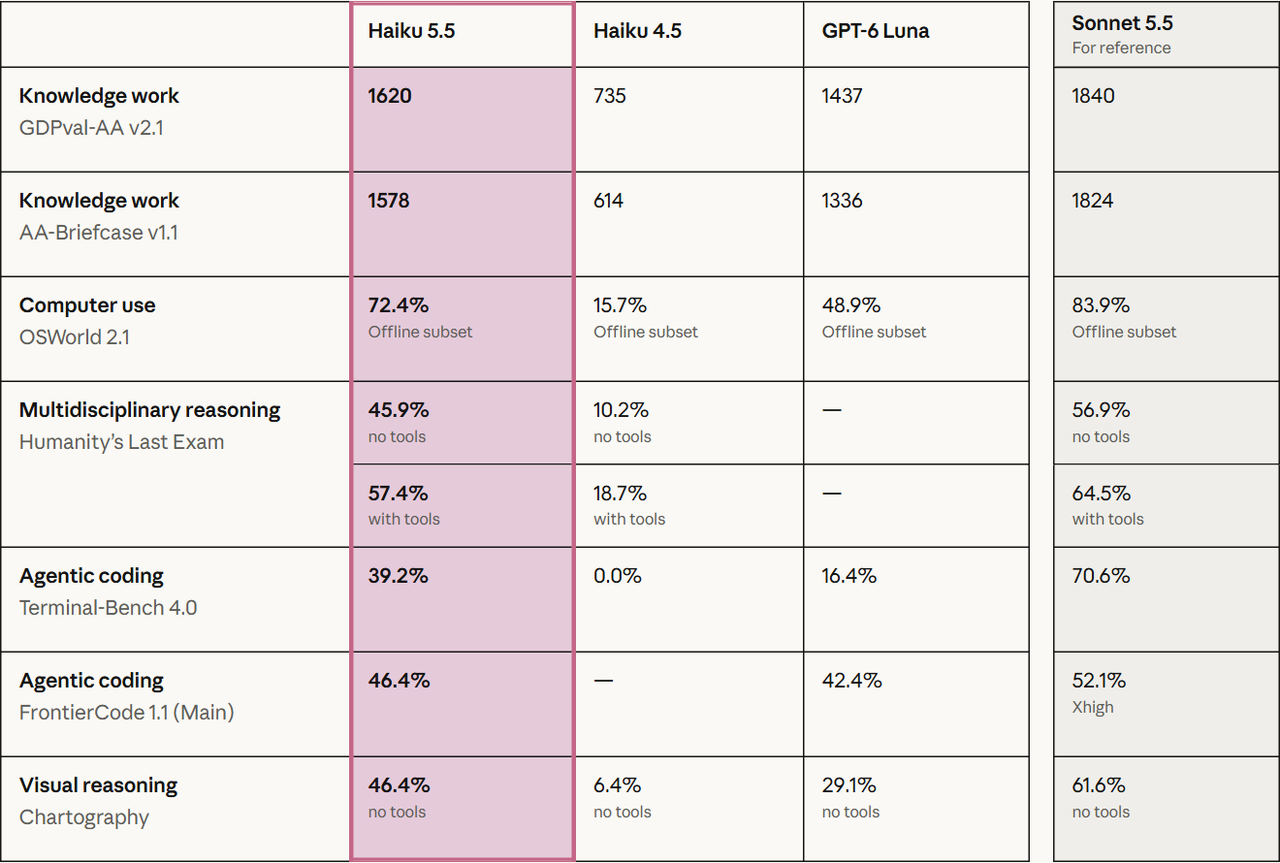
ผลสัมพัทธ์ที่แข็งแกร่งที่สุดของ Haiku ในตารางเปิดตัวนี้ปรากฏในปฏิสัมพันธ์กับคอมพิวเตอร์แบบภาพและงานบนเทอร์มินัล ช่องว่างเล็กลงใน FrontierCode เตือนว่าไม่ควรคาด extrapolate ช่องว่าง 20 จุดไปยังทุกสถานการณ์การเขียนโค้ด ใช้ผลลัพธ์เหล่านี้เพื่อเลือกผู้สมัครนำร่อง จากนั้นตรวจสอบพรอมต์และชุดเครื่องมือของคุณ
Reasoning Effort and Evaluation Limits
ระดับความพยายามด้านเหตุผลเปลี่ยนสมดุลความแม่นยำ–ต้นทุน เปรียบเทียบการตั้งค่าที่มีอยู่ด้วยงานและฮาร์เนสเดียวกัน; ชื่อการตั้งค่าที่เท่ากันของแต่ละผู้ขายไม่ได้รับประกันงบประมาณโทเค็นเหตุผลที่เท่ากัน ตารางเปิดตัวรายงานชุดย่อยออฟไลน์ของ OSWorld และ Chartography โดยไม่ใช้เครื่องมือ ฮาร์เนส การเลือกงาน การลองซ้ำ และการเข้าถึงเครื่องมือสามารถเปลี่ยนผลลัพธ์ได้ การ์ดระบบของ Anthropic บันทึกเงื่อนไขเฉพาะของเบนช์มาร์ก อ่านวิธีเบนช์มาร์กใน System card ของ Anthropic
- OSWorld ใช้ชุดย่อยออฟไลน์ 82 งาน เครื่อง Ubuntu ภาพหน้าจอ 1080p ขีดจำกัด 500 การกระทำ ความพยายามสูงสุด และห้าความพยายามต่อภารกิจ การเปรียบเทียบ 72.4%/48.9% เป็นการให้คะแนนแบบได้คะแนนบางส่วน ไม่ใช่เปอร์เซ็นต์ของงานที่สำเร็จสมบูรณ์; อัตราผ่านแบบเข้มงวดของ Haiku คือ 37.1% Anthropic รัน Luna บนชุดงานเดียวกันผ่าน API ของ OpenAI
- Terminal-Bench ใช้ 66 งานในคอนเทนเนอร์; Haiku รันที่ความพยายามสูงสุดในโหมด Claude Code แบบ bare โดยไม่มีการออกอินเทอร์เน็ตหรือโมเดลสำรอง เฉลี่ยสิบการลองต่อภารกิจ
- FrontierCode Main มี 100 งาน โดยห้ารันต่อภารกิจ; โมเดล Claude ใช้ Claude Code และโมเดล GPT ใช้ Codex
- GDPval-AA และ AA-Briefcase ประเมินโดยอิสระโดย Artificial Analysis และนำมาเผยแพร่ในวัสดุเปิดตัว เป็นสายการประเมินแยกกัน ไม่ใช่ฮาร์เนสการผลิตเดียว
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
ข้อได้เปรียบที่แข็งแกร่งที่สุดของ Haiku อยู่ในงานเปิดตัวที่ใช้ร่วมกันซึ่งต้องโต้ตอบกับคอมพิวเตอร์แบบกราฟิกหรือทำงานในเทอร์มินัล ช่องว่างคะแนนแบบบางส่วนของ OSWorld อยู่ที่ 23.5 จุดเปอร์เซ็นต์ ในขณะที่ Terminal-Bench ต่างกัน 22.8 จุด FrontierCode ที่ต่างกันเพียง 4.0 จุดแสดงให้เห็นว่าหมวดการเขียนโค้ดที่กว้างไม่ควรถูกมองเป็นงานเดียว
สำหรับระบบอัตโนมัติเบราว์เซอร์ ให้ทดสอบการนำทางหน้า การกรอกแบบฟอร์ม การกู้คืนจากความล้มเหลวของเครื่องมือ และการเสร็จสิ้นแบบ End-to-End สำหรับการเขียนโค้ด ให้ทดสอบว่าแพตช์ผ่านการตรวจสอบการทำงานของรีโพซิตอรีของคุณและคงอยู่ในขอบเขตหรือไม่ การตรวจสอบการยอมรับเหล่านั้นมีประโยชน์มากกว่าการเลือกโมเดลจากช่องว่างพาดหัวข่าวที่ใหญ่ที่สุด
Long Context and Document Processing
ความแตกต่าง 5% ในความจุคอนเท็กซ์ตามชื่อไม่สำคัญเท่าความเชื่อถือได้และราคาของการประมวลผลพรอมต์จำนวนมาก โมเดลใดๆ ไม่ได้เหนือกว่าในการดึงข้อมูลเพียงเพราะหน้าต่างคอนเท็กซ์ใหญ่กว่า
ความแตกต่างสำคัญคือเมื่ออัตราที่สูงกว่าจะเริ่มใช้: พรอมต์ 150K โทเค็นข้ามเกณฑ์ของ Haiku ขณะที่ยังอยู่ในระดับฐานของ Luna ดังนั้น Luna จึงเป็นจุดเริ่มต้นต้นทุนต่ำสำหรับงานโทเค็นนั้น ว่าเป็นนักวิเคราะห์เอกสารที่ดีกว่าหรือไม่ยังขึ้นกับความแม่นยำของการแยกข้อมูล การอ้างอิง และจำนวนการลองซ้ำที่ต้องใช้เพื่อให้ได้คำตอบที่ยอมรับได้
Reasoning Controls
ทั้งสองโมเดลมีระดับความพยายามด้านเหตุผลที่ปรับได้ โดยค่าเริ่มต้นเป็นระดับกลางตามเอกสารที่อ้างถึง Luna ยังมีการตั้งค่า none ใช้การควบคุมเหล่านั้นให้เหมาะกับงาน: การแยกข้อมูลและการกำหนดเส้นทางอาจต้องใช้เหตุผลน้อยกว่างานเวิร์กโฟลว์เครื่องมือหลายขั้นตอนที่ไม่แน่นอน ป้ายกำกับความพยายามเดียวกันไม่ได้หมายความว่างบประมาณคอมพิวต์เท่ากันระหว่างผู้ขาย
Multimodal Input and Structured Workflows
ทั้งสองรับข้อความและภาพ และผลิตข้อความ ทำให้เหมาะกับภาพหน้าจอ การแยกข้อมูลจากภาพเอกสาร และเวิร์กโฟลว์แบบมีโครงสร้างในลำธารถัดไป การรองรับอินพุตเพียงอย่างเดียวไม่ได้ยืนยันความแม่นยำที่เท่ากันบนข้อความเล็ก แผนภูมิ หรืออินเทอร์เฟซภาพ; วัดกรณีเหล่านั้นแยกต่างหาก
Speed and Task Economics
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 โทเค็น/วินาที | 123.0 โทเค็น/วินาที |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis เป็นผู้เผยแพร่การทดสอบอิสระ ตารางนี้เป็นสแนปช็อตของหน้ารุ่นโหมดความพยายามสูงสุด ตรวจเมื่อ 9 ตุลาคม 2026 ไม่ใช่ประสิทธิภาพทางการของผู้ขาย ความเร็วเอาต์พุตวัดโทเค็นที่ได้รับหลังเริ่มสร้าง แยกจากเวลาถึงโทเค็นแรกและเวลาแฝงของงานเต็ม ต้นทุนต่อภารกิจเป็นเมตริก Intelligence Index แบบถ่วงน้ำหนัก ไม่ใช่ใบเสนอราคาสำหรับงานโปรดักชันของคุณหรือค่าต่อผลลัพธ์ที่สำเร็จ
สแนปช็อตอัตราการส่งเอาต์พุตของ Haiku สูงกว่าของ Luna ประมาณ 1.96 เท่า ในขณะที่ต้นทุนภารกิจแบบถ่วงน้ำหนักของ Luna ต่ำกว่า สิ่งนี้ไม่ได้ยืนยันข้อได้เปรียบ 1.96 เท่าในเวลาเสร็จงานเต็ม การทดสอบโปรดักชันควรบันทึกเวลาถึงโทเค็นแรก เวลาเสร็จสิ้น ความยาวเอาต์พุต การใช้เหตุผล และเวลาในการเรียกเครื่องมือแยกกัน
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
ดอลลาร์สหรัฐต่อโทเค็นหนึ่งล้านที่อัตราการประมวลผลมาตรฐาน ตรวจเมื่อ 9 ตุลาคม 2026 ตารางใช้อัตรามาตรฐานและการเขียนแคช 5 นาทีของ Haiku Haiku's standard and 5-minute cache-write rates และอัตราระยะสั้น/ยาวของ Luna Luna's short- and long-context rates ค่าธรรมเนียมเครื่องมือ ภาษี การเพิ่มราคาตามภูมิภาค และการปรับระดับการประมวลผลตัวเลือกถูกตัดออก เหนือเกณฑ์อินพุต อัตราที่สูงกว่าที่ใช้จะครอบคลุมคำขอ ไม่ใช่เฉพาะโทเค็นส่วนเกิน
ความแตกต่างสำคัญคือเกณฑ์การคิดเงิน Haiku ย้ายไปสู่ระดับราคาที่สูงกว่าหลัง 100K โทเค็นพรอมต์ ขณะที่ Luna รักษาระดับฐานจนถึง 272K แม้เหนือเกณฑ์นั้น อัตราอินพุตและเอาต์พุตของ Luna สำหรับคอนเท็กซ์ยาวที่อ้างถึงยังต่ำกว่า
Haiku ยังมีการเขียนแคช 1 ชั่วโมงที่ $0.20/$1.00 ต่อโทเค็นหนึ่งล้านสำหรับพรอมต์สั้น/ยาว ความคงอยู่และกลไกการตั้งราคาแคชต่างกันระหว่างผู้ขาย ดังนั้นให้เปรียบเทียบรูปแบบการใช้งานซ้ำ แทนที่จะถือว่าทั้งสองแถวการเขียนแคชเป็นผลิตภัณฑ์เดียวกัน ขีดจำกัดเอาต์พุต 128K เป็นขีดจำกัด API มาตรฐาน; Message Batches API ของ Haiku รองรับเอาต์พุต 300K ด้วยเบตาเฮดเดอร์
Illustrative Costs at Fixed Token Budgets
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
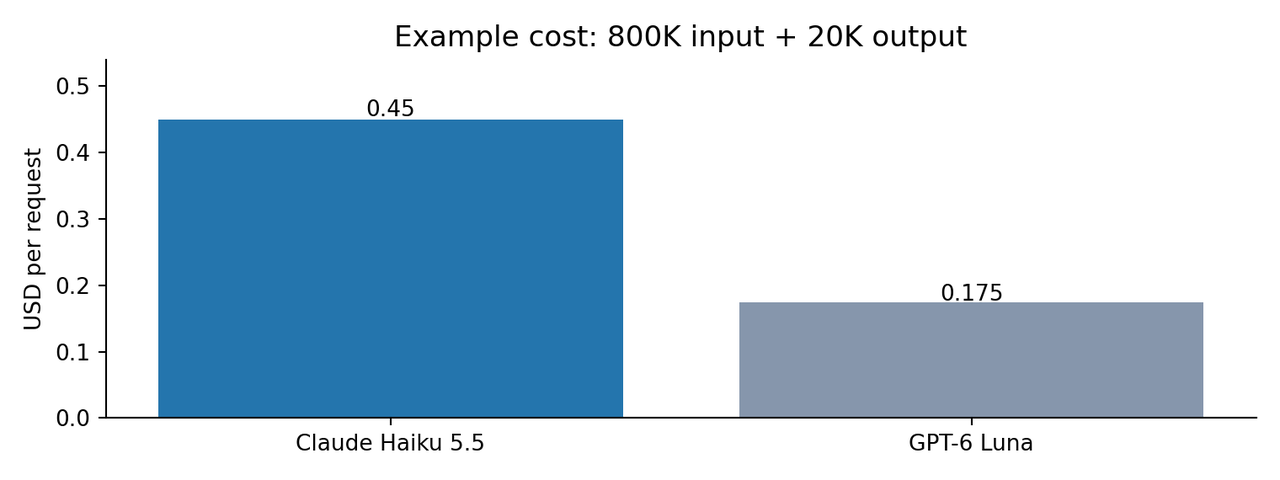
ประมาณการมาตรฐานแบบไม่มีแคชคำนวณโดยผู้เขียน: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000 “Output” หมายถึงเอาต์พุตที่ถูกคิดเงินรวมในประมาณการนี้ รวมถึงโทเค็นเหตุผลในกรณีที่คิดเป็นเอาต์พุต; ไม่จำเป็นต้องเท่ากับความยาวคำตอบที่มองเห็น ใช้นับโทเค็นที่รายงานเดียวกันสำหรับทั้งสองโมเดล แม้ว่า tokenizer อาจต่างกัน
โทเค็นราคาถูกไม่ได้หมายความว่าผลลัพธ์ที่สำเร็จจะถูกเสมอ ทีมควรคำนวณความพยายามซ้ำ การเรียกเครื่องมือที่ล้มเหลว การใช้โทเค็นเหตุผล และพฤติกรรม tokenizer ที่ต่างกัน
CometAPI Access and Integration Constraints
CometAPI มีตัวเลือกการเข้าถึงสำหรับทั้งสองโมเดล ก่อนเปรียบเทียบหรือปรับใช้ผ่านเกตเวย์ ให้ยืนยันรหัสโมเดล ปลายทางที่รองรับ พารามิเตอร์คำขอ พฤติกรรมเครื่องมือ และกฎการคิดเงินสำหรับแต่ละเส้นทาง ลิงก์ของผู้ให้บริการเหล่านี้บันทึกตัวเลือกการเข้าถึง; แต่ไม่แทนที่แหล่งเทคนิคหรือราคามาตรฐานของผู้ขาย
สำหรับการผสานรวม OpenAI โดยตรง Luna รองรับเครื่องมือในตัวผ่าน Responses API; การเรียกฟังก์ชันของ Chat Completions ต้องการระดับ reasoning แบบ none Haiku ใช้ Anthropic's Messages API และ adaptive thinking เกตเวย์ไม่ได้ทำให้สคีมาพื้นฐานสามารถสลับกันได้: ตรวจสอบคำจำกัดความของเครื่องมือ พฤติกรรมเอาต์พุตแบบมีโครงสร้าง เหตุการณ์สตรีม และการบัญชีกับเส้นทางที่คุณตั้งใจใช้จริง
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
ตัวอย่างการเปรียบเทียบเชิงปฏิบัติสามารถใช้ชุดเอกสารสัญญาซัพพลายเออร์ที่มีวันที่มีผล เงื่อนไขการต่ออายุ ระยะเวลาบอกเลิก และข้อยกเว้น รักษาชุดเอกสาร คำสั่งการแยกข้อมูล ฟิลด์ที่คาดหวัง และกฎการตรวจสอบให้เหมือนกันต่อทั้งสอง ต่อไปนี้เป็นการออกแบบการประเมิน ไม่ใช่ผลโมเดลที่วัดใหม่
ตัวอย่างพรอมต์: แยกชื่อซัพพลายเออร์ของแต่ละสัญญา วันที่มีผล วันที่ต่ออายุ ระยะเวลาบอกเลิก และข้อยกเว้นราคา สำหรับค่าที่แยกทุกค่า ให้ระบุชื่อเอกสารและข้อความสนับสนุนที่แน่นอน หากฟิลด์ไม่มี ให้คืนค่า null; อย่าเดาวันที่ที่หายไป ทำธงข้อกำหนดที่ขัดแย้ง และรักษาคำตอบสุดท้ายภายใน 1,000 คำ
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | ฟิลด์ที่ต้องการตรงกับกุญแจคำตอบที่ตรวจอิสระ | ค่าถูก ผิด และขาดหาย |
| Grounding | ทุกฟิลด์ที่ไม่ใช่ null มีข้อความสนับสนุนที่ถูกต้อง | การอ้างอิงที่ไม่มีหลักฐานและการอ้างชื่อเอกสารผิด |
| Instruction following | ไม่มีการประดิษฐ์วันที่; ฟิลด์ที่ไม่มีคืนค่า null | ความล้มเหลวของสคีมาและการละเมิดข้อกำหนด |
| Economics | คำนวณค่าใช้จ่ายต่อการแยกข้อมูลที่ผ่านเกณฑ์ | อินพุต เอาต์พุต เหตุผล การลองซ้ำ และต้นทุน fallback ที่คิดเงิน |
| Latency | เปรียบเทียบเวลางานเต็มภายใต้นโยบายเครื่องมือเดียวกัน | เวลาถึงโทเค็นแรกและเวลา End-to-End |
รันมากกว่าหนึ่งชุดตัวแทน และทำซ้ำกรณีที่ผลต่าง เริ่มด้วยระดับความพยายามที่มีอยู่เหมือนกัน จากนั้นทดสอบการกำหนดค่าต้นทุนต่ำกว่าสำหรับแต่ละโมเดล รายงานขนาดตัวอย่าง การตั้งค่า เส้นทาง วันที่ และจำนวนความล้มเหลวก่อนเสนอผู้ชนะ
Haiku 5.5 or GPT-6 Luna: Which to Choose?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | คะแนนแบบบางส่วนของ OSWorld ที่แชร์ไว้เอียงไปทาง Haiku; ยืนยันความสำเร็จงานเต็ม |
| Terminal coding | Claude Haiku 5.5 | คะแนน Terminal-Bench ที่แชร์ไว้เอียงไปทาง Haiku; ตรวจการเปลี่ยนแปลงในรีโพซิตอรี |
| Short prompts and base prices | ทดสอบทั้งสอง | อัตราฐานเท่ากัน; เปรียบเทียบการใช้งานที่คิดเงินและการลองซ้ำ |
| Prompts above 100K tokens | GPT-6 Luna บนอัตรามาตรฐาน | Luna รักษาระดับฐานนานกว่า; ความแม่นยำอาจเปลี่ยนต้นทุนรวม |
| Streamed token throughput | Claude Haiku 5.5 ในสแนปช็อตที่ระบุ | อัตราผ่านต่างจากเวลาเสร็จงานเต็ม |
| Simple repeated extraction | ทดสอบ Luna ด้วยเหตุผลต่ำหรือไม่มี | เลือกจากผลลัพธ์ที่ผ่านเกณฑ์ ไม่ใช่จากราคาเพียงอย่างเดียว |
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
เริ่มจาก Haiku เมื่อแอปของคุณคล้ายกับงานที่เผยแพร่สำหรับคอมพิวเตอร์กราฟิก การเขียนโค้ดบนเทอร์มินัล หรืองานมืออาชีพ และอัตราความสำเร็จที่สูงขึ้นชดเชยการใช้เหตุผลหรือคอนเท็กซ์ยาวที่เพิ่มขึ้น ยืนยันข้อได้เปรียบนั้นบนชุดเครื่องมือของคุณก่อนส่งทราฟฟิกโปรดักชัน
Choose GPT-6 Luna for Large-Prompt Cost Control
เริ่มจาก Luna เมื่อพรอมต์เกิน 100K โทเค็นบ่อยครั้งและต้นทุนโทเค็นมาตรฐานมีผลต่อบประมาณอย่างมีนัยสำคัญ เป็นผู้สมัครสำหรับการแยกข้อมูลซ้ำๆ หรือการกำหนดเส้นทางที่สำเร็จด้วยเหตุผลต่ำหรือไม่มี รักษาคำแนะนำแบบมีเงื่อนไขตามอัตราผลลัพธ์ที่ผ่านเกณฑ์และการใช้งานที่คิดเงินจริง
Use Both When Workloads Have Different Needs
การนำร่องอาจกำหนดเส้นทางการแยกเอกสารยาวไปที่ Luna และงาน GUI หรือเทอร์มินัลไปที่ Haiku จากนั้นยืนยันแต่ละตัวเลือกกับการตรวจรับรอง ทริกเกอร์ fallback เมื่อเอาต์พุตล้มเหลวในการตรวจสคีมา ไม่มีหลักฐานที่ต้องการ หรือไม่ผ่านการตรวจเฉพาะงาน และรวมต้นทุนและเวลาแฝงของ fallback ในการเปรียบเทียบ
Validate Before Switching
รวมโมเดลปัจจุบันเป็นค่าพื้นฐาน ย้ายเฉพาะเมื่อผู้สมัครบรรลุเป้าหมายความถูกต้องที่กำหนดไว้และปรับปรุงต้นทุนต่อผลลัพธ์ที่ผ่านเกณฑ์หรือเวลา End-to-End มากพอที่จะครอบคลุมต้นทุนการย้ายและบำรุงรักษา ชะลอการปล่อยหากข้อผิดพลาดของเครื่องมือสำคัญเพิ่มขึ้น คำแนะนำอาจเปลี่ยนหากการนำร่องแสดงว่าอัตราที่ต่ำกว่าของ Luna ถูกหักล้างด้วยการลองซ้ำ หรือคะแนนเบนช์มาร์กที่สูงกว่าของ Haiku ไม่ได้ปรับปรุงความสำเร็จของงานของคุณ
- ใช้ชุดงานตัวแทนและให้คะแนนผลลัพธ์ที่ถูก ผิด และไม่สมบูรณ์
- วัดเวลาถึงโทเค็นแรก เวลาเสร็จงานเต็ม และความเชื่อถือได้ของเครื่องมือ
- ติดตามจำนวนโทเค็นอินพุต แคช เอาต์พุต และเหตุผลแยกกัน
- คำนวณต้นทุนต่อผลลัพธ์ที่สำเร็จ รวมการลองซ้ำและ fallback
- เปรียบเทียบระดับความพยายามกลางและสูงก่อนเปิดใช้ระดับสูงสุดโดยค่าเริ่มต้น
Conclusion
Claude Haiku 5.5 มีหลักฐานการเปิดตัวแบบเฮดทูเฮดที่แข็งแกร่งกว่าในเบนช์มาร์กงานมืออาชีพ การใช้งานคอมพิวเตอร์ และการเขียนโค้ดแบบเอเจนติกที่เปรียบเทียบที่นี่ และมีอัตราการส่งเอาต์พุตสูงกว่าในสแนปช็อตอิสระ GPT-6 Luna มีข้อได้เปรียบอัตรามาตรฐานที่ชัดเจนสำหรับพรอมต์เหนือเกณฑ์ 100K ของ Haiku และต้นทุนภารกิจแบบถ่วงน้ำหนักต่ำกว่า การสังเกตทั้งสองข้อไม่สามารถตัดสินความเชื่อถือได้ในโปรดักชันหรือค่าต่อผลลัพธ์ที่สำเร็จได้ด้วยตัวเอง
ผู้ชนะเชิงปฏิบัติคือโมเดลที่ให้ผลลัพธ์ที่ยอมรับได้ด้วยต้นทุนการดำเนินงานทั้งหมดต่ำที่สุด รันทั้งสองกับพรอมต์ เครื่องมือ และกฎการลองซ้ำของคุณเอง แทนที่จะถือว่ามีเบนช์มาร์กเดียวเป็นคำตอบ
FAQ
Why can task costs differ when both models have the same base token prices?
อัตราฐานเดียวกันไม่ได้หมายความว่าบิลรวมจะเท่ากัน โมเดลอาจใช้จำนวนโทเค็นอินพุต เอาต์พุต และเหตุผลต่างกัน และอาจต้องจำนวนการลองซ้ำหรือการเรียกเครื่องมือที่ต่างกันเพื่อให้ได้ผลลัพธ์ที่ยอมรับได้ อัตราคอนเท็กซ์ยาวและการใช้แคชยังส่งผลต่อผลรวม เปรียบเทียบต้นทุนรวมของความพยายามทั้งหมดหารด้วยจำนวนผลลัพธ์ที่ผ่านเกณฑ์ แทนที่จะดูแค่ราคาโทเค็น
Do higher long-context rates apply only to tokens above the threshold?
ไม่ ภายใต้อัตรามาตรฐานที่อธิบายในบทความนี้ เมื่อข้ามเกณฑ์อินพุตจะใช้อัตราที่สูงกว่ากับคำขอทั้งคำ ไม่ใช่เฉพาะโทเค็นส่วนเกิน ตัวอย่างเช่น คำขออินพุต 150K โทเค็นข้ามเกณฑ์ 100K ของ Haiku แต่ยังอยู่ในระดับฐานของ Luna 272K ใช้อัตราอินพุตและเอาต์พุตที่ใช้กับคำขอทั้งคำเมื่อประมาณการต้นทุน
Can Claude Haiku 5.5 and GPT-6 Luna share a prompt cache?
อย่าคิดว่าแคชพรอมต์สามารถถ่ายโอนระหว่างโมเดลหรือผู้ให้บริการได้ ออกแบบกลยุทธ์การใช้งานซ้ำแยกกัน จากนั้นวัดอัตราการโดนแคชและการใช้งานที่คิดเงินในแต่ละเส้นทาง การรองรับเกตเวย์ กฎการเก็บรักษา และโครงสร้างคำขอสามารถส่งผลต่อความเหมาะสมของอินพุตที่ซ้ำสำหรับการแคช; ตรวจสอบสิ่งเหล่านี้ก่อนคาดการณ์การประหยัด
What should a Haiku-to-Luna migration test cover?
ทดสอบอินพุตข้อความและภาพที่เป็นตัวแทน ฟิลด์โครงสร้างที่ต้องการ อาร์กิวเมนต์ของเครื่องมือ การตอบสตรีม และการกู้คืนข้อผิดพลาด กำหนดอัตราการยอมรับของระบบปัจจุบันก่อน จากนั้นเปรียบเทียบผู้สมัครทั้งสองภายใต้นโยบายการลองซ้ำและเครื่องมือเดียวกัน ราคาโทเค็นที่คล้ายกันหรือหมวดโมเดลเดียวกันไม่ได้ยืนยันความเข้ากันได้
Should benchmark scores drive a Haiku or Luna fallback?
ใช้คะแนนเพื่อเลือกผู้สมัคร จากนั้นทริกเกอร์ fallback จากความล้มเหลวที่สังเกต เช่น อาร์กิวเมนต์เครื่องมือไม่ถูกต้อง ขาดฟิลด์ที่ต้องการ หรือไม่ผ่านการตรวจเฉพาะงาน ติดตามความถี่ของ fallback และต้นทุนที่คิดเงินรวม โมเดลที่สองสามารถเพิ่มเวลาแฝงและค่าใช้จ่าย ดังนั้นยืนยันว่ามันปรับปรุงผลลัพธ์ที่ผ่านเกณฑ์จริง ไม่ใช่เพียงให้คำตอบที่สอง
Can sensitive data be routed through both APIs?
ตรวจทบทวนผู้ขายและเกตเวย์ที่เกี่ยวข้อง การตั้งค่าการเก็บรักษาปัจจุบัน สถานที่ประมวลผล เงื่อนไขสัญญา และนโยบายข้อมูลขององค์กรของคุณก่อนส่งผ่านอินพุตที่อ่อนไหว ความสามารถของโมเดลและตารางราคาไม่ยืนยันความเหมาะสมของเส้นทางสำหรับข้อมูลตามข้อบังคับหรือข้อมูลลับ ใช้เส้นทางที่ได้รับอนุมัติเมื่อข้อกำหนดเหล่านั้นเป็นปัจจัยชี้ขาด