
TL;DR
Google ประกาศ Gemini 4 Argon เมื่อวันที่ 30 กันยายน 2026 ในฐานะโมเดลระดับแนวหน้าสำหรับเวิร์กโฟลว์ที่ซับซ้อนและทำงานยาวนาน ผลลัพธ์ที่เผยแพร่แสดงรูปแบบชัดเจน: แข็งแกร่งในงานความรู้เชิงวิชาชีพ งานบริบทยาว และการประเมินวิศวกรรมซอฟต์แวร์บางชุด แต่ยังอ่อนกว่าบางรุ่นคู่แข่งบนเกณฑ์วัดการใช้เทอร์มินัลและการใช้งานคอมพิวเตอร์บางรายการ Google กำลังทยอยปล่อยใช้งานเป็นระยะๆ อีกด้านหนึ่ง CometAPI รายงานว่ามีอยู่ในแค็ตตาล็อก ณ วันที่ 1 ตุลาคม; ควรตรวจสอบคุณสมบัติของบัญชีและคำขอทดสอบที่สำเร็จก่อนนำไปใช้งานจริง เรื่องราวด้านประสิทธิภาพที่เป็นประโยชน์กว่าคือ “จุดที่ผลลัพธ์ดีขึ้น” ปรากฏตรงไหน
Argon ทำได้ 68.9% บน Vals Index, 65.4% บน Vals Finance Agent v2, 77.9% บน DeepSWE v1.1, 91.7% บน LVBench และ 84.2% บน GraphWalks ที่บริบท 256K–1M ขณะเดียวกันยังตามหลังโมเดลระดับแนวหน้าบางรุ่นบน FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science และ OSWorld-2.0
ผลลัพธ์ชี้ให้เห็นมุมมองแบบจำเพาะเวิร์กโหลดต่อ Argon จุดแข็งกระจุกตัวที่งานความรู้เชิงวิชาชีพ บริบทยาวมาก และการประเมินมัลติโหมด/วิศวกรรมซอฟต์แวร์ที่คัดเลือก ส่วนโมเดลอื่นยังได้เปรียบบนการทดสอบการใช้เทอร์มินัลและคอมพิวเตอร์หลายรายการ
Key Takeaways
- Gemini 4 Argon เด่นที่สุดในงานความรู้ระดับองค์กร การให้เหตุผลในบริบทยาว ความเข้าใจมัลติโหมด และการประเมินการโค้ดระยะยาวหลายแบบ
- ขีดจำกัดเอาต์พุตสูงสุด 1,000,000 โทเคน เปิดพื้นที่การสร้างข้อความเพิ่มสำหรับวิถีการให้เหตุผลที่ยาวขึ้น; ยังไม่มีสเปกบริบทอินพุตสาธารณะ
- Argon นำในผลลัพธ์งานความรู้และบริบทยาวหลายรายการ แต่ GPT-6 Astra และ Claude Opus 5.5 ยังนำหน้าในบางการประเมินการโค้ดและการใช้งานคอมพิวเตอร์
- คะแนนเกณฑ์วัดสะท้อนคอนฟิกโมเดลและเอเจนต์เฉพาะ การตั้งค่าเมตริก เงื่อนไขอินพุต และวิธีประเมินสำคัญพอๆ กับตัวเลขเปอร์เซ็นต์พาดหัว
- การทยอยปล่อยของ Google และการเข้าถึงผ่าน CometAPI เป็นคนละข้ออ้างการมีให้ใช้งาน ควรยืนยันเส้นทางที่ใช้งานได้จริง ตัวระบุโมเดล และคุณสมบัติบัญชีก่อนย้ายทราฟฟิก
What Is Gemini 4 Argon?
Gemini 4 Argon คือโมเดล Gemini ระดับแนวหน้าตัวใหม่ของ Google DeepMind ออกแบบมาสำหรับเวิร์กโฟลว์ที่ยากซึ่งต้องให้เหตุผลหลายขั้น มากกว่าจะตอบคำถามสั้นๆ เพียงครั้งเดียว
การวางตำแหน่งอย่างเป็นทางการของ Google เน้นวิศวกรรมซอฟต์แวร์ในโลกจริง งานความรู้ระดับองค์กรอย่างกฎหมายและการเงิน ความปลอดภัยไซเบอร์เชิงป้องกัน ความเข้าใจมัลติโหมด และงานเอเจนต์ที่รันยาวนาน
นี่เป็นความแตกต่างสำคัญจากรุ่น Flash ล่าสุด Gemini 3.8 Flash API ใน CometAPI ถูกออกแบบให้เป็นม้าทำงานต้นทุนต่ำสำหรับเวิร์กโหลดเชิงเอเจนต์ที่สเกลใหญ่ ขณะที่ Argon แทนตำแหน่งปลายแถวของสแตก Google ให้ความสำคัญกับความลึกและการดำเนินการต่อเนื่อง
Model Specifications
| Specification | Gemini 4 Argon |
|---|---|
| Developer | Google DeepMind |
| Announced | 30 กันยายน 2026 |
| Model family | Gemini 4 |
| Positioning | โมเดลสำหรับการให้เหตุผลระดับแนวหน้าและภารกิจระยะยาว |
| Maximum output | 1,000,000 tokens |
| Long-context evaluation | ทดสอบที่ช่วง 256K–1M บน GraphWalks |
| Public input context limit | ไม่ได้ระบุอย่างเป็นทางการในตารางสเปก API สาธารณะมาตรฐานในช่วงเปิดตัว |
| Multimodal understanding | ใช่; รวมชาร์ต เอกสาร และการประเมินวิดีโอความยาวมาก |
| Agentic coding | ใช่ |
| Computer use | ผ่านการประเมิน |
| Cybersecurity | ความสามารถเชิงป้องกันแบบเฉพาะทาง |
| Google public API model ID | ไม่ได้ประกาศในเอกสารสาธารณะช่วงแรก; CometAPI ใช้ gemini-4-argon เป็นตัวระบุในแค็ตตาล็อก |
Output Budget and Trade-offs
Google ประกาศขีดจำกัดเอาต์พุตสูงสุด 1 ล้านโทเคนสำหรับ Argon เพิ่มจากขีดจำกัด 64K ที่อ้างในประกาศเปิดตัวก่อนหน้า ช่วยให้มีพื้นที่สำหรับวิถีการให้เหตุผลที่ยาวขึ้น ไม่ควรตีความว่าเป็นงบประมาณรวมที่รับประกันได้สำหรับทั้งเซสชันเอเจนต์หลายคอล หรือเป็นหลักฐานว่าทุกงานจะดีขึ้น
ขีดจำกัดเอาต์พุตสูงสุดไม่เท่ากับความฉลาด การให้โทเคนเอาต์พุตมากขึ้นไม่ได้ทำให้โมเดลเก่งขึ้นโดยอัตโนมัติ เพียงแต่ลดคอขวดอย่างหนึ่ง โมเดลยังต้องใช้งบประมาณนั้นอย่างมีประสิทธิผล
ยังมีข้อแลกเปลี่ยนด้านต้นทุนและเวลาแฝง โมเดลที่สร้างโทเคนหลายแสนจริงๆ อาจมีค่าใช้จ่ายสูงและช้า แม้ราคาโทเคนตามหน้าตาจะดูน่าดึงดูด

คัดลอกผลเกณฑ์วัดบางส่วนจากบทความ เปรียบเทียบโมเดลภายในแต่ละแถว; เมตริกและเงื่อนไขการประเมินแตกต่างกัน กราฟนี้แทนที่งานกราฟิกไล่เฉดตกแต่งและไม่ใช่การทดสอบอิสระ
ขีดจำกัดเอาต์พุตสูงสุดและหน้าต่างบริบทอินพุตอธิบายความสามารถคนละด้าน ช่วงการประเมิน GraphWalks เป็นหลักฐานเกี่ยวกับอินพุตที่ใช้ทดสอบ ไม่ใช่สารทดแทนสเปก API สาธารณะ
How Does Gemini 4 Argon Perform on Benchmarks?
ตารางประสิทธิภาพของ Google DeepMind ครอบคลุมเวิร์กโฟลว์เอเจนต์ งานความรู้เชิงวิชาชีพ และงานมัลติโหมด ค่าด้านล่างคัดลอกจากการเปรียบเทียบที่เผยแพร่ วัดผลการทำงานของงาน ไม่ใช่อัตราการประมวลโทเคนหรือเวลาแฝงการตอบกลับ “—” หมายถึงไม่มีการรายงานผลในแถบเปรียบเทียบนี้
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | ชุดทดสอบส่วนตัว; ลีดเดอร์บอร์ด Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; แหล่งข้อมูลผสม |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | ลีดเดอร์บอร์ด Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | การทดสอบเอง / ลีดเดอร์บอร์ด |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; H100 หนึ่งตัว |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | ตัวตรวจสอบหมดเวลา ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | เครื่องมือ Linux; อินเทอร์เน็ต |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | ลีดเดอร์บอร์ด Surge |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 รายการ |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 รายการ |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | ผ่านแบบทวิภาค; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | คะแนนบางส่วนแบบออฟไลน์; ดีที่สุดจาก 3 ครั้งรัน |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | ไม่มีเครื่องมือ; ลีดเดอร์บอร์ด Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | ไม่มีเครื่องมือ; การสุ่มตัวอย่างเฟรมเฉพาะโมเดล |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; ใช้ pass@4 ตัดสินกรณีเสมอ |
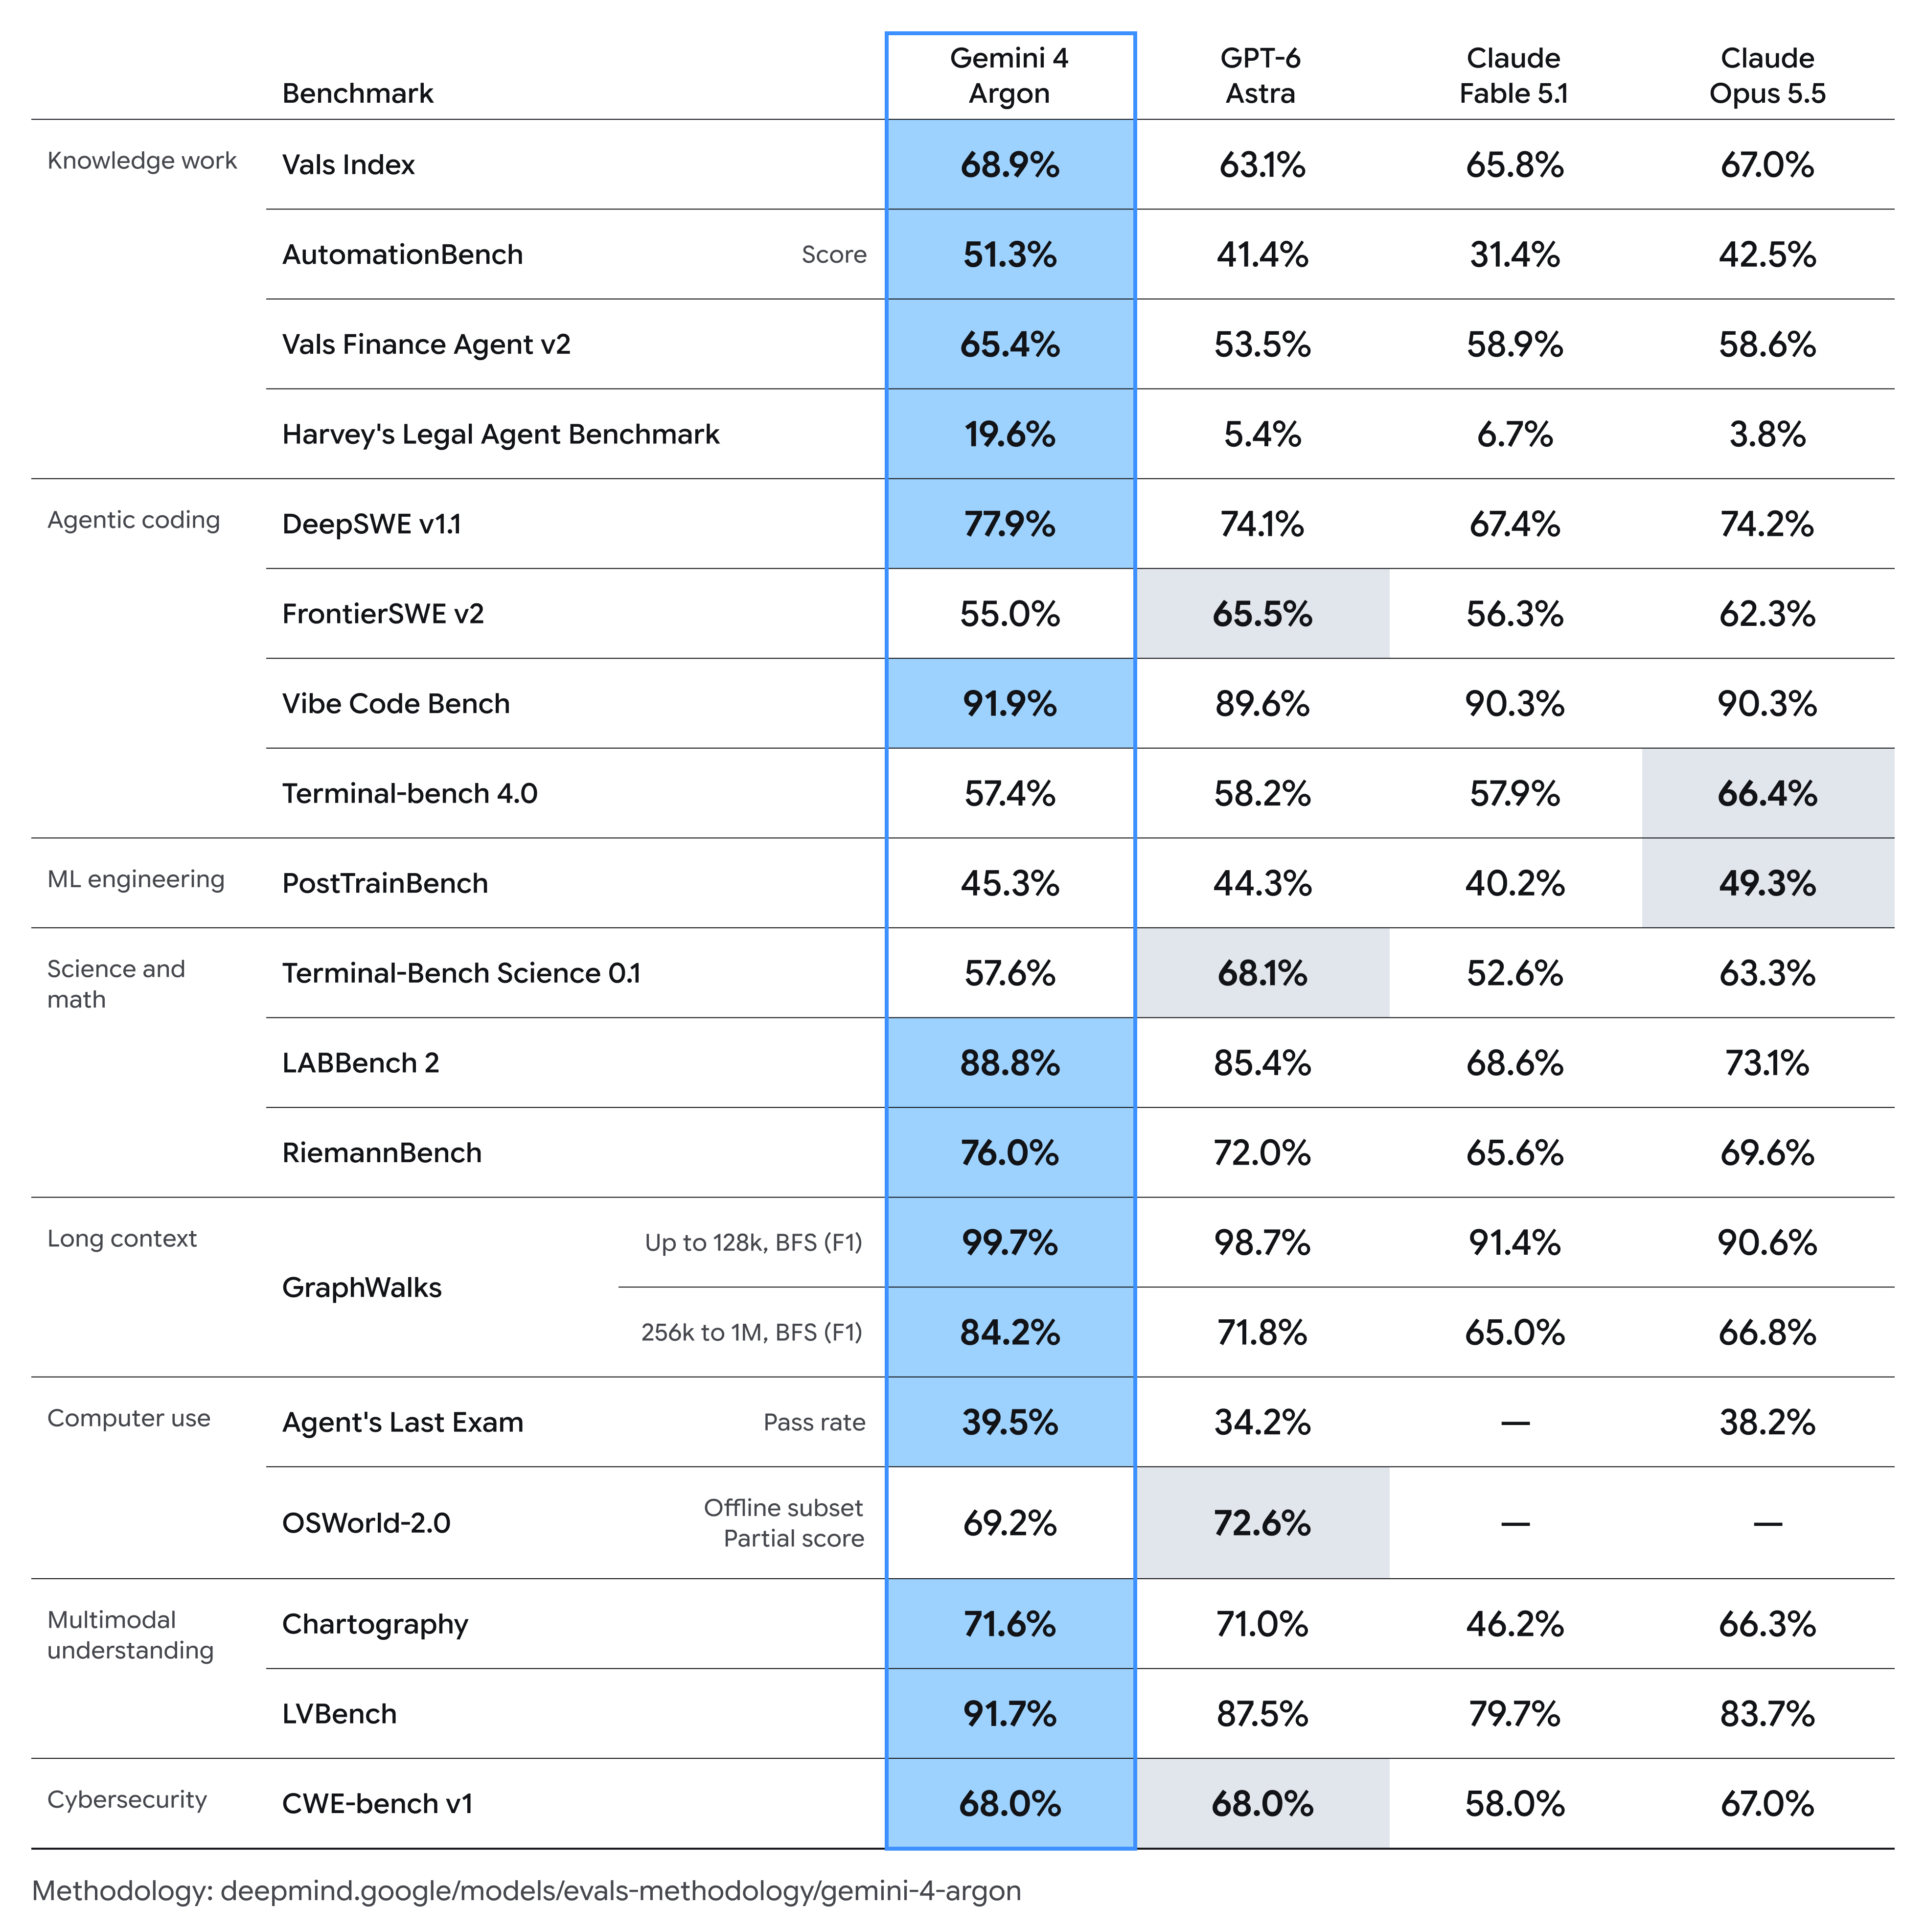
ภาพเปรียบเทียบเกณฑ์วัด Gemini 4 Argon อย่างเป็นทางการของ Google
เว้นแต่มีข้อสังเกตเป็นอย่างอื่น ผลของ Argon ใช้ความพยายามครั้งเดียวและการตั้งค่าการคิดสูงสุด ผลของโมเดลอื่นๆ โดยทั่วไปมาจากรายงานของผู้ให้บริการ พร้อมข้อยกเว้นเฉพาะเกณฑ์วัด LVBench ใช้ 1 FPS สำหรับ Gemini, 800 เฟรมสำหรับ GPT-6 Astra, 300 สำหรับ Fable 5.1 และ 600 สำหรับ Opus 5.5 อินพุตเหล่านี้ไม่เหมือนกัน จึงควรเปรียบเทียบตามคอนฟิกที่รายงาน แทนที่จะมองว่าแต่ละแถวเป็นการรันควบคุมเดียวกัน
Evaluation Conditions and Limitations
ตารางนี้มีประโยชน์ แต่ไม่ควรถูกตีความว่าเป็นลีดเดอร์บอร์ดสากลอิสระ
- การคัดเลือกเกณฑ์วัดเป็นการเลือกของ Google
- การตั้งค่าการประเมินเฉพาะเกณฑ์วัด แตกต่างกันในแต่ละแถว รวมถึงเฟรมเวิร์กเอเจนต์ งบเวลา เครื่องมือ และการสุ่มตัวอย่างอินพุต
- ระเบียบวิธีอย่างเป็นทางการระบุว่าผลโมเดลคู่แข่งใช้รายงานจากผู้ให้บริการเป็นค่าเริ่มต้น พร้อมข้อยกเว้นจากลีดเดอร์บอร์ดและการคำนวณเองเฉพาะรายการ
- การตั้งค่าระดับสูงสุดของเกณฑ์วัดอาจไม่สะท้อนคอนฟิกอินเฟอเรนซ์สำหรับโปรดักชันโดยปริยาย
- คะแนนเกณฑ์วัดพาดหัวเพียงอย่างเดียวไม่เปิดเผยการใช้โทเคน การเรียกเครื่องมือ การลองซ้ำ เวลาที่ผ่านไป หรือการแทรกแซงของมนุษย์
สำหรับระบบโปรดักชัน เมตริกที่ดีกว่ามักเป็นต้นทุนต่อภารกิจที่สำเร็จ มากกว่าราคาต่อโทเคนหรือเปอร์เซ็นต์เกณฑ์วัดเดียว
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
รูปแบบที่ชัดเจนที่สุดในผลของ Argon ปรากฏในงานความรู้เชิงวิชาชีพแบบหลายขั้น
บน Vals Index Argon ได้ 68.9% เทียบกับ 67.0% สำหรับ Claude Opus 5.5 ช่องว่างตัวเลขพอประมาณ แต่รูปแบบเด่นชัดขึ้นในเวิร์กโฟลว์เฉพาะทาง
- Vals Finance Agent v2: 65.4% สูงกว่าคู่แข่งที่แรงสุดในตารางของ Google 6.5 จุด
- AutomationBench: 51.3% สูงกว่า Claude Opus 5.5 อยู่ 8.8 จุด
- Harvey's Legal Agent Benchmark: 19.6% เทียบกับ 6.7% สำหรับโมเดลที่ตามมาติดๆ
โปรไฟล์ประสิทธิภาพบ่งชี้ว่า Argon ได้ประโยชน์มากที่สุดเมื่อโมเดลต้องรวบรวมข้อมูล รักษาสถานะ ให้เหตุผลข้ามหลายช่วง และผลิตสิ่งส่งมอบระดับมืออาชีพ มากกว่าตอบคำถามปลายปิด
คะแนน low absolute ของ legal-agent ก็สำคัญเช่นกัน คะแนน 19.6% เพียงอย่างเดียวไม่บอกว่ามีเกณฑ์หรือเวิร์กโฟลว์ครบชุดใดล้มเหลวกี่ส่วน บทสรุปที่มีประโยชน์คือ Argon แสดงการปรับปรุงสัมพัทธ์ขนาดใหญ่ในการประเมินนี้ แต่ผลดังกล่าวยังไม่ยืนยันการทำงานอัตโนมัติที่เชื่อถือได้ของงานกฎหมาย
Long-Context Reasoning
ข้อได้เปรียบที่เด่นชัดที่สุดของ Argon อาจอยู่ที่ GraphWalks เวอร์ชัน 256K–1M
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
นั่นคือความต่าง 12.4 จุดเหนือโมเดลที่ใกล้ที่สุดในการเปรียบเทียบที่เผยแพร่
ช่องว่างเล็กกว่ามากที่ความยาวบริบทสั้นกว่า: บน GraphWalks สูงสุด 128K Argon ได้ 99.7% และ GPT-6 Astra ได้ 98.7% สิ่งนี้บ่งชี้ว่า Argon เสื่อมประสิทธิภาพช้ากว่าโมเดลที่เทียบในเกณฑ์วัดบริบทยาวมากรายการนี้
สิ่งที่ Google ยังไม่ได้เปิดเผยคือข้อมูลสถาปัตยกรรมเพียงพอที่จะโยงความต่างนี้ไปยังกลไก attention ระบบเรียกคืน สูตรการฝึก หรือกลยุทธ์ช่วงอินเฟอเรนซ์เฉพาะ คำกล่าวเช่น “Gemini 4 แนะนำสถาปัตยกรรม attention แบบใหม่” จึงเกินหลักฐานสาธารณะ
Coding Performance
ตารางเกณฑ์วัดอย่างเป็นทางการไม่สนับสนุนคำตอบง่ายๆ
Argon ทำได้ดีมากในงานโค้ดบางแบบ และแพ้ชัดเจนในบางแบบ บน DeepSWE v1.1 ได้ 77.9% เทียบกับ 74.2% สำหรับ Claude Opus 5.5 และ 74.1% สำหรับ GPT-6 Astra คะแนน Vibe Code Bench ก็แข็งแกร่งที่ 91.9%
- FrontierSWE v2: 55.0% สำหรับ Argon เทียบกับ 65.5% สำหรับ GPT-6 Astra
- Terminal-Bench 4.0: 57.4% สำหรับ Argon เทียบกับ 66.4% สำหรับ Claude Opus 5.5
- Terminal-Bench Science 0.1: 57.6% สำหรับ Argon เทียบกับ 68.1% สำหรับ GPT-6 Astra
ความแยกนี้สำคัญสำหรับนักพัฒนา Argon ดูจะแข็งแกร่งเป็นพิเศษเมื่อการโค้ดเป็นเวิร์กโฟลว์วิศวกรรมยาวที่มีบริบทและการวางแผนมาก ขณะการดำเนินการที่พึ่งเทอร์มินัลยังแข่งขันสูง เกณฑ์ย้ายรีโพกับเกณฑ์เทอร์มินัลเชิงโต้ตอบไม่ควรถูกมองเป็นตัวชี้วัด “ความสามารถการโค้ด” แบบทดแทนกัน
Defensive Cybersecurity
ไซเบอร์ซีเคียวริตี้เป็นพื้นที่ใช้งานหลัก การวางตำแหน่งเชิงป้องกันของ Google รวมการค้นหา ยืนยัน และแพตช์ช่องโหว่อัตโนมัติ นี่คือข้ออ้างความสามารถจากผู้ให้บริการ; ผล CWE-bench ด้านล่างวัดการแก้ไขช่องโหว่บนเกณฑ์ของตนเอง
บน CWE-bench v1 Argon ได้ 68% เทียบกับ GPT-6 Astra ที่เสมอกัน และนำหน้า Claude Opus 5.5 เล็กน้อยที่ 67%
Google ยังเน้นกลไกป้องกันที่แข็งแรงขึ้นต่อการใช้งานผิดวัตถุประสงค์ การโจมตีด้วย prompt ทางอ้อม พฤติกรรมเอเจนต์ที่เสี่ยง และการถูกเจาะสภาพแวดล้อมรัน ทำให้ Argon เป็นการอัปเกรดด้านความปลอดภัยของเอเจนต์พอๆ กับการอัปเกรดโมเดล
Multimodal Understanding
Argon ได้ 71.6% บน Chartography และ 91.7% บน LVBench สำหรับความเข้าใจวิดีโอความยาวมาก ผล LVBench สูงกว่า GPT-6 Astra 4.2 จุดในตารางของ Google เนื่องจากแต่ละโมเดลได้รับคอนฟิกการสุ่มตัวอย่างเฟรมต่างกัน นี่จึงเป็นการเปรียบเทียบชุดคอนฟิกที่รายงาน ไม่ใช่ความได้เปรียบตัวโมเดลล้วนๆ
สิ่งนี้สำคัญเพราะเวิร์กโฟลว์วิชาชีพจำนวนมากไม่ใช่ข้อความล้วน เอเจนต์วิจัยการเงินอาจต้องดูชาร์ต ผู้ช่วยองค์กรอาจผสานรายงาน PDF และสกรีนช็อต ระบบวิเคราะห์วิดีโออาจต้องรักษาเหตุการณ์ตลอดลำดับยาว แทนการประมวลเฟรมแยก
การผสานการรับรู้มัลติโหมดและเหตุผลต่อเนื่องของ Argon จึงเกี่ยวข้องมากกว่าการรองรับมัลติโหมดเพียงอย่างเดียว
Science and Mathematics Performance
ผลลัพธ์ปะปนแต่โดยรวมแข็งแรง Argon ได้ 88.8% บน LABBench 2 และ 76.0% บน RiemannBench นำหน้าคู่เทียบในตารางของ Google อย่างไรก็ตาม บน Terminal-Bench Science 0.1 GPT-6 Astra ได้ 68.1% เทียบกับ 57.6% ของ Argon
ความต่างนี้ชี้ให้เห็นรูปแบบกว้างขึ้น: Argon ดูจะแข็งแรงในการให้เหตุผลเหนือข้อมูลวิทยาศาสตร์มากกว่าทุกแบบของการดำเนินงานเชิงเครื่องมือด้านวิทยาศาสตร์
Computer-Use Performance
บน Agent's Last Exam Argon ได้อัตราผ่านแบบทวิภาค 39.5% นำ GPT-6 Astra ที่ 34.2% และ Claude Opus 5.5 ที่ 38.2% บนชุดย่อยออฟไลน์ของ OSWorld-2.0 คะแนนบางส่วนอยู่ที่ 69.2% ต่ำกว่า GPT-6 Astra ที่ 72.6% ค่า OSWorld ไม่ใช่อัตราความสำเร็จเต็มงาน และค่าเว้นว่างของ Claude ไม่ได้แปลว่าไม่มีความสามารถ
ดังนั้นข้อมูลปัจจุบันยังไม่ชี้ให้เห็นความได้เปรียบด้านการใช้งานคอมพิวเตอร์แบบครอบคลุม สำหรับโปรดักชัน ควรเสริมคะแนนเกณฑ์วัดด้วยการทดสอบระดับงาน เช่น ความแม่นยำการนำทาง คลิกที่ล้มเหลว ความถี่การลองใหม่ การกระทำที่ไม่ตั้งใจ เวลาเสร็จงาน และอัตราการแก้ไขโดยมนุษย์
Gemini 4 Argon vs GPT-6 Astra and Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Knowledge work | แข็งแกร่งมาก | แข็งแกร่ง | แข็งแกร่งมาก | แข็งแกร่ง |
| Long-context benchmark | แข็งแกร่งที่สุดในผลที่เผย | แข็งแกร่ง | ปานกลาง–แข็งแกร่ง | ปานกลาง |
| Long-horizon coding | แข็งแกร่งมาก | แข็งแกร่งมาก | แข็งแกร่งมาก | แข็งแกร่ง |
| Terminal coding | แข่งขันได้ | แข็งแกร่ง | แข็งแกร่งที่สุดในบางการทดสอบ | แข่งขันได้ |
| Scientific terminal agents | แข่งขันได้ | แข็งแกร่งที่สุดในบางการทดสอบ | แข็งแกร่ง | แข่งขันได้ |
| Multimodal understanding | แข็งแกร่งมาก | แข็งแกร่งมาก | แข็งแกร่ง | แข่งขันได้ |
| Computer use | แข่งขันได้ | แข็งแกร่ง | ผสม/เปรียบเทียบน้อย | เปรียบเทียบน้อย |
| Cybersecurity | เสมอที่หัวตารางบน CWE-bench v1 | เสมอที่หัวตาราง | ใกล้เคียงมาก | ต่ำกว่า |
Argon โดดเด่นในงานบริบทยาว เอกสารหนัก และงานเอเจนต์ระดับมืออาชีพ นักพัฒนาสามารถเปรียบเทียบกับ GPT-6 Astra, Claude Opus 5.5 และ Claude Fable 5.1 ผ่าน CometAPI
Performance-based selection
ป้ายกำกับเชิงคุณภาพข้างต้นสรุปจากตารางเกณฑ์วัดที่เลือก ไม่ใช่การจัดอันดับสากล เลือก Argon สำหรับไพล็อตเมื่อรูปแบบงานคล้ายการประเมินที่เด่นของมัน; ทดสอบ Astra และ Opus บนเวิร์กโหลดที่พึ่งเทอร์มินัลก่อนเลือกเป็นค่าเริ่มต้น
Specifications and deployment constraints
การเปรียบเทียบประสิทธิภาพนี้ไม่ได้ยืนยันข้อได้เปรียบด้านสถาปัตยกรรมหรือผู้ชนะด้านราคา-ประสิทธิภาพโดยรวม จำนวนพารามิเตอร์และสถาปัตยกรรมของ Argon ไม่ได้ระบุในเอกสารเปิดตัวของ Google ที่รีวิว ขีดจำกัดบริบทอินพุตสาธารณะต้องอาศัยเอกสาร API อย่างเป็นทางการ CometAPI รายงานเส้นทาง gemini-4-argon; ยืนยันพารามิเตอร์ที่รองรับและการเข้าถึงบัญชีโดยอิสระจากการทยอยปล่อยของ Google เปรียบเทียบขีดจำกัดของแต่ละเส้นทางและต้นทุนต่อภารกิจจริงก่อนดีพลอย
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI รายงานว่าโมเดลมีให้ใช้ภายใต้ชื่อ gemini-4-argon ใช้แดชบอร์ดเพื่อสร้างคีย์ API เลือกตัวระบุนี้ใน playground และรันคำขอทดสอบก่อนอินทิเกรต ตัวอย่างที่เข้ากันได้กับ OpenAI ใช้ base URL https://api.cometapi.com/v1 ยืนยันเอ็นด์พอยต์และพารามิเตอร์ที่รองรับของโมเดลในเอกสารบัญชี; ป้ายแค็ตตาล็อกเพียงอย่างเดียวไม่ยืนยันการเรียกที่สำเร็จ
- สร้างบัญชี CometAPI และสร้างคีย์ API ในแดชบอร์ด
- เลือก gemini-4-argon และตรวจสอบคำขอที่เป็นตัวแทนใน playground
- คอนฟิกไคลเอนต์ที่เข้ากันได้ด้วย base URL ของ CometAPI คีย์ของคุณ และตัวระบุโมเดล; ยืนยันสคีมาคำขอและการคิดเงินก่อนดีพลอย
CometAPI and official pricing
Google ประกาศราคาแนะนำช่วงแรก $2 ต่อหนึ่งล้านโทเคนอินพุต และ $10 ต่อหนึ่งล้านโทเคนเอาต์พุต โดยอินพุตที่แคชคิดราคาลด 95% จากอัตราอินพุต หลังช่วงแนะนำ ราคาที่ประกาศคือ $4 อินพุต และ $20 เอาต์พุต ต่อหนึ่งล้านโทเคน นี่คือราคาที่ Google ประกาศ ไม่ใช่ราคาหรือการยืนยันการเข้าถึง API ทั่วไปของ CometAPI
| Billing basis | Gemini 4 Argon API in CometAPI | Google official announcement | Comparison |
|---|---|---|---|
| Input / 1M tokens | $3.20 | $4.00 หลังช่วงแนะนำ | ต่ำกว่าราคาหลังช่วงแนะนำที่ประกาศ 20% |
| Output / 1M tokens | $16.00 | $20.00 หลังช่วงแนะนำ | ต่ำกว่าราคาหลังช่วงแนะนำที่ประกาศ 20% |
Conclusion
โปรไฟล์เกณฑ์วัดของ Gemini 4 Argon น่าสนใจกว่าการอ้างลีดเดอร์บอร์ดแบบเรียบง่าย
ผลที่แข็งแกร่งที่สุดในเปรียบเทียบนี้กระจุกอยู่รอบงานความรู้เชิงวิชาชีพ บริบทยาว และการดำเนินงานเอเจนต์อย่างต่อเนื่อง รูปแบบนี้มีประโยชน์ต่อการเลือกเวิร์กโหลด แต่ไม่ได้ชี้กลไกสถาปัตยกรรมหรือพิสูจน์ว่ากลไกใดก่อให้เกิดผลลัพธ์
ผลการเงิน กฎหมาย วิดีโอยาว และวิศวกรรมซอฟต์แวร์ที่รายงาน สนับสนุนไพล็อตแบบโฟกัสสำหรับเวิร์กโหลดเหล่านั้น ว่าความได้เปรียบจะคงอยู่ในโปรดักชันหรือไม่ขึ้นกับส่วนผสมอินพุต เฟรมเวิร์กเอเจนต์ การตั้งค่าอินเฟอเรนซ์ และข้อกำหนดการตรวจสอบ
ขณะเดียวกัน ผลลัพธ์แสดงว่าโมเดลแนวหน้ามีความเฉพาะทางมากขึ้นเรื่อยๆ Argon อาจนำบน DeepSWE แต่ตามบน FrontierSWE; นำบน Agent's Last Exam แต่ตามบน OSWorld; และนำบน LABBench แต่ตามบน Terminal-Bench Science เกณฑ์วัดเหล่านี้กดดันส่วนต่างๆ ของระบบเอเจนต์ไม่เหมือนกัน
สำหรับนักพัฒนา บทเรียนสำคัญคือการเลือกโมเดลควรทำในระดับเวิร์กโหลดมากขึ้น แทนการยึดแบรนด์หรือแฟมิลี
FAQ
นักพัฒนาควรยืนยัน Gemini 4 Argon บนเวิร์กโหลดของตนอย่างไร?
สร้างชุดงานตัวแทนพร้อมเกณฑ์ยอมรับที่ชัดเจน ทำให้เครื่องมือ ขีดเวลาจำกัด การเตรียมอินพุต และนโยบายการลองใหม่ ใกล้เคียงกันข้ามโมเดล บันทึกงานที่สำเร็จ จำนวนโทเคน เวลา และการแก้ไขโดยมนุษย์ เริ่มจากไพล็อตเล็กๆ และตรวจสอบเคสล้มเหลวก่อนส่งทราฟฟิกโปรดักชัน
สามารถถัวเฉลี่ยเปอร์เซ็นต์เกณฑ์วัดของ Gemini 4 Argon ให้เป็นคะแนนเดียวได้หรือไม่?
ไม่ได้ ตารางรวมเมตริกต่างกัน รวมทั้ง F1 อัตราผ่าน และคะแนนบางส่วน ใช้เกณฑ์เฉพาะงานแทนการเฉลี่ยเปอร์เซ็นต์ทั้งหมด
เอเจนต์ Gemini 4 Argon ควรใช้เอาต์พุตสูงสุดเต็มงบประมาณเสมอหรือไม่?
ไม่ ควรเลือกงบประมาณที่เล็กที่สุดที่ผ่านการทดสอบแล้วว่าตอบโจทย์คุณภาพและความเชื่อถือได้ ขีดจำกัดเอาต์พุตสูงสุดเป็นเพดาน ไม่ใช่เป้าหมาย
ทีมควรประเมินการเข้าถึง Gemini 4 Argon ผ่าน CometAPI อย่างไร?
เริ่มจากตรวจสอบการมีให้ใช้ระดับบัญชีและคำขอเล็กๆ ผ่านเส้นทาง CometAPI ที่มีเอกสาร วัดคุณภาพการตอบ เวลาแฝง ขีดจำกัด และโทเคนที่คิดเงิน แล้วใช้เกณฑ์ยอมรับเดียวกับโมเดลทางเลือก อ้างสิทธิ์การเข้าถึงของ CometAPI แยกจากการทยอยปล่อยของ Google และทำให้การเราต์เป็นค่าคอนฟิกได้จนกว่าเส้นทางจะตรงตามข้อกำหนดของคุณ