
TL;DR
เริ่มจาก GPT-6.1 Sol เมื่อคุณใช้งานเครื่องมือ Responses อยู่แล้วหรือจำเป็นต้องใช้บันไดระดับความพยายามในการให้เหตุผลที่กำหนดได้อย่างชัดเจน; ทดสอบ Claude Sonnet 5.5 สำหรับการทำซ้ำโค้ดที่ขอบเขตชัดเจนและงานส่งมอบระดับมืออาชีพที่ขับเคลื่อนด้วยแม่แบบ สิ่งเหล่านี้คือความสำคัญในการประเมิน ไม่ใช่อันดับคุณภาพที่พิสูจน์แล้ว ทั้งสองเริ่มที่ $2/M สำหรับอินพุตและ $10/M สำหรับเอาต์พุต และคิดค่าบริการ $0.10/M สำหรับ base cache reads ด้วยบริบทประมาณ 1M และเอาต์พุตมาตรฐานสูงสุด 128K ความแตกต่างเชิงปฏิบัติอยู่ที่การผสานรวม พฤติกรรมงาน การเก็บ cache และการคิดค่าบริการบริบทยาว มากกว่าส่วนลด base cache-read
ปัจจัยแลกเปลี่ยนหลักคือพฤติกรรมงานและเงื่อนไขการคิดค่าบริการ GPT-6.1 Sol ใช้ระดับความพยายาม 5 ระดับและต้องใช้ Responses สำหรับการเรียกใช้เครื่องมือ; Sonnet 5.5 ใช้การคิดแบบปรับตัว เหนือ 272K โทเค็นอินพุต GPT-6.1 Sol ใช้อัตราที่สูงขึ้นกับคำขอทั้งฉบับ แหล่งข้อมูลที่ตรวจทานที่นี่ไม่ได้ยืนยันผู้ชนะ benchmark ที่จับคู่รุ่นเดียวกันอย่างแน่ชัด ดังนั้นให้เลือกโมเดลที่ตรงตามเกณฑ์การยอมรับของคุณด้วยต้นทุนเวิร์กโฟลว์รวมต่ำสุด
Key Takeaways
- ช่วงราคาพื้นฐานเท่ากัน: ทั้งสองโมเดลคิด $2/M อินพุต, $10/M เอาต์พุต และ $0.10/M cache reads เปรียบเทียบ cache writes, ระยะเวลาเก็บ, ชั้นบริบทยาว และการใช้งานที่ถูกเรียกเก็บจริง
- บริบทใกล้เคียง: 1.05M เทียบกับ 1M โทเค็น; ทั้งสองรองรับเอาต์พุตมาตรฐานสูงสุด 128K
- การผสานรวมต่างกัน: GPT-6.1 Sol ต้องใช้ Responses สำหรับการเรียกเครื่องมือและไม่ยอมรับ none หรือ minimal effort; Sonnet 5.5 ใช้ adaptive thinking และมีข้อจำกัดเครื่องมือเฉพาะโมเดล
- เก็บหลักฐานให้ระบุรุ่น: คะแนนของ GPT-6 Sol ไม่สามารถ relabel เป็นผลลัพธ์ของ GPT-6.1 Sol
- เลือกจากงานที่เสร็จสมบูรณ์: วัดคุณภาพ ระยะเวลา รีทราย การเขียนและอ่าน cache ค่าธรรมเนียมเครื่องมือ และการแก้ไขโดยมนุษย์
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
| ปัจจัยตัดสินใจ / สเปค | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| ผู้ให้บริการ | OpenAI | Anthropic |
| วันที่เปิดตัว | 29 กันยายน 2026 | 28 กันยายน 2026 |
| Model ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Context / standard maximum output | 1,050,000 / 128,000 โทเค็น | 1,000,000 / 128,000 โทเค็น |
| อินพุต → เอาต์พุต | ข้อความและรูปภาพ → ข้อความ | ข้อความและรูปภาพ → ข้อความ |
| การควบคุม reasoning | low, medium, high, xhigh, max; ค่าเริ่มต้นคือ medium | Adaptive thinking; ค่าเริ่มต้น high บน Claude Platform |
| ค่า effort เริ่มต้น | medium | high บน Claude Platform |
| ขอบเขตความรู้ | 30 เมษายน 2026 | มิถุนายน 2026 |
| อัตราราคาพื้นฐานอินพุต/เอาต์พุตต่อ 1M | $2 / $10; คำขอมาตรฐานที่มีอินพุตสูงสุด 272K โทเค็น | $2 / $10 |
| อัตราราคา base cache reads ต่อ 1M | $0.10 | $0.10 |
| อัตราราคา base cache writes ต่อ 1M | $2.50 | $2.50 สำหรับ 5 นาที; $4.00 สำหรับ 1 ชั่วโมง |
| การคิดค่าบริการบริบทยาว | เหนือ 272K อินพุต: $4 อินพุต, $0.20 cache read, $5 cache write, $15 เอาต์พุต ต่อ 1M; ใช้กับคำขอมาตรฐานทั้งฉบับ | ไม่มีการระบุการคิดค่าบริการแบบเดียวกันในภาพรวมโมเดลที่อ้างถึง |
| การวางตำแหน่งหลัก | การเขียนโค้ดซับซ้อน การใช้งานคอมพิวเตอร์ และงานระดับมืออาชีพ | การทำซ้ำโค้ดอย่างรวดเร็วและเวิร์กโฟลว์ระดับมืออาชีพ |
| ทดสอบก่อนเมื่อ | คุณใช้งานเครื่องมือ Responses อยู่แล้วหรือจำเป็นต้องใช้ตัวควบคุม effort ชัดเจน | งานของคุณเน้นโค้ด เอกสาร สไลด์ หรือสเปรดชีต |
| ข้อจำกัดหลักฐานและการตัดสินใจ | ความสามารถที่มีการบันทึก; ไม่ได้ยืนยันผู้ชนะเชิงตัวเลขที่ตรงรุ่นอย่างแน่ชัดที่นี่ | ผลลัพธ์การเขียนโค้ดและงานความรู้ที่เผยแพร่; ไม่ใช่ชัยชนะที่ควบคุมเหนือ GPT-6.1 Sol |
GPT-6.1 Sol Overview
GPT-6.1 Sol คือรุ่น Sol ของ OpenAI วันที่ 29 กันยายน 2026 สำหรับการเขียนโค้ดซับซ้อน การใช้งานคอมพิวเตอร์ และงานระดับมืออาชีพ OpenAI อธิบายว่าเป็น ประสิทธิภาพใกล้ Astra ที่มีต้นทุนต่ำกว่า; การวางตำแหน่งนี้ควรถูกยืนยันกับงานของคุณ บริบทขนาดใหญ่และการปรับ reasoning ได้ ทำให้เป็นตัวเลือกสำหรับเอเจนต์ระดับ repository และเวิร์กโฟลว์ระดับมืออาชีพหลายขั้นตอน
ข้อจำกัดการปฏิบัติการสำคัญพอๆ กับการวางตำแหน่ง: medium เป็นค่า effort เริ่มต้น, low คือต่ำสุดที่รองรับ, และการเรียกใช้เครื่องมือจำเป็นต้องใช้ Responses เวิร์กโฟลว์ที่สร้างบนเส้นทางแบบไม่ใช้ reasoning หรือเครื่องมือของ Chat Completions ต้องมีการย้ายก่อนจะใช้โมเดลนี้ได้อย่างน่าเชื่อถือ
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5 คือรุ่นของ Anthropic วันที่ 28 กันยายน 2026 สำหรับการเขียนโค้ดประจำที่ขอบเขตชัดเจน เอเจนต์ และงานระดับมืออาชีพ ภาพรวมโมเดล ระบุการคิดแบบปรับตัว ค่า effort เริ่มต้นสูงบน Claude Platform อินพุตข้อความและรูปภาพ และเอาต์พุตมาตรฐานสูงสุด 128K Anthropic เน้นการแก้บัก เอกสารชัดเจน สไลด์ที่ขัดเกลา และการทำซ้ำที่มีประสิทธิภาพ
สำหรับทีมพัฒนา สิ่งนี้ทำให้ Sonnet เป็นตัวเลือกที่มีประโยชน์สำหรับการนำไปใช้และรอบการทบทวนที่ทำซ้ำได้ สำหรับเวิร์กโฟลว์สำนักงาน ประเมินคุณภาพฉบับร่างแรกและการยึดตามแม่แบบ การอ้างความเร็วของผู้ให้บริการเปรียบเทียบ Sonnet 5.5 กับ Sonnet 5; ไม่ได้ยืนยันความได้เปรียบด้านความเร็วเหนือ GPT-6.1 Sol
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
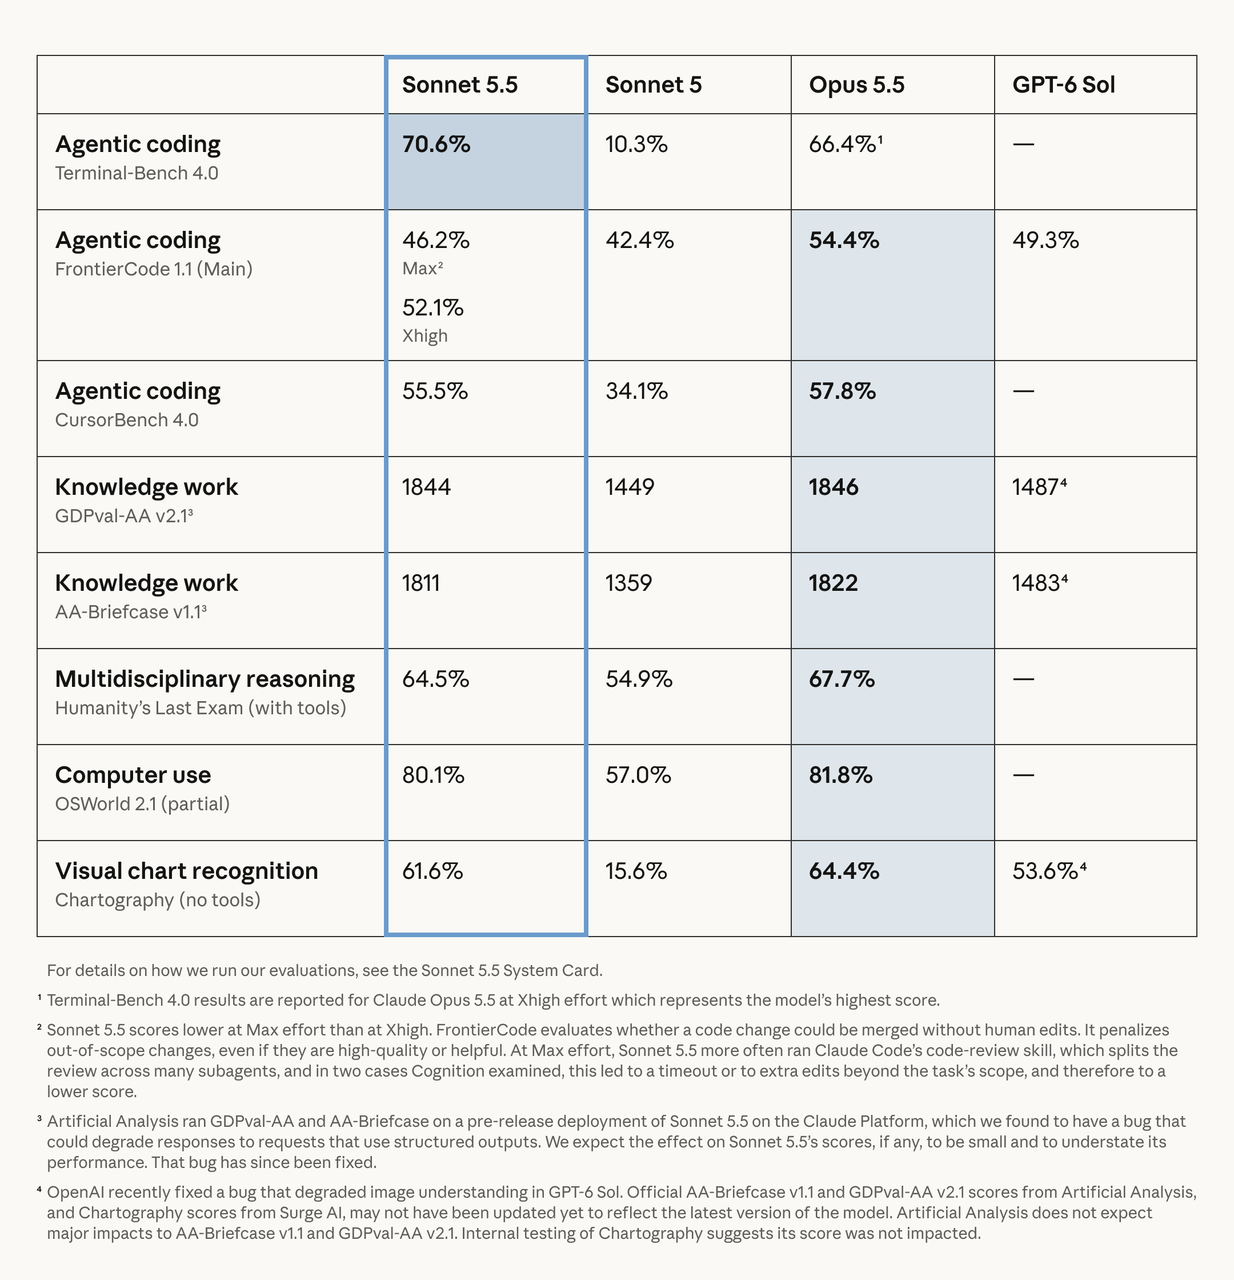
ผลการเปิดตัว Sonnet 5.5 ของ Anthropic ให้สัญญาณที่เป็นประโยชน์เกี่ยวกับภาระงาน ตารางเปรียบเทียบรวม GPT-6 Sol รุ่นเก่า ดังนั้นค่าของฝั่ง OpenAI จึงถูกตัดออกจากตารางรุ่นปัจจุบันด้านล่าง “ยังไม่ได้ยืนยันที่นี่” หมายถึงแหล่งอ้างอิงไม่สนับสนุนคะแนนที่ตรงรุ่นอย่างแน่ชัดสำหรับการเปรียบเทียบนี้; ไม่ได้หมายถึงประสิทธิภาพเป็นศูนย์
| Benchmark / เงื่อนไข | GPT-6.1 Sol | Claude Sonnet 5.5 | วัดอะไร |
|---|---|---|---|
| Terminal-Bench 4.0 | ยังไม่ได้ยืนยันที่นี่ | 70.6% | งานเขียนโค้ดบนเทอร์มินัล |
| FrontierCode 1.1 Main | ยังไม่ได้ยืนยันที่นี่ | 52.1% Xhigh; 46.2% Max | การเปลี่ยนแปลงโค้ดที่ merge ได้ |
| CursorBench 4.0 | ยังไม่ได้ยืนยันที่นี่ | 55.5% | งานพัฒนาแบบเอเจนต์ใน Cursor |
| GDPval-AA v2.1 | ยังไม่ได้ยืนยันที่นี่ | 1844 | งานความรู้ระดับมืออาชีพ |
| AA-Briefcase v1.1 | ยังไม่ได้ยืนยันที่นี่ | 1811 | งานความรู้ระยะยาว |
| Humanity’s Last Exam, tools | ยังไม่ได้ยืนยันที่นี่ | 64.5% | การให้เหตุผลสหสาขาวิชา |
| OSWorld 2.1, partial | ยังไม่ได้ยืนยันที่นี่ | 80.1% | รางวัลบางส่วนด้านการใช้งานคอมพิวเตอร์ |
| Chartography, no tools | ยังไม่ได้ยืนยันที่นี่ | 61.6% | การรู้จำแผนภูมิจากภาพ |
เงื่อนไขการทดสอบ: ระดับ effort และ harness ของเอเจนต์มีผลต่อผลลัพธ์การเขียนโค้ด GDPval-AA และ AA-Briefcase เป็นการประเมินโดย Artificial Analysis ส่วนผล Chartography มาจาก Surge AI Anthropic ระบุบั๊กโครงสร้างผลลัพธ์ที่ได้รับการแก้ไขภายหลังใน Sonnet รุ่นก่อนเผยแพร่ ซึ่งอาจทำให้ผลงานระดับมืออาชีพต่ำกว่าความเป็นจริงเล็กน้อย ใช้ System Card ในประกาศสำหรับสภาพแวดล้อมการทดสอบและระเบียบวิธีเต็มรูปแบบ; อย่ารวม metrics ต่างชนิดให้เป็นอันดับรวมเดียว
ภาพต้นฉบับของ Anthropic ด้านล่างมีเชิงอรรถการประเมิน คอลัมน์ GPT-6 Sol เป็นบริบทเชิงประวัติเท่านั้น และไม่ได้รายงานประสิทธิภาพของ GPT-6.1 Sol
Agentic Coding and Software Engineering
Sonnet 5.5 มีหลักฐานรายงานเกี่ยวกับงานเขียนโค้ดบนเทอร์มินัล การเปลี่ยนแปลงโค้ดที่ merge ได้ และงานแบบเอเจนต์ในสไตล์ IDE GPT-6.1 Sol ถูกบันทึกไว้สำหรับงานเขียนโค้ดซับซ้อนและผสานกับระบบเครื่องมือของ OpenAI ทั้งการวางตำแหน่งผลิตภัณฑ์หรือคะแนนของรุ่นก่อนหน้าไม่ได้ยืนยันผู้ชนะงานเขียนโค้ดในรุ่นปัจจุบัน สำหรับการประเมินที่มีประโยชน์ ให้เลือกการเปลี่ยนแปลงจริงพร้อมการทดสอบ regression และให้ผู้รีวิวประเมินขอบเขต ความสามารถในการดูแลรักษา และความพร้อมสำหรับการ merge
Knowledge Work, Reasoning, Math, and Science
ผลลัพธ์ GDPval-AA และ AA-Briefcase ของ Sonnet ทำให้งานรายงาน การวิเคราะห์ และงานส่งมอบในสำนักงานเป็นเป้าหมายการประเมินที่สมเหตุสมผล GPT-6.1 Sol ก็เล็งเป้าที่งานระดับมืออาชีพเช่นกัน แต่แหล่งข้อมูลที่ใช้ที่นี่ไม่ได้ให้การเปรียบเทียบที่จับคู่ข้ามโมเดลเหล่านี้ ใช้แม่แบบเอกสาร สเปรดชีต และสไลด์ของคุณเอง คำกล่าวอ้างด้านคณิตขั้นสูงและวิทยาศาสตร์ต้องการหลักฐานเฉพาะงาน แทนการคาดการณ์จากตัวควบคุม reasoning ทั่วไป
Computer Use, Browser Automation, and Multimodal Workflows
ทั้งสองโมเดลรับรูปภาพ ซึ่งสนับสนุนการดีบักภาพหน้าจอและการวิเคราะห์เชิงภาพ ผล OSWorld และ Chartography ของ Sonnet เป็นหลักฐานสำหรับการประเมินเหล่านั้น GPT-6.1 Sol บันทึกการใช้งานคอมพิวเตอร์ผ่านเครื่องมือ Responses ทดสอบเวิร์กโฟลว์เต็มรูปแบบ: ความแม่นยำในการนำทาง การฟื้นตัวหลังการเรียกเครื่องมือที่ล้มเหลว ความถูกต้องของเอาต์พุต และเวลาสิ้นสุดงาน อินพุตข้อความและรูปภาพเพียงอย่างเดียวไม่ได้รับประกันการผสานรวมการใช้งานคอมพิวเตอร์ที่เหมือนกัน
Independent Evaluation and Evidence Quality
ตารางที่เผยแพร่โดยผู้ให้บริการอาจมีผลของบุคคลที่สามโดยไม่กลายเป็นการทดลองควบคุมเดียว สำหรับการเปรียบเทียบอย่างอิสระ บันทึก Model ID ที่แน่นอน วันที่ดีพลอยเมนต์ effort เครื่องมือ มาตรการป้องกัน เวลาออก การตั้งค่ารีทราย และกฎการหยุด ดัชนีสติปัญญารวม อัตราความสำเร็จในการเขียนโค้ด และคะแนนรางวัลบางส่วนด้านการใช้งานคอมพิวเตอร์ ตอบคำถามต่างกัน แหล่งที่อ้างถึงไม่ยืนยันชุดผลลัพธ์อิสระที่สมบูรณ์สำหรับคู่เปรียบเทียบนี้
GPT-6.1 Sol vs Claude Sonnet 5.5: Cost
Official API Pricing
| ตัวชี้วัดราคา | อัตราอย่างเป็นทางการของ GPT-6.1 Sol | อัตราอย่างเป็นทางการของ Claude Sonnet 5.5 |
|---|---|---|
| อินพุต / 1M โทเค็น, Base Standard | $2.00 | $2.00 |
| เอาต์พุต / 1M โทเค็น, Base Standard | $10.00 | $10.00 |
| Cache read / 1M โทเค็น, Base | $0.10 | $0.10 |
| Cache write / 1M โทเค็น, Base | $2.50 | $2.50 สำหรับ 5m; $4.00 สำหรับ 1h |
| การประมวลผลแบบ Batch | ต่ำกว่า Standard 50% | ส่วนลดอินพุต/เอาต์พุต 50% |
| อินพุตเกิน 272K, คำขอ Standard ทั้งฉบับ | $4 อินพุต / $0.20 cache read / $5 cache write / $15 เอาต์พุต | ไม่มีการระบุค่าบริการเสริมแบบเดียวกันในภาพรวมที่อ้างถึง |
อัตราทั้งหมดเป็น USD ต่อหนึ่งล้านโทเค็น Base cache reads ของ GPT-6.1 Sol มีค่า $0.10/M และ cache reads ของ Sonnet 5.5 ก็ $0.10/M เงื่อนไขอินพุตเกิน 272K ของ Sol ทำให้อัตราเพิ่มขึ้นสำหรับคำขอมาตรฐานทั้งฉบับ ไม่ใช่เฉพาะโทเค็นส่วนเกิน เปรียบเทียบ cache writes ระยะเวลาเก็บ ชั้นบริบทยาว การประมวลผลตามภูมิภาค และชั้นบริการ; ราคาฐานของการอ่านเพียงอย่างเดียวไม่ได้ให้ข้อได้เปรียบกับโมเดลใด
Cost per Completed Task
ต้นทุนต่อผลลัพธ์ที่ยอมรับได้ = ต้นทุนรวมของทุกงานที่พยายาม / จำนวนผลลัพธ์ที่ยอมรับ ต้นทุนรวมรวมอินพุตใหม่ที่เรียกเก็บ การอ่านและเขียน cache เอาต์พุต (รวมโทเค็น reasoning ที่มีการเรียกเก็บเมื่อใช้) เครื่องมือที่เสียค่าใช้จ่าย และการทบทวน/แก้ไขโดยมนุษย์ ต้นทุนรีทรายนับตามการใช้งานจริง ไม่บวกซ้ำเป็นค่าใช้จ่ายที่ซ้ำกัน
สำหรับหนึ่งล้านโทเค็นที่อ่านจาก cache ที่ถูกเรียกเก็บทั้งหมดในอัตราฐาน โมเดลใดๆ ก็มีค่า $0.10; ความแตกต่างของราคา base read คือ $0.00 นี่คือภาพประกอบของอัตรา ไม่ใช่คำขอ Sol หนึ่งล้านโทเค็นอินพุตที่คิดราคาในชั้นฐาน ต้นทุนเซสชันจริงยังรวมอินพุตใหม่ การเขียน cache เอาต์พุต เครื่องมือ และรีทราย เปรียบเทียบเซสชันแบบ cold และ warm ภายใต้ชั้นบริบทที่ใช้ และรายงานอัตราผลลัพธ์ที่ยอมรับพร้อมกับการใช้งานที่ถูกเรียกเก็บ
CometAPI Pricing
| ชั้นราคา CometAPI ที่เผยแพร่ | GPT-6.1 Sol API ใน CometAPI | Claude Sonnet 5.5 API ใน CometAPI |
|---|---|---|
| อินพุต/เอาต์พุตฐานต่อ 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| ส่วนลดฐานเมื่อเทียบผู้ให้บริการ | 20% | 20% |
| อินพุต/เอาต์พุตบริบทยาวของ GPT | $3.20 / $12.00 | ตรวจสอบเงื่อนไขตามเส้นทางปัจจุบัน |
| GPT cache reads, base / long | $0.08 / $0.16 | ไม่ได้ระบุในตารางราคาพื้นฐานที่อ้างถึง |
นี่คือราคาตามเส้นทางโมเดลที่เผยแพร่สำหรับการแก้ไขนี้ แยกจากอัตราผู้ให้บริการ ราคาของ GPT-6.1 Sol บน CometAPI แยกบริบทสั้นและยาว ตารางพื้นฐานของ Sonnet ที่อ้างถึงระบุอินพุตและเอาต์พุต ดังนั้นจึงไม่สามารถสรุปนโยบาย cache ของเกตเวย์ที่เหมือนกันได้ ตรวจสอบเงื่อนไขการคิดค่าบริการของเส้นทางที่เลือกในปัจจุบันก่อนประมาณการเซสชันการผลิต
How Do Context Windows, Speed, and Technical Specs Compare?
GPT-6.1 Sol รองรับ 1.05M โทเค็น ขณะที่ Claude Sonnet 5.5 รองรับ 1M โทเค็น ความแตกต่างเชิงชื่อเพียงประมาณ 5% ดังนั้นความจุบริบทเพียงอย่างเดียวไม่น่าตัดสินการใช้งานส่วนใหญ่
บันได effort ของ GPT-6.1 Sol มี low, medium, high, xhigh และ max; medium เป็นค่าเริ่มต้น Sonnet 5.5 ใช้ adaptive thinking โดยมีค่าเริ่มต้นเป็น high บน Claude Platform ชื่อเหล่านี้ไม่ได้หมายถึงงบประมาณ reasoning ที่เท่ากัน ที่ข้อกำหนดคุณภาพเท่ากัน วัดเวลาเริ่มโทเค็นแรก อัตราส่งออก เครื่องมือ-ลูป latency และเวลาสิ้นสุดงานแยกกัน
Anthropic รายงานว่าการผลิตเอาต์พุตเร็วขึ้นมากกว่า 30% สำหรับ Sonnet 5.5 เมื่อเทียบกับ Sonnet 5 ให้ถือว่าเป็นการเปรียบเทียบกับรุ่นก่อน หลักฐานในบทความนี้ไม่ได้ยืนยันหมายเลข latency สากลสำหรับ GPT-6.1 Sol หรือผู้ชนะความเร็วโดยตรงระหว่างโมเดลปัจจุบัน สำหรับเวิร์กโหลดเชิงโต้ตอบ ทดสอบค่า effort ต่ำลงภายใต้เกณฑ์ยอมรับเดียวกัน แทนการสมมุติว่า max เป็นการตั้งค่าที่ดีที่สุด
What Matters for Safety, Alignment, and Deployment?
การตัดสินใจใช้งานควรแยกพฤติกรรมโมเดลที่บันทึกได้ออกจากการควบคุมของแอปพลิเคชัน การเปรียบเทียบโมเดลเพียงอย่างเดียวไม่สามารถยืนยันว่าโซลูชันใดตรงตามข้อกำหนดการจัดการข้อมูลหรือการเข้าถึงขององค์กรของคุณ ประเมินผู้ให้บริการหรือเกตเวย์ที่คุณใช้งานจริง รวมถึงการบันทึกคำขอ ที่ตั้งข้อมูล สิทธิ์เครื่องมือ และการจัดการความล้มเหลว
- Reasoning migration: GPT-6.1 Sol ไม่รองรับ none หรือ minimal คำแนะนำการย้ายของ OpenAI ที่ อัปเดตล่าสุด ชี้ให้เวิร์กโฟลว์การเรียกเครื่องมือไปที่ Responses
- พฤติกรรมเครื่องมือของ Claude: การเปลี่ยนแปลงความเข้ากันได้ของ Sonnet 5.5 รวมโหมดบังคับใช้เครื่องมือที่ไม่รองรับและบล็อกการคิดที่ผูกกับการสนทนา ทดสอบเส้นทางเหล่านี้ก่อน rollout
- การควบคุมปฏิบัติการ: ให้เอเจนต์มีเครื่องมือเท่าที่จำเป็นสำหรับงาน บันทึกการเรียกที่ล้มเหลว และคงการทบทวนโดยมนุษย์สำหรับการกระทำภายนอกที่มีนัยสำคัญ สิ่งเหล่านี้เป็นทางเลือกในการออกแบบแอป ไม่ใช่ข้อได้เปรียบเชิงวัดของโมเดลใด
GPT-6.1 Sol vs Claude Sonnet 5.5: Which Should You Choose?
ทดสอบ GPT-6.1 Sol ก่อนเมื่อคุณใช้งานเครื่องมือ Responses อยู่แล้วหรือจำเป็นต้องใช้บันได effort ที่คาดการณ์ได้ ทดสอบ Sonnet 5.5 สำหรับการทำซ้ำโค้ดที่ขอบเขตชัดเจน สไลด์ สเปรดชีต และเวิร์กโฟลว์เอกสารที่หลักฐานรายงานสอดคล้องกับงานของคุณ สำหรับเซสชันที่พึ่งพา cache ให้ทดสอบทั้งสอง: อัตรา base cache-read เท่ากัน ขณะที่ต้นทุนการเขียน ระยะเวลาเก็บ ชั้นบริบทยาว และความสำเร็จของงาน อาจเปลี่ยนบิลรวม จัดสรรงานหลังการประเมินตัวแทนที่ยืนยันความแตกต่างที่มีประโยชน์ด้านคุณภาพ ต้นทุน หรือ latency
Workload-Based Selection
| เวิร์กโหลด | จุดเริ่มต้น | สิ่งที่ต้องตรวจสอบ |
|---|---|---|
| เอเจนต์ OpenAI Responses ที่มีอยู่ | GPT-6.1 Sol | ความเข้ากันได้ของเครื่องมือและการเปลี่ยนแปลง effort |
| การทำซ้ำโค้ด / การแก้บัก | Sonnet 5.5 แล้วเปรียบเทียบกับ Sol | ความพร้อมสำหรับ merge, latency และรีทราย |
| สไลด์ / สเปรดชีต / รายงาน | Sonnet 5.5 แล้วเปรียบเทียบกับ Sol | การยึดตามแม่แบบและเวลาการแก้ไขของมนุษย์ |
| เซสชันที่มีคำนำร่วมแบบ cache เสถียร | ทั้งสอง; อัตรา base cache-read เท่ากัน | อัตราการถูก cache, การเขียน, ชั้นบริบท และคุณภาพที่ยอมรับ |
| คำขอเต็มเกิน 272K อินพุต | ทั้งสอง | บิลบริบทยาวจริงและคุณภาพการดึงคืนข้อมูล |
| การใช้งานคอมพิวเตอร์/เบราว์เซอร์ | ทั้งสอง | การฟื้นตัว ความสำเร็จของงาน และสิทธิ์ |
| คณิต/การวิเคราะห์วิทยาศาสตร์ | ทั้งสองบนการทดสอบเฉพาะงาน | ความถูกต้องพร้อมคำตอบที่ตรวจสอบได้ |
| การผลิตที่อ่อนไหวต่อค่าใช้จ่าย | ทั้งสอง | ต้นทุนรวมต่อผลลัพธ์ที่ยอมรับได้ |
การเปรียบเทียบในการผลิตควรรักษาระบบรอบข้างให้คงที่ ใช้พรอมป์ต์เดียวกัน Repository หรือเอกสารเดียวกัน สิทธิ์เครื่องมือเดียวกัน timeout นโยบายรีทราย และเกณฑ์การยอมรับเอาต์พุตเดียวกัน
บันทึกอินพุตใหม่ การเขียนและอ่าน cache การใช้งานเอาต์พุต การเรียกเครื่องมือที่เสียค่าใช้จ่าย รีทราย เวลารีวิวโดยมนุษย์ ความสำเร็จของงาน และ latency ตั้งแต่ต้นจนจบ การตอบครั้งแรกที่ถูกลงอาจยังนำไปสู่ผลลัพธ์ที่ยอมรับได้ซึ่งมีค่าใช้จ่ายสูงกว่า
How Can You Access GPT-6.1 Sol and Claude Sonnet 5.5?
นักพัฒนาสามารถเข้าถึง GPT-6.1 Sol API ใน CometAPI และ Claude Sonnet 5.5 API ใน CometAPI ผ่านเส้นทางโมเดลที่มีเอกสาร กุญแจ API ควรถูกสร้างและเก็บอย่างปลอดภัย และตรวจสอบการเข้าถึงโมเดลและเงื่อนไขการคิดค่าบริการตามเส้นทางก่อนใช้จริง
GPT-6.1 Sol Access
สำหรับ Sol ใช้เส้นทาง Responses ที่มีเอกสารเมื่อจำเป็นต้องเรียกเครื่องมือ เลือก gpt-6.1-sol และระดับ effort ที่รองรับ โดยค่าเริ่มต้นคือ medium ส่งงานอินพุต กำหนดค่าเฉพาะเครื่องมือที่จำเป็น และตรวจสอบข้อความที่ส่งกลับ การเรียกเครื่องมือ ข้อผิดพลาด และการใช้งาน ยืนยันการรองรับของเกตเวย์สำหรับคุณสมบัติเฉพาะผู้ให้บริการ แทนที่จะสมมุติว่าทุกตัวเลือกของ OpenAI ใช้ได้
Claude Sonnet 5.5 Access
สำหรับ Sonnet เลือก claude-sonnet-5-5 บนอินเทอร์เฟซที่เข้ากันได้ซึ่งมีเอกสาร และส่งงานเป็นข้อความการสนทนาพร้อมงบประมาณเอาต์พุตที่เหมาะสม ยืนยันว่าเส้นทางนั้นจัดการการคิดแบบ native และพารามิเตอร์เครื่องมืออย่างไร; ฟิลด์ reasoning ของ OpenAI ไม่สามารถใช้แทนตัวเลือกของ Claude ได้โดยอัตโนมัติ ตรวจสอบความต่อเนื่องของการสนทนาและการจัดการข้อผิดพลาดก่อนการใช้งานเอเจนต์
การตรวจสอบ endpoint ยืนยันความเชื่อมต่อ ไม่ใช่ประสิทธิภาพเปรียบเทียบ สำหรับการประเมิน ให้ปรับพรอมป์ต์ งบประมาณเอาต์พุตและ reasoning ที่มีผล เครื่องมือ รีทราย timeout และเกณฑ์การยอมรับให้สอดคล้องกัน แล้วเปรียบเทียบงานที่ยอมรับ ระยะเวลา และต้นทุนที่ถูกเรียกเก็บรวม
Conclusion
GPT-6.1 Sol และ Claude Sonnet 5.5 มีอัตราราคาอินพุต เอาต์พุต และ cache-read พื้นฐานเท่ากัน พร้อมความจุบริบทที่ใกล้เคียงกัน Sol เป็นตัวเลือกธรรมชาติสำหรับเอเจนต์ Responses ที่มีอยู่และการควบคุม effort ที่ชัดเจน การคิดแบบปรับตัวของ Sonnet และผลลัพธ์ที่รายงานในงานเขียนโค้ดและงานระดับมืออาชีพ ทำให้เป็นตัวเลือกที่มีประโยชน์สำหรับงานส่งมอบประจำ เซสชันที่พึ่งพา cache ต้องการการเปรียบเทียบเต็มเซสชัน: อัตรา base read เท่ากันไม่ได้รับประกันต้นทุนการเขียน ระยะเวลาเก็บ บริบทยาว หรือค่าใช้จ่ายต่อผลสำเร็จที่เท่ากัน
เลือกโมเดลที่ทำงานจริงของคุณเสร็จภายในข้อกำหนดคุณภาพ ระยะเวลา และต้นทุน รักษาคะแนนของรุ่นก่อนหน้าให้แยกจากหลักฐานของรุ่นปัจจุบัน ตั้งราคาในชั้นบริบทที่เวิร์กโหลดของคุณใช้ และเปรียบเทียบเส้นทางทั้งสองก่อนรับไปใช้เป็นค่าเริ่มต้น
FAQ
Can GPT-6.1 Sol and Sonnet 5.5 share one tool schema?
JSON tool definition เดียวกันอาจเป็นจุดเริ่มต้น แต่การรองรับ endpoint โหมดบังคับใช้เครื่องมือ บล็อกการคิด และการจัดการการตอบกลับแตกต่างกัน ตรวจสอบการเรียกเครื่องมือของแต่ละโมเดลด้วยการทดสอบสัญญาสำหรับอาร์กิวเมนต์ เส้นทางความล้มเหลว และความต่อเนื่องของการสนทนา เก็บอแดปเตอร์เฉพาะโมเดลสำหรับตัวเลือกที่ไม่รองรับ แทนการสมมุติว่าคำขอข้อความที่สำเร็จพิสูจน์ความเข้ากันได้ของเอเจนต์
How should reasoning effort be matched across both models?
อย่าถือว่าการตั้งค่าที่มีชื่อเหมือนกันหมายถึงงบประมาณคอมพิวต์เท่ากัน กำหนดเกณฑ์การยอมรับและอย่างใดอย่างหนึ่งคือขีดจำกัดต้นทุนหรือเป้าหมาย latency แล้วกวาดค่า effort สำหรับแต่ละโมเดล เปรียบเทียบการตั้งค่าที่ดีที่สุดที่ตรงข้อจำกัดการปฏิบัติการเดียวกัน รวมถึงรีทรายและการแก้ไขโดยมนุษย์ แทนการเปรียบเทียบเฉพาะการตั้งค่าสูงสุดของทั้งสองโมเดล
When should a 1M-context workflow use retrieval instead?
ใช้ retrieval เมื่อภารกิจต้องการส่วนเล็กที่ระบุได้จากคลังข้อมูลขนาดใหญ่ และการทดสอบ retrieval ของคุณแสดงว่าข้อมูลที่เกี่ยวข้องถูกดึงมาอย่างสม่ำเสมอ ทดสอบคำขอเต็มบริบทเมื่อหลักฐานกระจายหรือความสัมพันธ์ข้ามไฟล์มีความสำคัญ เปรียบเทียบความถูกต้องของคำตอบ ความครอบคลุมของ citation ต้นทุนอินพุต และ latency; ขีดจำกัดบริบทใหญ่เพียงอย่างเดียวไม่ยืนยันว่าการเติมหน้าต่างทั้งหมดจะคุ้มค่าหรือเชื่อถือได้
How can teams avoid a misleading cache-cost comparison?
วัดการรันแบบ cold-cache และ warm-cache แยกกัน บันทึกการเขียน cache เช่นเดียวกับการอ่าน และใช้หน้าต่างการเก็บและชั้นบริบทยาวที่ถูกต้อง รักษาคำนำร่วมให้คงที่และเปรียบเทียบเซสชันจริงที่ทำซ้ำได้ ไม่ใช่คำขอเดียวที่ได้รับส่วนลด รายงานอัตราการถูก cache และการใช้งานที่ถูกเรียกเก็บรวม เพื่อให้การประหยัดที่เห็นสามารถทำซ้ำได้
What should trigger a new GPT-6.1 Sol vs Sonnet 5.5 evaluation?
รันชุดงานที่ได้รับผลกระทบใหม่หลังจากการอัปเดตดีพลอยเมนต์ การแก้บั๊กของผู้ให้บริการ การเปลี่ยนเส้นทาง เครื่องมือหรือพรอมป์ต์เปลี่ยน หรือการแก้ไขราคาอย่างมีนัยสำคัญ บันทึกวันที่ประเมิน Model ID เอ็นด์พอยต์ effort และเวอร์ชัน harness เก็บผลการรันก่อนหน้าเป็นฐาน เพื่อไม่ให้การเปลี่ยนคุณภาพหรือ latency สับสนกับการเปลี่ยนในระบบรอบข้าง