สร้างด้วย CometAPIต้องการ API เดียวสำหรับหลายโมเดลใช่ไหมทดสอบเวิร์กโฟลว์ใน Playground แล้วสร้างคีย์ API เมื่อโมเดลและค่าใช้จ่ายเหมาะกับกรณีการใช้งานของคุณ
GPT-6.1 Sol เทียบกับ GPT-6 Sol: ผลทดสอบประสิทธิภาพ, ราคา และการอัปเกรด
เปรียบเทียบ GPT-6.1 Sol กับ GPT-6 Sol ในด้านการเขียนโค้ด เอเจนต์ และการกำหนดราคา API ทบทวนผลการทดสอบมาตรฐานและการเปลี่ยนแปลงในการย้ายระบบก่อนตัดสินใจว่าจะอัปเกรดหรือไม่
ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
การย้ายใช้งานต้องตรวจสอบทั้งระดับความพยายามเชิงเหตุผลและความเข้ากันได้ของเอ็นด์พอยต์ API: GPT-6.1 Sol ไม่ตัดออกเครื่องมือใด และต้องใช้ Responses API สำหรับการเรียกเครื่องมือ
ตรวจสอบความสำเร็จของงาน ระยะเวลาแฝง อัตราการโดนแคชจริง และต้นทุนปลายทางก่อนแทนที่การใช้งาน GPT-6 Sol ที่เสถียร
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI เปิดตัว GPT-6 Sol เมื่อวันที่ 22 กันยายน 2026 หนึ่งสัปดาห์ต่อมา ภาคผนวก system-card วันที่ 29 กันยายนประกาศ GPT-6.1 Sol OpenAI นำเสนอรุ่นใหม่นี้ในฐานะ การอัปเกรดของ GPT-6 Sol มากกว่าการเป็นชั้นราคาที่แยกต่างหาก
ช่วงเวลาปล่อยสั้นมีความสำคัญ เพราะ GPT-6.1 Sol ไม่ได้ถูกวางตำแหน่งเป็นสินค้าชั้นใหม่ OpenAI คงชั้นราคา Sol และมุ่งเน้นการอัปเดตที่งานยาก ประสิทธิภาพต้นทุน และความน่าเชื่อถือของเอเจนต์
OpenAI วางตำแหน่ง GPT-6.1 Sol รอบงานเอเจนต์ด้านโค้ดดิ้ง การใช้คอมพิวเตอร์ และงานมืออาชีพ การเปรียบเทียบสำคัญคือความสำเร็จของงานภายใต้ต้นทุนที่กำหนด มากกว่าชื่อโมเดลเพียงอย่างเดียว สรุปเบนช์มาร์กทางการด้านล่างแยกความสามารถที่เพิ่มขึ้นออกจากข้อกำหนด API ที่ไม่เปลี่ยนแปลง
ทำให้การเปรียบเทียบตรงไปตรงมาเป็นพิเศษ: GPT-6.1 Sol เป็นการอัปเกรดด้านความสามารถและประสิทธิภาพ มากกว่าการอัปเกรดหน้าต่างบริบทหรือราคาพื้นฐาน
ผลลัพธ์ทางการในตารางเบนช์มาร์กเปรียบเทียบ GPT-6.1 Sol ที่ความพยายามต่ำกว่ากับคะแนนที่ดีที่สุดของ GPT-6 Sol ไม่ควรถูกอธิบายว่าเป็นการเปรียบเทียบความเร็วที่พยายามเท่ากัน DeepSWE v1.1 ประเมินงานวิศวกรรมซอฟต์แวร์ต้นฉบับในฐานโค้ดจริงที่ต้องทำงานหลายขั้นตอนระยะยาว
เพื่อบริบท การเปิดตัว GPT-6 Sol ดั้งเดิม รายงาน 68.8% ที่ความพยายามสูงสุดบน DeepSWE v1.1
ผลลัพธ์ AutomationBench ที่ระดับ medium ซึ่งจับคู่กันในสรุปเบนช์มาร์กมีความหมายต่อเวิร์กโฟลว์ธุรกิจที่อาศัยเครื่องมือหนัก อย่างไรก็ตาม มันยังคงเป็นผลลัพธ์จากเบนช์มาร์ก ไม่ใช่การรับประกันความสำเร็จในสแตกเครื่องมือของบริษัทของคุณเอง การเปรียบเทียบรวมถึง Claude Opus 5.5 API ใน CometAPI; ประเมินผู้ท้าชิงทั้งหมดด้วยเครื่องมือและเกณฑ์ความสำเร็จเดียวกันก่อนเลือก
GPT-6 Luna API ใน CometAPI เป็นตัวเลือกเน้นต้นทุนอีกตัว แต่ผล broken-search ที่นี่แสดงให้เห็นว่าทำไมเอเจนต์ต้องทดสอบการจัดการความล้มเหลว รวมถึงการดำเนินการเครื่องมือที่สำเร็จ
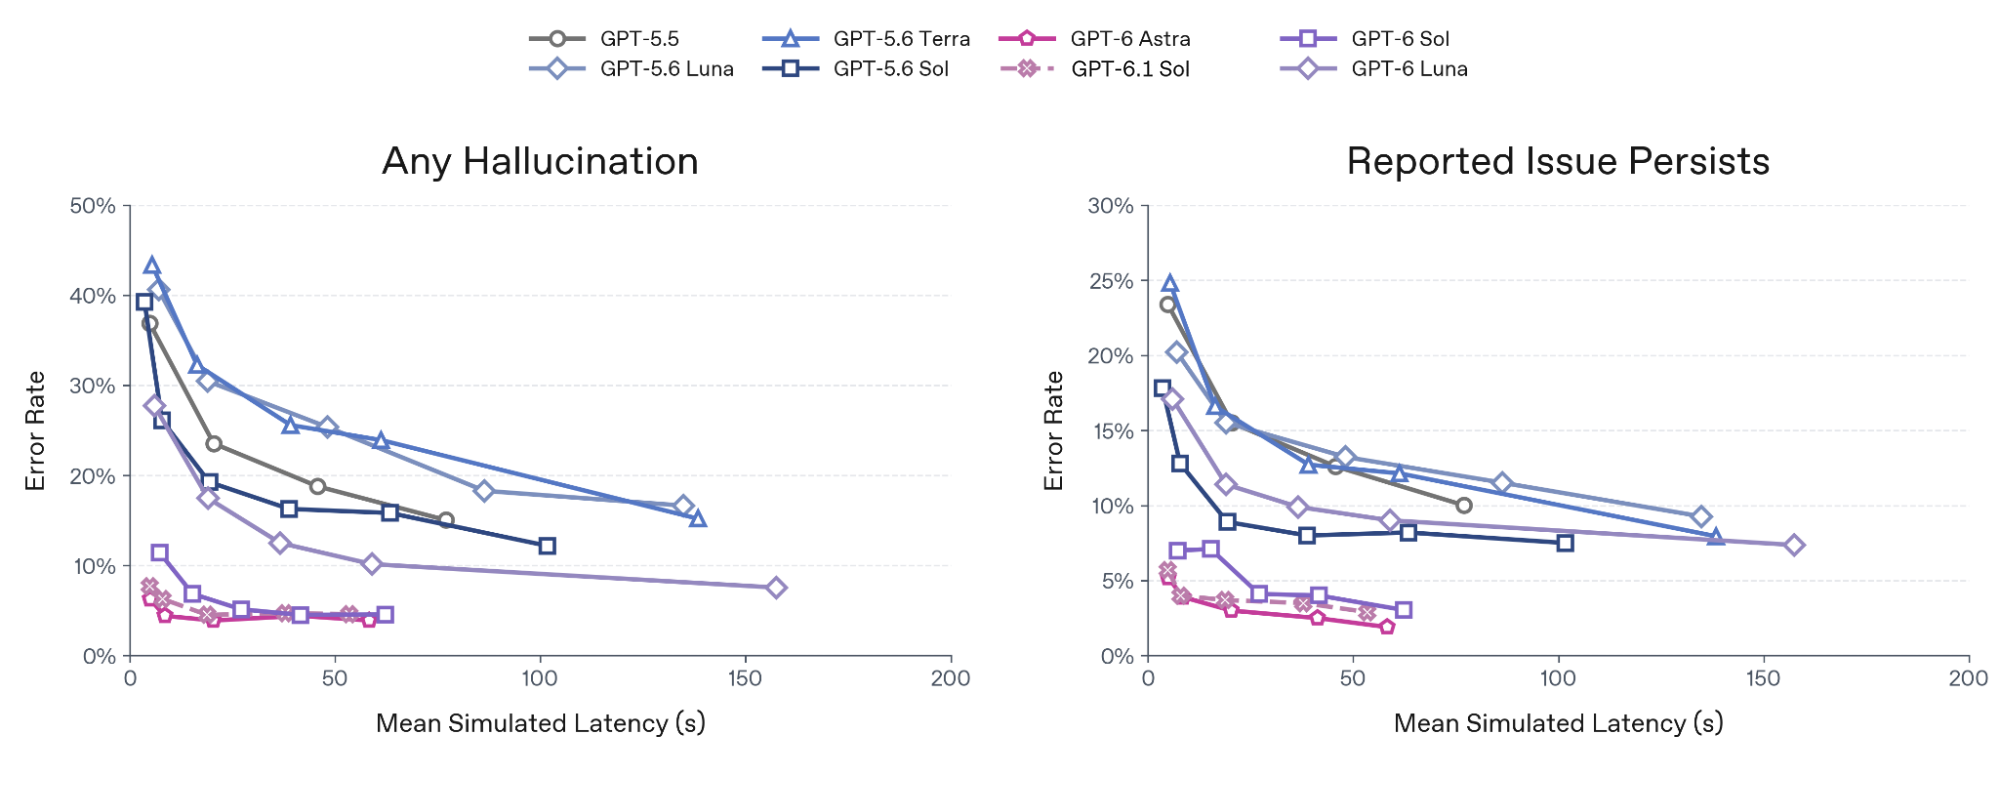
นี่คือการประเมินที่จงใจเป็นปฏิปักษ์ ไม่ใช่อัตราความล้มเหลวในการผลิตทั่วไป พวกมันมีประโยชน์เป็นหลักฐานว่า GPT-6.1 Sol ดีกว่าในการตระหนักเมื่อเครื่องมือใช้ไม่ได้หรือพัง แทนที่จะเดินหน้าต่อด้วยคำกล่าวที่ไม่รองรับอย่างมั่นใจ
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
สำหรับเวิร์กโฟลว์ซับซ้อนใหม่ GPT-6.1 Sol เป็นผู้ทดสอบที่แข็งแกร่ง สำหรับการใช้งาน GPT-6 Sol ที่เสถียร ให้ยกระดับเฉพาะเมื่อผลลัพธ์ที่วัดได้คุ้มค่ากับการย้าย ขีดจำกัดบริบทที่ใช้ร่วมและราคาต่อโทเค็นพื้นฐานทำให้การเปรียบเทียบยุติธรรมเป็นไปได้ แต่เบนช์มาร์กสาธารณะไม่สามารถตัดสินได้ว่าแอปของคุณจะเร็วขึ้น น่าเชื่อถือขึ้น หรือถูกลงหรือไม่
คงใช้ GPT-6 Sol เมื่อมันตอบโจทย์คุณภาพ ระยะเวลาแฝง และงบประมาณของคุณอยู่แล้ว และโมเดลใหม่ไม่ให้ประโยชน์อย่างมีนัยสำคัญในการทดสอบที่แทนงานจริง การผสานที่ทำงานอยู่ก็มีมูลค่า: หลีกเลี่ยงการแทนที่เส้นทางที่เสถียรเพียงเพราะชื่อโมเดลใหม่กว่า
ความเข้ากันได้อาจชี้ขาด GPT-6 Sol รองรับเหตุผลแบบ none; GPT-6.1 Sol เริ่มที่ low แอปพลิเคชันที่ใช้ Sol Chat Completions เรียกฟังก์ชันที่ none ต้องย้ายลูปเครื่องมือไปที่ Responses เพื่อใช้ 6.1 Sol นอกจากนี้ให้ตรวจสอบพารามิเตอร์ sampling และการพาร์สรองรับคำตอบ สิ่งเหล่านี้เป็นการเปลี่ยนแปลงการย้าย ไม่ใช่แค่การสลับ Model ID ดู แนวทางการย้ายของ OpenAI
How to Make the Upgrade Decision
สร้างชุดการประเมินคงที่ด้วยงานประจำ เคสยาก และความล้มเหลวของเครื่องมือจากเวิร์กโฟลว์เป้าหมายของคุณ รักษานิยามงาน สิทธิ์เครื่องมือ และเกณฑ์การยอมรับให้สอดคล้อง เปรียบเทียบฐาน Sol ที่ผ่านการตรวจสอบกับการกำหนดค่า 6.1 Sol ที่ถูกต้อง; บันทึกการตั้งค่าเหตุผลอย่างชัดเจนแทนที่จะแสร้งว่า none และ low เทียบเท่ากัน
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
การเปลี่ยนตัวระบุโมเดลเป็นเพียงก้าวแรก GPT-6.1 Sol รองรับ low, medium, high, xhigh, และ max ขณะที่ GPT-6 Sol รองรับ none เพิ่มเติม ลบการตั้งค่า none ที่ระบุไว้ออกและเลือกความพยายามที่อนุญาต แอปพลิเคชันที่ใช้เครื่องมือยังต้องใช้ Responses API: GPT-6.1 Sol Chat Completions ไม่รองรับการเรียกเครื่องมือ ในขณะที่ GPT-6 Sol Chat Completions รองรับการเรียกฟังก์ชันเฉพาะเมื่อ none คอลัมน์โมเดลทางการในตารางสเปกระบุข้อจำกัดเอ็นด์พอยต์เหล่านี้
GPT-6 Sol ยังคงมีประโยชน์ในที่ที่การผสานที่มีอยู่มีเสถียรภาพอยู่แล้ว หรือเมื่อผู้พัฒนาต้องการการตั้งค่าเหตุผลแบบ none โดยเฉพาะ สำหรับการดีพลอยใหม่ที่เน้นเอเจนต์ การเขียนโค้ด การใช้คอมพิวเตอร์ หรือเวิร์กโฟลว์ที่ใช้บริบทซ้ำ GPT-6.1 Sol เปลี่ยนสมการต้นทุน-ประสิทธิภาพโดยไม่เปลี่ยนราคาโทเค็นอินพุต/เอาต์พุตปกติ
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
สำหรับนักพัฒนาที่ใช้งาน GPT-6 Sol API ใน CometAPI อยู่แล้ว การอัปเกรดเป็น GPT-6.1 Sol สามารถจัดการได้เป็นการย้ายขนาดเล็ก แทนที่จะต้องเขียนผสานรวมใหม่ทั้งหมด
GPT-6.1 Sol พร้อมใช้งานผ่าน CometAPI ด้วยตัวระบุโมเดล gpt-6.1-sol ปัจจุบัน CometAPI แสดงราคาอินพุตบริบทสั้นเริ่มต้นที่ $1.60 ต่อหนึ่งล้านโทเค็น เทียบกับอัตรา $2.00 ทางการ ขณะที่ราคาเอาต์พุตเริ่มที่ $8.00 ต่อหนึ่งล้านโทเค็น ซึ่งทำให้โมเดล Sol ใหม่อยู่ในโครงสร้างราคาลดเหมือนกับ GPT-6 Sol ขณะให้ผู้พัฒนาสามารถเข้าถึงความสามารถที่แข็งแกร่งขึ้นด้านโค้ดดิ้ง เอเจนต์ และการใช้คอมพิวเตอร์
เนื่องจาก CometAPI มอบอินเทอร์เฟซที่ เข้ากันได้กับ OpenAI แอป GPT-6 Sol ที่มีอยู่ส่วนใหญ่สามารถคงโครง SDK และโฟลว์คำขอเดิมไว้ขณะสลับ Model ID เป็น gpt-6.1-sol CometAPI ยังมีเครื่องมือเปรียบเทียบโมเดล ทดสอบพรอมป์ต์ ประมาณต้นทุนเวิร์กโหลด และตรวจสอบพฤติกรรมการย้ายก่อนปล่อยใช้งานจริง
กระบวนการอัปเกรดที่ปลอดภัยกว่าคือรันพรอมป์ต์แทนงานจริงเดียวกันบน GPT-6 Sol และ GPT-6.1 Sol ก่อน จากนั้นเปรียบเทียบคุณภาพเอาต์พุต ระยะเวลาแฝง พฤติกรรมเครื่องมือ และต้นทุนรวม สิ่งนี้สำคัญเป็นพิเศษสำหรับแอปที่พึ่งการตั้งค่าเหตุผล เอาต์พุตที่มีโครงสร้าง การเรียกเครื่องมือ หรือเอเจนต์ที่รันยาว เพราะความเข้ากันได้ของโมเดลไม่ได้การันตีพฤติกรรมเหมือนกันในทุกเวิร์กโฟลว์
สำหรับเวิร์กโหลดซับซ้อนส่วนใหญ่ คำถามสำคัญจึงไม่ใช่ว่า GPT-6.1 Sol มีหน้าต่างบริบทใหญ่กว่าหรืออัตราโทเค็นสูงกว่าหรือไม่ — ไม่ใช่ คำถามคือความสำเร็จของงานที่สูงขึ้น การอ่านแคชที่ถูกลง ความจริงเชิงข้อเท็จจริงที่ดีขึ้น และพฤติกรรมเอเจนต์ที่แข็งแกร่งขึ้น คุ้มค่ากับการเปลี่ยน Model ID และการทดสอบเวิร์กโหลดใหม่หรือไม่
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?