Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog วิธีปรับใช้ Qwen 3.8 Max ภายในเครื่อง: คู่มือฮาร์ดแวร์, vLLM, SGLang และการควอนไทซ์ guide / งานวิจัย CometAPI
วิธีปรับใช้ Qwen 3.8 Max ภายในเครื่อง: คู่มือฮาร์ดแวร์, vLLM, SGLang และการควอนไทซ์ วิธีปรับใช้ Qwen 3.8 Max ในเครื่องโดยใช้น้ำหนักโมเดลแบบเปิด Qwen3.8-2.4T-A95B พร้อมข้อกำหนด GPU, FP8/FP4, vLLM, SGLang, คอนเท็กซ์ 1M และการเพิ่มประสิทธิภาพสำหรับโปรดักชัน
Deon Goodwin ทีมวิจัยโมเดล AI และ API วิธีปรับใช้ Qwen 3.8 Max ในเครื่องโดยใช้น้ำหนักโมเดลแบบเปิด Qwen3.8-2.4T-A95B พร้อมข้อกำหนด GPU, FP8/FP4, vLLM, SGLang, คอนเท็กซ์ 1M และการเพิ่มประสิทธิภาพสำหรับโปรดักชัน
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)การรัน Qwen3.8-Max ในเครื่อง (local) ทำได้แล้ว แต่วลี “Qwen 3.8 Max locally” จำเป็นต้องมีคำชี้แจงสำคัญอย่างหนึ่ง ผลิตภัณฑ์ Max แบบโฮสต์ของ Alibaba และเช็คพอยต์ที่ดาวน์โหลดได้มีความเกี่ยวข้องกันอย่างใกล้ชิด แต่ไม่ใช่ผลิตภัณฑ์เดียวกัน
Qwen เปิดตัวบริการ Max แบบโฮสต์ครั้งแรกเมื่อต้นเดือนสิงหาคม 2026 และปล่อย Qwen3.8-2.4T-A95B เป็น open weights เมื่อ 12 สิงหาคม 2026 เช็คพอยต์นั้นคือโมเดลที่คุณจะดีพลอยบนโครงสร้างพื้นฐานของคุณเองจริง ๆ
นี่ไม่ใช่บทเรียนสไตล์ Ollama บนพีซีเกมมิ่งทั่วไป เช็คพอยต์แบบไม่ควอนไทซ์เป็นโมเดล Mixture-of-Experts พารามิเตอร์ 2.4 ล้านล้าน และสูตร vLLM ปัจจุบันประมาณขนาดน้ำหนัก BF16 ไว้ที่ 4.45 TiB แม้แต่เวอร์ชันเชิงผลิตแบบ floating-point 4 บิตก็ยังใช้พื้นที่น้ำหนักประมาณ 1.3–1.5 TiB
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Sep 25, 2026 อัปเดตล่าสุด Sep 25, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
คำตอบอย่างย่อ:
Qwen 3.8 Max เทียบกับโมเดลแบบเปิดที่คุณดีพลอยจริง เช็คพอยต์ที่ดาวน์โหลดได้ Qwen3.8-2.4T-A95B ถูกอธิบายอย่างเป็นทางการว่าเป็นโมเดล causal language พารามิเตอร์ 2.4T ที่มีพารามิเตอร์ทำงานต่อโทเคนประมาณ 95B บริการ Max แบบโฮสต์มีความสามารถในระดับผลิตภัณฑ์ที่ไม่มีในเช็คพอยต์แบบเปิดปัจจุบัน
พารามิเตอร์รวม 2.4T 2.4T พารามิเตอร์ที่ทำงาน ~95B ~95B สถาปัตยกรรม Sparse MoE Sparse MoE อินพุต ข้อความ, ภาพ, วิดีโอ ข้อความ คอนเท็กซ์ คอนเท็กซ์แบบจัดการ 1M เนทีฟ 262,144; ขยายได้ถึง ~1.01M พฤติกรรมการคิด มีการจัดการการคิด/ตัวเลือกไม่คิด ต้องมีการคิด; ปรับความพยายามในการให้เหตุผลได้ เครื่องมือในตัว มีให้บนบริการแบบจัดการ แอปพลิเคชันต้องจัดเตรียมเครื่องมือเอง โฮสต์เอง ไม่ต้องจัดการ weights ต้องจัดการ; เช็คพอยต์แบบเปิด
ผลิตภัณฑ์แบบโฮสต์รองรับอินพุตข้อความ ภาพ และวิดีโอ พร้อมคอนเท็กซ์ 1,000,000 โทเคน ในทางตรงกันข้าม เช็คพอยต์แบบเปิดรองรับเฉพาะข้อความและมีคอนเท็กซ์เนทีฟ 262,144 โทเคน ความแตกต่างนี้สำคัญหากแอปพลิเคชันของคุณพึ่งพาอินพุตแบบมัลติโหมดหรือเครื่องมือในตัวที่มีการจัดการ
สถาปัตยกรรมและสเปกของ Qwen 3.8 CometAPI ได้ครอบคลุมพื้นหลังของโมเดลไว้แล้วใน What is Qwen3.8 Max ดังนั้นคู่มือการดีพลอยนี้จะโฟกัสการอภิปรายสถาปัตยกรรมเฉพาะรายละเอียดที่มีผลต่อหน่วยความจำ พารัลเลลิซึม และการให้บริการ
พารามิเตอร์รวม/ที่ทำงาน 2.4T / ~95B ต่อโทเคน เลย์เอาต์เลเยอร์ 92 เลเยอร์: 69 Gated DeltaNet + 23 full attention การรูตของ MoE ผู้เชี่ยวชาญที่รูตได้ 512; ใช้งาน 10 รูต + 1 shared หัว full-attention หัว query 64 / หัว key-value 4 คอนเท็กซ์เนทีฟ 262,144 โทเคน คอนเท็กซ์ที่ขยาย สูงสุดประมาณ 1,010,000 โทเคน Multi-Token Prediction รองรับ โมดาลิตีของเช็คพอยต์แบบเปิด เฉพาะข้อความ
อย่าตีความ “95B active parameters” ว่าเป็นรอยเท้าหน่วยความจำของโมเดล 95B การทำงานแบบสแปร์สช่วยลดคอมพิวต์ต่อโทเคน แต่ระบบให้บริการยังคงต้องเข้าถึงชุดน้ำหนักของผู้เชี่ยวชาญทั้งหมด
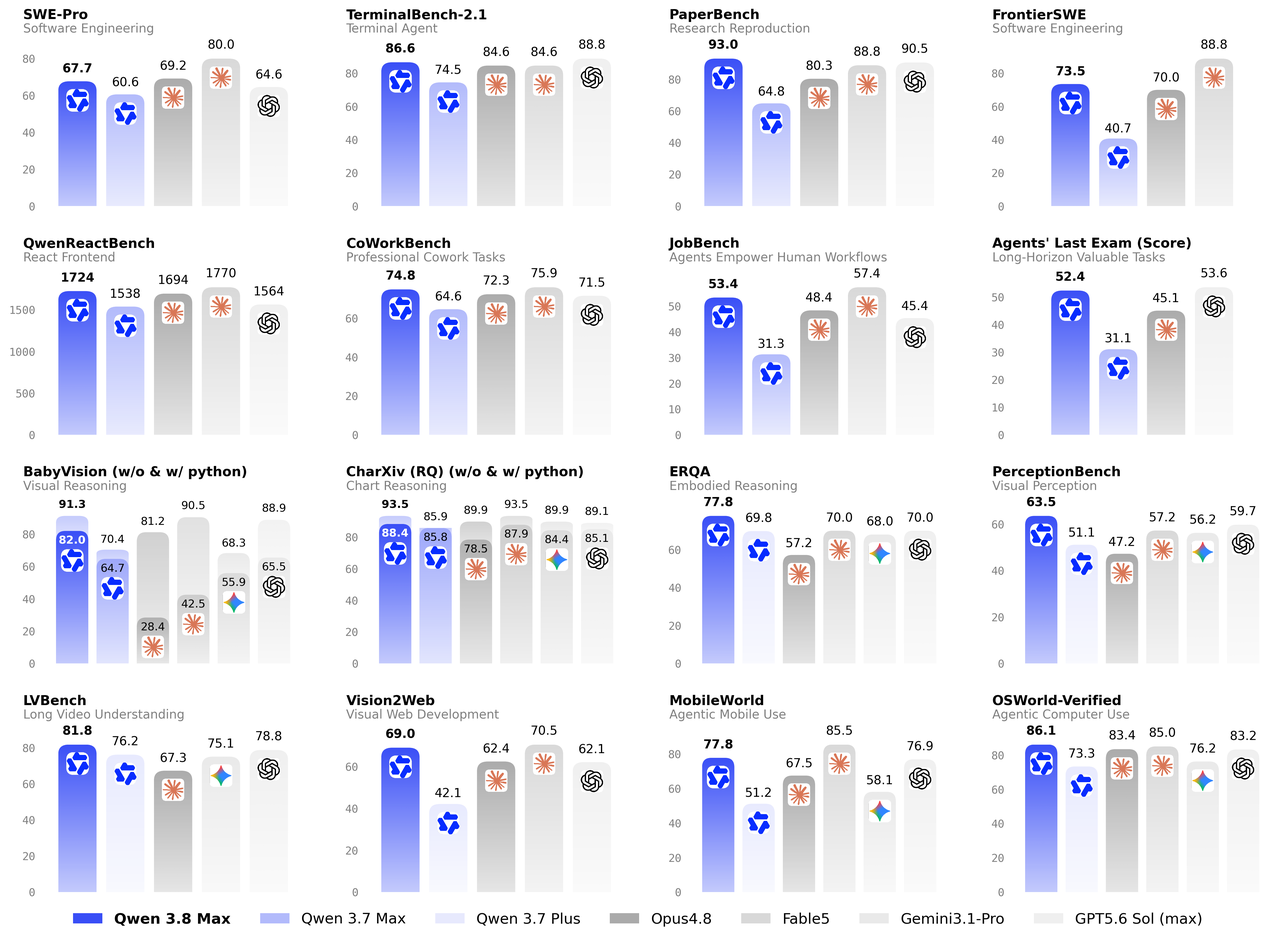
สแนปช็อตเบนช์มาร์กของ Qwen 3.8 Max เนื่องจากภาพรวม Qwen3.8 Max ของ CometAPI มีการพูดถึงเบนช์มาร์กอย่างละเอียดแล้ว บทความนี้จึงใช้เพียงชุดย่อยที่เกี่ยวข้องกับการดีพลอยจากตารางเบนช์มาร์กในโมเดลการ์ดอย่างเป็นทางการของ Qwen
Terminal Bench 2.1 86.6 74.5 88.8 SWE-bench Pro 67.7 60.6 64.6 PaperBench 93.0 64.8 90.5 FrontierSWE 73.5 40.7 — CoWorkBench 74.8 64.6 71.5 GPQA Diamond 92.6 92.4 94.1
กราฟสมรรถนะ Qwen3.8 อย่างเป็นทางการที่เผยแพร่โดย ทีม Qwen .
กำไรที่รายงานสูงสุดเมื่อเทียบกับ Qwen3.7-Max ในชุดย่อยนี้คือ PaperBench และ FrontierSWE Qwen3.8-Max ยังเหนือกว่า GPT-5.6 Sol บน SWE-bench Pro และ PaperBench ขณะที่ GPT-5.6 Sol นำหน้าใน Terminal Bench 2.1 สำหรับการตัดสินใจดีพลอย ให้มองสิ่งเหล่านี้เป็นบริบทด้านความสามารถ; การวัดหน่วยความจำและอัตราการให้บริการด้านล่างมีความเกี่ยวข้องเชิงปฏิบัติมากกว่า
ตารางเบนช์มาร์กไม่ใช่อันดับสากล เครื่องมือทดสอบ การตั้งค่า timeout ขีดจำกัดคอนเท็กซ์ การเข้าถึงเครื่องมือ และการควอนไทซ์ สามารถเปลี่ยนผลลัพธ์ได้ ทดสอบเบนช์มาร์กกับเช็คพอยต์ ความละเอียด (precision) เอนจินให้บริการ และการกระจายพรอมป์ตที่คุณจะใช้จริง
ฮาร์ดแวร์ที่ Qwen3.8 ต้องใช้สำหรับการดีพลอยในเครื่องคืออะไร?
ความต้องการ GPU สำหรับ Qwen3.8-2.4T-A95B นี่คือคำถามสำคัญในการดีพลอย สูตร vLLM สำหรับ Qwen3.8 ปัจจุบัน เผยแพร่ขนาดรอยเท้าของเช็คพอยต์และจำนวน GPU ที่สมจริงพร้อมเฮดรูมขณะรันไทม์ ซึ่งมีประโยชน์กว่าการประมาณ VRAM จากจำนวนพารามิเตอร์อย่างเดียว
BF16 4.45 TiB 24 GPUs 24 GPUs 48 GPUs ความเที่ยงตรงสูงสุด/วิจัย FP8 2.27 TiB 16 GPUs 16 GPUs 32 GPUs เชิงผลิตความเที่ยงตรงสูง MXFP4 1.45 TiB — 8 GPUs 16 GPUs การดีพลอย AMD ที่ใช้งานได้จริง NVFP4 W4A4 1.32 TiB 8 GPUs — 16 GPUs การดีพลอย NVIDIA ที่ใช้งานได้จริง
สำหรับองค์กรส่วนใหญ่ที่ต้องการโฮสต์ Qwen3.8 ด้วยตนเองจริง ๆ FP4 คือจุดเริ่มต้นที่ใช้งานได้จริง ค่าคอนฟิกเด่นฝั่ง NVIDIA คือ NVFP4 W4A4 บน 8× B300 ; ฝั่ง AMD ที่สอดคล้องกันคือ MXFP4 บน 8× MI355X
เซิร์ฟเวอร์ H200 จำนวน 8 ตัวไม่พอสำหรับการดีพลอยโมเดลเต็มตามที่แนะนำ สูตรอย่างเป็นทางการประเมิน H200 ที่ 16 GPUs สำหรับ FP4, 32 สำหรับ FP8 และ 48 สำหรับ BF16
ความต้องการ VRAM สำหรับ Qwen3.8-27B Qwen3.8-27B เป็นทางเลือกสำหรับเวิร์กสเตชันที่ใช้งานได้จริง หน่วยความจำของน้ำหนักดิบประมาณ 54 GB ใน BF16, 27 GB ใน FP8 และ 13.5 GB ที่ความละเอียด 4 บิต ค่าโอเวอร์เฮดขณะรันและ KV cache จะเพิ่มความต้องการจริง โดยเฉพาะเมื่อคอนเท็กซ์ยาว
BF16 ~54 GB ใช้ GPU 64–80 GB ขึ้นอยู่กับคอนเท็กซ์และโอเวอร์เฮดการให้บริการ FP8 / INT8 ~27 GB GPU 40–48 GB ให้เฮดรูมรันไทม์ที่ใช้งานได้จริงกว่า 4-bit ~13.5 GB GPU ระดับคอนซูเมอร์ 20–24 GB อาจใช้งานได้ที่ความยาวคอนเท็กซ์ปานกลาง
ตัวเลขเหล่านี้เป็นค่าประมาณเพื่อการวางแผนที่ได้มาจากจำนวนพารามิเตอร์ ยืนยันเช็คพอยต์จริง รูปแบบควอนไทซ์ เอนจินให้บริการ ความยาวคอนเท็กซ์ และการตั้งค่า KV-cache ก่อนคำนวณขนาดฮาร์ดแวร์สำหรับผลิตจริง
Qwen3.8 รันบน GPU ระดับคอนซูเมอร์ได้หรือไม่? โมเดลเต็ม Qwen3.8-2.4T-A95B ไม่เหมาะสมกับ GPU ระดับคอนซูเมอร์ทั่วไป แม้เมื่อควอนไทซ์อย่างหนัก โครงการคอมมูนิตี้หนึ่งแสดงให้เห็นบิลด์ UD-Q1_0 ที่ถูกบีบอัดอย่างรุนแรงขนาด 397 GB บนระบบ DGX Spark สี่เครื่อง แต่เส้นทางนั้นเป็นการควอนไทซ์ขั้นสุดโต่งเชิงทดลอง ไม่ใช่ฐานสำหรับการให้บริการที่เน้นคุณภาพ
สำหรับเวิร์กสเตชันหรือโฮมแลบ โมเดลที่เหมาะสมกว่าคือ Qwen3.8-27B ซึ่งปล่อย open weights เมื่อ 14 สิงหาคม 2026 โมเดลนี้โฮสต์ได้ง่ายกว่ามาก และเป็นตัวเลือกที่ถูกต้องหาก “local” ของคุณหมายถึงเครื่องเดียวมากกว่าคลัสเตอร์ GPU
ก่อนติดตั้ง Qwen 3.8 Max วางแผนโครงสร้างพื้นฐานก่อนรันคำสั่งติดตั้ง คุณต้องมี Linux สแตกเร่งความเร็วที่เข้ากันได้ ที่เก็บข้อมูลภายในหรือแชร์ที่เพียงพอสำหรับเช็คพอยต์ อินเตอร์คอนเน็กต์ GPU แบนด์วิธสูง และเมื่อข้ามโหนด ต้องมีเครือข่ายที่ออกแบบมาสำหรับการอินเฟอเรนซ์แบบกระจาย สูตร vLLM ปัจจุบันแนะนำให้ใช้ vLLM nightly และ Transformers 5.4.0 ขึ้นไป
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
วิธีดีพลอย Qwen 3.8 แบบ FP8 ด้วย vLLM FP8 เป็นตัวเลือกที่สมเหตุสมผลเมื่อคุณต้องการเช็คพอยต์ที่ Qwen จัดให้และสามารถรองรับโครงสร้างพื้นฐานแบบหลายโหนดได้ เช็คพอยต์อย่างเป็นทางการคือ Qwen/Qwen3.8-2.4T-A95B-FP8
สำหรับการดีพลอย B300-class แบบสองโหนด 16 GPU ให้รันโหนดหัวด้วย:
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
บนโหนดเวิร์กเกอร์ ใช้โทโพโลยีเดียวกันแต่กำหนดลำดับโหนดต่างกันและไม่เปิด API server:
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
อย่าคัดลอกตัวอย่าง 16 GPU ไปใช้กับเซิร์ฟเวอร์ H200 โดยไม่ปรับขนาดโทโพโลยี รุ่น FP8 เดียวกันนี้ถูกประเมินไว้ที่ 32× H200 ในสูตร vLLM ปัจจุบัน
วิธีรัน Qwen 3.8 บนเซิร์ฟเวอร์ 8× B300 เครื่องเดียว สำหรับ NVIDIA Blackwell ค่าคอนฟิกโมเดลเต็มที่ใช้งานได้จริงที่สุดคือ NVFP4 ขณะนี้ vLLM รับรอง NVFP4 W4A4 พร้อมเทนเซอร์พารัลเลลิซึมทั่ว 8 GPU ของ B300
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
บิลด์ NVFP4 ของ Inferact เป็นเช็คพอยต์ที่ผ่านการควอนไทซ์ ไม่ใช่อาร์ติแฟกต์ BF16 ดั้งเดิมของ Qwen ตรวจสอบคุณภาพโมเดลกับชุดการยอมรับของคุณเองก่อนจะถือว่าเป็นตัวแทนแทน BF16 หรือ FP8 ได้โดยตรง
วิธีดีพลอย Qwen 3.8 ด้วย SGLang SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
--trust-remote-code \
--model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
--tp-size 8 \
--context-length 200000 \
--preferred-sampling-params '{"top_k": 20}' \
--attention-backend trtllm_mha \
--linear-attn-prefill-backend flashinfer \
--linear-attn-decode-backend flashinfer \
--reasoning-parser qwen3 \
--tool-call-parser qwen3_coder \
--host 0.0.0.0 \
--port 30000
SGLang รายงาน 346 โทเคน/วินาที สำหรับเอาต์พุตที่ batch size 1 บน TP8 B300 พร้อม MTP และ throughput รวมที่สูงขึ้นอย่างมากในเลย์เอาต์การให้บริการแบบแยกส่วน ให้ถือว่าตัวเลขเหล่านี้เป็นการวัดสแตกการให้บริการ ไม่ใช่เบนช์มาร์กคุณภาพโมเดล
ทดสอบเอ็นด์พอยต์ที่เข้ากันได้กับ OpenAI แบบโลคัล ทั้ง vLLM และ SGLang เปิด API ที่เข้ากันได้กับ OpenAI ทำให้การบูรณาการแอปพลิเคชันเป็นเรื่องตรงไปตรงมา
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "ออกแบบสถาปัตยกรรม Redis ที่ทนทานต่อความล้มเหลวสำหรับ 3 ภูมิภาค"
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
โมเดลการ์ดอย่างเป็นทางการแนะนำให้ใช้ค่าเริ่มต้นของ sampling เป็น temperature=1.0, top_p=0.95 และ top_k=20 สำหรับงานเชิงเอเจนต์ ให้เผื่อ budget เอาต์พุตสำหรับการให้เหตุผล แทนที่จะกำหนด max_tokens แค่สำหรับคำตอบสุดท้ายที่มองเห็นได้
เปิดใช้หน้าต่างคอนเท็กซ์ 1M VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
--max-model-len 1010000 \
--hf-overrides '{"max_position_embeddings": 1010000}' \
--reasoning-parser qwen3 \
...
อย่าตั้ง 1M เป็นค่าเริ่มต้นเพียงเพราะรองรับ คอนเท็กซ์สูงสุดที่ใหญ่ขึ้นจะสงวนความจุแคชมากขึ้นและสามารถลด concurrency ได้อย่างมาก ตั้งค่า --max-model-len ให้เหมาะกับเวิร์กโหลดจริง
จะปรับปรุงประสิทธิภาพอินเฟอเรนซ์ของ Qwen3.8 อย่างไร?
ใช้ MTP-3 เพื่อลด latency ต่อผู้ใช้ --speculative-config '{"method":"mtp","num_speculative_tokens":3}'
ใช้ fastsafetensors เพื่อให้เริ่มต้นได้เร็วขึ้น สำหรับโมเดลขนาดเทราไบต์ เวลาเริ่มต้นมีความสำคัญ ในการวัดหนึ่งของ vLLM เวลาโหลดน้ำหนักลดจาก 545 วินาทีเป็น 306 วินาทีด้วย fastsafetensors และ lazy loading
--load-format fastsafetensors \
--safetensors-load-strategy lazy
ใช้ Expert Parallelism เพื่อเพิ่ม Throughp พร้อมกัน สำหรับความพร้อมกันสูง Qwen3.8 ได้ประโยชน์จากเลย์เอาต์แบบ expert-parallel เพราะมีผู้เชี่ยวชาญที่รูตได้ 512 ราย vLLM รายงานได้ถึง 3,200 โทเคน/วินาที/ต่อ GPU สำหรับ FP8 EP และสูงสุด 4,300 โทเคน/วินาที/ต่อ GPU สำหรับค่าคอนฟิก NVFP4 DEP16 ที่ปรับให้เหมาะสม
ตั้งค่า --max-model-len เพื่อบาลานซ์ VRAM และ concurrency ตั้งค่า --max-model-len ให้เท่ากับลำดับที่ยาวที่สุดที่เวิร์กโหลดต้องใช้จริง ๆ ค่าที่ใหญ่ขึ้นจะสงวนความจุ KV-cache มากขึ้น เพิ่มแรงกดดันหน่วยความจำ และสามารถลดจำนวนคำขอพร้อมกันได้แม้เมื่อโมเดลโหลดน้ำหนักได้พอดี
เริ่มจากเปอร์เซ็นไทล์ที่เป็นตัวแทนของการใช้งานจริงแทนที่จะใช้ค่าสูงสุดของคอนเท็กซ์ที่โมเดลโฆษณาไว้ จากนั้นทดสอบโหลดด้วยความละเอียด รูปแบบ batch และเอนจินให้บริการเดียวกับที่ใช้ในโปรดักชัน แล้วจึงค่อยเพิ่มเมื่อคำขอจริงต้องการคอนเท็กซ์มากขึ้น
การดีพลอย Qwen 3.8 Max แบบโลคัล เทียบกับ API การมี open weights ไม่ได้ทำให้การอินเฟอเรนซ์โลคัลคุ้มค่าโดยอัตโนมัติ การตัดสินใจที่ถูกต้องขึ้นกับอัตราการใช้งาน การพำนักของข้อมูล ทีมงาน การตั้งเป้าความพร้อมใช้งาน และว่าคุณต้องการความสามารถมัลติโหมดของโมเดลแบบจัดการจริงหรือไม่
โครงสร้างพื้นฐาน เซิร์ฟเวอร์/คลัสเตอร์หลาย GPU ไม่ต้องมีโครงสร้างพื้นฐาน GPU โมดาลิตีอินพุต ข้อความ ข้อความ, ภาพ, วิดีโอ คอนเท็กซ์ เนทีฟ 262K; ขยายได้ ~1.01M จัดการ 1M การควบคุมข้อมูล สูงสุด Cloud API การปฏิบัติการ คุณรับผิดชอบมอนิเตอร์ อัปเกรด และ HA ผู้ให้บริการจัดการให้ เหมาะกับ การพำนักข้อมูล การใช้งานต่อเนื่อง ทีมโครงสร้างพื้นฐาน ทีมแอปทั่วไปและเวิร์กโหลดแปรผัน
หากคุณมีอุปกรณ์เร่งความเร็วที่เหมาะสมอยู่แล้วและมีการใช้งานสูงอย่างต่อเนื่อง การโฮสต์เองสามารถคุ้มค่าได้ หากคุณจะซื้อคลัสเตอร์เพียงเพื่อโมเดลนี้ Qwen3.8-Max บน CometAPI มักจะเป็นเส้นทางที่มีแรงเสียดทานต่ำกว่า คู่มือ API ที่มีอยู่ครอบคลุมการบูรณาการแบบโฮสต์แล้ว ขณะที่คู่มือราคาอธิบายการสร้างแบบจำลองต้นทุน ดังนั้นบทความนี้จึงมุ่งเน้นที่การดีพลอยแบบโลคัล
ปัญหาทั่วไปในการดีพลอย Qwen 3.8 แบบโลคัล
เซิร์ฟเวอร์หน่วยความจำ GPU ไม่พอระหว่างเริ่มต้น ลดค่า --max-model-len ก่อนหากปัญหาอยู่ที่แคช หากน้ำหนักเองไม่พอ การลดคอนเท็กซ์จะไม่แก้ปัญหารากเหง้า; ย้ายไปใช้เช็คพอยต์ความละเอียดต่ำที่ได้รับการรับรองหรือเพิ่มจำนวน GPU
Tensor Parallelism ล้มเหลวด้วยขนาดไม่ถูกต้อง Qwen3.8 มีหัว attention 64 หัวในเลเยอร์ full-attention ดังนั้น vLLM จึงต้องการให้ TP หาร 64 ลงตัว ขนาด TP ที่ตรงไปตรงมาคือ 1, 2, 4, 8, 16 และ 32 VRAM รวมดิบจึงไม่เพียงพอสำหรับการเลือกโทโพโลยี
เซิร์ฟเวอร์ใช้เวลาเริ่มต้นนาน การโหลดน้ำหนักตั้งแต่หนึ่งถึงหลายเทราไบต์บวกกับการ JIT ของเคอร์เนลอาจใช้เวลาหลายนาที เพิ่มค่า VLLM_ENGINE_READY_TIMEOUT_S และตรวจสอบเอ็นด์พอยต์อินเฟอเรนซ์จริงแทนที่จะสมมุติกรอบเวลาเริ่มต้นสั้น ๆ
โมเดลโลคัลไม่สามารถประมวลผลภาพได้ สิ่งนี้เป็นไปตามคาด เช็คพอยต์แบบเปิด Qwen3.8-2.4T-A95B รองรับเฉพาะข้อความ ข้อจำกัดนี้เฉพาะกับ Qwen3.8-2.4T-A95B ส่วน Qwen3.8-27B รองรับอินพุตภาพเมื่อโหลดไฟล์ vision projection แยกต่างหาก
คอนเท็กซ์ 1M ลด throughput อย่างมาก ลดค่า --max-model-len ให้เท่ากับลำดับที่ยาวที่สุดที่เวิร์กโหลดต้องใช้จริง หน้าต่างคอนเท็กซ์ที่รองรับสูงสุดไม่จำเป็นต้องเป็นการตั้งค่าที่ดีที่สุดสำหรับโปรดักชัน; เลือกขีดจำกัดคอนเท็กซ์ที่บาลานซ์ข้อกำหนดเวิร์กโหลด การใช้ KV-cache และ concurrency
Ollama หรือ LM Studio รัน Qwen 3.8 Max ได้หรือไม่? ระบบนิเวศสามารถแพ็กเกจนํ้าหนัก Qwen3.8 ที่ถูกควอนไทซ์อย่างหนักสำหรับการอินเฟอเรนซ์สไตล์ llama.cpp ได้ แต่ไม่ควรสับสนกับเวิร์กโฟลว์ Ollama เดสก์ท็อปปกติ บิลด์ที่ควอนไทซ์ซึ่งกินพื้นที่หลายร้อยกิกะไบต์ยังคงต้องการหน่วยความจำที่เข้าถึงได้หลายร้อยกิกะไบต์ และมีการแลกเปลี่ยนคุณภาพและประสิทธิภาพอย่างมีนัยสำคัญ
สำหรับการพัฒนาท้องถิ่นทั่วไป Qwen3.8-27B คือเป้าหมายที่เหมาะสม โมเดล 2.4T แบบเต็มควรถูกมองว่าเป็นโมเดลสำหรับเซิร์ฟเวอร์/คลัสเตอร์ แม้เมื่อควอนไทซ์ชุมชนขั้นสุดทำให้สามารถบูตบนฮาร์ดแวร์ที่ไม่ปกติได้ทางเทคนิค
ควรเลือกวิธีดีพลอยแบบใด? สำหรับ NVIDIA Blackwell การดีพลอย 8× B300 แบบ NVFP4 ปัจจุบันเป็นจุดเริ่มต้นโมเดลเต็มที่สะอาดที่สุด สำหรับ AMD การใช้ 8× MI355X พร้อม MXFP4 คือค่าคอนฟิกที่ใช้งานได้จริงที่สอดคล้องกัน ใช้ FP8 เมื่อคุณให้ความสำคัญกับที่มาของเช็คพอยต์และคุณภาพมากกว่าขนาดโครงสร้างพื้นฐาน และใช้ BF16 เฉพาะเมื่อความเที่ยงตรงสูงสุดคุ้มกับความต้องการหน่วยความจำระดับหลายแร็ก
บทสรุป Qwen3.8-Max ข้ามเส้นสำคัญนับตั้งแต่เปิดตัว API ครั้งแรก: ตระกูล Qwen ระดับ Max ตอนนี้มีเช็คพอยต์ 2.4T แบบเปิดที่องค์กรสามารถใช้งานได้อย่างสมบูรณ์บนโครงสร้างพื้นฐานของตนเอง
แต่การมี open weights ไม่ได้หมายถึงฮาร์ดแวร์คอนซูเมอร์ รอยเท้า BF16 ขนาด 4.45 TiB เช็คพอยต์ FP8 ขนาด 2.27 TiB และเวอร์ชัน FP4 ขนาด 1.3–1.5 TiB ทำให้ Qwen3.8-2.4T-A95B เป็นหนึ่งในโมเดลแบบเปิดที่ต้องใช้โครงสร้างพื้นฐานเข้มที่สุด ข้อดีเชิงปฏิบัติคือ vLLM และ SGLang รองรับสถาปัตยกรรมนี้แล้ว และ FP4 ทำให้การดีพลอยแบบหนึ่งโหนด 8× B300 หรือ 8× MI355X เป็นไปได้
โฮสต์เองเมื่อการควบคุมข้อมูล การใช้งานต่อเนื่อง และการเป็นเจ้าของโครงสร้างพื้นฐานคุ้มค่ากับคลัสเตอร์ มิฉะนั้น ให้ใช้ Max API แบบจัดการ—หรือ Qwen3.8-27B เมื่อสิ่งที่คุณต้องการจริง ๆ คือโมเดล Qwen ที่แข็งแกร่งบนเวิร์กสเตชันเครื่องเดียว