
วิธีที่เร็วที่สุดในการใช้ GLM-5.3 Flash API คือเรียกโมเดลผ่าน CometAPI ที่รองรับรูปแบบ OpenAI บนปลายทาง chat-completions รายละเอียดการเชื่อมต่อถูกรวมไว้ในตารางสเปค API ด้านล่าง; เก็บ API key ไว้บนเซิร์ฟเวอร์
คำตอบแบบสรุปก่อน: สร้าง CometAPI key, ติดตั้ง SDK ที่รองรับ OpenAI, ส่งคำขอ POST ไปที่ /v1/chat/completions แล้วค่อยเพิ่มการสตรีม มองภาพ ผลลัพธ์ JSON หรือ tools หลังจากคำขอพื้นฐานสำเร็จแล้ว
GLM-5.3 Flash API คืออะไร?
GLM-5.3 Flash คือโมเดลมัลติโหมดที่เน้นประสิทธิภาพของ Z.ai ในตระกูล GLM-5 มีความสามารถด้านการให้เหตุผล บริบทยาว ความเข้าใจภาพ และการทำงานเชิงเอเจนต์ผ่าน chat API โมเดลมี 320B พารามิเตอร์ทั้งหมด แต่เปิดใช้ 18B ต่อโทเคน; สถาปัตยกรรมนี้สำคัญต่อค่าใช้จ่าย แต่สิ่งที่นักพัฒนาสัมผัสคือโมเดลที่คงสถานะได้ดีในพรอมป์ตยาวและการเรียกเครื่องมือซ้ำ
คู่มือนี้ตั้งใจย่อส่วนเรื่องสถาปัตยกรรมและผลทดสอบ โดย บทความภาพรวมโมเดล ได้อธิบายการออกแบบ hybrid attention น้ำหนักเปิด เมทริกซ์ผลทดสอบตอนเปิดตัว พื้นฐานราคา และการเปรียบเทียบในตระกูลโมเดลไว้แล้ว ที่นี่จะเน้นพฤติกรรมการเชื่อมต่อและการตัดสินใจสำหรับงานโปรดักชัน
สเปค API ที่มีผลต่อการเชื่อมต่อ
| สเปค API | ค่า | ความหมายเชิงปฏิบัติ |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | กำหนดค่านี้ครั้งเดียวในไคลเอนต์ฝั่งเซิร์ฟเวอร์ |
| Endpoint | POST /v1/chat/completions | ใช้เส้นทาง chat-completions ที่รองรับ OpenAI |
| Compatible SDKs | ไคลเอนต์ Python และ JavaScript ที่รองรับ OpenAI | ใช้รูปแบบไคลเอนต์ที่คุ้นเคยโดยตั้งค่า CometAPI เป็น base URL |
| Authentication | Bearer API key | เก็บคีย์ไว้ในตัวแปรสภาพแวดล้อมฝั่งเซิร์ฟเวอร์หรือตัวจัดการความลับ |
| Model code | glm-5.3-flash | ใช้ค่านี้ตรงๆ ใน request body |
| Context window | 1,048,576 โทเคน | เหมาะสำหรับรีโพขนาดใหญ่ ชุดเอกสาร และประวัติเอเจนต์ยาว |
| Maximum output | สูงสุด 131,072 โทเคน | ตั้งเพดานต่ำกว่าตามงานเพื่อคุมต้นทุนและเวลาแฝง |
| Native inputs | Text, image, video, file | การรองรับในเส้นทางโฮสต์อาจต่างกัน; ตรวจสอบเส้นทาง CometAPI ที่ใช้จริงก่อนพึ่งพาทุกโมดาลิตี้ |
| Output | Text | โมเดลตีความสื่อได้แต่ไม่สร้างภาพหรือวิดีโอออกโดยตรง |
| Reasoning | low, high, max | ใช้ระดับ effort เพื่อแลกเปลี่ยนเวลาแฝงและโทเคนกับความลึก |
| Thinking | เปิดใช้งานตลอดเวลา | อย่าส่งพารามิเตอร์เพื่อพยายามปิด thinking |
| Developer features | สตรีมมิง, ฟังก์ชันคอล, แคชชิง, เอาต์พุตแบบโครงสร้าง | มีประโยชน์สำหรับแอปโต้ตอบ เอเจนต์ และไปป์ไลน์ที่อ่านได้โดยเครื่อง |
ความสามารถของโมเดลกับความสามารถของเกตเวย์อาจไม่เหมือนกัน ให้ยึดหน้ารายการโมเดลของ CometAPI และสคีมาของ API ที่ใช้งานจริงเป็นสัญญาสำหรับเส้นทางที่เรียก โดยเฉพาะกับวิดีโอ ไฟล์ JSON Schema แบบเคร่งครัด และฟิลด์ thinking เฉพาะผู้ให้บริการ
บริบทด้านประสิทธิภาพโดยสังเขป
Z.ai รายงานผลเปิดตัวที่แข็งแรง ในงานที่สำคัญสำหรับผู้ใช้ API: งานเทอร์มินัล วิศวกรรมซอฟต์แวร์ การใช้เครื่องมือ และออโตเมชัน คะแนนเหล่านี้มาจากผู้ขายด้วยฮาร์เนสและนโยบายเครื่องมือเฉพาะ จึงใช้ชี้แนวโน้มความถนัดมากกว่าจัดอันดับสากล
| เบนช์มาร์ก | GLM-5.3 Flash | นัยต่อภาระงาน API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | เหมาะกับเอเจนต์โค้ดที่ขับด้วยเทอร์มินัล |
| DeepSWE v1.1 | 63.4 | มีแววในการทำวิศวกรรมซอฟต์แวร์ระดับรีโพขนาดใหญ่ |
| Toolathlon Verified | 78.4 | สัญญาณดีด้านการเลือกและใช้เครื่องมือ |
| AutomationBench | 48.8 | ออโตเมชันหลายขั้นตอนดีขึ้นเทียบกับรุ่นก่อน |
ผลเชิงปฏิบัติแคบกว่าตารางเบนช์มาร์ก: GLM-5.3 Flash เป็นตัวเลือกที่แข็งแรงเมื่อเวิร์กโฟลว์ผสานบริบทยาวกับเครื่องมือหรือฟีดแบ็กจากภาพ สำหรับการเปรียบเทียบโมเดลครบถ้วน ใช้ ภาพรวมโมเดล ที่มีอยู่แทนการทำซ้ำที่นี่
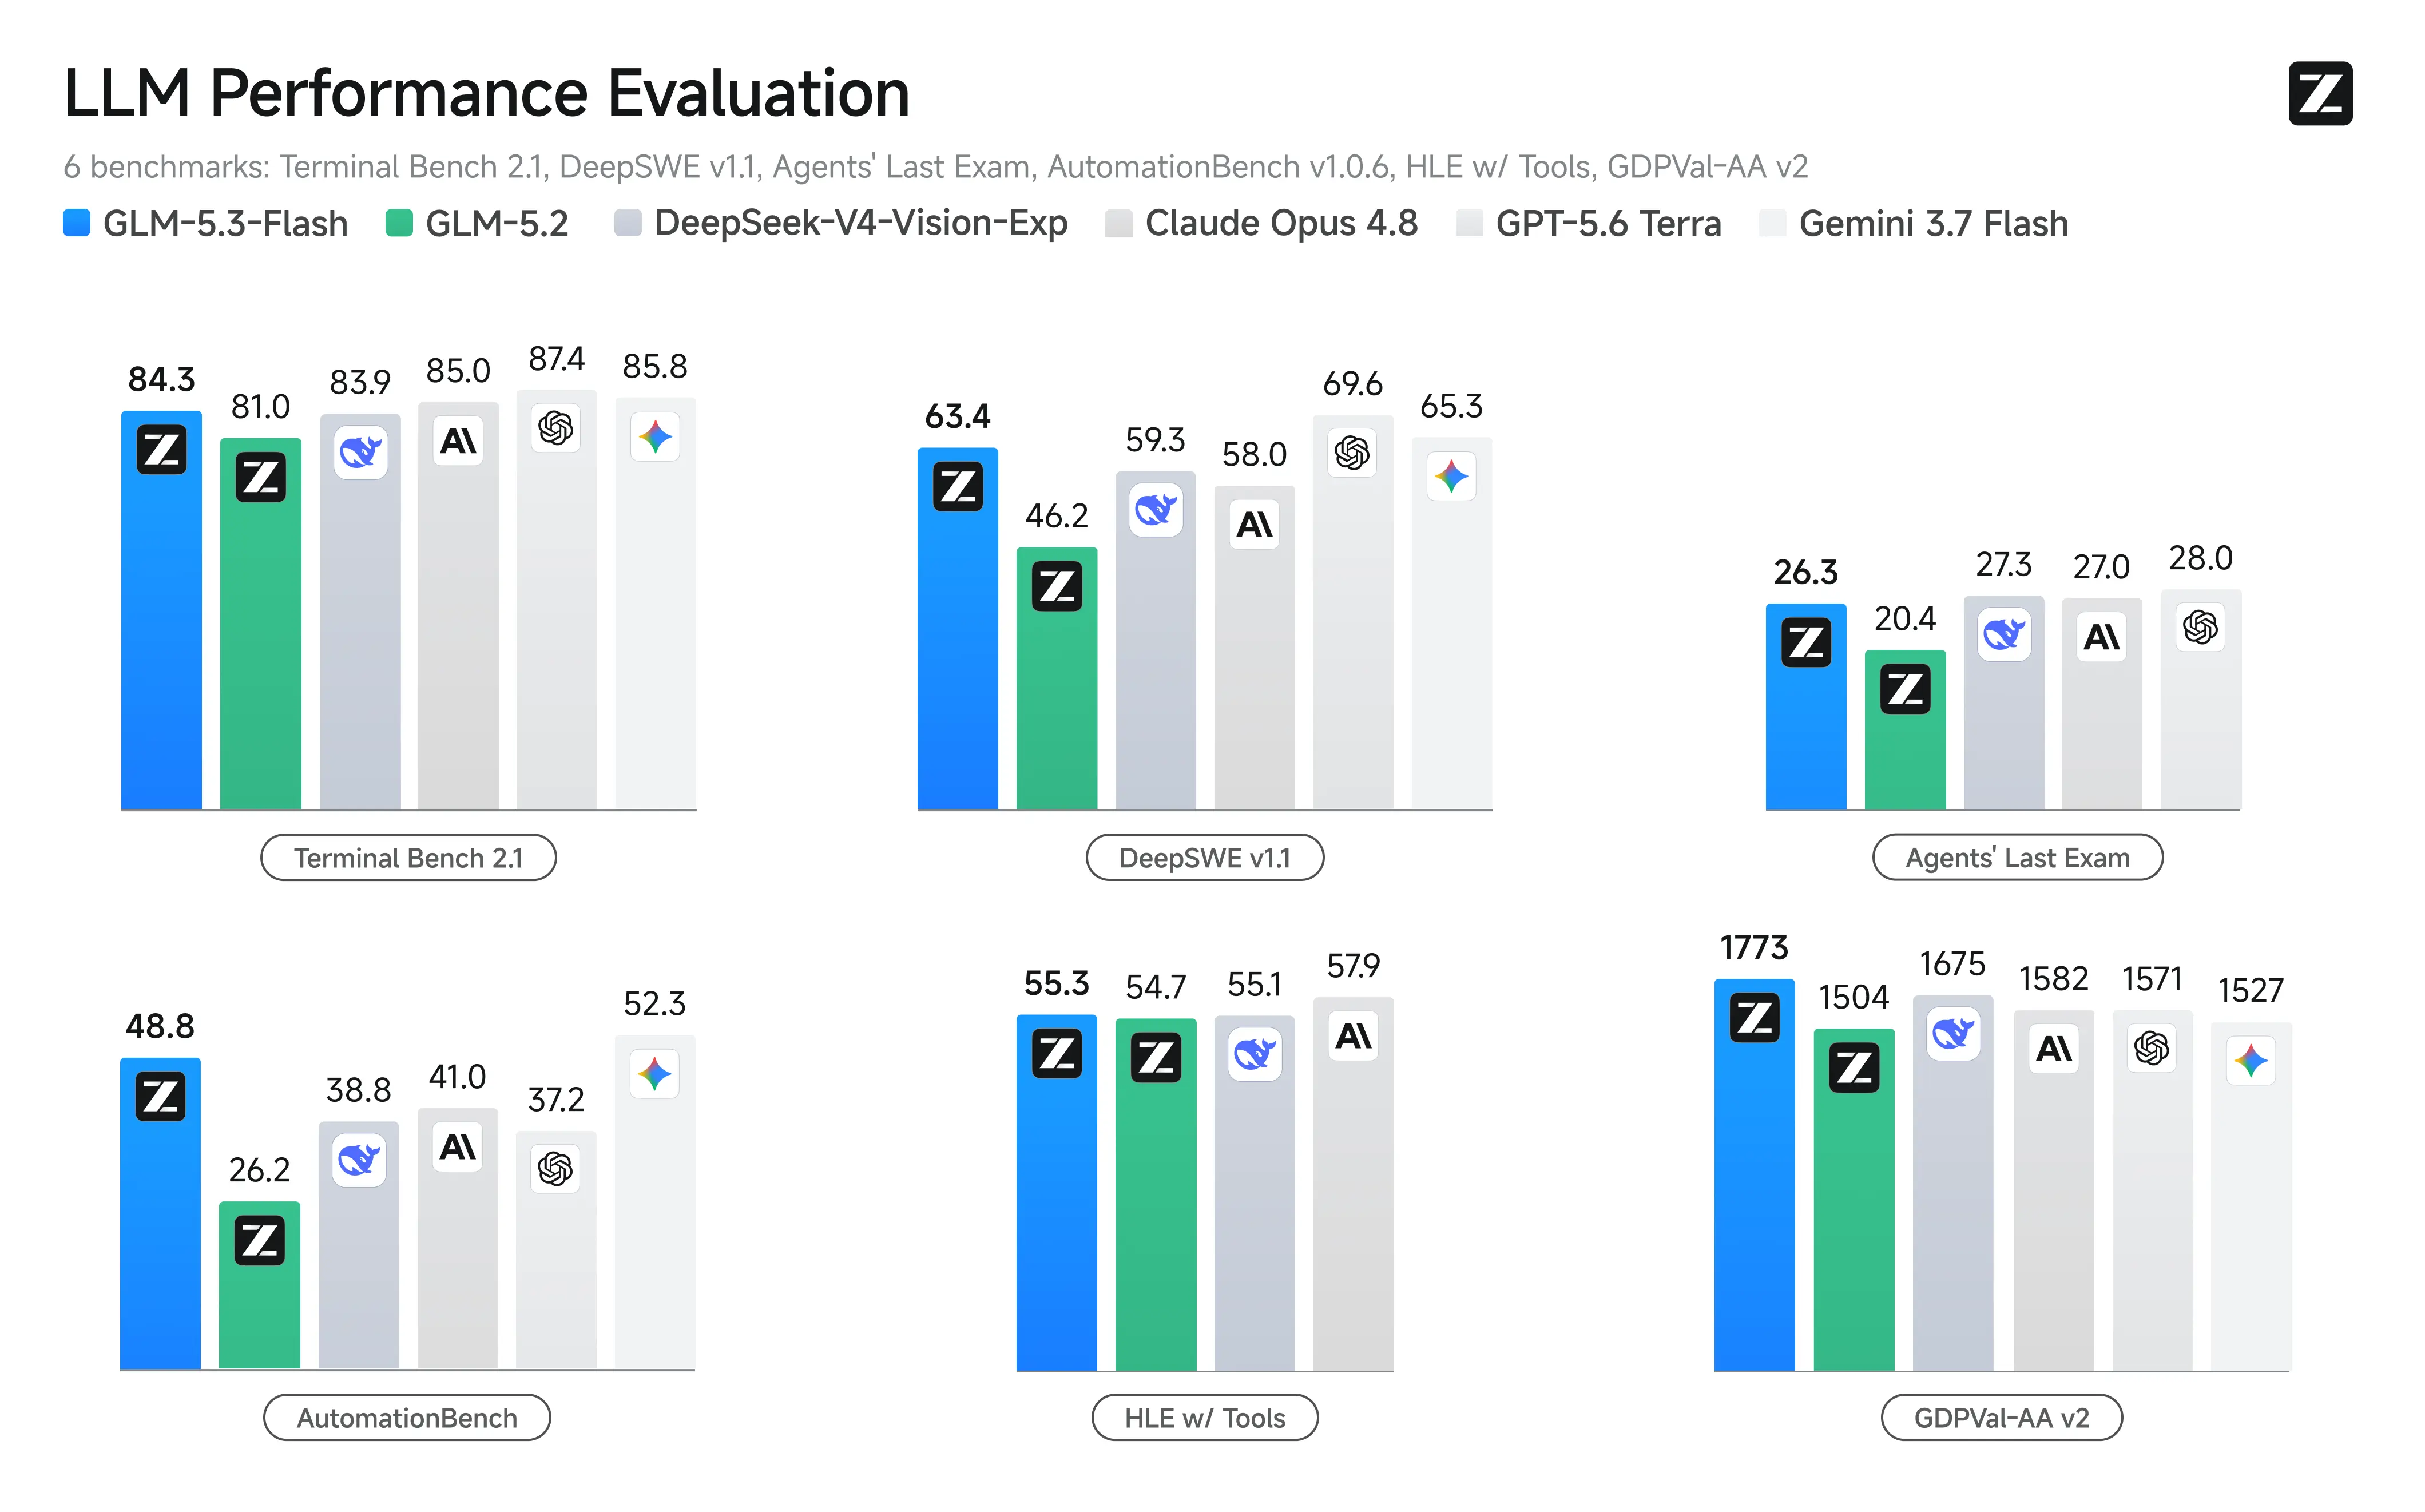
แหล่งที่มา: กราฟิกเบนช์มาร์กอย่างเป็นทางการของ Z.ai
กราฟิกอย่างเป็นทางการเปรียบเทียบประสิทธิภาพของ GLM-5.3 Flash ตามโมเดลและระดับ effort สำหรับคู่มือนี้ใช้เป็นบริบทสั้นๆ ไม่ได้ย้ำเมทริกซ์เปิดตัวทั้งหมด แอปยังควรวัดความสำเร็จของงาน เวลาแฝงปลายทาง และโทเคนรวมจากพรอมป์ตของตนเอง
ทำไมควรใช้ GLM-5.3 Flash ผ่าน CometAPI?
CometAPI เปิดให้ใช้ GLM-5.3 Flash ผ่านอินเทอร์เฟซที่เข้ากันได้กับ OpenAI ช่วยให้ทีมใช้รูปแบบ SDK ที่คุ้นเคย รวมศูนย์ข้อมูลยืนยันตัวตนและการเรียกเก็บเงิน และสลับโมเดลได้โดยไม่ต้องสร้างเลเยอร์คำขอใหม่ทั้งชุด
• รูปแบบการเชื่อมต่อเดียวกัน ไคลเอนต์ฐานเดียวเรียกโมเดลที่รองรับต่างๆ ได้ด้วยการเปลี่ยนรหัสโมเดล
• การมองเห็นการใช้งานแบบรวมศูนย์ ทีมตรวจสอบการใช้งานและต้นทุนได้โดยไม่ต้องดูแลแดชบอร์ดแยกสำหรับผู้ให้บริการทุกเจ้า
• ประเมินผลได้เร็ว ฮาร์เนสคำขอเดียวเปรียบเทียบคุณภาพคำตอบ เวลาแฝง และข้อผิดพลาดข้ามโมเดลที่เป็นตัวเลือกได้
• การออกแบบ fallback ที่ง่ายกว่า แอปเก็บลอจิกรีทรายและการกำหนดเส้นทางไว้ในเลเยอร์เกตเวย์เดียว
• ราคาต่อเส้นทางที่ระบุไว้ต่ำกว่า หน้ารายการโมเดลปัจจุบันแสดงราคา อินพุต $0.06 ต่อหนึ่งล้านโทเคน และ เอาต์พุต $0.20 ต่อหนึ่งล้านโทเคน โปรดยืนยันหน้าจริงก่อนทำงบประมาณ
ก่อนเริ่มต้น
คุณต้องมีบัญชี CometAPI, API key และหนึ่งในสภาพแวดล้อมต่อไปนี้ในเครื่อง:
• Python 3.9 ขึ้นไปพร้อม pip
• Node.js 18 ขึ้นไปพร้อม npm
• cURL สำหรับทดสอบบรรทัดคำสั่งแบบมินิมอล
ห้ามวาง CometAPI key สำหรับโปรดักชันไว้ใน JavaScript ฝั่งเบราว์เซอร์ แอปมือถือ รีโพสาธารณะ สกรีนช็อต หรือบันทึกฝั่งไคลเอนต์ เรียก CometAPI จากเซิร์ฟเวอร์ที่เชื่อถือได้และเก็บคีย์ไว้ในตัวแปรสภาพแวดล้อมหรือตัวจัดการความลับ
วิธีใช้ GLM-5.3 Flash API กับ CometAPI
ขั้นตอนที่ 1: สร้าง CometAPI API Key
ลงชื่อเข้าใช้ CometAPI เปิด คอนโซล API key สร้างคีย์ และคัดลอกครั้งเดียวไปยังเวิร์กโฟลว์จัดการความลับ ใช้คีย์แยกกันสำหรับ development และ production เพื่อหมุนหรือเพิกถอนสภาพแวดล้อมหนึ่งได้โดยไม่กระทบอีกอัน
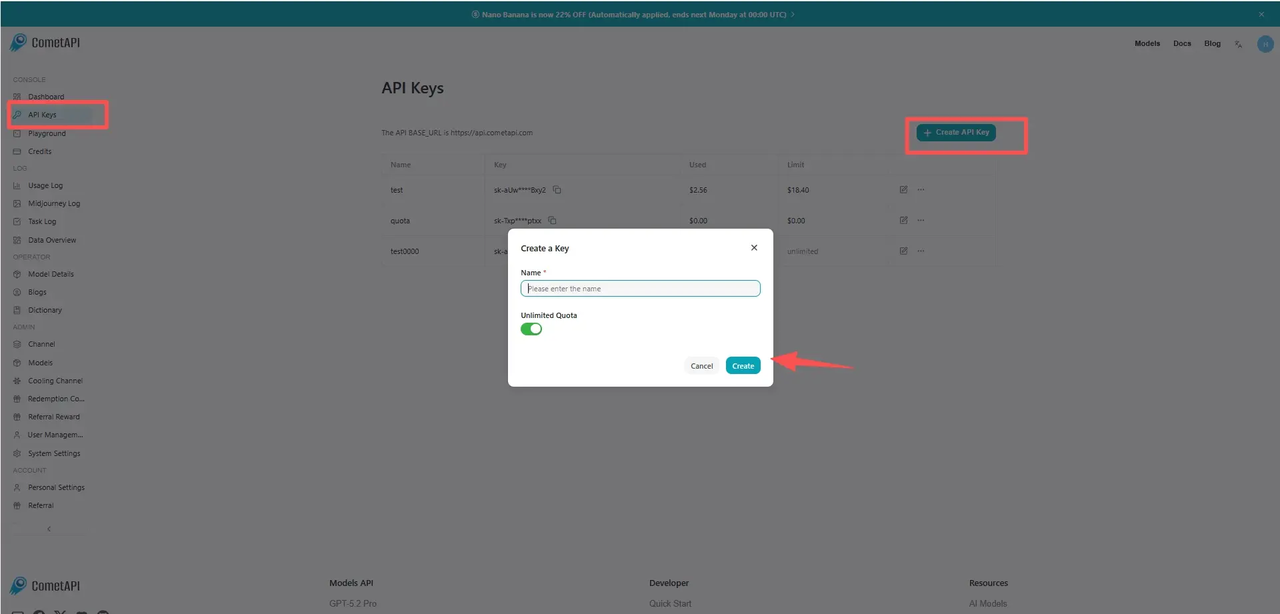
แหล่งที่มา: ภาพคู่มือ API key อย่างเป็นทางการของ CometAPI
ขั้นตอนที่ 2: เก็บคีย์เป็นตัวแปรสภาพแวดล้อม
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
สำหรับโปรดักชัน ให้แทนที่ประวัติในเชลล์ด้วยดีพลอยเมนต์ซีเคร็ต ซีเคร็ตในคอนเทนเนอร์ หรือวอลต์ที่มีการจัดการ

### ขั้นตอนที่ 3: ติดตั้ง SDK ที่รองรับ OpenAI
python -m pip install --upgrade openai
npm install openai
```

### ขั้นตอนที่ 4: ส่งคำขอแรกด้วย cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

คำตอบที่สำเร็จจะมีข้อความผู้ช่วยอยู่ใต้ choices[0].message.content พร้อมเมทาดาทา usage เมื่อเส้นทางส่งคืน เริ่มจากคำขอเล็กๆ นี้ก่อนที่จะเพิ่มพารามิเตอร์เสริม

### ขั้นตอนที่ 5: เรียก API จาก Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### ขั้นตอนที่ 6: เรียก API จาก JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## วิธีควบคุมระดับ Reasoning Effort

เอกสารโมเดลอย่างเป็นทางการรองรับระดับ reasoning effort แบบ [low, high, และ max](https://docs.z.ai/guides/vlm/glm-5.3-flash) โดย [thinking เปิดใช้งานตลอดเวลา](https://docs.z.ai/guides/vlm/glm-5.3-flash); การตั้งค่าคือการจำกัดงบประมาณ reasoning ที่โมเดลใช้ได้

| Effort | งานตั้งต้นที่เหมาะสม                         | สิ่งที่แลกเปลี่ยน                                   |
| ------ | --------------------------------------------- | ---------------------------------------------------- |
| low    | จัดหมวดหมู่ เขียนใหม่ สกัดข้อมูลสั้น         | เวลาแฝงต่ำลงและใช้เอาต์พุตโทเคนน้อย แต่ความลึกน้อย |
| high   | รีวิวโค้ด วางแผน วิเคราะห์เอกสาร             | สมดุล เหมาะเป็นค่าเริ่มต้นสำหรับงานโปรดักชัน       |
| max    | ดีบักยาก เอเจนต์ใช้เครื่องมือ เหตุผลยาก       | ความลึกสูงสุด อาจใช้เวลาและต้นทุนมากขึ้น            |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

หาก SDK ที่ติดตั้งรองรับ reasoning_effort เป็นอาร์กิวเมนต์โดยตรง ให้ส่งค่าได้เลย หากเส้นทาง CometAPI ปฏิเสธฟิลด์เฉพาะผู้ให้บริการ ให้ลบออกและใช้ค่าเริ่มต้นจากเส้นทาง อย่าพยายามปิด thinking

## วิธีสตรีมคำตอบ

สตรีมมิงเหมาะกับแชท ผู้ช่วยเขียนโค้ด และการวิเคราะห์ยาว เพราะแสดงผลได้ทันทีที่มาถึง แต่ไม่ได้ลดจำนวนโทเคนที่สร้าง ดังนั้นยังคงตั้งเพดานเอาต์พุตและควบคุมต้นทุนเช่นเดิม

### การสตรีมใน Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### การสตรีมใน JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• จัดการการยกเลิก หยุดอ่านสตรีมเมื่อไคลเอนต์ตัดการเชื่อมต่อ และยกเลิกงานต้นทางเมื่อรองรับ

• บัฟเฟอร์อย่างปลอดภัย อย่าคาดว่าทุกชิ้นส่วนจะเป็นคำเต็ม โทเคน JSON เต็ม หรืออ็อบเจ็กต์ tool-call ที่ครบถ้วน

• บันทึกการใช้งานสุดท้าย ข้อมูล usage อาจอยู่เฉพาะในอีเวนต์สุดท้ายหรือเมทาดาทาเฉพาะเส้นทาง

## วิธีส่งรูปภาพ

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) รับคอนเทนต์ภาพผ่านบล็อก image_url ใน messages[].content[] เอกสารอย่างเป็นทางการแนะนำ URL ของภาพที่เข้าถึงได้หรือ Base64 Data URL หน้ารายการโมเดลของ CometAPI แสดงความสามารถ image-to-text แต่แอปควรทดสอบฟอร์แมต ขนาดไฟล์ และพฤติกรรมเส้นทางก่อนใช้งานจริง

### วิเคราะห์ภาพจาก URL

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### ส่งภาพท้องถิ่นเป็น Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• ครอปช่องว่างที่ไม่จำเป็นก่อนเข้ารหัสภาพ

• ลดขนาดภาพที่ใหญ่เกินกว่าข้อมูลที่ต้องการตรวจ

• ถามคำถามเชิงภาพให้เฉพาะเจาะจงแทนการขอคำบรรยายทั่วไป

• อย่าคิดว่า URL หน้าเว็บสาธารณะคือ URL ภาพโดยตรง

• ทดสอบการเรียงลำดับหลายภาพ เพราะแต่ละภาพควรถูกอ้างอิงชัดเจนในพรอมป์ต

## วิธีขอผลลัพธ์ JSON แบบมีโครงสร้าง

เอาต์พุตแบบมีโครงสร้างมีค่าสำหรับส่วนถัดไปที่เป็นโค้ด มากกว่าคนอ่าน ใช้สคีมาที่แคบ ตรวจสอบความถูกต้อง และเตรียม fallback สำหรับเส้นทางที่อาจไม่รองรับ JSON Schema แบบเคร่งครัดในรูปแบบเดียวกัน

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

โหมด JSON ไม่ได้ตัดความจำเป็นในการตรวจสอบ ตรวจสอบฟิลด์บังคับ ชนิด ค่าอนุญาต และความยาวสูงสุดก่อนบันทึกผลหรือทริกเกอร์ระบบอื่น

## วิธีใช้ Function Calling

Function calling ช่วยให้โมเดลตัดสินใจเมื่อจำเป็นต้องใช้ข้อมูลภายนอก ขณะที่โค้ดแอปยังรับผิดชอบการยืนยันตัวตนและการรัน ขั้นตอนที่ปลอดภัยคือ: โมเดลเสนอการเรียกเครื่องมือ เซิร์ฟเวอร์ตรวจสอบ เซิร์ฟเวอร์ดำเนินการเครื่องมือ และโมเดลได้รับผลลัพธ์

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• ตรวจสอบอาร์กิวเมนต์ ปฏิบัติต่อ JSON ของ tool-call เป็นอินพุตที่ไม่น่าไว้วางใจ

• บังคับใช้อำนาจอนุญาต โมเดลไม่ได้ตัดสินใจว่าผู้ใช้ปัจจุบันมีสิทธิ์ทำอะไร

• แยกเครื่องมืออ่านและเขียน ต้องยืนยันสำหรับการกระทำที่ทำลายหรือมองเห็นภายนอก

• จำกัดคลังเครื่องมือ เปิดเฉพาะเครื่องมือที่เกี่ยวข้องกับเวิร์กโฟลว์ปัจจุบัน

• จำกัดลูป ตั้งจำนวนรอบเครื่องมือสูงสุด โทเคนรวม เวลา และต้นทุน

## พารามิเตอร์ API ของ [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| พารามิเตอร์             | วัตถุประสงค์                       | คำแนะนำเชิงปฏิบัติ                                   |
| ------------------------ | ------------------------------------ | ------------------------------------------------------ |
| model                    | เลือกเส้นทางโมเดล                   | ใช้ glm-5.3-flash                                      |
| messages                 | บทสนทนาและอินพุตมัลติโหมด          | รักษาลำดับ role ให้ถูก และคงข้อความเครื่องมือที่จำเป็น |
| max_completion_tokens    | จำกัดความยาวเอาต์พุตที่สร้าง       | ตั้งตามเวิร์กโฟลว์ แทนการพึ่งพาค่าสูงสุดของโมเดล      |
| temperature              | พฤติกรรมการสุ่มตัวอย่าง             | คำแนะนำอย่างเป็นทางการคือ 1                           |
| top_p                    | Nucleus sampling                     | คำแนะนำอย่างเป็นทางการคือ 0.95                        |
| reasoning_effort         | งบประมาณ reasoning                   | ใช้ low, high หรือ max; ควรทดสอบการรองรับของเส้นทาง   |
| stream                   | เอาต์พุตแบบไลฟ์                     | ใช้ true สำหรับคำตอบแบบโต้ตอบ                         |
| tools                    | คำนิยามฟังก์ชัน                      | ทำสคีมาให้แคบและตรวจสอบทุกการเรียก                    |
| tool_choice              | ควบคุมการเลือกเครื่องมือ            | เริ่มจาก auto เว้นแต่งานต้องใช้เครื่องมือแน่นอน       |
| response_format          | ขอเอาต์พุตที่อ่านได้โดยเครื่อง      | ตรวจสอบการรองรับและ JSON ที่ส่งกลับ                    |

## Z.ai Direct API เทียบกับ CometAPI

ทั้งสองเส้นทางอาจเหมาะ ขึ้นอยู่กับการถือครองการเชื่อมต่อ ความกว้างของโมเดล การเรียกเก็บเงิน และความเร็วที่ต้องการฟีเจอร์เนทีฟจากผู้ให้บริการ

| มิติ                | Z.ai Direct API                              | CometAPI                                              | ผลเชิงปฏิบัติ                                           |
| ------------------- | --------------------------------------------- | ----------------------------------------------------- | -------------------------------------------------------- |
| บัญชีและคีย์       | บัญชีและคีย์ของ Z.ai                         | บัญชีและคีย์ของ CometAPI                             | คีย์ใช้แทนกันไม่ได้                                      |
| รูปแบบ SDK         | เข้ากันได้กับ OpenAI                         | เข้ากันได้กับ OpenAI                                  | โค้ดไคลเอนต์จำนวนมากนำกลับมาใช้ได้                     |
| ความครอบคลุมโมเดล | ตระกูลโมเดลของ Z.ai                          | ผู้ให้บริการและตระกูลโมเดลหลายเจ้า                   | CometAPI มีประโยชน์สำหรับการกำหนดเส้นทางและเปรียบเทียบ |
| ฟีเจอร์เนทีฟ       | เข้าถึงฟิลด์/พารามิเตอร์เฉพาะผู้ให้บริการเร็วสุด | ขึ้นกับการเปิดเผย/ส่งผ่านของเกตเวย์                   | ทดสอบฟิลด์ขั้นสูงบนเส้นทางที่เลือก                     |
| การเรียกเก็บเงิน   | เฉพาะผู้ให้บริการ                            | รวมศูนย์ข้ามโมเดลที่รองรับ                           | บิลลิงรวมช่วยง่ายต่อการทำงานหลายโมเดล                   |
| การออกแบบ fallback | ต้องผสานผู้ให้บริการอื่นเพิ่ม                | อยู่ในเลเยอร์เกตเวย์เดียวได้                         | CometAPI ลดแรงเสียดทานในการสลับโมเดล                    |
| เหมาะที่สุดเมื่อ    | มุ่งใช้ความสามารถเนทีฟของ Z.ai อย่างลึกซึ้ง | ต้องการการเข้าถึงแบบรวมเดียว การประเมิน และการกำหนดเส้นทางโปรดักชัน | เลือกตามสถาปัตยกรรมระบบ ไม่ใช่คำตอบกลาง                 |

ใช้ API ตรงเมื่อพารามิเตอร์หรือฟีเจอร์เนทีฟล่าสุดจำเป็น ใช้ CometAPI เมื่อไคลเอนต์เดียว บิลลิงรวม และความสามารถในการเปรียบเทียบหรือสลับโมเดลสำคัญกว่า สำหรับโปรดักชัน ให้รันทดสอบตัวแทนแบบเดียวกับเส้นทางจริงที่คุณจะดีพลอย

## การประเมินต้นทุนและงบโทเคน

หน้ารายการโมเดลของ CometAPI ปัจจุบันแสดงราคา [อินพุต $0.06 ต่อหนึ่งล้านโทเคน](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) และ [เอาต์พุต $0.20 ต่อหนึ่งล้านโทเคน](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) ที่อัตรานี้ ต้นทุนคำขอโดยประมาณคือ:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| ภาระงาน                 | โทเคนอินพุต | โทเคนเอาต์พุต | ต้นทุนประมาณการ |
| ----------------------- | ------------ | -------------- | ---------------- |
| คำถามสั้น               | 2,000        | 400            | $0.00020         |
| รีวิวโค้ด               | 50,000       | 4,000          | $0.00380         |
| วิเคราะห์เอกสารใหญ่     | 250,000      | 10,000         | $0.01700         |
| เอเจนต์รันยาว           | 800,000      | 30,000         | $0.05400         |

ราคาไวต่อเวลา โปรดยืนยันอัตราอินพุต อินพุตที่แคช และเอาต์พุตสดๆ ก่อนเผยแพร่หรือทำงบ Reasoning และลูปเครื่องมืออาจเพิ่มเอาต์พุตที่คิดเงินและอินพุตที่อ่านซ้ำ ดังนั้นควรประเมินทั้งเวิร์กโฟลว์ ไม่ใช่เฉพาะคำตอบที่เห็น

## แนวทางปฏิบัติที่ดีสำหรับโปรดักชันของ GLM-5.3 Flash API

### ควบคุมต้นทุนและเวลาแฝง

#### เพดานเอาต์พุต

การตั้งค่าระหว่างเบนช์มาร์กกับโปรดักชันต่างกัน การประเมิน HLE ที่อ้างถึงใช้ความยาวสูงสุด 163,840 โทเคน ขณะที่บางการประเมินใช้เอาต์พุต 64K; ทั้งสองไม่พิสูจน์ว่าเส้นทางโฮสต์ทุกเส้นคืนได้เกิน 100,000 โทเคน ตั้งเพดานจากสคีมาของเส้นทางจริงและงบประมาณงาน ตั้งเล็กสำหรับจัดหมวด/สกัดข้อมูล ตั้งกลางสำหรับการวิเคราะห์ และใหญ่เฉพาะเมื่อจำเป็นต่อข้อความยาวหรือเอเจนต์

**ควบคุมบริบท**

หน้าต่างหนึ่งล้านโทเคนคือความจุ ไม่ใช่เป้าหมาย ดึงไฟล์ที่เกี่ยวข้อง ลบล็อกซ้ำ วางคำสั่งคงที่ไว้ต้นๆ และวัดว่าบริบทเพิ่มช่วยให้งานสำเร็จขึ้นจริงหรือไม่

### สถานะและความเชื่อถือได้

#### เก็บสถานะ

เก็บข้อความผู้ช่วยครบถ้วนสำหรับรอบถัดไป รวมถึงการเรียกเครื่องมือและฟิลด์เฉพาะเส้นทางที่แอปคุณตรวจแล้ว การทิ้งประวัติโครงสร้างอาจทำให้ลูปเครื่องมือหลายขั้นพังได้ แม้ข้อความที่เห็นจะดูครบ

#### รีทรายแบบเลือกสรร

• รีทรายข้อผิดพลาดชั่วคราว 429, 500, 502, 503 และหมดเวลาเครือข่ายด้วย backoff แบบเอ็กซ์โปเนนเชียลและ jitter

• อย่ารีทรายแบบไม่ลืมหูลืมตากับข้อผิดพลาดยืนยันตัวตน พารามิเตอร์ไม่ถูก หรือคำขอใหญ่เกิน

• แนบ application request ID เพื่อแยกงานซ้ำ

• ใช้การควบคุม idempotency รอบปฏิบัติการเขียนภายนอก แม้คำขอโมเดลเองจะถูกรีทราย

### ความปลอดภัยและการตรวจสอบ

#### ตรวจเอาต์พุตที่อ่านได้โดยเครื่อง

การตรวจสคีมา ค่าที่อนุญาต ขีดจำกัดความยาว และกฎโดเมนควรอยู่ระหว่างโมเดลกับทุกฐานข้อมูล คิว หรือ API ภายนอก อ็อบเจ็กต์ JSON ที่ถูกไวยากรณ์ยังอาจไม่ครบหรือไม่ปลอดภัย

#### อนุญาตการเรียกเครื่องมือ

ปฏิบัติต่อการเรียกเครื่องมือที่โมเดลเสนอเป็นคำขอที่ไม่น่าไว้วางใจ: ตรวจอาร์กิวเมนต์ บังคับสิทธิ์ผู้ใช้ แยกอ่าน/เขียน และต้องยืนยันสำหรับการกระทำที่ทำลาย

### การสังเกตการณ์และ Fallback

#### วัดเวิร์กโฟลว์

• ความสำเร็จของงานหรืออัตราการยอมรับโดยมนุษย์

• เวลาเริ่มโทเคนแรกและเวลาแฝงรวม

• โทเคนอินพุต อินพุตที่แคช Reasoning และเอาต์พุต

• จำนวนการเรียกเครื่องมือและอัตราล้มเหลว

• การรีทราย ขีดจำกัดอัตรา และข้อผิดพลาดผู้ให้บริการ

• ต้นทุนต่อเวิร์กโฟลว์ที่เสร็จสิ้น ไม่ใช่แค่ต้นทุนต่อการเรียก API เท่านั้น

#### ออกแบบ fallback

เลือก fallback ตามภาระงาน ไม่ใช่ชื่อเสียง Fallback แบบข้อความอย่างเดียวอาจพอสำหรับการสกัดเอกสารแต่ล้มเหลวกับงานที่ใช้สกรีนช็อต กำหนดว่าคอนเทนต์อินพุตและสคีมาเครื่องมือใดพกพาได้ พารามิเตอร์ใดต้องลบ และเมื่อใดควรแสดงข้อผิดพลาดที่กู้คืนได้แทนการสลับโมเดลอัตโนมัติ

## ข้อผิดพลาดทั่วไปและการแก้ปัญหา

| อาการ                   | สาเหตุที่เป็นไปได้                                           | สิ่งที่ควรตรวจ                                                             |
| ----------------------- | -------------------------------------------------------------- | -------------------------------------------------------------------------- |
| 401 Unauthorized        | คีย์หาย ผิดรูปแบบ หรือถูกเพิกถอน                             | ตรวจส่วนหัว Authorization และตัวแปรสภาพแวดล้อมฝั่งเซิร์ฟเวอร์           |
| 404 หรือไม่พบโมเดล     | รหัสโมเดลผิดหรือเส้นทางไม่พร้อมใช้งาน                        | ใช้ glm-5.3-flash และยืนยันบนหน้ารายการโมเดลจริง                         |
| 429 Rate Limit          | เกินโควต้าคำขอหรือโทเคน                                      | ลดความถี่ ลดคอนเคอร์เรนซี ตรวจขีดจำกัดบัญชี และรีทรายพร้อม jitter       |
| Unsupported parameter   | ฟิลด์เนทีฟของผู้ให้บริการไม่ถูกเปิดเผยโดยเกตเวย์            | ลบฟิลด์เสริม แล้วค่อยๆ เพิ่มกลับทีละรายการ                               |
| Context length exceeded | พรอมป์ตรวมเอาต์พุตที่ร้องขอเกินขีดจำกัดเส้นทาง              | ตัด แตกรับข้อมูล สรุป หรือปรับลด max_completion_tokens                    |
| Invalid image           | URL เข้าถึงไม่ได้ ฟอร์แมตไม่รองรับ หรือ Base64 ไม่ถูกต้อง    | ทดสอบ URL ของภาพแบบ HTTPS โดยตรงและแก้ MIME prefix                        |
| Broken streamed JSON    | พาร์สชิ้นส่วนเป็นอ็อบเจ็กต์ที่สมบูรณ์เกินไป                  | บัฟเฟอร์สตรีม และพาร์สเมื่อได้เพย์โหลด JSON ครบถ้วนเท่านั้น              |
| Tool loop never ends    | ไม่มีเพดานรอบหรือผลลัพธ์เครื่องมือกำกวม                      | จำกัดจำนวนรอบ ปรับคำอธิบายเครื่องมือ และคืนข้อผิดพลาดเครื่องมือให้ชัด   |

## ควรใช้ GLM-5.3 Flash API เมื่อใด?

### เหมาะเมื่อ

• เข้าใจโค้ดระดับรีโพและรีวิวหลายไฟล์

• โค้ดจากภาพ วิเคราะห์สกรีนช็อต และ QA อินเทอร์เฟซ

• ชุดเอกสารยาวและสังเคราะห์พร้อมหลักฐานอ้างอิง

• เอเจนต์ใช้เครื่องมือที่มีการวางแผนและตรวจสอบซ้ำ

• เวิร์กโฟลว์ปริมาณสูงที่ต้นทุนโทเคนมีผลต่อยูนิตอีโคโนมิกส์

• แอปที่ได้ประโยชน์จากการสลับหรือเปรียบเทียบโมเดลผ่านเกตเวย์เดียว

### ควรใช้เส้นทางหรือโมเดลอื่นเมื่อ

• ผลิตภัณฑ์ต้องการเอาต์พุตเป็นภาพหรือวิดีโอ ไม่ใช่ข้อความ

• งานเป็นการจัดหมวดเล็กๆ ความเสี่ยงต่ำที่โมเดลขนาดเล็กทำได้ดี

• ฟีเจอร์เนทีฟของผู้ให้บริการจำเป็นแต่เส้นทางเกตเวย์ไม่เปิดเผย

• เวิร์กโฟลว์ทนต่อ thinking ที่เปิดตลอดเวลาและเวลาแฝงที่เกี่ยวข้องไม่ได้

• แอปยังไม่ทดสอบโมเดลกับเครื่องมือ ข้อมูล และกรณีล้มเหลวของตนเอง

## คำถามที่พบบ่อย

###

### ควรยืนยันอะไรบนเส้นทาง CometAPI ที่จะใช้จริงก่อนเปิดตัว?

ยืนยันความพร้อมของโมเดล ฟอร์แมตมัลติโหมดที่ยอมรับ เอาต์พุตสูงสุด ฟิลด์ reasoning พฤติกรรมเอาต์พุตแบบมีโครงสร้าง ขีดจำกัดอัตรา และราคา ณ ปัจจุบันด้วยคำขอที่เป็นตัวแทนจริง

### โปรดักชันทดสอบควรติดตามเมตริกใด?

ติดตามความสำเร็จของงาน เวลาโทเคนแรก เวลาแฝงรวม โทเคนอินพุตและเอาต์พุต ความล้มเหลวของการเรียกเครื่องมือ อัตรารีทราย และต้นทุนต่อเวิร์กโฟลว์ที่เสร็จสิ้น ไม่ใช่แค่ต้นทุนต่อการเรียก API

### จะเลือกใช้ระหว่าง Z.ai direct และ CometAPI อย่างไร?

ใช้ Z.ai direct เมื่อจำเป็นต้องเข้าถึงพฤติกรรมเนทีฟของผู้ให้บริการทันที ใช้ CometAPI เมื่อการยืนยันตัวตนแบบรวม บิลลิง การเปรียบเทียบโมเดล และ fallback ระดับเกตเวย์สำคัญกว่า

### อะไรทำให้ fallback ปลอดภัย?

Fallback ที่ปลอดภัยยอมรับโมดาลิตี้อินพุตเดียวกัน คงสคีมาเครื่องมือที่จำเป็น ลบพารามิเตอร์ที่ไม่รองรับ อยู่ภายในขอบเขตการอนุญาตของงาน และล้มเหลวแบบเห็นได้เมื่อไม่สามารถคงพฤติกรรมเดิม

## บทสรุป

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) มีประโยชน์ที่สุดผ่าน API เมื่อบริบทยาว อินพุตภาพ Reasoning และการใช้เครื่องมืออยู่ในเวิร์กโฟลว์เดียวกัน การเชื่อมต่อพื้นฐานกับ CometAPI มีขนาดเล็ก: คีย์ฝั่งเซิร์ฟเวอร์หนึ่งตัว ไคลเอนต์ที่รองรับ OpenAI หนึ่งตัว รหัสโมเดล [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) และปลายทาง chat-completions คุณภาพโปรดักชันมาจากทุกอย่างรอบๆ คำขอนั้น: พรอมป์ตที่พอดี เพดานเอาต์พุต การตรวจสคีมา การอนุญาตเครื่องมือ รีทราย การสังเกตการณ์ และการประเมินเฉพาะเวิร์กโหลด

เริ่มจากการเรียกข้อความสั้น เพิ่มความสามารถขั้นสูงทีละรายการ และทดสอบเส้นทางผู้ใช้ครบถ้วนก่อนขยาย ตรวจสอบหน้าโมเดล [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) สดๆ สำหรับความพร้อมใช้งาน พฤติกรรมเส้นทางที่รองรับ และราคา

## เมตาดาทา SEO

ชื่อเมตา: How to Use GLM-5.3 Flash API: Developer Guide

คำอธิบายเมตา: เรียนรู้วิธีใช้ GLM-5.3 Flash API กับ CometAPI พร้อมตัวอย่าง Python และ JavaScript, การมองภาพ, สตรีมมิง, tools, เอาต์พุต JSON และแนวทางปฏิบัติที่ดีที่สุด

คีย์เวิร์ด: GLM-5.3 Flash API, how to use GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API tutorial, multimodal API, reasoning API, function calling

URL slug: how-to-use-glm-5-3-flash-api