Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog MiMo-V2.5 vs MiMo-V2.5-Pro รุ่นไหนของ Xiaomi ดีกว่ากัน ai-comparisons / งานวิจัย CometAPI
MiMo-V2.5 vs MiMo-V2.5-Pro รุ่นไหนของ Xiaomi ดีกว่ากัน การเปรียบเทียบ MiMo V2.5, Xiaomi MiMo, เบนช์มาร์กของ MiMo Pro, ราคา MiMo API, โมเดล AI แบบมัลติโมดัล, โมเดลเอเจนต์สำหรับการเขียนโค้ด, โมเดลที่มีบริบท 1M
Deon Goodwin ทีมวิจัยโมเดล AI และ API การเปรียบเทียบ MiMo V2.5, Xiaomi MiMo, เบนช์มาร์กของ MiMo Pro, ราคา MiMo API, โมเดล AI แบบมัลติโมดัล, โมเดลเอเจนต์สำหรับการเขียนโค้ด, โมเดลที่มีบริบท 1M
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)สรุปสั้นๆ
MiMo-V2.5 คือค่าตั้งต้นที่แข็งแรงสำหรับงานมัลติโมดัล เอเจนต์งานประจำ และโปรดักชันที่ใส่ใจต้นทุน ส่วน MiMo-V2.5-Pro คือทางเลือกเชิงผู้เชี่ยวชาญสำหรับการให้เหตุผลที่ยาก การโค้ดระดับคลังซอร์ส และการใช้เครื่องมือแบบยาวนาน ทั้งสองรุ่นมีหน้าต่างบริบท 1M โทเคนและเอาต์พุตได้สูงสุด 128K โทเคน แต่ Pro ใช้แกนภาษาที่ใหญ่กว่ามากและมีค่าใช้จ่ายต่อโทเคนอินพุต/เอาต์พุตทั่วไปประมาณ 3.1×
MiMo-V2.5 เทียบกับ Pro: ตัดสินใจเร็ว
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
การวางตำแหน่งหลัก โมเดลมัลติโมดัลและเอเจนต์ประสิทธิภาพสูง เอเจนต์เรือธงและการโค้ดที่ซับซ้อน เลือกตามลักษณะงาน อินพุตมัลติโมดัลเหมาะกับ V2.5; งานข้อความยากๆ ต่อเนื่องเหมาะกับ Pro สถาปัตยกรรม MoE แบบ sparse MoE แบบ sparse เลือกตามลักษณะงาน ขนาดโมเดลอย่างเดียวไม่ได้ตัดสินว่าดีกว่าสำหรับทุกงาน จำนวนพารามิเตอร์ทั้งหมด 310B 1.02T เลือกตามลักษณะงาน โมเดลที่ใหญ่กว่ามุ่งเป้าที่การให้เหตุผลที่ยาก แต่ขนาดรวมไม่เท่ากับผลลัพธ์ของงาน พารามิเตอร์ที่ทำงาน 15B 42B เลือกตามลักษณะงาน ใช้ความสำเร็จของงานและต้นทุนในการตัดสินใจ ชั้น LLM 48 70 เลือกตามลักษณะงาน จำนวนเลเยอร์อธิบายสถาปัตยกรรม ไม่ใช่ชัยชนะสากล ผู้เชี่ยวชาญที่ถูกกำหนดเส้นทาง 256 384 เลือกตามลักษณะงาน ความต่างนี้สำคัญก็ต่อเมื่อช่วยผลงานที่เป็นเป้าหมายให้ดีขึ้น จำนวนผู้เชี่ยวชาญที่ทำงานต่อโทเคน 8 8 ได้ทั้งสอง ทั้งสองเปิดใช้ผู้เชี่ยวชาญ 8 รายต่อโทเคน หน้าต่างบริบท 1M โทเคน 1M โทเคน ได้ทั้งสอง ทั้งคู่โฆษณาหน้าต่าง 1M โทเคน; ทดสอบการเรียกคืนเชิงประสิทธิผลจริง ผลลัพธ์สูงสุด 128K โทเคน 128K โทเคน ได้ทั้งสอง ทั้งคู่โฆษณาเอาต์พุตสูงสุด 128K โทเคน รูปแบบอินพุต ข้อความ ภาพ วิดีโอ และเสียง ข้อความ MiMo-V2.5 รองรับอินพุตภาพ วิดีโอ และเสียงโดยตรง; Pro มุ่งที่อินพุตข้อความ การเรียกใช้เครื่องมือ มี มี เลือกตามลักษณะงาน ทั้งคู่เรียกใช้เครื่องมือได้; ทดสอบอัตราความสำเร็จบนทราเจกทอรีจริง weights แบบเปิดและไลเซนส์ มี; MIT มี; MIT ได้ทั้งสอง ทั้งคู่เปิด weights ภายใต้ MIT; ต้นทุนการให้บริการต่างกัน
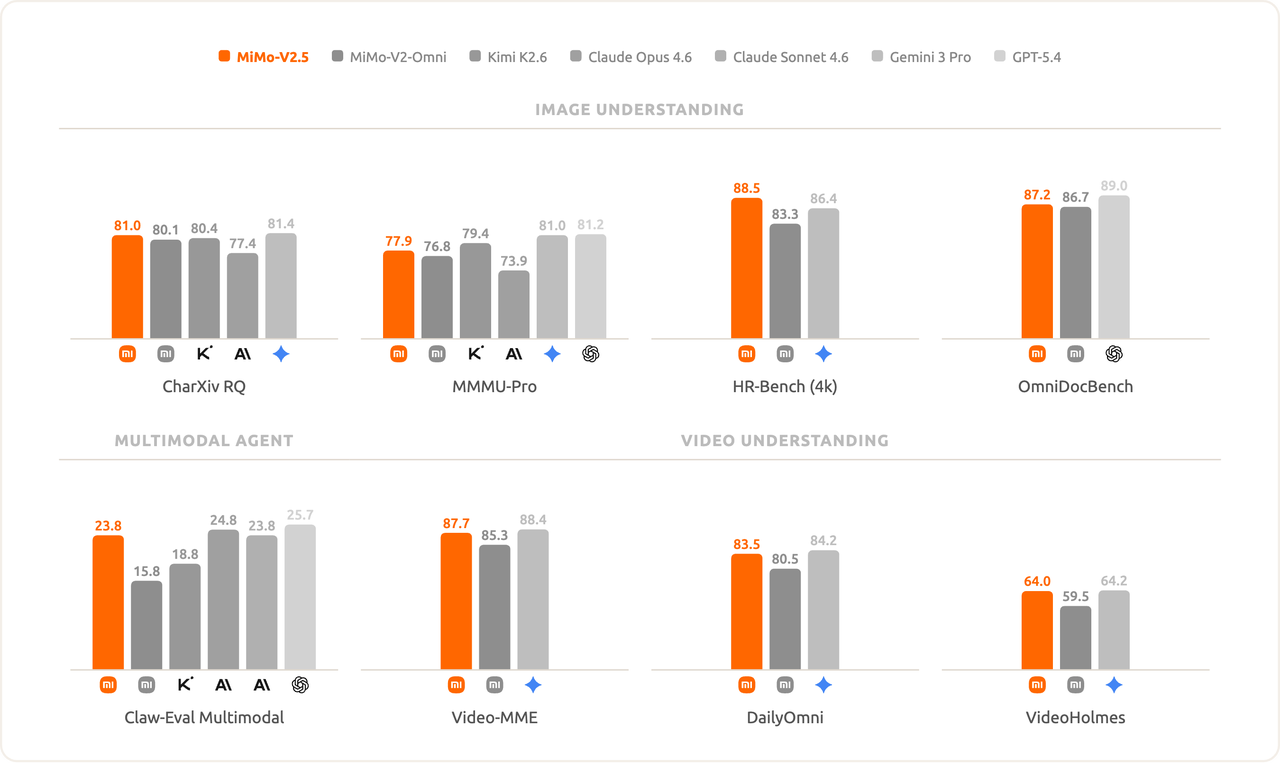
ความแตกต่างชี้ขาด: มัลติโมดัลเทียบกับแนวทางที่เน้นเอเจนต์ก่อน V2.5 รองรับ ข้อความ ภาพ วิดีโอ และเสียง โดยกำเนิด Xiaomi จับคู่แกนภาษากับตัวเข้ารหัสภาพขนาด 729M พารามิเตอร์ และตัวเข้ารหัสเสียงขนาด 261M พารามิเตอร์ ทำให้ข้อมูลมัลติโมดัลเข้าร่วมเวิร์กโฟลว์การให้เหตุผลเดียวกันได้โดยตรง
วิเคราะห์ภาพหน้าจอก่อนเรียกใช้เครื่องมือ
ทำความเข้าใจวิดีโอและแทร็กเสียงร่วมกัน
ดึงข้อมูลจากไดอะแกรมและภาพเอกสาร
ใช้งานเอเจนต์ที่มีส่วนติดต่อแบบภาพและรองรับมัลติโมดัล
ใช้เหตุผลกับลำดับวิดีโอยาว
V2.5-Pro ใช้การออกแบบที่แตกต่าง ตอนนี้ Xiaomi ระบุว่า อินพุตเป็นข้อความ และเน้นการให้เหตุผลเชิงลึก การพัฒนาโค้ด และการประสานเครื่องมือที่ทำงานยาวนาน
หากเวิร์กโฟลว์มีอินพุตภาพ วิดีโอ หรือเสียง ให้เริ่มด้วย V2.5 ทดสอบ Pro เมื่อส่วนที่ยากคือการให้เหตุผลบนข้อความ ซอร์สโค้ด เครื่องมือ หรือทราเจกทอรียาวของเอเจนต์
การเปรียบเทียบเบนช์มาร์กมัลติโมดัลอย่างเป็นทางการของ Xiaomi
เหตุใด V2.5-Pro จึงดีกว่าในงานยาก
สเกลโมเดล: 310B/15B เทียบกับ 1.02T/42B ทั้งสองใช้แบ็กโบนแบบ Mixture-of-Experts ที่เป็น sparse ใช้ attention แบบผสมผสานระหว่างหน้าต่างเลื่อนและ global และมีโมดูล Multi-Token Prediction สามชั้น การ์ดโมเดลของ V2.5 ระบุแบ็กโบน 310B ทั้งหมด เปิดใช้ 15B ส่วน การ์ดโมเดล Pro ขยายเป็นพารามิเตอร์รวม 1.02T และเปิดใช้ 42B ต่อโทเคน
พารามิเตอร์ทั้งหมด 310B 1.02T ประมาณ 3.3× พารามิเตอร์ที่ทำงาน 15B 42B 2.8× ขนาดแฝง 4,096 6,144 1.5× ชั้น LLM 48 70 มากกว่า 22 ชั้น จำนวนหัว attention 64 128 2× ผู้เชี่ยวชาญที่ถูกกำหนดเส้นทาง 256 384 1.5× ผู้เชี่ยวชาญต่อโทเคน 8 8 เท่ากัน ชั้น MTP 3 3 เท่ากัน
V2.5 ใช้ รูปแบบ attention 5:1 ขณะที่ Pro ขยับเป็นอัตราส่วน local-to-global 6:1 Xiaomi ระบุว่าการออกแบบเหล่านี้ลดความต้องการ KV-cache ได้เกือบ 6× และ 7× ตามลำดับ เมื่อเทียบกับการใช้ full attention ตลอดเครือข่าย
จำนวนพารามิเตอร์ไม่ได้แปรเชิงเส้นเป็นคุณภาพคำตอบ แบ็กโบนที่ใหญ่กว่าของ Pro สำคัญที่สุดเมื่อความยากของการให้เหตุผลหรือความยาวทราเจกทอรีทำให้ความน่าเชื่อถือรายสเต็ปที่เพิ่มขึ้นเล็กน้อยสะสมทบกัน
เหตุใดกำไรด้านความน่าเชื่อถือเพียงเล็กน้อยจึงสะสมทบกัน งานเอเจนต์ที่ยาวมีหลายสเต็ปที่พึ่งพากัน ข้อผิดพลาดในคำสั่งเรียกเครื่องมือช่วงต้นอาจบังคับให้รีทรายหรือทำให้งานช่วงหลังเสียหาย ดังนั้นกำไรความน่าเชื่อถือรายสเต็ปเล็กน้อยอาจส่งผลใหญ่ต่อการสำเร็จปลายทาง ประเมินผลนั้นกับงานตัวแทน แทนการสมมุติว่าขนาดโมเดลรับประกันผล
Pro ช่วยดีขึ้นจริงที่ไหน? ตัวเปรียบเทียบที่เป็นตัวเลขสะอาดที่สุดคือการประเมินโมเดลฐานของ Xiaomi ที่ทั้งสองปรากฏภายใต้การตั้งค่าเดียวกัน เพื่อหลีกเลี่ยงการผสมผลลัพธ์จากฮาร์เนสหรือการตั้งค่าหลังการฝึกที่ไม่เกี่ยวข้องกัน
ความรู้ทั่วไป: ดีขึ้นเล็กถึงปานกลาง ในการเปรียบเทียบโมเดลฐาน Pro ได้เพิ่ม 1.2 คะแนนบน BBH, 3.1 บน MMLU และ 2.7 บน MMLU-Pro ถือว่าวัดได้ แต่เล็กกว่าบนงานให้เหตุผลที่ยาก
คณิตศาสตร์และวิทยาศาสตร์: เพิ่มขึ้นมากกว่า Pro เพิ่ม 8.6 คะแนนบน GPQA-Diamond, 16.3 บน GSM8K และ 18.5 บน MATH ในการประเมินโมเดลฐานเดียวกัน นี่คือหลักฐานที่ชัดเจนที่สุดในการเลือก Pro เมื่อความยากด้านการให้เหตุผลขับเคลื่อนความสำเร็จของงาน
การเขียนโค้ด: ดีขึ้น แต่ไม่ดีขึ้นอย่างสม่ำเสมอ ผลเพิ่มที่รายงานคือ 4.3 คะแนนบน HumanEval+, 3.2 บน MBPP+, 4.1 บน LiveCodeBench v6 และ 4.9 บน SWE-Bench AgentLess ทดสอบงานระดับคลังซอร์สและการใช้เครื่องมือแยกกัน: คะแนนโมเดลฐานเหล่านี้ไม่ได้วัดเวิร์กโฟลว์เอเจนต์โปรดักชันทุกแบบ
ผลเบนช์มาร์ก: Pro ไม่ได้ดีขึ้นสามเท่าเพียงเพราะมีราคาแพงกว่าประมาณสามเท่า มันจะมีคุณค่ามากขึ้นเรื่อยๆ ตามความยากของการให้เหตุผลและระยะเวลางานที่เพิ่มขึ้น
แถวเหล่านี้คือการประเมินโมเดลฐาน ไม่ใช่คำสัญญาว่า API โปรดักชันจะทำคะแนนเดียวกัน ผลเอเจนต์ขึ้นกับเครื่องมือ พรอมต์ รีทราย สภาพแวดล้อมรัน และงบโทเคน
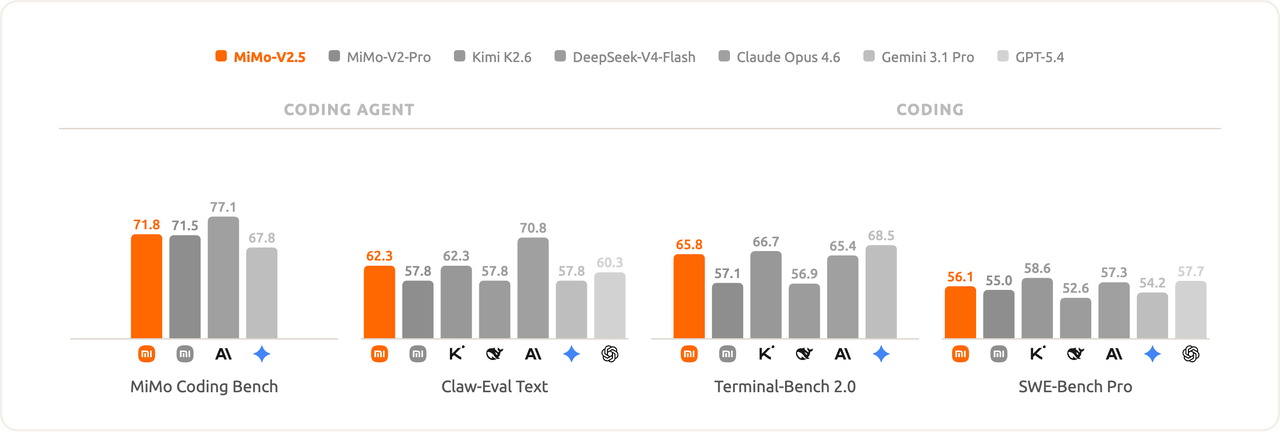
หลังการฝึกและเอเจนต์ระยะยาว รุ่นโปรดักชันเพิ่ม supervised fine-tuning, agentic reinforcement learning และ Multi-Teacher On-Policy Distillation Xiaomi รายงาน คะแนนหลังการฝึก ที่ 56.1 บน SWE-bench Pro, 65.8 บน Terminal-Bench 2.0 และ 62.1 Pass³ บนส่วนทั่วไปของ Claw-Eval สำหรับ V2.5
Pro ถูกปรับให้เหมาะชัดเจนยิ่งขึ้นสำหรับวิศวกรรมซอฟต์แวร์ระยะยาว Xiaomi อธิบาย การเรียกเครื่องมือหลายร้อยครั้ง ในทราเจกทอรีที่ยาว และเผยแพร่ผล 78.9% บน SWE-bench Verified
กรณีศึกษาทางการหนึ่งแสดงให้เห็นว่า Pro สร้างคอมไพเลอร์ SysY เสร็จใน 4.3 ชั่วโมง ด้วยการเรียกเครื่องมือ 672 ครั้ง และผ่านการทดสอบทั้ง 233 รายการ บทเรียนไม่ใช่ว่าทุกคำขอโค้ดต้องใช้ Pro; แต่คือความต่างความน่าเชื่อถือเล็กน้อยสามารถตัดสินว่าเวิร์กโฟลว์ที่มีการพึ่งพาหลายร้อยขั้นจะเสร็จหรือไม่
รูปเบนช์มาร์กการโค้ดและเอเจนต์อย่างเป็นทางการของ Xiaomi
บริบทยาว: ความจุเท่ากัน แต่งานต่างกัน ทั้งสองรุ่นมี หน้าต่างบริบท 1M โทเคน และเอาต์พุตได้สูงสุด 128K โทเคนผ่าน API ปัจจุบันของ Xiaomi ดังนั้นขนาดบริบทดิบจึงไม่ใช่ตัวแยก
V2.5 น่าดึงดูดเมื่อบริบทยาวนั้นมีสื่อมัลติโมดัล เช่น วิดีโอ ภาพเอกสาร หรือทราซ์ของเอเจนต์แบบภาพ Pro คือโมเดลที่ควรทดสอบเมื่อบริบทเองกลายเป็นปัญหาการให้เหตุผล: คลังซอร์สขนาดใหญ่ สัญญายาว ชุดข้อมูลวิจัย หรือทราเจกทอรีของเอเจนต์ที่มีการกระทำต่อเนื่องจำนวนมาก
หน้าต่างบริบทขนาดใหญ่บอกความจุ ไม่ได้การันตีความซื่อสัตย์ในการให้เหตุผล ทดสอบการเรียกคืน การคงคำสั่ง และการใช้พยานหลักฐานที่ความยาวที่สำคัญต่อแอปพลิเคชัน
ราคาและประสิทธิภาพด้านต้นทุน อินพุตที่ไม่แคชต่อ 1M โทเคน $0.14 $0.435 3.11× อินพุตที่แคชแล้วต่อ 1M โทเคน $0.0028 $0.0036 1.29× เอาต์พุตต่อ 1M โทเคน $0.28 $0.87 3.11× หน้าต่างบริบท 1M 1M เท่ากัน เอาต์พุตสูงสุด 128K 128K เท่ากัน
คำขอที่มีอินพุต 1M โทเคนแบบไม่แคชและเอาต์พุต 200K โทเคน มีต้นทุนโดยประมาณ $0.196 บน V2.5 และ $0.609 บน Pro ก่อนคิด cache hit ค่าค้นเว็บ หรือการคิดเงินเฉพาะผู้ให้บริการ
ความต่างของราคาสำหรับ cache มีน้อยกว่า: Pro แพงขึ้นประมาณ 29% สำหรับอินพุตที่ cache-hit แทนที่จะเป็น 211% สำหรับอินพุตทั่วไป ดังนั้นเอเจนต์ที่รันยาวและมี system prompt คำนิยามเครื่องมือ หรือพรีฟิกซ์คลังโค้ดที่คงที่ ควรวัดอัตรา cache hit จริงของตน
ประเมินต้นทุนต่อหนึ่งงานที่สำเร็จ เอเจนต์ Pro ที่ทำเวิร์กโฟลว์ยากๆ สำเร็จในครั้งเดียว อาจมีต้นทุนน้อยกว่าการพยายามที่ล้มเหลวซ้ำๆ บนโมเดลที่ถูกกว่า
ควรใช้โมเดลใด? แชตข้อความทั่วไป V2.5 ราคาถูกกว่า; Pro มักไม่จำเป็น การสร้างเนื้อหาปริมาณมาก V2.5 ราคาต่อโทเคนมาตรฐานถูกกว่าประมาณ 3.1× การทำความเข้าใจภาพ วิดีโอ หรือเสียง V2.5 รองรับอินพุตมัลติโมดัลโดยตรง การเรียกใช้เครื่องมือทั่วไป V2.5 ความสามารถเอเจนต์แข็งแรงในต้นทุนที่ต่ำกว่า คณิตศาสตร์และวิทยาศาสตร์ที่ยาก Pro คะแนนเบนช์มาร์กสูงกว่า การโค้ดระดับคลังซอร์ส Pro ออกแบบมาสำหรับวิศวกรรมซอฟต์แวร์ที่ซับซ้อน การเรียกเครื่องมือที่พึ่งพากันหลายร้อยขั้น Pro เหมาะกับการทำงานต่อเนื่องยาวนาน งาน 1M context ที่อ่อนไหวต่อค่าใช้จ่าย V2.5 บริบทเท่ากันในราคาที่ต่ำกว่ามาก
ผลการคัดเลือก: V2.5 คือค่าตั้งต้นสำหรับแอปมัลติโมดัล เอเจนต์งานประจำ และงานโปรดักชันที่ใส่ใจต้นทุน ส่วน Pro คือการอัปเกรดสำหรับการให้เหตุผลที่ยาก วิศวกรรมซอฟต์แวร์ซับซ้อน และทราเจกทอรีอัตโนมัติที่ยาว
กลยุทธ์ขึ้นโปรดักชันที่ดีกว่า: กำหนดเส้นทางระหว่างทั้งสอง หลายครั้งไม่จำเป็นต้องเลือกโมเดลเดียวทั่วทั้งระบบ กำหนดเส้นทางคำขอมัลติโมดัลและงานทั่วไปไปยัง V2.5 แล้วค่อยยกระดับเฉพาะคำขอที่ยากด้านการให้เหตุผลบนข้อความ การโค้ดที่ซับซ้อน หรือการทำงานยาวนาน ไปยัง Pro
Completion งานที่สำเร็จ / จำนวนความพยายาม จับความน่าเชื่อถือปลายทางแบบ end-to-end ยกระดับคลาสที่มีอัตราสำเร็จต่ำ Quality คะแนนจากมนุษย์หรือรูบริก ป้องกันไม่ให้ต้นทุนโทเคนครอบงำทั้งหมด ยกระดับงานที่มีความเสี่ยงสูง Tool reliability ข้อผิดพลาดและจำนวนรีทราย ความผิดพลาดเล็กๆ สะสมทบกันในเอเจนต์ ยกระดับทราเจกทอรียาว Latency เวลาไปถึงผลที่ยอมรับได้ รวมค่าใช้จ่ายจากการรีทราย คงงานโต้ตอบให้เบาไว้ Cost ค่าใช้จ่ายต่อต่องานที่ยอมรับได้ สะท้อนความล้มเหลวและการรันซ้ำ ใช้โมเดลที่ถูกที่สุดที่ทำงานสำเร็จ
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
รันชุดงานตัวแทนที่มีคำของ่ายๆ งานให้เหตุผลยาก การแก้โค้ด งานบริบทยาว และการเรียกใช้เครื่องมือของเอเจนต์ บันทึกอัตราการสำเร็จ จำนวนโทเคน เวลาแฝง ข้อผิดพลาดของเครื่องมือ การรีทราย คุณภาพคำตอบ และต้นทุนต่อหนึ่งงานที่สำเร็จ
ข้อจำกัด
ข้อจำกัดของ V2.5 แกนภาษาที่เล็กกว่าทำให้ประสิทธิภาพลดลงเมื่อความยากของการให้เหตุผลสูงขึ้น ช่องว่างยังพอประมาณบน BBH แต่ใหญ่ขึ้นมากบน GPQA-Diamond และ MATH หน้าต่างบริบท 1M โทเคนก็ไม่ควรถูกเข้าใจผิดว่าเป็นการรับประกันความซื่อสัตย์ในการให้เหตุผลที่ 1M โทเคน
ข้อจำกัดของ Pro ราคาสำหรับอินพุตและเอาต์พุตทั่วไปแพงกว่า V2.5 ประมาณ 3.1× และอินพุตแบบข้อความเท่านั้นทำให้ไม่เหมาะแทนที่แอปมัลติโมดัลโดยตรง โมเดล weights เปิดขนาด 1.02T ก็เป็นโครงการโฮสต์เองที่โหด แม้จะเปิดใช้จริง 42B พารามิเตอร์ต่อโทเคนก็ตาม
ข้อสรุปสุดท้าย เลือก V2.5 สำหรับแอปมัลติโมดัล เอเจนต์งานประจำ และโปรดักชันที่ใส่ใจต้นทุน เลือก Pro สำหรับการให้เหตุผลที่ยาก วิศวกรรมซอฟต์แวร์ซับซ้อน และเอเจนต์อัตโนมัติที่ทำงานยาว สำหรับงานผสมผสาน ให้กำหนดเส้นทางส่วนใหญ่ไปที่ V2.5 และยกระดับเฉพาะคำขอที่ความยากหรือความยาวทราเจกทอรีคุ้มค่ากับต้นทุนที่เพิ่มขึ้น
คำถามที่พบบ่อย
Pro ดีกว่า V2.5 เสมอหรือไม่? ไม่ใช่ Pro แข็งแรงกว่าในงานให้เหตุผลบนข้อความที่ยากและการโค้ด แต่ V2.5 รองรับอินพุตภาพ วิดีโอ และเสียง และราคาถูกกว่ามาก
ทั้งสองโมเดลรองรับหน้าต่างบริบท 1M โทเคนหรือไม่? ใช่ ทั้งคู่โฆษณาบริบท 1M โทเคนและเอาต์พุตได้สูงสุด 128K โทเคน แอปพลิเคชันยังควรทดสอบการเรียกคืนและการให้เหตุผลที่ความยาวใช้งานจริง
เอเจนต์มัลติโมดัลควรใช้โมเดลใด? เริ่มจาก V2.5 เพราะรองรับอินพุตภาพและเสียงโดยกำเนิด ปัจจุบัน Pro มุ่งที่เวิร์กโฟลว์อินพุตข้อความ
เมื่อใด Pro จึงคุ้มราคาที่สูงกว่า? เมื่อความน่าเชื่อถือในการให้เหตุผลที่ดีขึ้นส่งผลต่อการสำเร็จของคณิตศาสตร์ยาก การโค้ดระดับคลังซอร์ส หรือทราเจกทอรียาวที่มีการเรียกเครื่องมือที่พึ่งพากันหลายขั้น
ระบบโปรดักชันควรใช้โมเดลเดียวหรือไม่? ไม่จำเป็น เลเยอร์กำหนดเส้นทางสามารถคงงานทั่วไปและมัลติโมดัลไว้ที่ V2.5 ขณะที่ยกระดับงานให้เหตุผลบนข้อความและเอเจนต์ที่ยากไปยัง Pro