
TL;DR
โมเดลวิดีโอ AI กำลังก้าวข้ามสูตรเดิมแบบข้อความเป็นวิดีโอไปสู่ระบบที่เข้าใจบรีฟครีเอทีฟครบวงจร—ข้อความ รูปภาพ ฟุตเทจอ้างอิง การเคลื่อนไหว เสียงพูด เพลง และเอฟเฟกต์เสียง—แล้วแปลงเป็นซีนภาพและเสียงที่สอดคล้องกัน MiniMax เปิดตัว H3 อย่างเป็นทางการเมื่อ 31 กรกฎาคม 2026 ในฐานะโมเดลการสร้างออมนิ-โมดัลอเนกประสงค์ที่เข้าใจข้อความ รูปภาพ วิดีโอ และเสียงร่วมกัน และสามารถสร้างคลิปยาวสูงสุด 15 วินาทีพร้อมเสียงสเตอริโอแบบเนทีฟ จุดเปลี่ยนสำคัญคือสถาปัตยกรรมแบบเอกภาพที่มองโจทย์ข้อความเป็นวิดีโอ ภาพเป็นวิดีโอ การสร้างเฟรมแรก/สุดท้าย การสร้างอ้างอิง การถ่ายโอนการเคลื่อนไหว การตัดต่อภาพและเสียง และการสร้างตามเงื่อนไขเสียง เป็นความแปรผันของปัญหาการสร้างมัลติโมดัลเพียงปัญหาเดียวแทนที่จะเป็นสายพานแยกส่วน ผลิตภัณฑ์แบบโฮสต์ให้ผลลัพธ์ 2K ตามค่าเริ่มต้นด้วยเวิร์กโฟลว์ที่ H3-Base สร้างที่ด้านสั้น 768p ก่อน แล้ว H3-Regenerate-2K จึงสร้างฉากใหม่โดยใช้คอนเท็กซ์เดิม จุดเด่นที่ผสานคุณภาพภาพและเสียงที่แข่งขันได้ การควบคุมมัลติโมดัลที่ยืดหยุ่น น้ำหนัก H3-Base ที่ดาวน์โหลดได้ และการเก็บรายละเอียดแบบรับรู้คอนเท็กซ์ในงาน 2K ทำให้ H3 เป็นหนึ่งในรุ่นวิดีโอที่โดดเด่นทางเทคนิคในปี 2026
Key Takeaways
- สถาปัตยกรรมใหม่: Contextual Omni Representation, H3-VAE, H3-Omni Transformer และ In-Context Regeneration รวมความสามารถในการทำความเข้าใจและการสร้างข้ามโมดาลิตี้
- ปรับปรุงประสิทธิภาพ: H3 สร้างคลิป 4–15 วินาที ที่วิดีโอ 24 FPS เสียงสเตอริโอ 32 kHz และผลลัพธ์ 2K แบบโฮสต์ที่สร้างใหม่จากคอนเท็กซ์มัลติโมดัลเดิม
- API และน้ำหนักที่เปิดให้ใช้: MiniMax มีบริการ H3-2K, H3-Context-IR และ H3-Regenerate-2K แบบโฮสต์ ขณะที่ H3-Base-FL2VA และ H3-Base-Ref2VA เปิดให้ดาวน์โหลดเป็นเช็คพอยต์
- กรณีใช้งานหลัก: โฆษณา แบรนด์ดิ้ง อีคอมเมิร์ซ ออกแบบผลิตภัณฑ์ UI/UX เกม ภาพยนตร์ การสร้างแบบอ้างอิง การถ่ายโอนการเคลื่อนไหว และการตัดต่อภาพและเสียง
- ราคาและขอบเขตการดีพลอย: แบบจ่ายตามการใช้งานอย่างเป็นทางการ $0.08/วินาที ที่ 768P และ $0.13/วินาที ที่ 2K; ดาวน์โหลดได้เฉพาะ H3-Base ส่วน H3-Context-IR และ H3-Regenerate-2K คงเป็นบริการแบบโฮสต์
What Is MiniMax H3?
MiniMax H3 คือระบบสร้างภาพและเสียงออมนิ-โมดัลอเนกประสงค์ที่พัฒนาโดย MiniMax แทนที่จะรับเพียงพรอมป์หรือภาพอ้างอิงหนึ่งภาพ H3 สามารถให้เหตุผลบนคอนเท็กซ์ที่มีข้อความ รูปภาพ วิดีโอ และเสียง แล้วสร้างวิดีโอที่ซิงก์กับเสียงสเตอริโอ
ระบบ H3 แบบโฮสต์รองรับ ผลลัพธ์ 4–15 วินาที วิดีโอ 24 FPS และเสียงสเตอริโอ 32 kHz MiniMax ทำการตลาดว่าระบบแบบโฮสต์ให้ 2K เป็นค่าเริ่มต้น ทางเทคนิค H3-Base สร้างผลลัพธ์ด้านสั้น 768p และ H3-Regenerate-2K นำผลนั้นพร้อมคอนเท็กซ์เดิมป้อนกลับเพื่อสร้างใหม่เป็น 2K MiniMax ยังรายงานการสร้างบทสนทนาที่เสถียรใน 11 ภาษา ได้แก่ อังกฤษ จีน ญี่ปุ่น เกาหลี ฝรั่งเศส เยอรมัน สเปน โปรตุเกส อิตาลี รัสเซีย และอาหรับ
ความแตกต่างนี้สำคัญ เพราะเวิร์กโฟลว์วิดีโอรุ่นก่อน ๆ มักเป็นสายพานลักษณะนี้:
prompt -> วิดีโอไม่มีเสียง -> เสียงพูด -> เอฟเฟกต์เสียง -> เพลง -> การซิงก์
H3 มองเสียงและวิดีโอเป็นส่วนหนึ่งของกระบวนการสร้างเดียวกัน H3-Omni-Transformer ทำนายละติเอนต์ของวิดีโอและเสียงร่วมกัน ลดความจำเป็นต้องประกอบวิดีโอ เสียงพากย์ เพลง และการซิงก์ที่เป็นขั้นตอนแยกต่างหากภายหลัง
MiniMax H3 Specifications at a Glance
| Specification | MiniMax H3 |
|---|---|
| ผู้พัฒนา | MiniMax |
| หมวดหมู่โมเดล | การสร้างวิดีโอออมนิ-โมดัลแบบอเนกประสงค์ |
| โมดาลิตี้ขาเข้า | ข้อความ, รูปภาพ, วิดีโอ, เสียง |
| ผลลัพธ์ | วิดีโอพร้อมเสียงสเตอริโอแบบเนทีฟ |
| ระยะเวลาผลลัพธ์ | 4–15 วินาที |
| ความละเอียดฐาน | ด้านสั้น 768p สำหรับ H3-Base |
| ความละเอียดบนระบบโฮสต์ | สูงสุด 2K ผ่าน H3-Regenerate-2K ให้ 2K เป็นค่าเริ่มต้น; ผลิตผ่าน H3-Regenerate-2K หลังการสร้างฐาน 768p |
| อัตราเฟรม | 24 FPS |
| เสียง | สเตอริโอ 32 kHz |
| ภาษาบทสนทนาที่เสถียร | 11 |
| อัตราส่วนภาพ | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 และมิติอื่น ๆ |
| ขีดจำกัดการอ้างอิง | สูงสุด 9 รูปภาพ, 3 วิดีโอ, 3 คลิปเสียง และรวมสูงสุด 12 ไฟล์แบบผสม |
| แกนโมเดลการสร้าง | H3-Omni-Transformer แบบ dense ขนาด 33B |
| การเข้ารหัสตำแหน่ง | 3D Multimodal RoPE |
| เช็คพอยต์แบบ open-weight | H3-Base-FL2VA และ H3-Base-Ref2VA |
| ความละเอียดเช็คพอยต์ | BF16 |
| สัญญาอนุญาต | MiniMax H3 Community License |
ตัวเลข 33B หมายถึง H3-Omni-Transformer ไม่ใช่องค์ประกอบทุกชิ้นในสายการผลิตแบบโฮสต์ทั้งหมด
What Makes MiniMax H3 Different?
One Model for Multiple Video Tasks
ตัวสร้างวิดีโอส่วนใหญ่มักแยกความสามารถข้อความเป็นวิดีโอ ภาพเป็นวิดีโอ การอ้างอิงการเคลื่อนไหว การตัดต่อวิดีโอ การสร้างเสียง และการอ้างอิงตัวแบบออกจากกัน
MiniMax เลือกแนวทางต่างออกไป H3 ผ่านการพรีเทรนรอบความสัมพันธ์ทั่วไประหว่างคอนเท็กซ์มัลติโมดัลกับผลลัพธ์ที่ต้องการ ทำให้สามารถใช้นิยามคำสั่งด้วยภาษาธรรมชาติอธิบายความสัมพันธ์เหล่านั้นได้
ตัวอย่างเช่น ครีเอเตอร์สามารถสั่งให้ H3 ติดตามการเคลื่อนไหวกล้องในวิดีโอหนึ่ง รักษาตัวละครจากภาพหนึ่ง และใช้คลิปเสียงอีกอันเป็นอ้างอิงโทนเสียง เดโมเปิดตัวของ MiniMax ใช้คำสั่งข้ามโมดาลลักษณะนี้เพื่อแสดงระบบอ้างอิงแบบทั่วไปของ H3
ทำให้ H3 มีลักษณะคล้ายเอนจินครีเอทีฟมัลติโมดัลมากกว่าชุดโหมดการสร้างที่แยกกัน
Native Video and Stereo Audio Generation
คำอธิบายทางเทคนิคของ MiniMax ระบุว่า H3-Omni-Transformer ทำนายละติเอนต์ของวิดีโอและเสียงร่วมกัน ฝั่งเสียงทำงานผ่าน H3-AudioVAE ซึ่งบีบอัดเสียง 32 kHz เป็นลำดับละติเอนต์ที่ 40 Hz ก่อนถอดรหัสกลับเป็นเสียงสเตอริโอ
สิ่งนี้ให้ข้อได้เปรียบเชิงปฏิบัติในซีนที่มีบทสนทนา เสียงแวดล้อม เพลง หรือเอฟเฟกต์เสียง: เสียงเป็นส่วนหนึ่งของคอนเท็กซ์การสร้างแทนที่จะเป็นขั้นตอนหลังการผลิตที่แยกออกไป
Omni-Reference Inputs
H3-Base-Ref2VA รองรับได้สูงสุด 9 รูปภาพ 3 คลิปวิดีโอ และ 3 คลิปเสียง โดยรวมจำกัด 12 ไฟล์ผสม วิดีโอและคลิปเสียงอ้างอิงยาวได้ 2–15 วินาทีต่อคลิป โดยมีข้อจำกัดระยะเวลารวมต่อโมดาลิตี้ เสียงเพียงอย่างเดียวไม่สามารถเป็นอินพุตอ้างอิงในโหมด Ref2VA ได้
สิ่งสำคัญไม่ใช่เพียงจำนวนอ้างอิง H3 ถูกออกแบบมาเพื่ออนุมานความสัมพันธ์ระหว่างแอสเซ็ตเหล่านั้น
- รักษาตัวละครจากภาพ;
- ทำซ้ำการเคลื่อนไหวจากคลิปอ้างอิง;
- ถ่ายโอนสไตล์ภาพหรือภาพยนตร์;
- รักษาหรือแทนที่เสียง;
- ใช้เสียงหนึ่งเป็นอ้างอิงโทนเสียง;
- ตัดต่อซีนภาพและเสียงที่มีอยู่ด้วยคำสั่งภาษาธรรมชาติ
In-Context 2K Regeneration
แนวทางสู่ความละเอียดสูงของ H3 มีความสำคัญอย่างผิดปกติ
แทนที่จะส่งผลลัพธ์ 768p ผ่านเครือข่ายซูเปอร์เรโซลูชันแบบเดิม H3-Regenerate-2K นำคอนเท็กซ์มัลติโมดัลเดิมกลับมาพร้อมผลลัพธ์ฐานแล้วขอให้ H3 สร้างซีนใหม่ที่ความละเอียดสูงกว่า
ประโยชน์ที่ตั้งใจไว้คือการกู้คืนเชิงความหมาย อัปสเกลเลอร์ทั่วไปสามารถอินเตอร์โพเลตพิกเซลได้ แต่ไม่สามารถกู้คืนข้อมูลที่หายไปได้อย่างน่าเชื่อถือ—เช่น ตัวอักษรเล็ก ๆ องค์ประกอบแบรนด์ หรือรายละเอียดวัตถุยิบย่อย ขั้นตอนการสร้างใหม่ของ H3 สามารถอ้างอิงพรอมป์และไฟล์อ้างอิงเดิมอีกครั้งระหว่างการสร้างผลลัพธ์ 2K
How Does the MiniMax H3 Architecture Work?
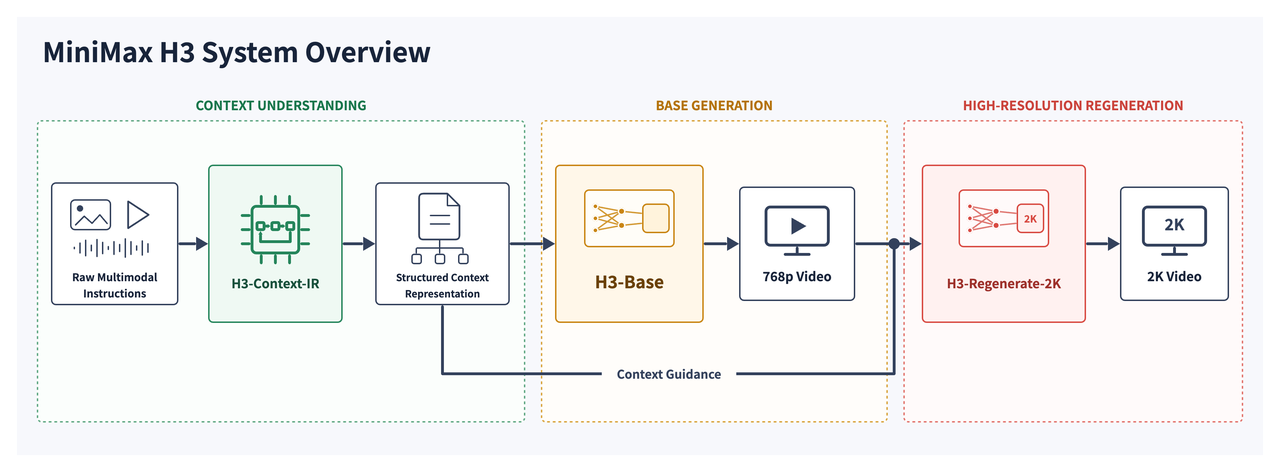
เวิร์กโฟลว์ H3 แบบสมบูรณ์มี 3 ขั้นตอนหลัก:
H3-Context-IR -> H3-Base -> H3-Regenerate-2K
H3-Context-IR แปลความหมายคำสั่งมัลติโมดัลที่อาจซับซ้อนและแปลงเป็น Context Intermediate Representation ที่มีโครงสร้าง H3-Base รับอินพุตนี้และสร้างวิดีโอพร้อมเสียงที่ 768p จากนั้น H3-Regenerate-2K รวมผลที่สร้างแล้วกับคอนเท็กซ์เดิมเพื่อสร้างเวอร์ชันความละเอียดสูงกว่า
H3-Contextual Omni Representation และ H3-Context-IR
Contextual Omni Representation คือแนวคิดการออกแบบกว้างของ MiniMax: ภาษาเป็นสะพานที่อธิบายความสัมพันธ์ระหว่างคอนเท็กซ์ เป้าหมาย และหลายโมดาลิตี้ ในคำอธิบายระบบที่เปิดเผย H3-Context-IR คือเลเยอร์พรีโปรเซสและออร์เคสตราชันแบบโฮสต์ที่พาร์สคำสั่ง เชื่อมโยงโมดาลิตี้ ให้เหตุผลด้านเวลา และซีเรียไลซ์ผลสำหรับ H3-Base
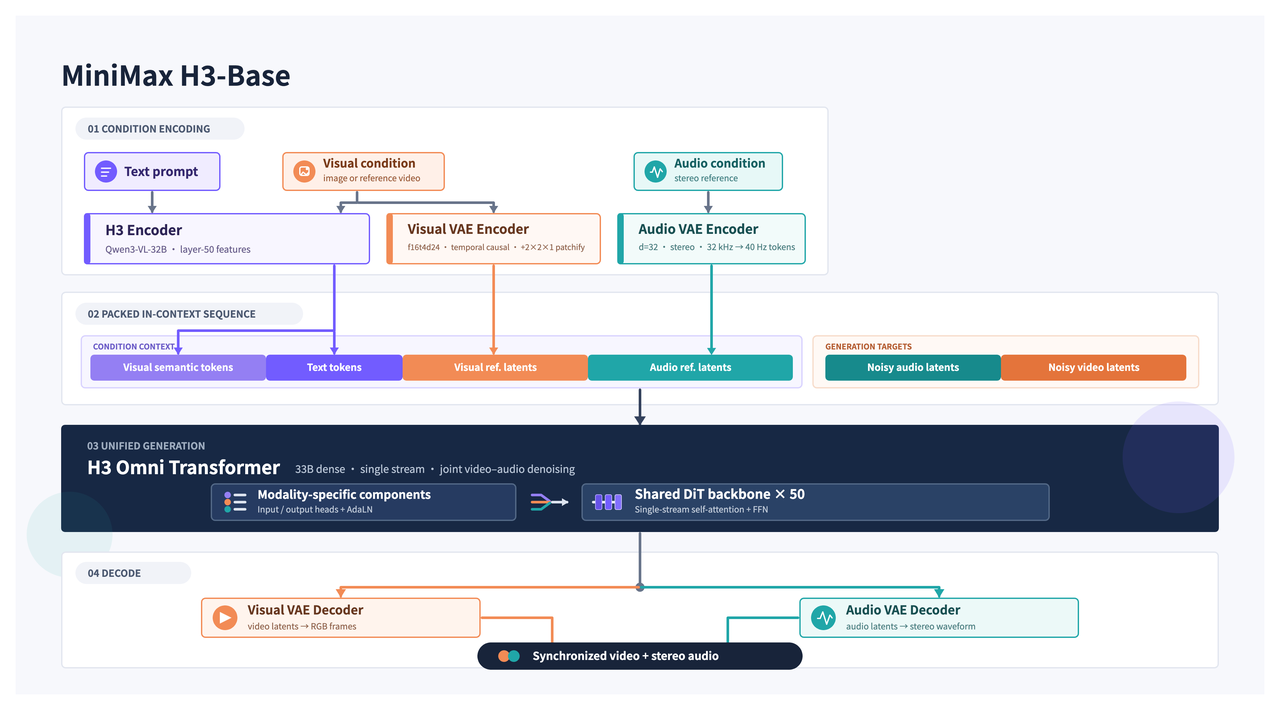
H3-Encoder ยังคงเป็นองค์ประกอบเฉพาะภายใน H3-Base ใช้น้ำหนักที่พรีเทรนของ Qwen3-VL-32B และส่งสถานะแฝงจากเลเยอร์ 50 เข้า H3-Omni-Transformer
H3-VAE
คำศัพท์เปิดตัว “H3-VAE” ครอบคลุมการแทนค่าละติเอนต์ภาพและเสียงของทั้งตระกูลโมเดล เอกสารโอเพ่นเวตแยก H3-VisualVAE ออกจาก H3-AudioVAE H3-VisualVAE ใช้การเข้ารหัสเชิงเหตุและเวลา ด้วยการบีบอัดเชิงพื้นที่ 16× การบีบอัดเชิงเวลา 4× และ 24 ช่องละติเอนต์ ตามด้วยการแพตชิฟาย 1 × 2 × 2 ส่วน H3-AudioVAE บีบอัดเสียงสเตอริโอ 32 kHz เป็นโทเค็นละติเอนต์ที่อัตราเวลา 40 Hz
H3-Omni-Transformer
บล็อกเปิดตัวสะกดชื่อว่า “H3-Omni Transformer”; เอกสารเทคนิคโอเพ่นเวตใช้ “H3-Omni-Transformer” ทั้งสองหมายถึงแกนการสร้างเดียวกัน เป็น Transformer แบบ dense สตรีมเดียวขนาด 33B โดยประมาณ 13B พารามิเตอร์อยู่ในสาขาที่เกี่ยวกับ AdaLN เอาต์พุตการมอดูเลชันของมันสามารถพรีคอมพิวต์และแคชได้ จึงไม่จำเป็นต้องโหลดไว้ตลอดระหว่างอินเฟอเรนซ์
องค์ประกอบจำเพาะโมดาลิตี้กระจุกตัวที่เลเยอร์อินพุต/เอาต์พุตและสาขา AdaLN ขณะที่ Transformer แกนกลางทำงานบนลำดับแพ็กแบบเอกภาพ Multimodal RoPE แบบ 3 มิติ แทนตำแหน่งเชิงเวลาและเชิงพื้นที่ข้าม (t, h, w)
H3-In-Context Regeneration
บล็อกเปิดตัวของ MiniMax เรียกเทคนิคนี้ว่า H3-In-Context Regeneration; โมดูลโปรดักชันชื่อ H3-Regenerate-2K มันป้อนผล 768p และคอนเท็กซ์เดิมกลับเข้า H3 เพื่อสร้างผลลัพธ์ 2K ใหม่ ช่วยให้รายละเอียดเชิงความหมายถูกสร้างใหม่แทนการอินเตอร์โพเลตเพียงอย่างเดียว
Is MiniMax H3 Really Open Source?
ย้ายมาจากตำแหน่งเดิมหลังส่วนเปรียบเทียบ เพราะขอบเขตโอเพ่นเวตคือความแตกต่างเชิงสถาปัตยกรรมหลัก
“โอเพ่นเวต” แม่นยำกว่า “โอเพ่นซอร์สเต็มรูปแบบ” MiniMax เปิดเช็คพอยต์ H3-Base-FL2VA และ H3-Base-Ref2VA สำหรับใช้งานภายในเครื่อง รวมถึงองค์ประกอบที่จำเป็นอย่างตัวประมวลผล ตัวโทเคไนซ์ ตัวเข้ารหัสข้อความ Transformer, visual VAE และ audio VAE
อย่างไรก็ตาม สายการผลิตระดับโปรดักชันแบบครบวงจรไม่สามารถดาวน์โหลดได้ H3-Context-IR ยังคงเป็นแบบโฮสต์ และ H3-Regenerate-2K ไม่รวมอยู่ในรีลีสโอเพ่นเวตครั้งแรก การสร้างด้วย H3-Base ภายในเครื่องมุ่งเป้าไปที่ด้านสั้น 768p; การทำให้เวิร์กโฟลว์ 2K เต็มตามทางการต้องอาศัยบริการแบบโฮสต์สำหรับการประมวลคอนเท็กซ์และการสร้างใหม่
H3 ยังใช้ MiniMax H3 Community License แทนสัญญาอนุญาตแบบผ่อนปรนมาตรฐานอย่าง Apache 2.0 หรือ MIT องค์กรควรทบทวนเงื่อนไขด้านอาณาเขต การให้เครดิต ความปลอดภัย และการใช้เชิงพาณิชย์ของสัญญาอนุญาตก่อนดีพลอย
MiniMax H3 Benchmark Performance
สื่อเปิดตัวของ MiniMax เน้นเดโม สถาปัตยกรรม และกรณีใช้งาน มากกว่าการเผยแพร่เมทริกซ์เบนช์มาร์กแบบ VBench ขนาดใหญ่ สำหรับภาพรวมที่เป็นกลางกว่า แหล่งที่มีประโยชน์คือ Video Arena ของ Artificial Analysis ที่ผู้ใช้เปรียบเทียบการสร้างจากพรอมป์เดียวกันแบบปิดตา
| งานของ Artificial Analysis | อันดับ H3 | H3 Elo | ผู้นำ | Elo ของผู้นำ |
|---|---|---|---|---|
| ข้อความเป็นวิดีโอพร้อมเสียง | #4 | ≈1,228 | Wan 3.0 | 1,242 |
| ภาพเป็นวิดีโอพร้อมเสียง | #3 | 1,185 | H3 Max ที่ผ่านการฝึกเพิ่มเติมโดย fal | 1,202 |
| ตัดต่อวิดีโอพร้อมเสียง | #2 | 1,129 | Wan 3.0 | 1,190 |
การจัดอันดับเหล่านี้เป็นสแน็ปช็อตเมื่อ 2 กันยายน 2026 ไม่ใช่คะแนนถาวร H3 แข่งขันได้กับระบบเชิงพาณิชย์ชั้นนำ และโดดเด่นเป็นพิเศษในบรรดารายการโอเพ่นเวต คุณค่าของมันคือการผสานคุณภาพการแข่งขัน การสร้างภาพและเสียงแบบเนทีฟ อ้างอิงมัลติโมดัล และน้ำหนักฐานที่ดาวน์โหลดได้—ไม่ใช่เพียงการอ้างคะแนนสูงสุด
MiniMax H3 Pricing
ราคาจ่ายตามการใช้งานต่อไปนี้ตรวจทานซ้ำกับหน้า定价อย่างเป็นทางการของ MiniMax เมื่อ 24 กันยายน 2026 ราคาอาจเปลี่ยนแปลงได้ ทีมโปรดักชันควรตรวจสอบอีกครั้งก่อนตั้งงบ
| การใช้งาน | ราคาอย่างเป็นทางการ |
|---|---|
| การสร้าง H3 ที่ 768P | $0.08/วินาที |
| การสร้าง H3 ที่ 2K | $0.13/วินาที |
| ผลลัพธ์การสร้างใหม่ 768P → 2K | $0.05/วินาที |
| อ้างอิงเสียงในการสร้างมาตรฐาน | ฟรี |
| อ้างอิงรูปภาพในการสร้างมาตรฐาน | 5 ภาพแรกฟรี; หลังจากนั้น $0.04/ภาพ |
| อ้างอิงรูปภาพในการสร้างใหม่ | 5 ภาพแรกฟรี; หลังจากนั้น $0.025/ภาพ |
| อ้างอิงวิดีโอในการสร้างใหม่ | $0.05/วินาที ของอินพุต 768P เดิม |
| อินพุต H3-Context-IR | $0.90/ล้านโทเค็น |
| เอาต์พุต H3-Context-IR | $3.60/ล้านโทเค็น |
ตามป้ายราคา การสร้าง 10 วินาทีคิดประมาณ $0.80 ที่ 768P หรือ $1.30 ที่ 2K; การสร้าง 15 วินาทีประมาณ $1.20 หรือ $1.95 ตัวอย่างนี้ไม่รวมค่าอ้างอิง ค่าทโคน Context-IR และค่าใช้จ่ายอื่นตามเวิร์กโฟลว์
MiniMax H3 ยังใช้งานผ่าน CometAPI ได้ หน้าระบุโมเดลโฆษณาอัตราเริ่มต้น $0.064/วินาที ภายใต้ model ID minimax-h3 ราคาหัวข่าวของบุคคลที่สามอาจขึ้นกับเส้นทาง ความละเอียด และกฎการคิดเงิน จึงไม่ควรถือเป็นอัตราหน่วยสากล
MiniMax H3 vs Wan3.0 vs Seedance 2.5 vs Vidu Q3
คู่แข่งที่มีประโยชน์ที่สุดไม่จำเป็นต้องเป็นโมเดลที่ดูเหมือนกันบนกระดาษ MiniMax H3, Wan3.0, Seedance 2.5 และ Vidu Q3 เน้นส่วนต่าง ๆ ของเวิร์กโฟลว์วิดีโอระดับมืออาชีพ
| มิติ | MiniMax H3 | Wan3.0 | Seedance 2.5 | Vidu Q3 |
|---|---|---|---|---|
| ระยะเวลาเจเนอเรชันเดี่ยวสูงสุด | 15s | 30s | 30s | 16s |
| ความละเอียดวิดีโอ | 2K แบบโฮสต์; ฐาน 768p แบบโอเพ่นเวต | สูงสุด 1080P | ขึ้นกับเส้นทาง | สูงสุด 1080P |
| เสียง-วิดีโอแบบเนทีฟ | Yes | Yes | Yes | Yes |
| อินพุตอ้างอิง | ข้อความ, รูปภาพ, วิดีโอ, เสียง | รูปภาพ, วิดีโอ, เสียง, เอกสาร, เว็บเพจ | รูปภาพ, วิดีโอ, เสียง | เวิร์กโฟลว์ภาพ/อ้างอิง |
| ความจุอ้างอิง | ไฟล์ผสม 12 รายการ | สูงสุด 20 วัสดุ | สูงสุด 50 วัสดุ | ไม่ระบุในหน้าหลัก |
| จุดแตกต่างหลัก | H3-Base แบบโอเพ่นเวต + การสร้างใหม่ 2K | 30s พร้อมอินพุตกว้าง | เล่าเรื่อง 30s พร้อมชุดอ้างอิงขนาดใหญ่ | เรื่องสั้นและคุมบทสนทนา |
| เหมาะที่สุดกับ | เวิร์กโฟลว์ครีเอทีฟแบบปรับแต่งได้ | โปรดักชันแบบ all-in-one ยาว | เล่าเรื่องเชิงพาณิชย์ที่พึ่งพาอ้างอิงมาก | ซีนเรื่องสั้นและบทสนทนา |
| เหมาะที่สุดกับ | เวิร์กโฟลว์ครีเอทีฟแบบปรับแต่งได้ | โปรดักชันแบบ all-in-one ยาว | เล่าเรื่องเชิงพาณิชย์ที่พึ่งพาอ้างอิงมาก | ซีนเรื่องสั้นและบทสนทนา |
Which Model Is Better?
ไม่มีผู้ชนะสากล เลือก MiniMax H3 เมื่อโอเพ่นเวต การคอนดิชันมัลติโมดัล เสียงสเตอริโอแบบเนทีฟ การตัดต่อภาพและเสียง และการจบงาน 2K สำคัญกว่าความยาวคลิปสูงสุด เลือก Wan 3.0 เมื่อเอาต์พุต 30 วินาที 1080P อินพุตเอกสาร/เว็บกว้าง และผลงานในอารีนาที่แข็งแกร่งสำคัญที่สุด เลือก Seedance 2.5 สำหรับชุดอ้างอิงขนาดใหญ่มาก โครงเรื่อง 30 วินาที ความคงตัวของอัตลักษณ์ หรือการตัดต่อแบบเจาะจง เลือก Vidu Q3 สำหรับซีนเรื่องสั้น บทสนทนาหลายคน ไทมิง และการคุมกล้องแบบผู้กำกับ
การประเมินอย่างรับผิดชอบควรรันพรอมป์ภายในชุดเดียวกันข้ามทุก API ที่เป็นตัวเลือก กระดานจัดอันดับสาธารณะไม่เสมอไปที่จะแสดงเวอร์ชันเทียบกันได้ตรง ๆ และการแทนที่ด้วยรุ่นเก่ากว่าหรือรุ่นเทอร์โบอาจบิดเบือนผล
What Are MiniMax H3's Main Limitations?
- ระยะเวลา: H3 สูงสุด 15 วินาที ขณะที่คู่แข่งบางรายรองรับ 30 วินาทีแล้ว
- ขอบเขตโอเพ่นเวต: ดาวน์โหลดได้เฉพาะ H3-Base; Context-IR และการสร้างใหม่ 2K ยังเป็นแบบโฮสต์
- ความต้องการฮาร์ดแวร์: โมเดลวิดีโอแบบ dense ขนาด 33B ยังมีค่าใช้จ่ายสูงในการดีพลอยภายในเครื่อง แม้มีการปรับอินเฟอเรนซ์
- ความซับซ้อนด้านราคา: การสร้าง การสร้างใหม่ วิดีโอและรูปภาพอ้างอิง และ Context-IR อาจมีค่าใช้จ่ายแยกกัน
- เงื่อนไขสัญญาอนุญาต: Community License ต้องตรวจทานทางกฎหมายใกล้ชิดกว่าสัญญาแบบผ่อนปรนมาตรฐาน
- ความผันผวนของเบนช์มาร์ก: อันดับอารีนาเปลี่ยนได้และไม่ทดแทนการทดสอบตามเวิร์กโหลดจริง
Who Should Use MiniMax H3?
H3 เหมาะกับนักพัฒนาและทีมครีเอทีฟที่สร้างเวิร์กโฟลว์วิดีโอมัลติโมดัลซึ่งต้องการความสม่ำเสมอของตัวแบบ อ้างอิงการเคลื่อนไหวหรือเสียง เสียงสเตอริโอแบบเนทีฟ การตัดต่อ และการจบงานความละเอียดสูง นอกจากนี้ยังสอดคล้องกับทีมที่ต้องการปรับแต่งหรือโฮสต์โมเดลฐานเอง พร้อมใช้สเตจแบบโฮสต์เฉพาะเมื่อจำเป็น
ทีมที่ต้องการความยาวเจเนอเรชันเดี่ยวสูงสุด การดีพลอยภายในเครื่องที่เบาที่สุด หรือสแตกครบวงจรที่ผ่อนปรนอย่างสมบูรณ์อาจเหมาะกับโมเดลอื่น MiniMax ชูกรณีการสร้างเชิงพาณิชย์อย่างโฆษณา แบรนด์ดิ้ง อีคอมเมิร์ซ ออกแบบผลิตภัณฑ์ UI/UX เกม และภาพยนตร์
How Can Developers Access MiniMax H3?
มี 3 เส้นทางหลัก:
- ใช้ผลิตภัณฑ์แบบโฮสต์ของ MiniMax รวมถึง Hailuo และ MiniMax Design
- ใช้ MiniMax Open Platform โดยตรงสำหรับ API H3-2K, H3-Context-IR และ H3-Regenerate-2K
- ดาวน์โหลดเช็คพอยต์ H3-Base เพื่อนำไปดีพลอยภายในเครื่องผ่านรีโพทางการและเฟรมเวิร์กอินเฟอเรนซ์ที่รองรับ
สำหรับรายละเอียดการใช้งาน ให้ดูเอกสาร API และการดีพลอยอย่างเป็นทางการในรายการแหล่งที่มา บทความนี้มุ่งที่การประเมินผลิตภัณฑ์
Conclusion
ความสำคัญของ MiniMax H3 ไม่ได้อยู่ที่การนำทุกเมตริกเสมอไป แต่อยู่ที่การบีบอัดสายพานการผลิตที่แยกส่วนให้กลายเป็นระบบมัลติโมดัลที่ตั้งโปรแกรมได้หนึ่งเดียว น้ำหนัก H3-Base ที่ดาวน์โหลดได้เปิดพื้นที่ให้นักพัฒนาสร้างต้นแบบ ปรับแต่ง และวนซ้ำภายในเครื่อง ขณะที่สเตจแบบโฮสต์ H3-Context-IR และ H3-Regenerate-2K ให้การประมวลผลคำสั่งและการจบงานความละเอียดสูงที่เหมาะกับโปรดักชัน โมเดลแบบผสมนี้ก็มีแลกเปลี่ยน: ขีดจำกัด 15 วินาที ความต้องการโครงสร้างพื้นฐานภายใน การพึ่งพาบริการโฮสต์ ต้นทุนระดับเวิร์กโฟลว์ และเงื่อนไข Community License ทั้งหมดต้องชั่งน้ำหนักกับพรอมป์จริงและข้อจำกัดการส่งมอบของทีม สำหรับทีมที่ให้ความสำคัญกับการควบคุมอ้างอิงมัลติโมดัล เสียงเนทีฟที่ซิงก์ การตัดต่อภาพและเสียง และมาสเตอร์ 2K H3 เป็นแพลตฟอร์มที่น่าสนใจ; ทีมที่ต้องการคลิปยาวกว่าหรือสแตกแบบผ่อนปรนและพึ่งตนเองทั้งหมดควรเบนช์มาร์กทางเลือกก่อนตัดสินใจ
FAQ
ทีมโปรดักชันควรแบ่งงานระหว่าง H3-Base ภายในเครื่องกับบริการโฮสต์ของ MiniMax อย่างไร?
เวิร์กโฟลว์ผสมที่ใช้งานได้จริงคือใช้ H3-Base ภายในเครื่องสำหรับการสำรวจอย่างรวดเร็ว การไล่พรอมป์ การทดสอบอ้างอิง และทุกสเตจที่การควบคุมโครงสร้างพื้นฐานหรือความเป็นส่วนตัวของข้อมูลสำคัญ ผลลัพธ์ที่มีแนวโน้มดีค่อยส่งไปยัง H3-Context-IR แบบโฮสต์เพื่อการประมวลคำสั่งที่เข้มข้นขึ้น และ H3-Regenerate-2K เพื่อการส่งมอบความละเอียดสุดท้าย สัดส่วนที่เหมาะสมขึ้นกับความจุ GPU เวลาเล่นกลับ ข้อกำหนดกำกับดูแล และว่าคุณภาพที่ได้จากสเตจแบบโฮสต์คุ้มกับการโอนข้อมูล หน่วงเวลา และค่าใช้จ่ายเพิ่มหรือไม่
ชุดประเมินภายในควรวัดอะไรบ้างก่อนทีมจะรับ H3 มาใช้?
อย่าประเมิน H3 ด้วยพรอมป์ที่ดูสวยงามทางสายตาเท่านั้น ใช้ชุดบรีฟโปรดักชันจริงที่ทำซ้ำได้ และให้คะแนนความสอดคล้องคำสั่ง ความคงตัวของตัวแบบและแบรนด์ ความเสถียรเชิงเวลา การเรนเดอร์ตัวอักษร ความแม่นยำการเคลื่อนกล้อง การซิงก์ภาพ-เสียง คุณภาพบทสนทนา ความซื่อสัตย์ของการสร้างใหม่ หน่วงเวลา อัตราล้มเหลว และต้นทุนต่อคลิปที่ยอมรับได้ รันแอสเซ็ตและเกณฑ์ยอมรับเดียวกันกับโมเดลคู่แข่ง เพื่อไม่ให้จัดอันดับสาธารณะมาแทนหลักฐานจากเวิร์กโหลดจริงของทีม
ควรเตรียมแอสเซ็ตอ้างอิงมัลติโมดัลอย่างไรเพื่อเพิ่มการควบคุม?
แอสเซ็ตอ้างอิงควรมีบทบาทที่ชัดเจนไม่ขัดแย้ง: รูปภาพหนึ่งอาจกำหนดอัตลักษณ์ คลิปหนึ่งกำหนดการเคลื่อนไหว และตัวอย่างเสียงหนึ่งกำหนดโทนเสียงหรืาบรรยากาศ ลบอ้างอิงคุณภาพต่ำหรือขัดกัน ตัดคลิปให้เหลือช่วงการกระทำที่เกี่ยวข้อง และระบุความสัมพันธ์ระหว่างแต่ละแอสเซ็ตกับเอาต์พุตเป้าหมายให้ชัดในคำสั่ง เริ่มจากชุดอ้างอิงที่น้อยที่สุดเท่าที่พอจะช่วยวินิจฉัยได้ง่ายว่าแอสเซ็ตไหนช่วย และแอสเซ็ตไหนสร้างความคลุมเครือ
ต้นทุนโปรดักชันใดที่มองข้ามได้ง่ายเมื่อเทียบ H3 กับ API อื่น?
ราคาต่อวินาทีเป็นเพียงฐานที่มองเห็นได้ โมเดลต้นทุนที่สมจริงควรรวมวิดีโออ้างอิงที่คิดตามวินาที รูปภาพเพิ่มเติม โทเค็น Context-IR การสร้างใหม่ 2K การลองซ้ำ งานที่ถูกปัดตก ความจุ GPU ภายใน พื้นที่จัดเก็บและการโอนสื่อ การจัดการม็อดเดอเรชัน งานอินทิเกรชัน และการรีวิวโดยมนุษย์ การเปรียบเทียบที่มีประโยชน์คือ “ต้นทุนต่อชิ้นงานที่ผ่านอนุมัติ” ที่ความละเอียดที่ต้องการ—ไม่ใช่ “ต้นทุนต่อการสร้างดิบ”
ควรตีความ “2K เป็นค่าเริ่มต้น” อย่างไรเมื่อ H3-Base เองสร้างที่ 768p?
ถ้อยคำเหล่านี้อธิบายเลเยอร์ของผลิตภัณฑ์ต่างกัน “2K เป็นค่าเริ่มต้น” หมายถึงประสบการณ์เชิงพาณิชย์แบบโฮสต์ ในขณะที่ 768p อธิบายเอาต์พุตด้านสั้นของสเตจ H3-Base ที่ดาวน์โหลดได้; H3-Regenerate-2K จะสร้างเอาต์พุตสุดท้ายใหม่โดยใช้ทั้งผลลัพธ์ฐานและคอนเท็กซ์เดิม ดังนั้นการทดสอบคุณภาพควรเทียบระหว่างเอาต์พุต 768p ภายในเครื่องและเอาต์พุต 2K แบบโฮสต์เป็นสเตจเวิร์กโฟลว์แยกกัน โดยให้ความสนใจกับว่าการสร้างใหม่ฟื้นฟูข้อความ แบรนด์ ใบหน้า และรายละเอียดไหมจิ๋วได้จริง ไม่ใช่แค่ขยายพิกเซล
เมื่อใดที่ MiniMax H3 ไม่น่าจะเป็นตัวเลือกแรกที่ดีที่สุด?
H3 อาจไม่เหมาะเมื่อโปรเจ็กต์ต้องการคลิปแบบ single-pass ที่ยาวกว่ามาก การจบงาน 2K ทั้งหมดภายในเครื่อง สัญญาอนุญาตแบบผ่อนปรนมาตรฐาน การลงทุน GPU น้อยที่สุด หรือเวิร์กโฟลว์ข้อความเป็นวิดีโอที่เรียบง่ายซึ่งไม่ได้ประโยชน์มากจากอ้างอิงมัลติโมดัล ในกรณีเหล่านี้ คุณค่าของสถาปัตยกรรมทั่วไปของ H3 อาจไม่คุ้มกับความซับซ้อนเชิงปฏิบัติ การพิสูจน์แนวคิดขนาดสั้นโดยใช้พรอมป์แทนงานเป็นวิธีที่ปลอดภัยที่สุดเพื่อตัดสินว่า การควบคุมและการบูรณาการภาพ-เสียงช่วยปรับปรุงผลลัพธ์สุดท้ายอย่างมีนัยสำคัญหรือไม่