
TL;DR
OpenAI Decisions API คือ endpoint เฉพาะทางที่แปลงข้อความและภาพให้เป็นคำตัดสินที่เครื่องอ่านได้ (machine-readable) ที่พร้อมนำไปปฏิบัติ แทนการสร้างร้อยแก้ว ใช้ GPT-6 Luna และรองรับคำถามแบบ predicate, choice และ score OpenAI รายงานว่ามีประสิทธิภาพเร็วกว่า Responses API ประมาณ 10× สำหรับงานตัดสินใจที่รองรับ และมีราคามาตรฐานสำหรับอินพุต $0.10 ต่อหนึ่งล้านโทเค็น
Key Takeaways
- การตัดสินใจที่ออกแบบเฉพาะ: ใช้คำถามที่กำหนดไว้ล่วงหน้าแทนการสนทนาแบบอิสระ
- ประเภทการตัดสินใจ 3 แบบ: predicate, choice และ score
- ระบบอัตโนมัติที่คำนึงถึงความน่าจะเป็น: ส่งอินพุตที่คลุมเครือหรือมีผลกระทบสูงไปให้มนุษย์ตรวจทาน
- ผู้ให้บริการรายงานว่าเร็วขึ้น และราคามาตรฐานสำหรับอินพุต $0.10 ต่อหนึ่งล้านโทเค็น โดยไม่มีค่าบิลลิงเอาต์พุต ทำให้ endpoint นี้เหมาะกับการตัดสินใจจำนวนมาก
- เหมาะสำหรับงาน routing, classification, visual checks และด่านตัดสินใจของ AI agent
What Is the OpenAI Decisions API?
OpenAI Decisions API ประเมินข้อมูลและส่งคืนคำตัดสินแบบมีขอบเขตที่เครื่องอ่านได้ OpenAI เปิดตัวเวอร์ชันเบตาเมื่อ 6 ตุลาคม 2026 คู่มือนี้เหมาะสำหรับนักพัฒนาที่เข้าใจ API keys และ JSON อยู่แล้ว และต้องการประเมินเวิร์กโฟลว์การจัดประเภทหรือการกำหนดเส้นทาง รายละเอียดสินค้าได้รับการตรวจสอบเมื่อ 12 ตุลาคม 2026
สคีมาคำขอ POST /v1/decisions รองรับการระบุโมเดล อินพุตข้อความหรือภาพที่ใช้ร่วมกัน และคำถามที่นักพัฒนากำหนด Endpoint เฉพาะนี้จะส่งคืนคำตัดสินแบบมีชนิดข้อมูล แทนคำอธิบายเป็นร้อยแก้ว
OpenAI Decisions API specifications
| Specification | Documented endpoint details |
|---|---|
| Product type | Specialized API endpoint, not a standalone foundation model |
| Endpoint | POST /v1/decisions |
| Underlying model | gpt-6-luna |
| Inputs | Text and images |
| Decision types | predicate, choice, score |
| Outputs | Typed decisions and probability information |
| Performance | Approximately 10× faster than Responses API (vendor claim) |
| Standard input price | $0.10 / 1M tokens |
| Output charge | None for Decisions API |
| Tool calling / streaming | Not supported directly by this endpoint |
Current availability and access
ณ วันที่ 15 ตุลาคม 2026 คู่มือทางการ ระบุการเปิดเบตาสาธารณะ โดย gpt-6-luna เป็นโมเดลเดียวที่รองรับ ส่งคำขอไปที่ POST /v1/decisions; สถานะเบตาไม่ได้รับประกันความเสถียรระดับโปรดักชัน
ใช้โปรเจ็กต์ OpenAI API และตรวจสอบสิทธิ์เข้าถึงโมเดล สถานะการเรียกเก็บเงิน และขีดจำกัดอัตราก่อนการปรับใช้งาน คู่มือระบุให้ใช้ Python SDK 3.26.0 หรือใหม่กว่า; ควรยืนยันสิทธิ์การเข้าถึงที่ผูกกับบัญชีด้วยคำขอทดสอบขนาดเล็ก
ลูกค้าที่มีคุณสมบัติสามารถใช้ Zero Data Retention และการจัดการตาม HIPAA ได้ คู่มือระบุการประมวลผลในภูมิภาคสหรัฐฯ และยุโรป; คุณสมบัติและข้อกำหนดตามสัญญายังคงมีผล การเข้าถึงผ่านอินเทอร์เฟซ Luna ของบุคคลที่สามไม่ถือว่าเข้ากันได้กับ endpoint เฉพาะนี้โดยอัตโนมัติ
How Does the OpenAI Decisions API Work?
คำขอจะรวมหลักฐานอินพุตที่ใช้ร่วมกันกับคำถามที่นักพัฒนากำหนด API จะประเมินอินพุตด้วย GPT-6 Luna และส่งคำตอบที่โค้ดแอปพลิเคชันสามารถใช้เพื่อทำงานอัตโนมัติ ตรวจทาน หรือยกระดับได้ สามารถถามหลายคำถามกับอินพุตเดียวกันได้ อย่างไรก็ตามคำถามที่มีความสัมพันธ์กันควรถูกเรียงลำดับโดยแอปพลิเคชัน
Predicate evaluation
Predicate ประเมินว่าเงื่อนไขที่ระบุเป็นจริงหรือไม่ ตัวอย่างเช่น ผู้ค้าปลีกอาจถามว่าภาพถ่ายมีความเสียหายของสินค้าให้เห็นได้ชัดหรือไม่; การตอบกลับจะให้ความน่าจะเป็นระหว่าง 0 ถึง 1
ตัวอย่างส่วนตอบกลับของ predicate
{
  "type": "predicate",
  "name": "visible_damage",
  "probability": 0.92
}
Choice selection
คำถามแบบ choice เลือกจากหมวดหมู่ที่กำหนดไว้อย่างชัดเจน เช่น Billing, Technical Support หรือ Account Access ฟิลด์การกระจาย (distribution) และความเชื่อมั่น (confidence) รองรับนโยบายการกำหนดเส้นทางและการยกระดับในขั้นถัดไป
Score evaluation
คำถามแบบ score ประเมินอินพุตเทียบกับ rubric ที่มีลำดับ คะแนนที่คาดหวังอาจสะท้อนดัชนีแบบถ่วงความน่าจะเป็นของระดับที่กำหนดไว้; ซึ่งไม่ได้หมายความว่าเป็นการปรับเทียบความเสี่ยงในโลกจริงโดยอัตโนมัติ
| Index | Severity | Interpretation |
|---|---|---|
| 0 | Low | ไม่มีการดำเนินการเร่งด่วน |
| 1 | Moderate | ดำเนินการติดตามตามปกติ |
| 2 | High | ส่งผลกระทบต่อลูกค้ามาก |
| 3 | Critical | ยกระดับทันที |
What Are the Main Features of the OpenAI Decisions API?
Fast, bounded execution
เอาต์พุตแบบมีชนิดช่วยลดความจำเป็นในการสร้างร้อยแก้ว การพาร์สข้อความ หรือการลองใหม่เมื่อคำตอบผิดรูป OpenAI อธิบายว่ามีความเร็วเพิ่มขึ้นประมาณสิบเท่าสำหรับงานตัดสินใจที่รองรับ; กำไรจริงขึ้นกับความยาวอินพุต ค่าเครือข่าย และระดับความขนาน
Multiple questions over shared context
ทิคเก็ตสนับสนุนหนึ่งรายการสามารถถูกประเมินแผนก ระดับเร่งด่วน และคุณสมบัติการตรวจทานได้ในการขอครั้งเดียว แอปพลิเคชันยังคงต้องบังคับใช้กฎธุรกิจแบบ deterministic และการตรวจสิทธิ์
Text and image understanding
รองรับข้อความและภาพสำหรับการกำหนดเส้นทางทิคเก็ต การคัดแยกภาพหน้าจอ และการตรวจภาพเชิงสายตา โปรดดูเอกสารทางการสำหรับรูปแบบภาพที่รองรับ ขนาดสูงสุด และโครงสร้าง payload ที่ยอมรับในปัจจุบัน
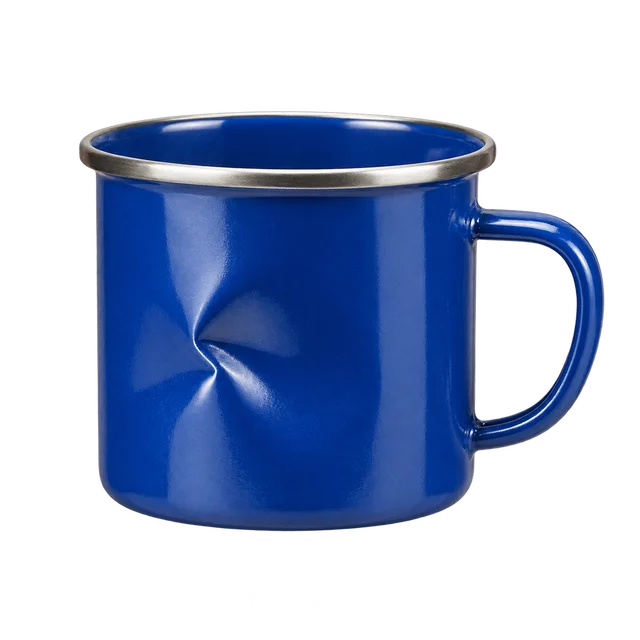
OpenAI ใช้แก้วที่บุบนี้ใน ตัวอย่างการตัดสินภาพ ภาพนี้แสดงความเสียหายที่สังเกตได้; ไม่ใช่หลักฐานอัตราความแม่นยำ Endpoint นี้รับ data URL ของภาพแบบ base64 แบบ inline ไม่รองรับภาพที่โฮสต์ผ่าน URL หรือไฟล์ไอดี
Probability-aware automation
ค่าความเชื่อมั่นที่รายงานไม่รับประกันความแม่นยำ ทีมงานควรปรับแต่ง threshold กับข้อมูลตัวอย่างที่ติดฉลาก แยก threshold สำหรับกรณีที่ผลลัพธ์ผิดด้านมีผลกระทบสูง (false positive/false negative)
Security and data controls
การเก็บข้อมูล การประมวลผลตามภูมิภาค และการใช้งานภายใต้กฎระเบียบขึ้นอยู่กับการกำหนดค่าบัญชีและข้อกำหนดตามสัญญาที่ใช้บังคับ โปรดยืนยันคุณสมบัติก่อนประมวลผลข้อมูลที่มีการกำกับดูแลหรืออ่อนไหว
How Much Does the OpenAI Decisions API Cost?
อัตรามาตรฐานที่รายงานคือ $0.10 ต่อหนึ่งล้านโทเค็นอินพุต โดยไม่มีการคิดค่าบิลลิงเอาต์พุตผ่าน Decisions endpoint เฉพาะ ค่าพรีเมียมการประมวลผลตามภูมิภาคหรือค่าคูณสำหรับ long context อาจส่งผลต่อบิลสุดท้าย
| Component | Dedicated endpoint pricing |
|---|---|
| Standard input | $0.10 per 1M tokens |
| Output tokens | $0 |
| Cache reads / writes | $0 |
| Regional processing | Premium may apply |
| Long context | Multiplier may apply |
| Billing unit | Input tokens |
How much can Decisions API save versus Responses API?
เปรียบเทียบงานเดียวกันบนโมเดลเดียวกัน Decisions guide ระบุ $0.10 ต่อหนึ่งล้านโทเค็นอินพุตและไม่มีค่าบิลลิงสำหรับเอาต์พุตหรือ cache หน้าโมเดล Luna ระบุราคามาตรฐานข้อความ $0.10/1M uncached input และ $0.50/1M output สำหรับการใช้งานโมเดลทั่วไป
การคำนวณตัวอย่าง (ไม่ใช่ benchmark): คำขอข้อความ 1,000,000 รายการ อินพุตที่คิดค่าบริการแบบ uncached 500 โทเค็นต่อคำขอบนแต่ละ endpoint การจัดประเภทหนึ่งครั้งต่อคำขอ และไม่มีพรีเมียมภูมิภาคหรือ long context สำหรับ Responses ให้ใช้จำนวนโทเค็นเอาต์พุตที่ถูกบิลทั้งหมด รวมถึง reasoning tokens ที่ถูกบิล ไม่ใช่ความยาวคำตอบที่มองเห็นเพียงอย่างเดียว
ภายใต้สมมติฐานนี้: Decisions cost = N × I × $0.10 / 1,000,000. Responses cost = N × (I × $0.10 + O × $0.50) / 1,000,000. Savings percentage = (Responses cost − Decisions cost) / Responses cost × 100%, โดย N คือจำนวนคำขอ, I โทเค็นอินพุต/คำขอ, และ O โทเค็นเอาต์พุตที่ถูกบิล/คำขอ
| Billed Responses output / request | Decisions cost / 1M requests | Responses cost / 1M requests | Estimated savings |
|---|---|---|---|
| 5 tokens | $50.00 | $52.50 | $2.50 (4.8%) |
| 20 tokens | $50.00 | $60.00 | $10.00 (16.7%) |
| 100 tokens | $50.00 | $100.00 | $50.00 (50.0%) |
การประหยัดข้างต้นมาจากสมมติฐานค่าบิลลิงเอาต์พุตของ Responses; ไม่ใช่ส่วนลดคงที่ของ endpoint โปรดคำนวณใหม่ด้วยการใช้งานอินพุตที่วัดจริง อัตราการ cache hit/เขียน ชั้นการประมวลผล และการลองใหม่ อัตรา cache หรือ Batch/Flex อาจเปลี่ยนผลลัพธ์ เพิ่มค่าธรรมเนียมเครื่องมือ การตรวจทานโดยมนุษย์ และโครงสร้างพื้นฐานแยกต่างหาก เปรียบเทียบต้นทุนต่อคำตัดสินที่ถูกต้องที่ยอมรับหลังการตรวจสอบคุณภาพและ latency; ป้ายสั้นกับคำอธิบายยาวเป็นงานต่างกัน
OpenAI Decisions API vs Responses API vs Jev and Aplomb 1
ตารางนี้เน้นบริการตัดสินใจเฉพาะ สำหรับคำอธิบายที่สร้างขึ้น สคีมาสกัดแบบกำหนดเอง หรือเวิร์กโฟลว์เครื่องมือ ให้ใช้ Responses API ตามที่อธิบายไว้ใน คู่มือการตัดสินใจของ OpenAI การตัดสินใจสามารถเลือกแขนงเวิร์กโฟลว์ ในขณะที่ Responses ใช้เพื่อสร้างคอนเทนต์หรือร้องขอการเรียกเครื่องมือ โดยโค้ดแอปพลิเคชันจัดการการทำงานของเครื่องมือแบบกำหนดเอง
Capabilities and pricing overview
| Dimension | OpenAI Decisions API | Jev 1.13 | Aplomb 1 |
|---|---|---|---|
| Inputs | Text and images | Text; experimental images with opt-in | Text, JSON, images, video and audio |
| Standard input price / 1M tokens | $0.10 | $0.042 | $0.02 |
| Access | Hosted OpenAI API | Hosted TypeSafe API | Hosted API; downloadable weights under the EmpirioLabs Model License |
| Evaluation fit | Routing, filtering and scoring in OpenAI workflows | Classification and intent routing | Mixed-media decisions; deployment requiring weights |
ขอบเขตการคัดเลือก: Jev และ Aplomb ถูกนำมาเปรียบเทียบเนื่องจากความสามารถด้านการตัดสินใจที่เผยแพร่ ไม่ใช่การจัดอันดับความนิยม สเปกและราคามาตรฐานสำหรับอินพุตตรวจสอบเมื่อ 16 ตุลาคม 2026 TypeSafe ยังแม็ป jev-latest ไปที่ 1.13 และ jev-preview ไปที่ 1.14 ดังนั้นการเปรียบเทียบนี้ตรึงอยู่ที่ 1.13 การรองรับภาพของ Jev ยังเป็นแบบทดลอง น้ำหนักของ Aplomb มีข้อจำกัดด้านสิทธิ์การใช้งาน; โปรดตรวจสอบข้อกำหนดสำหรับการใช้งานเชิงพาณิชย์ ราคาต่อโทเค็นที่เผยแพร่ไม่ใช่การจัดอันดับคุณภาพหรือการประมาณต้นทุนเวิร์กโฟลว์ทั้งหมด
Workflow selection
คัดกรองบริการโดยดูจากอินพุตที่ต้องการและตัวเลือกการปรับใช้ แล้วทดสอบกับกรณีที่ติดฉลากเดียวกัน จับคู่การเตรียมอินพุต rubric การตัดสินใจ การวัด latency แบบ end-to-end และนโยบายการตรวจทานโดยมนุษย์ เปรียบเทียบความแม่นยำในการกำหนดเส้นทาง กรณีที่พลาด ภาระงานตรวจทาน และต้นทุนต่อคำตัดสินที่ถูกต้องที่ยอมรับ รายงานสิ่งเหล่านี้ร่วมกันเพื่อไม่ให้ราคาต่อโทเค็นที่ต่ำกว่า หรือคำตอบที่เร็วกว่า ปกปิดข้อผิดพลาดเพิ่มเติมหรือค่าใช้จ่ายการตรวจทาน
How Can You Use the OpenAI Decisions API?
Step 1: Configure credentials
สร้าง API key และระบุเป็นตัวแปรสภาพแวดล้อม OPENAI_API_KEY ห้ามฮาร์ดโค้ดคีย์ลับในรีโพสิทอรีหรือแอปพลิเคชันฝั่งหน้า
Step 2: Send a request with cURL
คำขอต่อไปนี้ทำตาม สคีมาตัวอย่าง choice อย่างเป็นทางการ ตั้งค่า OPENAI_API_KEY ก่อนรัน; การตอบสำเร็จจะมีอาร์เรย์ answers คำสั่งเชลล์ใช้ไวยากรณ์ Bash
กำหนดเส้นทางคำขอสนับสนุนด้วย cURL
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this complaint?",
        "choices": [
          {"value": "billing", "description": "Payments and refunds"},
          {"value": "technical", "description": "Product issues"},
          {"value": "other", "description": "Everything else"}
        ]
      }
    ]
  }'
Step 3: Integrate with Python
ติดตั้ง Python SDK ที่ต้องการ
pip install --upgrade "openai>=3.26.0"
ขอและตรวจสอบคำตัดสินแบบ choice
from openai import OpenAI

client = OpenAI()
result = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[{
        "type": "choice",
        "name": "department",
        "instructions": "Which team should handle this request?",
        "choices": [
            {"value": "billing", "description": "Payments and refunds"},
            {"value": "technical", "description": "Product issues"},
            {"value": "other", "description": "Other requests"}
        ]
    }]
)
answer = result.answers[0]
if answer.type == "refusal":
    print("Decision refused")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
Step 4: Define an escalation rule
ใช้ threshold สำหรับการกำหนดเส้นทางตัวอย่าง
if answer.type == "choice":
    if answer.choice != "other" and answer.confidence >= 0.90:
        print("Eligible for automatic routing")
    else:
        print("Send to human review")
ค่า threshold 0.90 เป็นเพียงตัวอย่าง ไม่ใช่การรับประกันจากผู้ให้บริการหรือค่าดีฟอลต์ที่แนะนำอย่างเป็นทางการ โปรดตรวจสอบกับตัวอย่างจริงและความเสี่ยงทางธุรกิจ
How Can You Access GPT-6 Luna Through CometAPI?
นักพัฒนาสามารถใช้ GPT-6 Luna API ใน CometAPI สำหรับงานโมเดลทั่วไป ซึ่งไม่ควรสับสนกับการรองรับ Decisions endpoint เฉพาะของ OpenAI ที่ต้องมีการยืนยันความเข้ากันได้แยกต่างหาก
จัดประเภทข้อความผ่าน CometAPI Responses
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.responses.create(
    model="gpt-6-luna",
    input=(
        "Classify as billing, technical, or other. "
        "Return only the category. "
        "Request: I was charged twice for my order."
    )
)
print(response.output_text)
ตัวอย่างนี้เป็นการจัดประเภททั่วไปผ่านอินเทอร์เฟซโมเดลที่เข้ากันได้กับ CometAPI; จะไม่ส่งคืนโครงสร้างความน่าจะเป็นแบบ native ของ Decisions API และไม่รับราคาที่คิดเฉพาะอินพุต
What Are the Best Use Cases for the OpenAI Decisions API?
ต่อไปนี้เป็นเวิร์กโฟลว์ตัวอย่าง ไม่ใช่การปรับใช้จริงหรือผล benchmark ใช้คำถามแบบ predicate, choice และ score ตาม Decisions guide อย่างเป็นทางการ โค้ดแอปพลิเคชันจะทำงานในขั้นตอนถัดไป
Customer support classification
ให้ข้อความทิคเก็ต ประวัติการสนทนาที่เกี่ยวข้อง และรายชื่อทีมสนับสนุนที่กำหนดไว้ คำถามแบบ choice สามารถเลือก Billing, Technical Support หรือ Account Access; คำถามแบบ score แยกต่างหากสามารถประเมินความเร่งด่วนตาม rubric ที่เขียนไว้ โค้ดแอปสามารถกำหนดคิวที่แนะนำและส่งเคสที่ไม่แน่ชัดหรือข้อมูลไม่ครบให้ผู้ตรวจทาน
ประเมินเวิร์กโฟลว์บนทิคเก็ตที่ติดฉลากโดยทีมซัพพอร์ต วัดความแม่นยำการกำหนดเส้นทางตามหมวดหมู่ เคสเร่งด่วนที่พลาด อัตราการย้ายคิว และภาระงานตรวจทาน เปรียบเทียบกับกระบวนการกำหนดเส้นทางเดิมก่อนขยายการปรับใช้
Content moderation and review queues
ให้อยู่กับข้อความหรือภาพที่ส่ง พร้อมหมวดหมู่การตรวจทานที่กำหนดไว้อย่างชัดเจน คำถามแบบ predicate ประเมินว่ามีเงื่อนไขเฉพาะปรากฏหรือไม่ ในขณะที่คำถามแบบ score จัดลำดับความสำคัญการตรวจทานตาม rubric ความรุนแรงที่บันทึกไว้ จากนั้นแอปสามารถวางรายการที่ถูกตั้งธงลงในคิวที่เหมาะสมและแสดงคอนเทนต์ที่เกี่ยวข้องให้ผู้ตรวจทาน; ตัว endpoint เองจะไม่ลบคอนเทนต์หรือบังคับใช้กฎของแพลตฟอร์ม
ประเมินการละเมิดที่พลาด การตั้งธงที่ไม่จำเป็น ความสอดคล้องของผู้ตรวจทาน และความล่าช้าคิวบนตัวอย่างที่ติดฉลากที่เป็นตัวแทน ปรับ threshold แยกสำหรับหมวดหมู่ที่มีผลกระทบแตกต่างกัน
E-commerce image inspection
ให้ภาพถ่ายสินค้าและเกณฑ์การตรวจที่เกี่ยวข้อง เช่น รอยแตกที่เห็นได้ชัด การฉีกขาด หรือบรรจุภัณฑ์ที่เสียหาย คำถามแบบ predicate ประเมินว่ามีแต่ละเงื่อนไขหรือไม่ และคำถามแบบ score ใช้ rubric ที่กำหนดไว้เมื่อภาพให้หลักฐานเพียงพอ โค้ดแอปสามารถขอภาพเพิ่มเติมหรือสร้างงานตรวจโดยมนุษย์เมื่อหลักฐานไม่ชัดเจน
ประเมินความแม่นยำการตรวจเทียบกับสิ่งของที่ตรวจจริง รวมถึงความเสียหายที่พลาดและสัญญาณเตือนผิดในแต่ละหมวดสินค้าและสภาพภาพ เก็บการคืนเงินหรือทดแทนไว้ในเวิร์กโฟลว์อนุมัติเดิมของผู้ค้าปลีก
AI-agent action gating
ให้แผนการกระทำที่เสนอ อาร์กิวเมนต์ คำขอของผู้ใช้ที่เกี่ยวข้อง และกฎการปฏิบัติของแอปที่เขียนไว้ คำถามแบบ predicate ประเมินว่าข้อเสนอเข้ากับงานที่ร้องขอหรือจำเป็นต้องตรวจทาน โค้ดแอปใช้ผลลัพธ์เพื่อเลือกแขนงที่กำหนดไว้: ดำเนินต่อ ขอคำชี้แจง หรือยกระดับ การตรวจสิทธิ์อย่างอิสระยังคงต้องกำหนดว่าการดำเนินการได้รับอนุญาตหรือไม่; การตัดสินของโมเดลเป็นเพียงอินพุตหนึ่ง
ประเมินเกตด้วยข้อเสนอการกระทำที่ติดฉลาก วัดการกระทำที่ไม่ได้รับอนุญาตที่พลาด การยกระดับที่ไม่จำเป็น และความไวต่อบริบทที่ไม่ครบหรือขัดแย้งก่อนเชื่อมต่อเข้ากับการดำเนินการจริง
Document and email triage
ให้ข้อความเอกสารหรืออีเมล เมทาดาทาที่เกี่ยวข้อง และชุดหมวดหมู่คงที่ เช่น invoice, support request, meeting request หรืออื่นๆ คำถามแบบ choice เลือกหมวดหมู่ ในขณะที่คำถามแบบ predicate ระบุเงื่อนไข เช่น ข้อมูลที่จำเป็นขาดหาย โค้ดแอปสามารถส่งรายการไปยังเวิร์กโฟลว์การสกัด การค้นคืน หรือการตรวจทานที่เหมาะสม โดยไม่ขอให้ decision endpoint ทำขั้นตอนภายหลังเหล่านั้น
ประเมินความแม่นยำของหมวดหมู่ การกำหนดเส้นทางปลายทางที่ผิด ปริมาณการตรวจทาน และเวลาในการประมวลผล โดยใช้บันทึกที่ติดฉลากซึ่งเป็นตัวแทน รวมถึงรายการที่คลุมเครือและรูปแบบที่ไม่คุ้นเคย
What Are the OpenAI Decisions API’s Limitations?
API นี้ไม่สร้างคอนเทนต์อธิบายตามอำเภอใจ ไม่เรียกใช้เครื่องมือโดยตรง และไม่ตัดความจำเป็นในการทดสอบคำทำนาย หมวดหมู่ที่ขาดหายหรือ rubric การตัดสินที่เขียนไม่ดีอาจก่อให้เกิดผลลัพธ์ที่ไม่เหมาะสม ค่า confidence อาจไม่ถูกปรับเทียบ; ระบบอัตโนมัติสำหรับงานที่มีความเสี่ยงสูงยังต้องมีการป้องกัน การตรวจทานโดยมนุษย์ และตรรกะการอนุญาต
Conclusion
Decisions API มีแนวโน้มที่ดีสำหรับคำตัดสินที่มีขอบเขตจำนวนมาก เพราะรวมเอาต์พุตแบบมีชนิดพร้อมข้อมูลความน่าจะเป็นเข้ากับโมเดลการคิดราคาต่อโทเค็นที่เรียบง่าย ทีมงานควรเปรียบเทียบกับ Structured Outputs และโมเดลตัดสินใจทางเลือกโดยใช้กรณีที่ติดฉลากเดียวกัน การวัด latency และต้นทุนเวิร์กโฟลว์ทั้งหมด โอกาสหลักคือระบุขั้นตอนในแอป AI ที่ต้องการ “การเลือก” มากกว่าการสร้างร้อยแก้ว
FAQs
How should OpenAI Decisions API refusals be handled?
ปฏิบัติต่อ refusal เป็นผลลัพธ์เวิร์กโฟลว์แยก ตรวจสอบ answer.type ก่อนอ่านฟิลด์ choice, score หรือ probability บันทึกชื่อคำถามและกำหนดเส้นทางคำขอไปยังเส้นทางตรวจทานหรือกู้คืน; อย่าตีความ refusal ว่าเป็น predicate เชิงลบหรือคะแนนศูนย์
How can Decisions API thresholds be maintained over time?
เลือก threshold จากตัวอย่าง holdout ที่ติดฉลาก แล้วติดตามความแม่นยำในคำตัดสินที่ยอมรับและสัดส่วนที่ส่งไปตรวจทาน ประเมินใหม่หลังเปลี่ยนหมวดหมู่ คำแนะนำ แหล่งอินพุต หรือพฤติกรรมโมเดล เก็บ rubric แบบมีเวอร์ชันเพื่อให้การเปลี่ยนแปลงการกำหนดเส้นทางโยงกับการกำหนดค่าที่ก่อให้เกิดได้
How should OpenAI Decisions API latency tests be reported?
บันทึกวันที่ ภูมิภาค ตัวระบุโมเดล จำนวนคำถาม ความยาวข้อความ ขนาดภาพ ระดับความขนาน เวอร์ชันไคลเอนต์ นโยบายลองใหม่ และการตั้งค่า endpoint ที่ใช้เปรียบเทียบ รายงาน end-to-end p50 และ p95 พร้อมจำนวนตัวอย่างและผลคุณภาพ เพื่อให้ความเร็วที่เพิ่มขึ้นไม่เกิดจากการยอมรับข้อผิดพลาดมากขึ้น
How should Decisions API categories evolve without breaking integrations?
ใช้ค่า value ที่เสถียรในเชิงเครื่องและคงแผนที่ไปยังคิวปลายทาง เพิ่มหมวดหมู่ fallback และทดสอบกรณีขอบทางประวัติก่อนปรับใช้คำอธิบายใหม่ หากเปลี่ยนชื่อหมวดหมู่ ให้ปรับแผนที่การกำหนดเส้นทางและ rubric พร้อมกัน แทนที่จะปล่อยให้ value ที่ไม่รู้จักเข้าสู่การกระทำในโปรดักชัน
What should be logged for a Decisions API routing audit?
บันทึกเวอร์ชันของ rubric หมวดหมู่ที่เลือก ความน่าจะเป็นหรือความเชื่อมั่นที่เกี่ยวข้อง threshold ตัวระบุโมเดล การประทับเวลา และการกระทำที่ทำ จำกัดคอนเทนต์อินพุตที่เก็บไว้เท่าที่เวิร์กโฟลว์ต้องการ และใช้ตามนโยบายการเก็บรักษาขององค์กร บันทึกการตรวจสอบควรแสดงเหตุผลว่าทำไมตรรกะแอปจึงกำหนดเส้นทางหรือยกระดับเคสดังกล่าว