
TL;DR
Claude Haiku 5.5 và GPT-6 Luna là các mô hình suy luận chi phí thấp cho khối lượng lớn qua API. Cả hai bắt đầu ở mức $0.10 cho mỗi triệu token đầu vào và $0.50 cho mỗi triệu token đầu ra. Haiku đạt điểm cao hơn trong sáu phép so sánh được công bố trong tài liệu ra mắt của Anthropic. Luna giữ nguyên mức giá token cơ bản cho prompt tới 272K token đầu vào, so với ngưỡng 100K của Haiku. Với nhà phát triển, các thước đo then chốt gồm tỷ lệ chấp nhận, độ trễ đầu-cuối, khả năng tương thích API và chi phí trên mỗi kết quả được chấp nhận—tổng chi phí của tất cả lần thử chia cho số đầu ra vượt qua các kiểm tra định sẵn.
Key Takeaways
- Haiku 5.5 dẫn đầu ở so sánh OSWorld 2.1 về tương tác máy tính, 72.4% so với 48.9% của Luna.
- Trên Terminal-Bench 4.0, kết quả được dẫn là 39.2% cho Haiku và 16.4% cho Luna.
- Cả hai có giá ngắn ngữ cảnh giống nhau, nhưng bậc giá cao hơn của Haiku bắt đầu sau 100K token prompt, trong khi ngưỡng của Luna là 272K.
- Trang “max-effort model” của Artificial Analysis, kiểm tra ngày 9 tháng 10, 2026, cho thấy tốc độ đầu ra 240.6 token/giây cho Haiku và 123.0 token/giây cho Luna; thông lượng không bao gồm thời gian chờ token đầu tiên.
- Bắt đầu với Haiku cho các tác vụ tương tác máy tính và terminal được phản ánh trong benchmark; cân nhắc Luna cho prompt lớn. Giữ mô hình hiện tại cho đến khi một thử nghiệm đại diện chứng minh được cải thiện hữu ích.
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 ra mắt ngày 7 tháng 10, 2026. Mô hình kết hợp suy luận giá thấp với mức suy luận điều chỉnh, sử dụng công cụ, ngữ cảnh dài và đầu vào văn bản–hình ảnh. Ứng dụng điển hình gồm trích xuất tài liệu, truy vấn cơ sở dữ liệu, hỗ trợ khách hàng và các tiểu tác tử nhẹ.
GPT-6 Luna: Overview
GPT-6 Luna ra mắt ngày 22 tháng 9, 2026. Mô hình được định vị cho các tác vụ tập trung ở quy mô lớn, gồm phân loại, trích xuất thông tin, đầu ra có cấu trúc, hỗ trợ lập trình và xử lý tài liệu dài. Thiết lập suy luận linh hoạt của Luna bao gồm cấu hình không suy luận cho công việc đơn giản.
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | 7 tháng 10, 2026 | 22 tháng 9, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 token | 1,050,000 token |
| Maximum output (standard API) | 128,000 token | 128,000 token |
| Input | Văn bản và hình ảnh | Văn bản và hình ảnh |
| Output | Văn bản | Văn bản |
| Reasoning | Điều chỉnh, Thấp đến Tối đa | Không đến Tối đa |
| Default effort | Trung bình | Trung bình |
| Knowledge cutoff | Tháng 6 năm 2026 | 18 tháng 5, 2026 |
| Tool use | Có | Có |
| Structured output | Có | Có |
| Open weights | Không | Không |
| Architecture and parameter count | Không được nêu trong tài liệu chính thức được dẫn | Không được nêu trong tài liệu chính thức được dẫn |
Thông số lấy từ tài liệu API tiêu chuẩn của nhà cung cấp, kiểm tra ngày 9 tháng 10, 2026: Haiku's standard API specifications và Luna's standard API specifications. Kiến trúc và số tham số không được nêu vì các nguồn này không xác lập chúng.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
Sáu dòng trên tái hiện các kết quả so sánh ra mắt do Anthropic công bố, kiểm tra ngày 9 tháng 10, 2026. Đây là các so sánh do Anthropic công bố, bao gồm kết quả độc lập được tái hiện ở đó, không phải thử nghiệm mới cho bài viết này. GDPval-AA và AA-Briefcase là điểm Elo; chênh lệch phần trăm là điểm phần trăm. Các họ benchmark đo lường tác vụ khác nhau và không nên bình quân thành một “người thắng chung cuộc”.
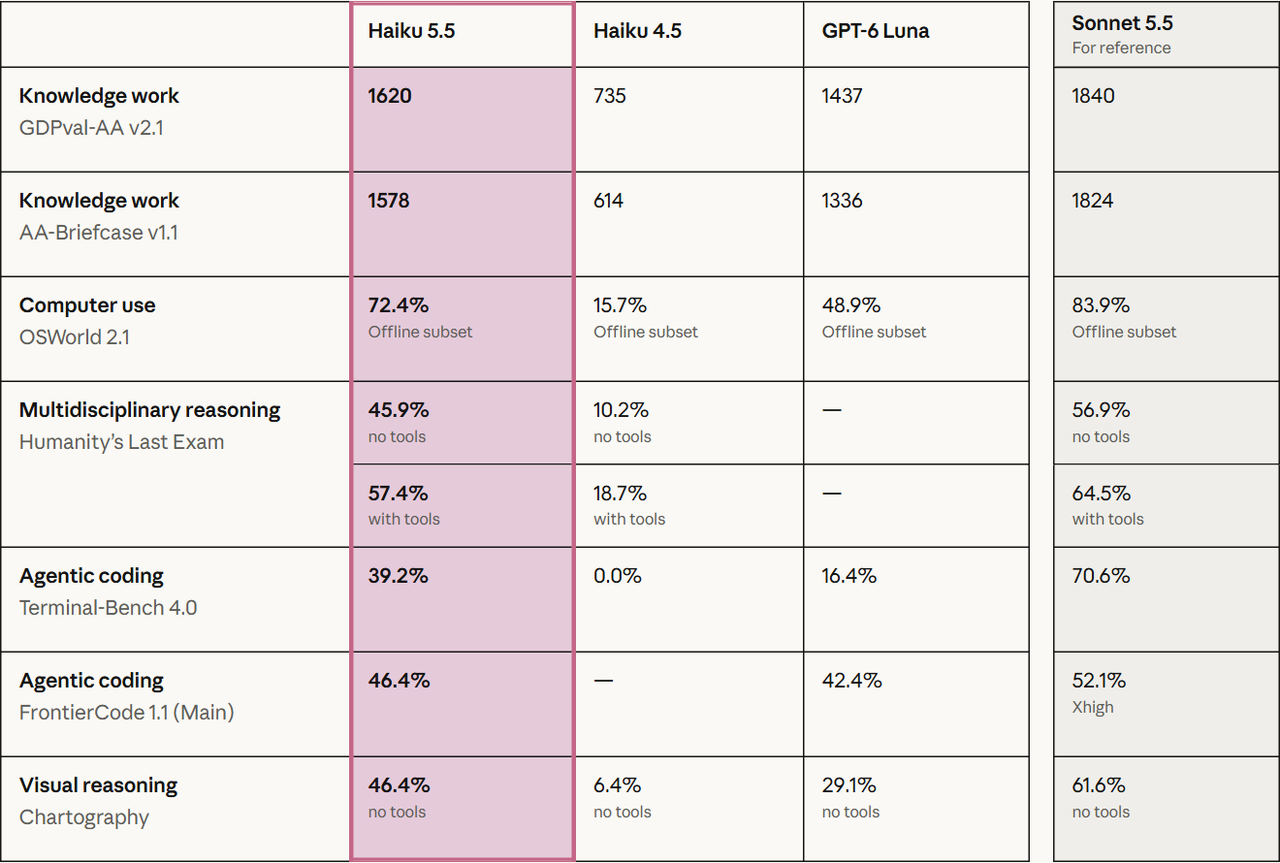
Ưu thế tương đối mạnh nhất của Haiku trong bảng ra mắt này xuất hiện ở tương tác máy tính trực quan và tác vụ dựa trên terminal. Khoảng cách nhỏ hơn ở FrontierCode cảnh báo không nên ngoại suy chênh lệch 20 điểm cho mọi tình huống lập trình. Hãy dùng các kết quả này để chọn ứng viên thí điểm, rồi xác thực prompt và bộ công cụ của bạn.
Reasoning Effort and Evaluation Limits
Mức nỗ lực suy luận thay đổi đánh đổi độ chính xác–chi phí. So sánh các thiết lập khả dụng trên cùng khối lượng công việc và bộ khung; tên mức nỗ lực giống nhau giữa nhà cung cấp không đảm bảo ngân sách token suy luận tương đương. Bảng ra mắt báo cáo tập con offline của OSWorld và Chartography không dùng công cụ. Bộ khung, lựa chọn tác vụ, số lần thử và quyền truy cập công cụ có thể thay đổi kết quả. System card của Anthropic ghi lại điều kiện cụ thể theo benchmark. Read the benchmark methods in Anthropic's system card.
- OSWorld dùng tập con offline 82 tác vụ, máy ảo Ubuntu, ảnh chụp màn hình 1080p, giới hạn 500 hành động, mức nỗ lực tối đa và 5 lần thử mỗi tác vụ. So sánh 72.4%/48.9% là chấm điểm tín dụng từng phần, không phải phần trăm tác vụ hoàn tất hoàn hảo; tỷ lệ vượt chuẩn nghiêm ngặt của Haiku là 37.1%. Anthropic chạy Luna trên cùng tập tác vụ qua API của OpenAI.
- Terminal-Bench dùng 66 tác vụ dạng container; Haiku chạy ở mức nỗ lực tối đa trong chế độ Claude Code “bare”, không có quyền truy cập internet ra ngoài và không có mô hình dự phòng, trung bình 10 lần thử mỗi tác vụ.
- FrontierCode Main gồm 100 tác vụ với 5 lượt chạy mỗi tác vụ; các mô hình Claude dùng Claude Code và các mô hình GPT dùng Codex.
- GDPval-AA và AA-Briefcase được Artificial Analysis đánh giá độc lập và tái hiện trong tài liệu ra mắt. Đây là các pipeline đánh giá riêng biệt, không phải một bộ khung sản xuất dùng chung.
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Ưu thế mạnh nhất của Haiku nằm ở các tác vụ ra mắt dùng chung yêu cầu tương tác với máy tính đồ họa hoặc làm việc trong terminal. Khoảng cách điểm OSWorld (tín dụng từng phần) là 23.5 điểm phần trăm, trong khi Terminal-Bench chênh 22.8 điểm. Chênh lệch 4.0 điểm nhỏ hơn của FrontierCode cho thấy không nên coi danh mục lập trình rộng như một khối công việc duy nhất.
Với tự động hóa trình duyệt, hãy kiểm thử điều hướng trang, nhập biểu mẫu, phục hồi khi công cụ lỗi và hoàn tất end-to-end. Với lập trình, kiểm thử liệu bản vá vượt qua kiểm tra chức năng của kho mã và nằm trong phạm vi. Những kiểm tra chấp nhận như vậy hữu ích hơn việc chọn mô hình dựa trên khoảng cách tiêu đề lớn nhất.
Long Context and Document Processing
Chênh 5% về sức chứa ngữ cảnh danh nghĩa kém quan trọng hơn độ tin cậy và mức giá khi xử lý prompt lớn. Không mô hình nào tự thân vượt trội trong truy xuất thông tin chỉ vì cửa sổ ngữ cảnh lớn hơn.
Khác biệt then chốt là thời điểm áp dụng mức giá cao hơn: prompt 150K token vượt ngưỡng của Haiku nhưng vẫn trong bậc cơ bản của Luna. Vì vậy Luna là điểm khởi đầu chi phí thấp hơn cho khối lượng token đó. Việc nó có phải là nhà phân tích tài liệu tốt hơn hay không vẫn phụ thuộc vào độ chính xác trích xuất, trích dẫn và số lần lặp lại cần thiết để có câu trả lời chấp nhận được.
Reasoning Controls
Cả hai mô hình đều cho phép điều chỉnh mức nỗ lực suy luận, với mặc định là trung bình theo tài liệu được dẫn. Luna còn có thiết lập none. Hãy dùng các điều khiển đó phù hợp với tác vụ: trích xuất và định tuyến có thể cần ít suy luận hơn một quy trình công cụ đa bước không chắc chắn. Cùng nhãn mức nỗ lực không hàm ý cùng ngân sách tính toán giữa các nhà cung cấp.
Multimodal Input and Structured Workflows
Cả hai chấp nhận văn bản và hình ảnh và tạo ra văn bản. Điều này khiến chúng phù hợp cho ảnh chụp màn hình, trích xuất từ ảnh tài liệu và các quy trình hạ nguồn có cấu trúc. Hỗ trợ đầu vào giống nhau không đồng nghĩa độ chính xác ngang nhau trên chữ nhỏ, biểu đồ hay giao diện trực quan; hãy đo lường riêng các trường hợp đó.
Speed and Task Economics
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 token/giây | 123.0 token/giây |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis là nhà xuất bản kiểm thử độc lập. Bảng là ảnh chụp từ trang “max-effort model” của họ, kiểm tra ngày 9 tháng 10, 2026, không phải hiệu năng chính thức của nhà cung cấp. Tốc độ đầu ra đo số token nhận được sau khi bắt đầu sinh; tách biệt với thời gian tới token đầu tiên và độ trễ hoàn tất tác vụ. Chi phí mỗi tác vụ là chỉ số có trọng số của Intelligence Index, không phải báo giá cho tác vụ sản xuất hay chi phí cho kết quả thành công.
Thông lượng đầu ra ảnh chụp của Haiku xấp xỉ gấp 1.96 lần Luna, trong khi chi phí tác vụ đánh giá có trọng số của Luna thấp hơn. Điều này không khẳng định lợi thế 1.96 lần về thời gian hoàn tất tác vụ đầy đủ. Kiểm thử sản xuất nên ghi riêng thời gian tới token đầu tiên, thời gian hoàn tất, độ dài đầu ra, mức tiêu thụ suy luận và thời gian thực thi công cụ.
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
USD trên mỗi triệu token ở mức xử lý tiêu chuẩn, kiểm tra ngày 9 tháng 10, 2026. Bảng dùng mức tiêu chuẩn và mức ghi cache 5 phút của Haiku và mức ngắn/ngữ cảnh dài của Luna. Phí công cụ, thuế, phụ phí khu vực và điều chỉnh bậc xử lý tùy chọn được loại trừ. Vượt ngưỡng token đầu vào, mức giá cao hơn áp dụng cho toàn bộ yêu cầu thay vì chỉ phần vượt.
Khác biệt trung tâm là ngưỡng tính phí. Haiku chuyển sang mức cao hơn sau 100K token prompt, trong khi Luna giữ bậc thấp tới 272K. Ngay cả trên ngưỡng đó, mức giá đầu vào và đầu ra ngữ cảnh dài của Luna được dẫn vẫn thấp hơn.
Haiku cũng cung cấp ghi cache 1 giờ ở $0.20/$1.00 cho mỗi triệu token với prompt ngắn/dài. Cơ chế lưu cache và định giá khác nhau giữa nhà cung cấp, nên hãy so sánh mẫu tái sử dụng thay vì coi hai hàng “ghi cache” là sản phẩm đồng nhất. Giới hạn đầu ra 128K của Haiku là giới hạn API tiêu chuẩn; Message Batches API của họ có thể hỗ trợ 300K đầu ra với một header beta.
Illustrative Costs at Fixed Token Budgets
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
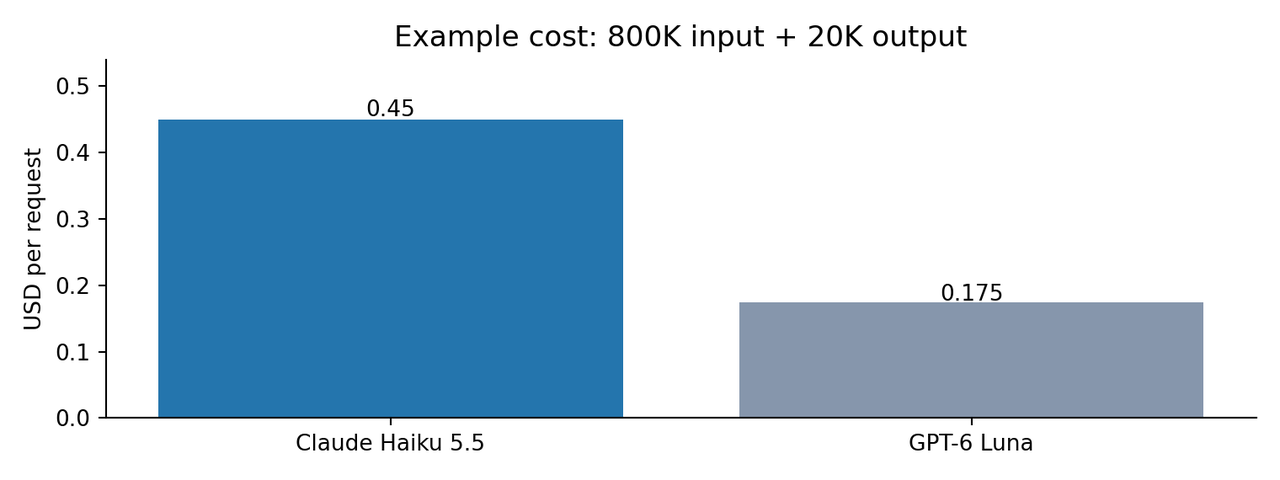
Ước tính mức tiêu chuẩn chưa cache do tác giả tự tính: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. “Output” nghĩa là tổng đầu ra bị tính phí cho ước tính này, bao gồm token suy luận nếu bị tính là đầu ra; không nhất thiết là độ dài câu trả lời hiển thị. Cùng số lượng token được báo cáo được dùng cho cả hai mô hình, dù bộ tách token có thể khác.
Token rẻ không đồng nghĩa kết quả thành công rẻ. Nhóm nên tính đến các lần thử lặp lại, cuộc gọi công cụ thất bại, tiêu thụ token suy luận và hành vi tokenizer khác nhau.
CometAPI Access and Integration Constraints
CometAPI cung cấp tùy chọn truy cập cho cả hai mô hình. Trước khi so sánh hoặc triển khai qua gateway, hãy xác minh model ID, endpoint được hỗ trợ, tham số yêu cầu, hành vi công cụ và quy tắc tính phí cho từng tuyến. Các liên kết nhà cung cấp này mô tả tùy chọn truy cập; chúng không thay thế nguồn kỹ thuật hay định giá tiêu chuẩn của nhà cung cấp.
Với tích hợp OpenAI trực tiếp, Luna hỗ trợ công cụ tích hợp qua Responses API; gọi hàm của Chat Completions yêu cầu mức suy luận none. Haiku dùng Messages API của Anthropic và tư duy thích ứng. Một gateway không khiến schema nền tảng có thể hoán đổi: hãy xác thực định nghĩa công cụ, hành vi đầu ra có cấu trúc, sự kiện streaming và tính cước với đúng tuyến bạn định dùng.
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
Một so sánh thực tế có thể dùng gói hợp đồng nhà cung cấp chứa ngày hiệu lực, điều khoản gia hạn, thời hạn thông báo và ngoại lệ. Giữ nguyên gói tài liệu, hướng dẫn trích xuất, trường kỳ vọng và quy tắc xác thực. Sau đây là thiết kế đánh giá, không phải kết quả đo lường mới.
Ví dụ prompt: Trích xuất tên nhà cung cấp, ngày hiệu lực, ngày gia hạn, thời hạn thông báo chấm dứt và ngoại lệ về giá của mỗi hợp đồng. Với mỗi giá trị trích xuất, dẫn nguồn tên tài liệu và đúng đoạn văn hỗ trợ. Trả về null khi trường vắng; không suy diễn ngày thiếu. Gắn cờ điều khoản xung đột và giữ câu trả lời cuối trong 1,000 từ.
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Trường bắt buộc khớp với đáp án chuẩn đã kiểm độc lập | Giá trị đúng, sai và thiếu |
| Grounding | Mỗi trường khác null có một đoạn hỗ trợ hợp lệ | Khẳng định không có căn cứ và trích dẫn tài liệu sai |
| Instruction following | Không bịa ngày; trường vắng trả về null | Lỗi lược đồ và vi phạm ràng buộc |
| Economics | Tính chi tiêu trên mỗi lần trích xuất được chấp nhận | Token đầu vào, đầu ra, suy luận bị tính phí, số lần lặp, chi phí dự phòng |
| Latency | So sánh thời gian hoàn tất công việc dưới cùng chính sách công cụ | Thời gian tới token đầu tiên và thời gian end-to-end |
Chạy hơn một gói đại diện và lặp lại các trường hợp có kết quả khác nhau. Bắt đầu với cùng mức nỗ lực khả dụng, sau đó thử cấu hình chi phí thấp hơn cho mỗi mô hình. Báo cáo kích thước mẫu, thiết lập, tuyến, ngày và số lỗi trước khi đưa ra “người thắng”.
Haiku 5.5 or GPT-6 Luna: Which to Choose?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | Điểm OSWorld (tín dụng từng phần) nghiêng về Haiku; xác minh hoàn tất tác vụ đầy đủ |
| Terminal coding | Claude Haiku 5.5 | Điểm Terminal-Bench nghiêng về Haiku; xác thực thay đổi trong kho mã |
| Short prompts and base prices | Thử cả hai | Cùng bậc giá cơ bản; so sánh mức sử dụng bị tính phí và số lần lặp |
| Prompts above 100K tokens | GPT-6 Luna ở mức tiêu chuẩn | Luna giữ bậc cơ bản lâu hơn; độ chính xác có thể làm thay đổi tổng chi phí |
| Streamed token throughput | Claude Haiku 5.5 trong ảnh chụp có ngày | Thông lượng khác với độ trễ hoàn tất đầy đủ |
| Simple repeated extraction | Thử Luna với mức suy luận thấp hoặc none | Chọn theo đầu ra hợp lệ được chấp nhận, không chỉ theo giá |
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
Bắt đầu với Haiku khi ứng dụng của bạn giống các tác vụ máy tính đồ họa, lập trình qua agent hoặc công việc chuyên nghiệp đã công bố, và tỷ lệ hoàn tất cao hơn có thể bù cho chi tiêu suy luận hoặc ngữ cảnh dài. Xác nhận lợi thế đó trên bộ công cụ của riêng bạn trước khi điều phối lưu lượng sản xuất.
Choose GPT-6 Luna for Large-Prompt Cost Control
Bắt đầu với Luna khi prompt thường vượt 100K token và chi phí token tiêu chuẩn ảnh hưởng đáng kể đến ngân sách. Đây cũng là ứng viên cho trích xuất lặp lại hoặc định tuyến có thể thành công với mức suy luận thấp hoặc none. Giữ khuyến nghị có điều kiện dựa trên tỷ lệ kết quả được chấp nhận và mức sử dụng thực tế bị tính phí.
Use Both When Workloads Have Different Needs
Một thí điểm có thể định tuyến trích xuất tài liệu dài sang Luna và tác vụ GUI hoặc terminal sang Haiku, rồi xác thực từng lựa chọn với các kiểm tra chấp nhận. Kích hoạt dự phòng khi đầu ra không đạt lược đồ, thiếu bằng chứng bắt buộc hoặc không vượt qua kiểm tra đặc thù tác vụ, và tính cả chi phí cùng độ trễ dự phòng vào so sánh.
Validate Before Switching
Bao gồm mô hình hiện tại làm đường cơ sở. Chỉ chuyển khi ứng viên đạt mục tiêu đúng đã định và cải thiện chi phí trên mỗi kết quả được chấp nhận hoặc độ trễ đầu-cuối đủ để bù cho chi phí di trú và bảo trì. Tạm dừng triển khai nếu lỗi công cụ nghiêm trọng tăng.
- Dùng mẫu khối lượng công việc đại diện và chấm số kết quả đúng, sai, và thiếu.
- Đo thời gian tới token đầu tiên, thời gian hoàn tất tác vụ và độ tin cậy công cụ.
- Theo dõi riêng token đầu vào, cache, đầu ra và suy luận.
- Tính chi phí trên mỗi kết quả thành công, gồm số lần lặp và dự phòng.
- So sánh mức nỗ lực trung bình và cao trước khi bật mức tối đa theo mặc định.
Conclusion
Claude Haiku 5.5 có bằng chứng đối đầu mạnh hơn qua các benchmark công việc chuyên nghiệp, tương tác máy tính và lập trình qua agent được so sánh ở đây. Mô hình cũng có thông lượng đầu ra cao hơn trong ảnh chụp độc lập. GPT-6 Luna có lợi thế rõ ràng về mức giá tiêu chuẩn cho prompt vượt ngưỡng 100K của Haiku và chi phí có trọng số cho tác vụ đánh giá thấp hơn. Không quan sát nào tự thân quyết định độ tin cậy sản xuất hay chi phí trên mỗi kết quả thành công.
Người thắng thực tế là mô hình mang lại kết quả chấp nhận được với chi phí vận hành đo lường đầy đủ thấp nhất. Hãy chạy cả hai trên prompt, công cụ và quy tắc lặp lại của riêng bạn thay vì coi một benchmark đơn lẻ là câu trả lời.
FAQ
Vì sao chi phí tác vụ có thể khác khi cả hai mô hình có giá token cơ bản giống nhau?
Cùng giá cơ bản không đồng nghĩa tổng hóa đơn giống nhau. Các mô hình có thể dùng lượng token đầu vào, đầu ra và suy luận khác nhau, và có thể cần số lần lặp hoặc gọi công cụ khác nhau để tạo ra kết quả chấp nhận được. Mức giá ngữ cảnh dài và việc dùng cache cũng ảnh hưởng tổng chi phí. Hãy so sánh tổng chi phí của tất cả lần thử chia cho số kết quả được chấp nhận, thay vì chỉ giá token.
Mức giá ngữ cảnh dài có chỉ áp dụng cho phần token vượt ngưỡng không?
Không. Theo mức giá tiêu chuẩn trong bài viết, vượt ngưỡng đầu vào sẽ áp dụng mức giá cao hơn cho toàn bộ yêu cầu, không chỉ phần vượt. Ví dụ, yêu cầu 150K token đầu vào vượt ngưỡng 100K của Haiku nhưng vẫn trong bậc cơ bản 272K của Luna. Hãy dùng mức giá đầu vào và đầu ra áp dụng cho cả yêu cầu khi ước tính chi phí.
Claude Haiku 5.5 và GPT-6 Luna có thể dùng chung cache prompt không?
Đừng giả định mục cache chuyển giữa mô hình hay nhà cung cấp. Hãy thiết kế chiến lược tái sử dụng riêng, rồi đo tỷ lệ trúng và mức sử dụng bị tính phí trên từng tuyến. Hỗ trợ gateway, quy tắc lưu giữ và cấu trúc yêu cầu có thể ảnh hưởng việc đầu vào lặp có đủ điều kiện cache hay không; hãy xác minh trước khi dự báo tiết kiệm.
Bài kiểm thử di trú từ Haiku sang Luna nên bao quát gì?
Kiểm thử đầu vào văn bản và hình ảnh đại diện, các trường có cấu trúc bắt buộc, tham số công cụ, phản hồi streaming và khôi phục lỗi. Thiết lập tỷ lệ chấp nhận của hệ thống hiện tại trước khi di trú, rồi so sánh cả hai ứng viên dưới cùng chính sách lặp lại và công cụ. Giá token tương tự hoặc cùng loại mô hình không xác lập khả năng tương thích.
Có nên dùng điểm benchmark để kích hoạt dự phòng giữa Haiku hoặc Luna?
Dùng điểm số để chọn ứng viên, rồi kích hoạt dự phòng khi quan sát thất bại như tham số công cụ không hợp lệ, thiếu trường bắt buộc hoặc không đạt kiểm tra tác vụ. Theo dõi tần suất dự phòng và tổng chi phí bị tính. Một mô hình thứ hai có thể tăng độ trễ và chi phí, vì vậy hãy xác minh nó cải thiện kết quả được chấp nhận thay vì chỉ tạo câu trả lời thứ hai.
Dữ liệu nhạy cảm có thể đi qua cả hai API không?
Xem xét kỹ nhà cung cấp và gateway cụ thể liên quan, thiết lập lưu giữ hiện tại, địa điểm xử lý, điều khoản hợp đồng và chính sách dữ liệu của tổ chức bạn trước khi gửi đầu vào nhạy cảm. Năng lực mô hình và bảng giá không xác lập khả năng đáp ứng yêu cầu dữ liệu nhạy cảm hay tuân thủ. Hãy dùng tuyến đã được phê duyệt khi các yêu cầu đó là quyết định.