
TL;DR
Google đã công bố Gemini 4 Argon vào ngày 30 tháng 9, 2026 như một mô hình tiên phong dành cho các quy trình phức tạp, chạy lâu. Kết quả công bố cho thấy một mô hình rõ rệt: hiệu năng mạnh trong công việc tri thức chuyên nghiệp, nhiệm vụ ngữ cảnh dài và một số đánh giá kỹ nghệ phần mềm chọn lọc, trong khi yếu hơn ở một số benchmark terminal và sử dụng máy tính. Google giới thiệu mô hình theo từng giai đoạn. Riêng CometAPI báo cáo tình trạng có trong danh mục kể từ ngày 1 tháng 10; cần kiểm tra điều kiện tài khoản và một yêu cầu thử thành công trước khi triển khai. Câu chuyện hiệu năng hữu ích hơn là nơi các cải thiện xuất hiện.
Argon đạt 68.9% trên Vals Index, 65.4% trên Vals Finance Agent v2, 77.9% trên DeepSWE v1.1, 91.7% trên LVBench và 84.2% trên GraphWalks ở 256K–1M ngữ cảnh. Đồng thời, nó tụt hậu so với các mô hình tiên phong cạnh tranh trên FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science và OSWorld-2.0.
Các kết quả ủng hộ cách nhìn theo khối công việc đối với Argon. Các điểm mạnh nhất tập trung quanh công việc tri thức chuyên nghiệp, nhiệm vụ ngữ cảnh rất dài và các đánh giá đa phương thức cùng kỹ nghệ phần mềm được chọn. Các mô hình khác vẫn có lợi thế trên một số bài kiểm tra terminal và sử dụng máy tính.
Key Takeaways
- Gemini 4 Argon mạnh nhất trong công việc tri thức doanh nghiệp, lập luận ngữ cảnh dài, hiểu đa phương thức và một số đánh giá mã hóa tầm nhìn dài.
- Giới hạn đầu ra tối đa 1 triệu token cung cấp thêm không gian tạo sinh cho các quỹ đạo lập luận dài; không công bố đặc tả ngữ cảnh đầu vào công khai.
- Argon dẫn đầu một số kết quả công việc tri thức và ngữ cảnh dài đã công bố, nhưng GPT-6 Astra và Claude Opus 5.5 vẫn vượt trội ở một số đánh giá mã hóa và sử dụng máy tính.
- Điểm benchmark phản ánh cấu hình mô hình-và-tác tử cụ thể. Thước đo, điều kiện đầu vào và thiết lập đánh giá quan trọng ngang với các tỷ lệ phần trăm tiêu đề.
- Lộ trình triển khai của Google và quyền truy cập qua CometAPI là hai tuyên bố khả dụng riêng biệt. Xác minh tuyến hoạt động, định danh mô hình và điều kiện tài khoản trước khi chuyển lưu lượng.
What Is Gemini 4 Argon?
Gemini 4 Argon là mô hình Gemini tiên phong mới của Google DeepMind, được xây dựng cho các quy trình khó đòi hỏi lập luận qua nhiều bước thay vì trả lời một lời nhắc ngắn.
Định vị chính thức của Google nhấn mạnh kỹ nghệ phần mềm thực tế, công việc tri thức doanh nghiệp như pháp lý và tài chính, an ninh mạng phòng thủ, hiểu đa phương thức và các tác vụ tác tử chạy dài.
Đây là khác biệt quan trọng so với các bản Flash gần đây. Gemini 3.8 Flash API trong CometAPI được thiết kế như một “ngựa thồ” chi phí thấp cho khối lượng tác tử ở quy mô. Ngược lại, Argon đại diện cho tầng tiên phong trong ngăn xếp của Google, ưu tiên chiều sâu và thực thi bền bỉ.
Model Specifications
| Thông số | Gemini 4 Argon |
|---|---|
| Nhà phát triển | Google DeepMind |
| Công bố | 30 tháng 9, 2026 |
| Họ mô hình | Gemini 4 |
| Định vị | Mô hình lập luận tiên phong và tầm nhìn dài |
| Đầu ra tối đa | 1,000,000 tokens |
| Đánh giá ngữ cảnh dài | Đã thử nghiệm qua 256K–1M trên GraphWalks |
| Giới hạn ngữ cảnh đầu vào công khai | Chưa được nêu chính thức trong bảng đặc tả API công khai khi ra mắt |
| Hiểu đa phương thức | Có; bao gồm biểu đồ, tài liệu và đánh giá video dài |
| Mã hóa tác tử | Có |
| Sử dụng máy tính | Đã được đánh giá |
| An ninh mạng | Năng lực phòng thủ chuyên biệt |
| Google public API model ID | Chưa công bố trong tài liệu công khai ban đầu của Google; CometAPI dùng gemini-4-argon làm định danh danh mục. |
Output Budget and Trade-offs
Google công bố giới hạn đầu ra tối đa 1 triệu token cho Argon, tăng từ mức 64K nêu trong thông báo ra mắt trước đó. Điều này cung cấp không gian cho các quỹ đạo lập luận dài hơn. Không nên diễn giải đây là ngân sách tổng đảm bảo cho toàn bộ phiên tác tử nhiều lần gọi, hoặc là bằng chứng rằng mọi tác vụ đều sẽ cải thiện.
Đầu ra tối đa không đồng nghĩa với trí tuệ. Cho mô hình nhiều token đầu ra hơn không tự động làm nó mạnh hơn; nó chỉ loại bỏ một nút thắt cổ chai tiềm năng. Mô hình vẫn phải sử dụng ngân sách đó một cách hiệu quả.
Cũng có đánh đổi về chi phí và độ trễ. Một mô hình thực sự tiêu thụ hàng trăm nghìn token sinh ra có thể đắt và chậm ngay cả khi giá danh nghĩa mỗi token có vẻ hấp dẫn.

Các kết quả benchmark chọn lọc được tái tạo từ bài viết. So sánh các mô hình trong từng hàng; thước đo và điều kiện đánh giá khác nhau. Biểu đồ này thay thế hình nền gradient trang trí và không đại diện cho kiểm thử độc lập.
Giới hạn đầu ra tối đa và cửa sổ ngữ cảnh đầu vào mô tả các năng lực khác nhau. Dải đánh giá GraphWalks là bằng chứng về các đầu vào đã thử nghiệm, không thay thế cho một đặc tả API công khai.
How Does Gemini 4 Argon Perform on Benchmarks?
Bảng hiệu năng của Google DeepMind bao phủ quy trình tác tử, công việc tri thức chuyên nghiệp và tác vụ đa phương thức. Các giá trị dưới đây tái hiện phép so sánh đã công bố. Chúng đo hiệu suất nhiệm vụ, không phải thông lượng token hay độ trễ phản hồi; “—” nghĩa là không có kết quả trong phép so sánh này.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Điều kiện đánh giá |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Bộ riêng; bảng xếp hạng Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; nguồn hỗn hợp |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Bảng xếp hạng Proximal |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Bảng xếp hạng Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Tự kiểm thử / bảng xếp hạng |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; một H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Công cụ Linux; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Bảng xếp hạng Surge |
| GraphWalks đến 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 mục |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 mục |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Đỗ/trượt nhị phân; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Điểm một phần offline; tốt nhất trong 3 lần |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Không công cụ; bảng xếp hạng Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Không công cụ; lấy mẫu khung theo mô hình |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 phá vỡ thế hòa |
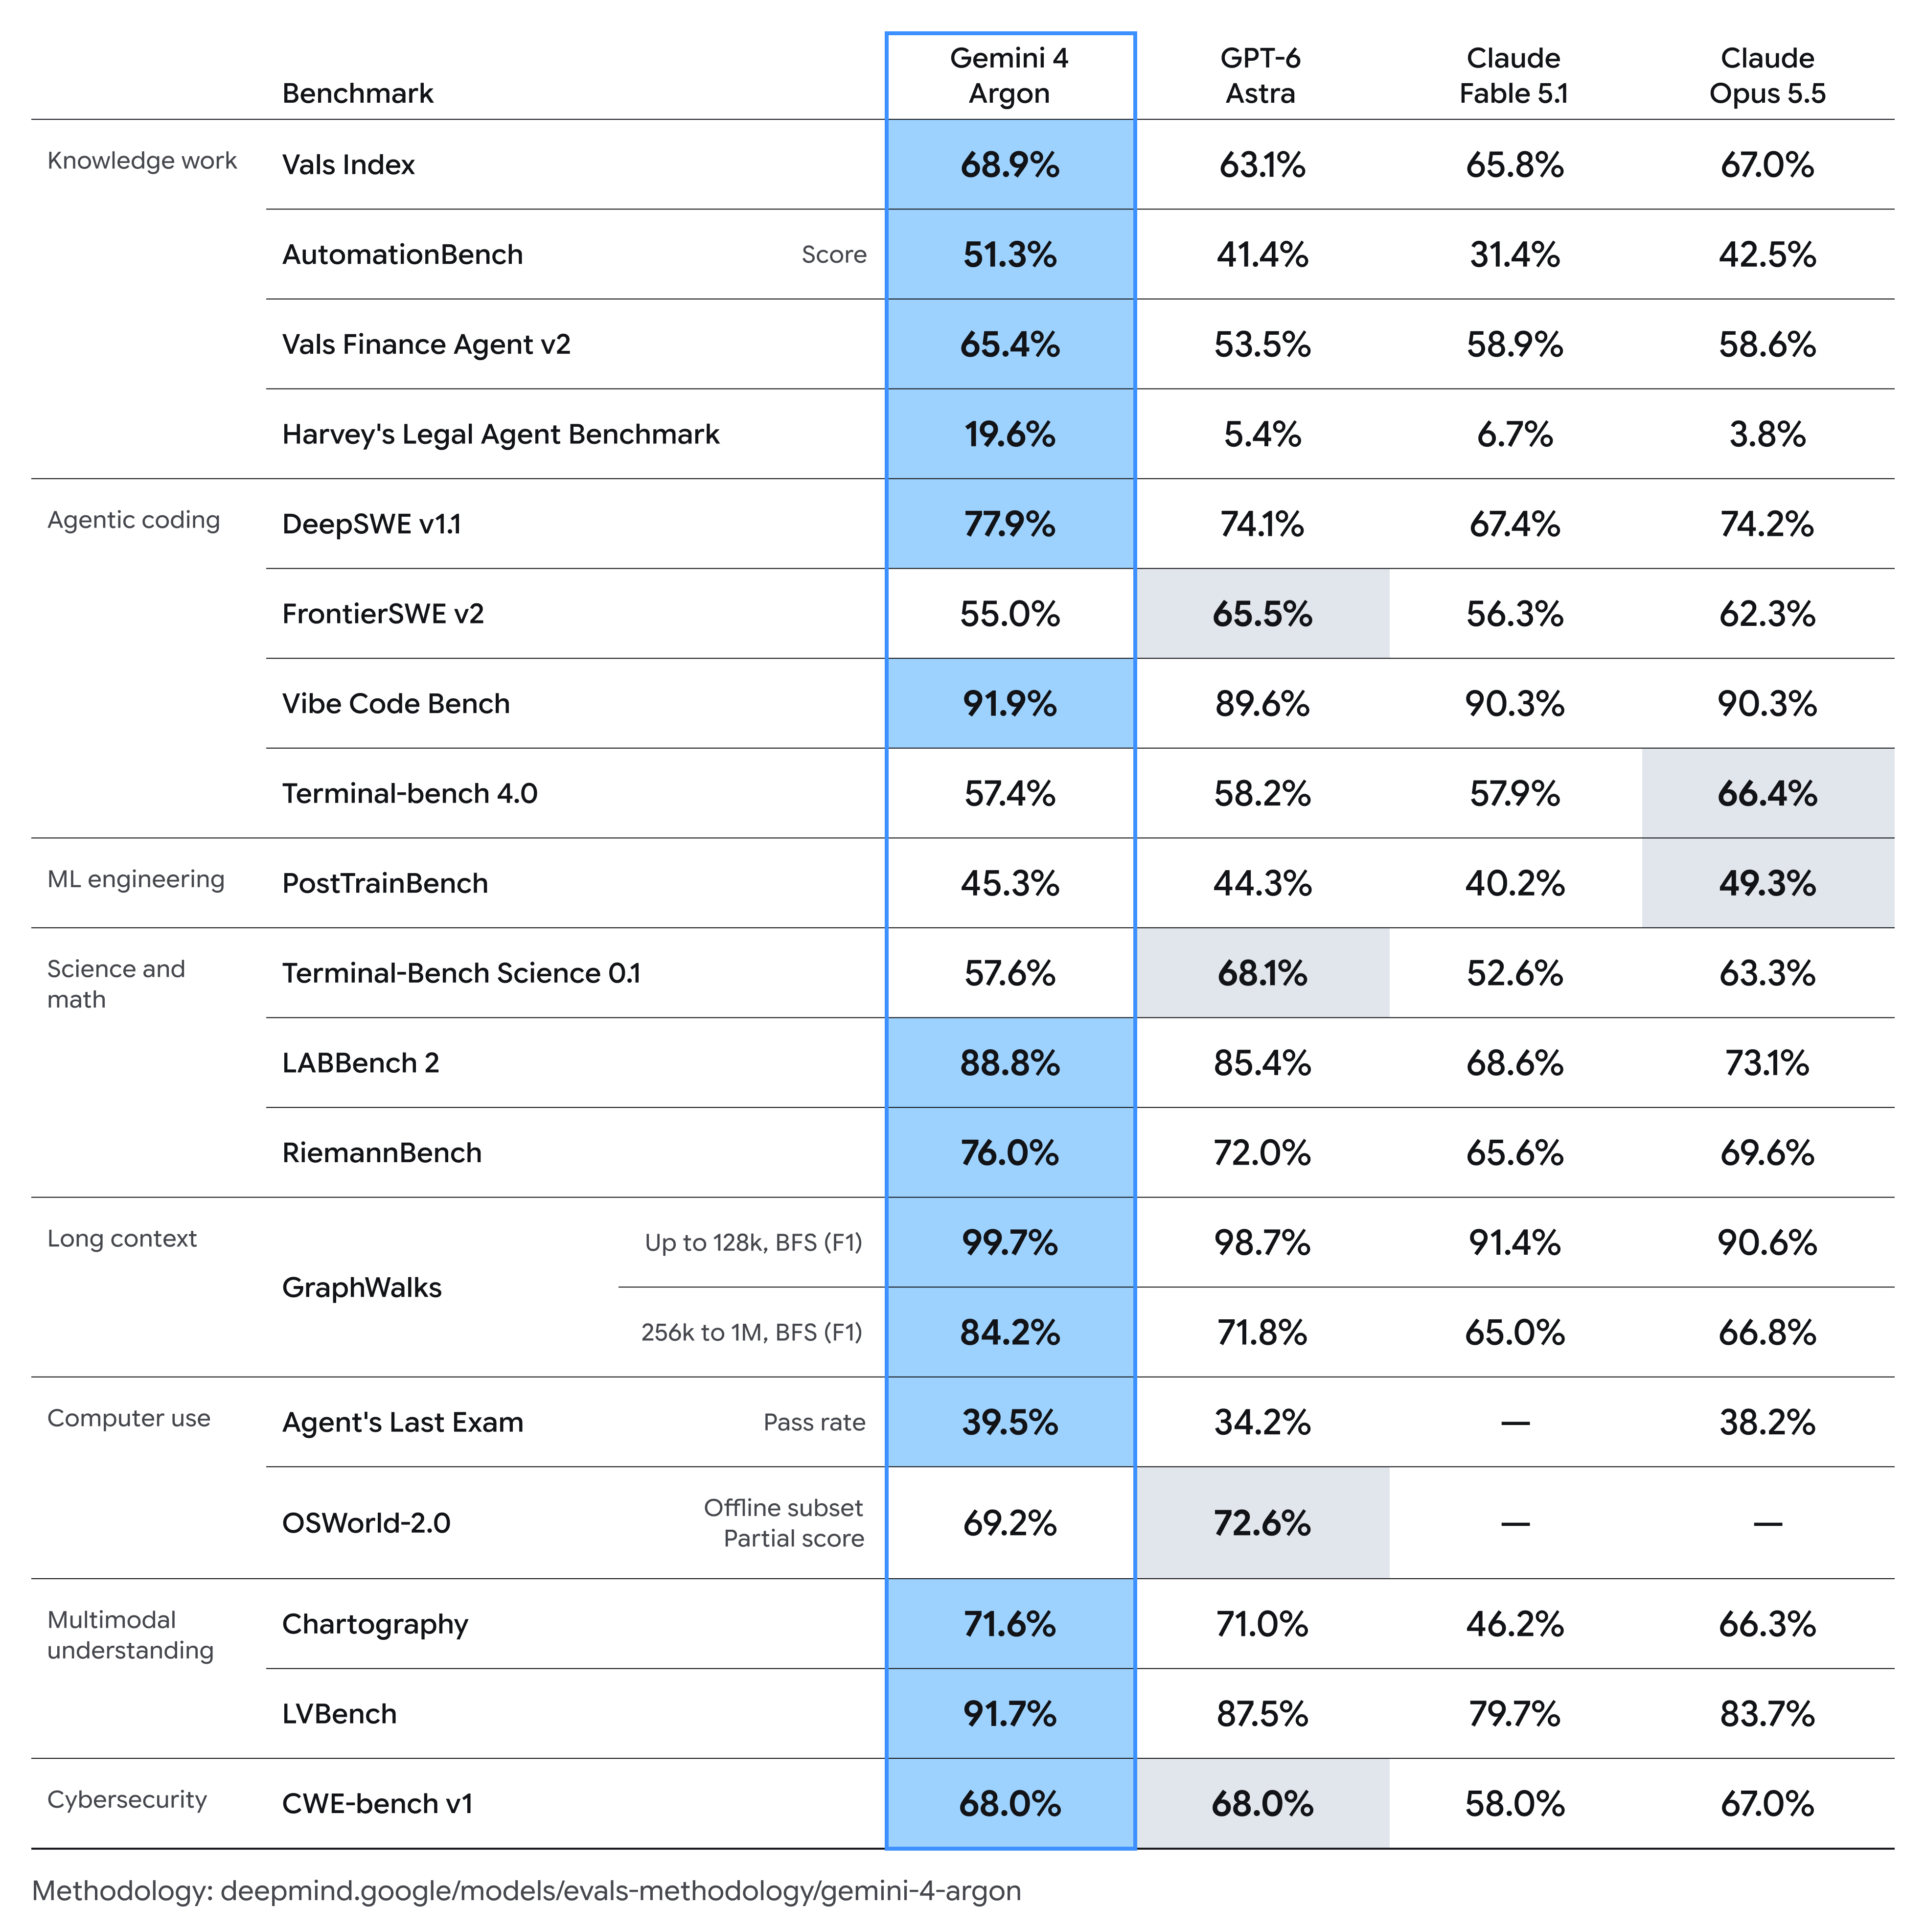
So sánh benchmark chính thức của Google cho Gemini 4 Argon
Trừ khi được ghi chú khác, các kết quả Argon dùng một lần thử và thiết lập “thinking” cao nhất. Kết quả các mô hình khác thường đến từ báo cáo của nhà cung cấp, với ngoại lệ theo từng benchmark. LVBench dùng 1 FPS cho Gemini, 800 khung cho GPT-6 Astra, 300 cho Fable 5.1 và 600 cho Opus 5.5. Đây không phải các đầu vào giống hệt, vì vậy hãy so sánh các cấu hình báo cáo thay vì coi mỗi hàng như một lần chạy được kiểm soát.
Evaluation Conditions and Limitations
Bảng này hữu ích, nhưng không nên được diễn giải như một bảng xếp hạng độc lập, phổ quát.
- Tập benchmark là do Google lựa chọn.
- Thiết lập đánh giá theo từng benchmark khác nhau giữa các hàng, bao gồm khung tác tử, ngân sách thời gian, công cụ và cách lấy mẫu đầu vào.
- Phương pháp chính thức xác định kết quả đối thủ do nhà cung cấp báo cáo là mặc định, với ngoại lệ theo từng benchmark về bảng xếp hạng và tự tính.
- Thiết lập benchmark cao nhất có thể không phản ánh cấu hình suy luận sản xuất mặc định.
- Một điểm benchmark tiêu đề không tiết lộ mức dùng token, số lần gọi công cụ, số lần thử lại, thời gian trôi qua hoặc can thiệp của con người.
Đối với hệ thống sản xuất, thước đo tốt hơn thường là chi phí trên mỗi nhiệm vụ hoàn thành thành công thay vì giá mỗi token hoặc một tỷ lệ phần trăm benchmark.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Mẫu rõ nhất trong kết quả của Argon xuất hiện ở công việc tri thức chuyên nghiệp nhiều bước.
Trên Vals Index, Argon đạt 68.9%, so với 67.0% của Claude Opus 5.5. Khoảng cách số liệu khiêm tốn, nhưng mẫu trở nên rõ hơn ở các quy trình chuyên biệt.
- Vals Finance Agent v2: 65.4%, cao hơn 6.5 điểm so với đối thủ mạnh nhất được nêu trong bảng của Google.
- AutomationBench: 51.3%, cao hơn 8.8 điểm so với Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19.6%, so với 6.7% của mô hình báo cáo cao tiếp theo.
Hồ sơ hiệu năng gợi ý rằng Argon hưởng lợi nhiều nhất khi mô hình phải thu thập thông tin, giữ trạng thái, lập luận qua nhiều giai đoạn và tạo ra một sản phẩm chuyên nghiệp thay vì chỉ trả lời một câu hỏi đóng.
Cũng quan trọng là điểm tuyệt đối thấp ở legal-agent. Điểm 19.6% tự thân không tiết lộ có bao nhiêu tiêu chí hoặc quy trình hoàn chỉnh thất bại. Kết luận hữu ích là Argon cho thấy cải thiện tương đối lớn trên đánh giá này, trong khi kết quả không xác lập khả năng tự động hóa công việc pháp lý đáng tin cậy.
Long-Context Reasoning
Lợi thế ấn tượng nhất của Argon có thể là phiên bản 256K–1M của GraphWalks.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Đó là chênh lệch 12.4 điểm so với mô hình gần nhất trong phép so sánh đã công bố.
Khoảng cách nhỏ hơn nhiều ở độ dài ngữ cảnh ngắn hơn: trên GraphWalks đến 128K, Argon đạt 99.7% và GPT-6 Astra đạt 98.7%. Điều này cho thấy Argon suy giảm ít hơn so với các mô hình so sánh trên đánh giá ngữ cảnh rất dài cụ thể này.
Những gì Google chưa tiết lộ là đủ thông tin kiến trúc để quy kết sự khác biệt này cho một cơ chế attention cụ thể, hệ thống truy xuất, công thức huấn luyện hoặc chiến lược thời gian suy luận. Các tuyên bố như “Gemini 4 giới thiệu kiến trúc attention mới” vì vậy sẽ vượt quá bằng chứng công khai.
Coding Performance
Bảng benchmark chính thức không hỗ trợ một câu trả lời đơn giản.
Argon thể hiện cực tốt trên một số hình thức mã hóa và thua rõ trên các hình thức khác. Trên DeepSWE v1.1 nó đạt 77.9%, so với 74.2% của Claude Opus 5.5 và 74.1% của GPT-6 Astra. Điểm Vibe Code Bench cũng mạnh ở 91.9%.
- FrontierSWE v2: 55.0% Argon so với 65.5% GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% Argon so với 66.4% Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% Argon so với 68.1% GPT-6 Astra.
Sự phân hóa này quan trọng đối với nhà phát triển. Argon có vẻ đặc biệt mạnh khi mã hóa trở thành một quy trình kỹ thuật dài với ngữ cảnh và lập kế hoạch đáng kể, trong khi thực thi nặng về terminal vẫn cạnh tranh gay gắt. Một benchmark di trú kho mã và một benchmark terminal tương tác không nên được coi là thước đo thay thế cho “năng lực mã hóa”.
Defensive Cybersecurity
An ninh mạng là lĩnh vực triển khai cốt lõi. Định vị an ninh mạng phòng thủ của Google bao gồm phát hiện, xác thực và vá lỗ hổng tự động. Đây là tuyên bố năng lực của nhà cung cấp; kết quả CWE-bench dưới đây đo khả năng khắc phục lỗ hổng trên đánh giá riêng.
Trên CWE-bench v1, Argon đạt 68%, ngang bằng GPT-6 Astra và nhỉnh hơn nhẹ Claude Opus 5.5 ở 67%.
Google cũng nhấn mạnh các biện pháp bảo vệ mạnh hơn chống lạm dụng, tiêm lệnh gián tiếp, hành vi tác tử rủi ro và xâm phạm môi trường thực thi. Điều này khiến Argon vừa là một bản phát hành tập trung an ninh tác tử, vừa là nâng cấp mô hình thông thường.
Multimodal Understanding
Argon đạt 71.6% trên Chartography và 91.7% trên LVBench cho hiểu video dài. Kết quả LVBench cao hơn GPT-6 Astra 4.2 điểm trong bảng của Google. Do các mô hình nhận cấu hình lấy mẫu khung khác nhau, đây là phép so sánh các thiết lập báo cáo thay vì lợi thế thuần mô hình.
Điều này quan trọng vì nhiều quy trình chuyên nghiệp không chỉ có văn bản. Một tác tử nghiên cứu tài chính có thể cần xem một biểu đồ; một trợ lý doanh nghiệp có thể kết hợp báo cáo, PDF và ảnh chụp màn hình; hệ thống phân tích video có thể cần bảo toàn sự kiện qua chuỗi dài thay vì xử lý độc lập từng khung.
Sự kết hợp giữa tri giác đa phương thức và lập luận bền bỉ của Argon vì vậy phù hợp hơn là chỉ hỗ trợ đa phương thức.
Science and Mathematics Performance
Kết quả pha trộn nhưng nhìn chung mạnh. Argon đạt 88.8% trên LABBench 2 và 76.0% trên RiemannBench, vượt các mô hình so sánh trong bảng của Google. Tuy nhiên, trên Terminal-Bench Science 0.1, GPT-6 Astra đạt 68.1% so với 57.6% của Argon.
Khác biệt đó gợi ý một mẫu rộng hơn: Argon có vẻ mạnh hơn trong lập luận trên thông tin khoa học so với mọi hình thức thực thi khoa học dựa trên công cụ.
Computer-Use Performance
Trên Agent's Last Exam, Argon đạt tỷ lệ đỗ nhị phân 39.5%, vượt GPT-6 Astra ở 34.2% và Claude Opus 5.5 ở 38.2%. Trên tập con offline của OSWorld-2.0, điểm một phần là 69.2%, thấp hơn 72.6% của GPT-6 Astra. Giá trị OSWorld không phải tỷ lệ thành công toàn tác vụ, và các mục thiếu của Claude không ngụ ý năng lực bằng không.
Vì vậy dữ liệu hiện tại không cho thấy một lợi thế sử dụng máy tính toàn diện. Đối với triển khai sản xuất, điểm benchmark nên được bổ sung bằng kiểm thử cấp nhiệm vụ về độ chính xác điều hướng, số lần nhấp lỗi, tần suất thử lại, hành động ngoài ý muốn, thời gian hoàn thành và tỷ lệ chỉnh sửa của con người.
Gemini 4 Argon vs GPT-6 Astra and Claude
| Khía cạnh | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Công việc tri thức | Rất mạnh | Mạnh | Rất mạnh | Mạnh |
| Benchmark ngữ cảnh dài | Mạnh nhất đã công bố | Mạnh | Trung bình–mạnh | Trung bình |
| Mã hóa tầm nhìn dài | Rất mạnh | Rất mạnh | Rất mạnh | Mạnh |
| Mã hóa trên terminal | Cạnh tranh | Mạnh | Mạnh nhất ở bài chọn lọc | Cạnh tranh |
| Tác tử khoa học trên terminal | Cạnh tranh | Mạnh nhất ở bài chọn lọc | Mạnh | Cạnh tranh |
| Hiểu đa phương thức | Rất mạnh | Rất mạnh | Mạnh | Cạnh tranh |
| Sử dụng máy tính | Cạnh tranh | Mạnh | Hỗn hợp / so sánh hạn chế | So sánh hạn chế |
| An ninh mạng | Đồng hạng đầu trên CWE-bench v1 | Đồng hạng đầu | Rất sát | Thấp hơn |
Argon nổi bật trong so sánh này ở ngữ cảnh dài, tài liệu dày đặc và công việc tác tử chuyên nghiệp. Nhà phát triển có thể so sánh nó với GPT-6 Astra, Claude Opus 5.5 và Claude Fable 5.1 qua CometAPI.
Performance-based selection
Các nhãn định tính trên tóm lược bảng benchmark chọn lọc, không phải xếp hạng phổ quát. Ưu tiên Argon cho thử nghiệm thí điểm khi công việc giống với các đánh giá mà nó dẫn đầu; thử Astra và Opus trên khối lượng công việc nặng terminal trước khi chọn mặc định.
Specifications and deployment constraints
So sánh hiệu năng này không xác lập lợi thế kiến trúc hay người chiến thắng chung về giá–hiệu năng. Số tham số và kiến trúc của Argon không được nêu trong tài liệu ra mắt của Google đã xem xét. Giới hạn ngữ cảnh đầu vào công khai của nó cần tài liệu API chính thức. CometAPI báo cáo tuyến gemini-4-argon; xác nhận các tham số hỗ trợ và quyền truy cập tài khoản độc lập với lộ trình triển khai rộng hơn của Google. So sánh giới hạn mỗi tuyến và chi phí nhiệm vụ thực tế trước khi triển khai.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI báo cáo mô hình khả dụng dưới định danh gemini-4-argon. Dùng bảng điều khiển tài khoản để tạo khóa API, chọn định danh đó trong playground và chạy một yêu cầu thử trước khi tích hợp. Ví dụ tương thích OpenAI sử dụng base URL https://api.cometapi.com/v1. Xác nhận endpoint và tham số được hỗ trợ của mô hình trong tài liệu tài khoản; một huy hiệu danh mục đơn lẻ không xác minh một lệnh gọi thành công.
- Tạo tài khoản CometAPI và sinh khóa API trong bảng điều khiển.
- Chọn gemini-4-argon và xác nhận một yêu cầu đại diện trong playground.
- Cấu hình client tương thích với base URL của CometAPI, khóa của bạn và định danh mô hình; xác nhận schema yêu cầu và thanh toán trước khi triển khai.
CometAPI and official pricing
Google công bố giá mở đầu $2 mỗi triệu token đầu vào và $10 mỗi triệu token đầu ra, với đầu vào được cache giảm 95% so với giá đầu vào. Sau giai đoạn mở đầu, mức công bố là $4 đầu vào và $20 đầu ra mỗi triệu token. Đây là mức Google công bố, không phải giá CometAPI hay xác nhận quyền truy cập API chung ngay lập tức.
| Cơ sở tính phí | Gemini 4 Argon API trong CometAPI | Thông báo chính thức của Google | So sánh |
|---|---|---|---|
| Đầu vào / 1M tokens | $3.20 | $4.00 sau giai đoạn mở đầu | Thấp hơn 20% so với mức sau mở đầu |
| Đầu ra / 1M tokens | $16.00 | $20.00 sau giai đoạn mở đầu | Thấp hơn 20% so với mức sau mở đầu |
Conclusion
Hồ sơ benchmark của Gemini 4 Argon thú vị hơn một tuyên bố bảng xếp hạng đơn giản.
Các kết quả mạnh nhất trong phép so sánh này tập trung quanh công việc tri thức chuyên nghiệp, ngữ cảnh dài và thực thi tác tử bền bỉ. Mẫu này hữu ích cho lựa chọn khối công việc, nhưng không xác định kiến trúc nền tảng hoặc chứng minh cơ chế nào gây ra cải thiện.
Các kết quả tài chính, pháp lý, video dài và kỹ nghệ phần mềm hỗ trợ một thử nghiệm thí điểm tập trung cho các khối công việc đó. Liệu lợi thế tương tự có bền vững trong sản xuất hay không phụ thuộc vào tổ hợp đầu vào, khung tác tử, thiết lập suy luận và yêu cầu xác minh.
Đồng thời, kết quả cho thấy hiệu năng mô hình tiên phong ngày càng chuyên biệt. Argon có thể dẫn đầu DeepSWE trong khi tụt trên FrontierSWE; dẫn Agent's Last Exam trong khi tụt trên OSWorld; và dẫn LABBench trong khi tụt trên Terminal-Bench Science. Các benchmark này nhấn mạnh các bộ phận khác nhau của một hệ thống tác tử.
Đối với nhà phát triển, bài học quan trọng nhất là lựa chọn mô hình ngày càng cần diễn ra ở cấp khối công việc thay vì theo thương hiệu hay họ mô hình.
FAQ
Các nhà phát triển nên xác thực Gemini 4 Argon trên khối công việc của riêng mình như thế nào?
Xây dựng một tập nhiệm vụ đại diện với tiêu chí chấp nhận rõ ràng. Giữ công cụ, giới hạn thời gian, chuẩn bị đầu vào và chính sách thử lại tương đương giữa các mô hình. Ghi lại nhiệm vụ hoàn thành, tổng token, thời gian trôi qua và chỉnh sửa của con người. Bắt đầu với thí điểm nhỏ và xem xét các ca thất bại trước khi định tuyến lưu lượng sản xuất.
Có thể lấy trung bình các phần trăm benchmark của Gemini 4 Argon thành một điểm số không?
Không. Bảng kết hợp các thước đo khác nhau, bao gồm F1, tỷ lệ pass và điểm một phần. Dùng tiêu chí theo từng nhiệm vụ thay vì lấy trung bình tất cả phần trăm.
Một tác tử Gemini 4 Argon có nên luôn dùng hết ngân sách đầu ra không?
Không. Chọn ngân sách nhỏ nhất đã thử nghiệm đáp ứng yêu cầu chất lượng và độ tin cậy của bạn. Giới hạn đầu ra tối đa là trần, không phải mục tiêu.
Các nhóm nên đánh giá quyền truy cập Gemini 4 Argon qua CometAPI như thế nào?
Bắt đầu bằng kiểm tra khả dụng ở cấp tài khoản và một yêu cầu nhỏ sử dụng tuyến CometAPI đã được ghi tài liệu. Đo chất lượng phản hồi, độ trễ, giới hạn và token tính phí, rồi áp dụng cùng tiêu chí chấp nhận dùng cho các mô hình thay thế. Xem tuyên bố quyền truy cập của CometAPI tách biệt với lộ trình triển khai rộng hơn của Google, và giữ cấu hình định tuyến có thể thay đổi cho đến khi tuyến đáp ứng yêu cầu của bạn.