Thông số kỹ thuật của Qwen3.8-Flash
| Thông số | Qwen3.8-Flash |
|---|---|
| Nhà cung cấp | Alibaba / Qwen |
| Dòng mô hình | Qwen3.8 |
| ID mô hình | qwen3.8-flash |
| Loại mô hình | Mô hình lập luận đa phương thức |
| Phương thức đầu vào | Văn bản, hình ảnh, video |
| Phương thức đầu ra | Văn bản |
| Cửa sổ ngữ cảnh | 1,000,000 tokens |
| Đầu ra tối đa | 128,000 tokens |
| Ngân sách lập luận tối đa | 262,144 tokens |
| Chế độ tư duy | Được hỗ trợ |
| Gọi hàm | Được hỗ trợ |
| Công cụ tích hợp | Được hỗ trợ |
Tài liệu API hiện tại của Qwen liệt kê qwen3.8-flash là một mô hình Qwen3.8 dùng trong sản xuất với cửa sổ ngữ cảnh 1M token và đầu ra tối đa 128K. Mô hình hỗ trợ đầu vào văn bản, hình ảnh và video, gọi hàm, công cụ tích hợp và đầu ra có cấu trúc.
Đối với các tác vụ thị giác, giới hạn được ghi nhận bao gồm tối đa 16 megapixel cho mỗi ảnh, tối đa 2,048 URL ảnh hoặc 250 ảnh Base64, và tối đa 64 video, với thời lượng video lên đến 2 giờ.
Qwen3.8-Flash là gì?
Qwen3.8-Flash là mô hình lập luận đa phương thức tối ưu chi phí của Alibaba trong họ Qwen3.8, được thiết kế cho lập trình, các luồng công việc agent, phân tích ngữ cảnh dài và hiểu thị giác. Mô hình cung cấp cùng lớp ngữ cảnh 1M token như Qwen3.8-Max nhưng hướng tới chi phí API thấp hơn đáng kể. Hướng dẫn dành cho nhà phát triển của Qwen khuyến nghị rõ ràng Qwen3.8-Flash khi người dùng muốn khả năng tương tự với mức giá thấp hơn, trong khi Qwen3.8-Max được định vị là lựa chọn có năng lực lập luận mạnh hơn.
Mô hình đặc biệt đáng chú ý vì “Flash” không đồng nghĩa với một mô hình nhỏ đơn giản. Mô hình API dùng trong sản xuất kết hợp lập luận ngữ cảnh dài, đầu vào đa phương thức, sử dụng công cụ và đầu ra có cấu trúc trong một endpoint tương đối tiết kiệm.
Những tính năng chính của Qwen3.8-Flash là gì?
- Ngữ cảnh 1M token: Qwen3.8-Flash có thể xử lý các tài liệu và codebase cực dài, phù hợp cho phân tích kho lưu trữ và các phiên agent kéo dài.
- Hiểu đa phương thức: API chấp nhận văn bản, hình ảnh và video, cho phép nhà phát triển kết hợp mã, ảnh chụp màn hình, biểu đồ, tài liệu và video trong một quy trình.
- Chế độ tư duy: Mô hình hỗ trợ chế độ tư duy của Qwen, với ngân sách lập luận tối đa được ghi nhận là 262,144 token.
- Hỗ trợ agent và công cụ: Gọi hàm và công cụ tích hợp được hỗ trợ, bao gồm các khả năng như tìm kiếm web, thực thi mã và các công cụ do Qwen lưu trữ liên quan.
- Đầu ra có cấu trúc: Nhà phát triển có thể yêu cầu phản hồi có cấu trúc, giúp mô hình dễ tích hợp hơn vào các ứng dụng yêu cầu JSON hoặc kết quả bị ràng buộc theo lược đồ.
- Hiểu video dài: Tài liệu API thị giác liệt kê đầu vào video lên đến hai giờ, khiến Qwen3.8-Flash hữu ích cho phân tích video thay vì chỉ các tác vụ chú thích hình ảnh ngắn.
Những trường hợp sử dụng tốt nhất cho Qwen3.8-Flash là gì?
Lập trình và Kỹ thuật phần mềm
Cửa sổ ngữ cảnh 1M token hữu ích cho các kho lớn, phiên gỡ lỗi dài và phân tích mã đa tệp. Hỗ trợ gọi hàm và lập luận cũng khiến mô hình phù hợp cho các agent lập trình thay vì chỉ hoàn thành mã.
Luồng công việc agent
Qwen3.8-Flash hỗ trợ gọi hàm và công cụ tích hợp, cho phép ứng dụng để mô hình truy xuất thông tin, thực thi mã hoặc tương tác với các hệ thống bên ngoài.
Phân tích tài liệu dài
Cửa sổ ngữ cảnh một triệu token khiến mô hình phù hợp cho hợp đồng lớn, tài liệu kỹ thuật, bộ sưu tập nghiên cứu và kho tri thức doanh nghiệp, nơi nếu không sẽ phải chia nhỏ nội dung nhiều lần.
Phân tích hình ảnh và video
Qwen3.8-Flash chấp nhận cả hình ảnh và video. Giới hạn API thị giác hiện tại cho phép video lên đến hai giờ, phù hợp với ghi âm cuộc họp, hướng dẫn, bài giảng, bản demo và phân tích nội dung thị giác dạng dài.
AI cho môi trường sản xuất chú trọng chi phí
Đây có lẽ là lợi thế thương mại lớn nhất. Qwen khuyến nghị rõ ràng Flash như một lựa chọn chi phí thấp hơn so với Qwen3.8-Max, khiến nó phù hợp cho các ứng dụng khối lượng lớn nơi không cần mức lập luận hàng đầu cho mọi yêu cầu.
Những hạn chế của Qwen3.8-Flash là gì?
Qwen3.8-Flash không nên được hiểu là mô hình có hiệu năng cao nhất trong họ Qwen3.8 chỉ vì nó chia sẻ cửa sổ ngữ cảnh 1M với Qwen3.8-Max.
Sự đánh đổi chính là năng lực so với chi phí: chính Qwen khuyến nghị Qwen3.8-Max khi cần hiệu năng lập luận mạnh nhất.
Một cân nhắc khác là cửa sổ ngữ cảnh 1M không có nghĩa là mọi yêu cầu nên chứa một triệu token. Ngữ cảnh lớn làm tăng yêu cầu xử lý, và nhà phát triển nên dùng truy xuất, bộ nhớ đệm và quản lý ngữ cảnh khi không cần toàn bộ ngữ cảnh.
Cuối cùng, nhà phát triển nên phân biệt qwen3.8-flash được lưu trữ với Qwen3.8-Flash-Next trọng số mở. Mô hình sau là bản xem trước kiến trúc và có trọng số, kiến trúc được ghi nhận độc lập; mô hình API dùng trong sản xuất nên được ghi nhận theo các thông số API riêng của nó.
Qwen3.8-Flash có phù hợp cho ứng dụng API sản xuất không?
Có, đặc biệt khi ứng dụng cần lập luận đa phương thức, ngữ cảnh dài, sử dụng công cụ và chi phí token tương đối thấp.
Nó là ứng cử viên sản xuất mạnh hơn so với Flash-Next khi yêu cầu chỉ đơn giản là gọi một API Qwen được lưu trữ, vì qwen3.8-flash được công bố rõ ràng là mô hình sản xuất trong tài liệu API của Qwen với giới hạn ngữ cảnh, đầu ra, công cụ và đa phương thức được xác định.
Để có chất lượng lập luận tối đa, Qwen3.8-Max vẫn là lựa chọn phù hợp hơn. Đối với khối lượng công việc lớn nơi chi phí và thông lượng quan trọng hơn, Qwen3.8-Flash là lựa chọn kinh tế hơn.
Tham số API của Qwen3.8-Flash
Một yêu cầu tương thích OpenAI tiêu chuẩn có thể sử dụng các tham số như:
| Tham số | Mục đích |
|---|---|
| model | qwen3.8-flash |
| messages | Đầu vào hội thoại và đa phương thức |
| temperature | Kiểm soát lấy mẫu |
| max_tokens | Đầu ra sinh tối đa |
| stream | Phản hồi dạng streaming |
| tools | Định nghĩa hàm/công cụ |
| tool_choice | Hành vi lựa chọn công cụ |
| response_format | Cấu hình đầu ra có cấu trúc |
| enable_thinking | Bật chế độ tư duy trong các API Qwen được hỗ trợ |
Tài liệu khởi động nhanh sử dụng OpenAI SDK với định danh mô hình qwen3.8-flash. Ví dụ bật lập luận bằng extra_body={"enable_thinking": True}.
Cách sử dụng API qwen3.8-flash trong CometAPI
Bước 1: Lấy quyền truy cập API
Đăng nhập vào cometAPI. Nếu bạn chưa là người dùng của chúng tôi, vui lòng đăng ký trước. Đăng nhập vào bảng điều khiển CometAPI. Lấy khóa API thông tin xác thực truy cập của giao diện. Nhấp “Add Token” tại mục API token trong trung tâm cá nhân, lấy khóa token: sk-xxxxx và gửi.
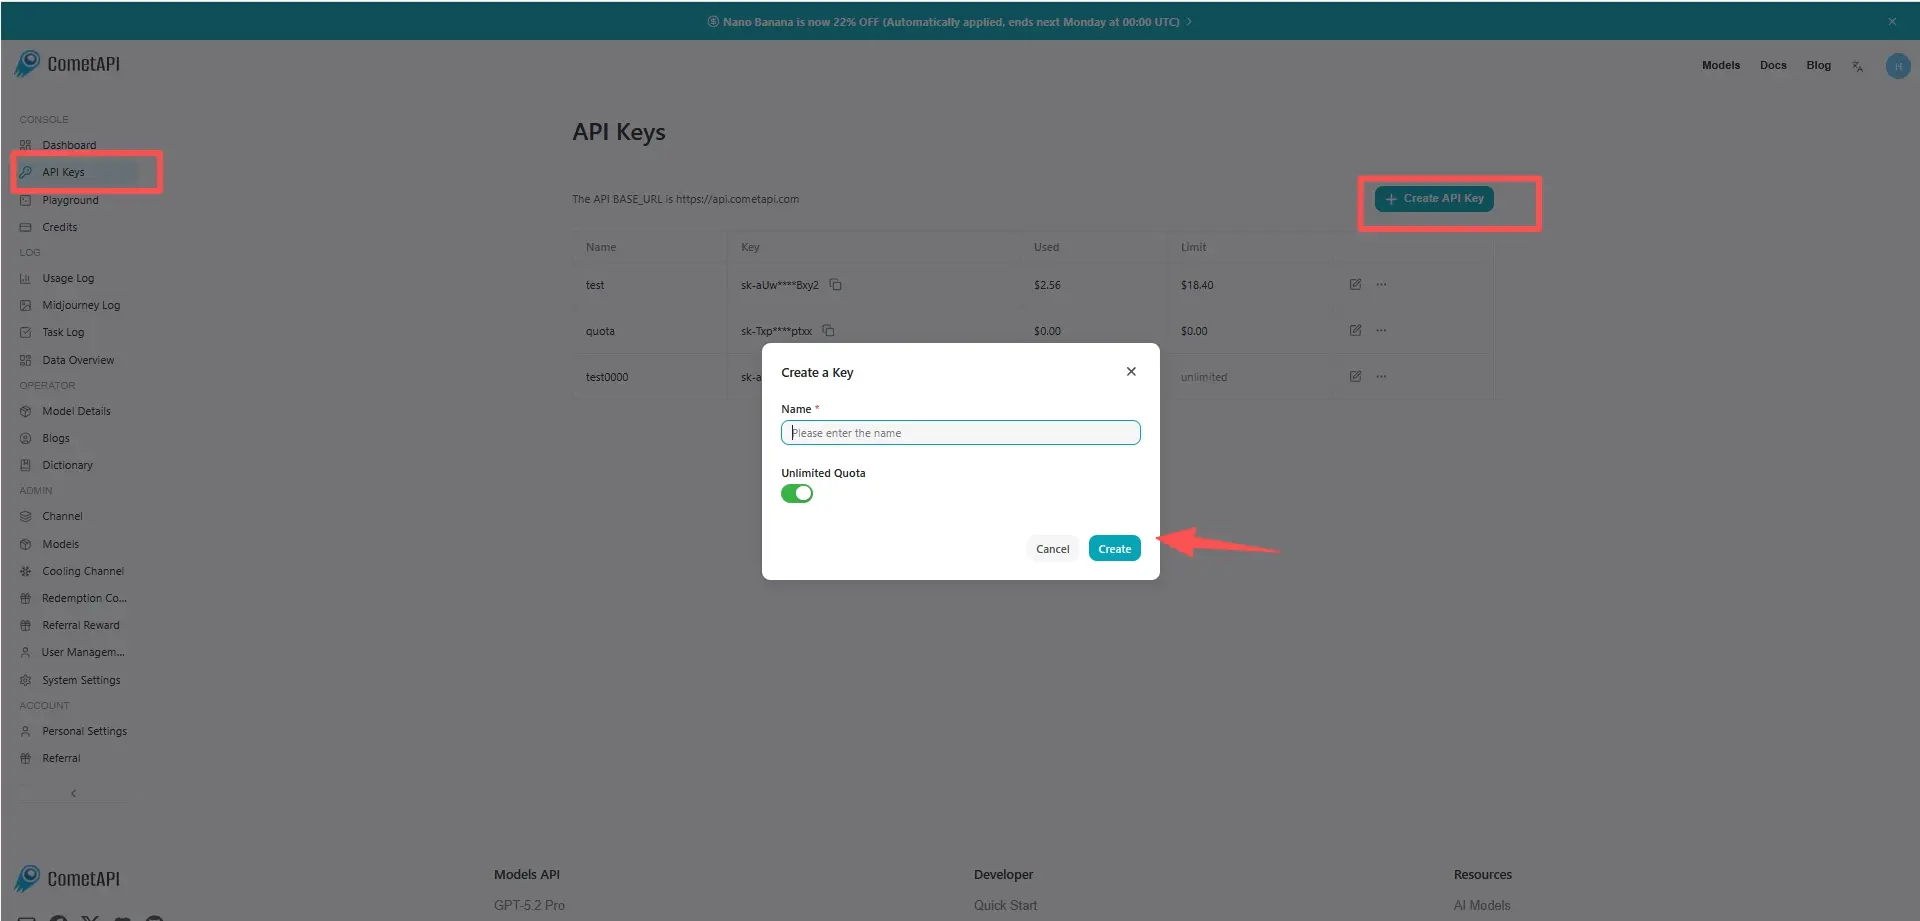
Bước 2: Gửi yêu cầu tới API qwen3.8-flash
Chọn endpoint “qwen3.8-flash” để gửi yêu cầu API và thiết lập phần thân yêu cầu. Phương thức và phần thân yêu cầu được lấy từ tài liệu API trên trang web của chúng tôi. Trang web cũng cung cấp bài kiểm thử Apifox để thuận tiện. Thay thế <YOUR_API_KEY> bằng khóa CometAPI thực tế từ tài khoản của bạn.
Chèn câu hỏi hoặc yêu cầu của bạn vào trường nội dung — đây là nội dung mà mô hình sẽ phản hồi. Xử lý phản hồi API để lấy câu trả lời được tạo. Hỗ trợ AI SDK, OpenAI Chat Completions, OpenAI Responses và các giao diện tương thích Anthropic Messages.
Bước 3: Xử lý phản hồi
API trả về các phản hồi ứng viên có cấu trúc bao gồm văn bản được tạo, trích dẫn, siêu dữ liệu an toàn và đầu ra công cụ tùy chọn. Đối với các yêu cầu đa phương thức, nội dung tin nhắn có thể được cấu trúc với đầu vào văn bản và hình ảnh khi endpoint CometAPI đã chọn cung cấp khả năng thị giác của mô hình.