Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Composer 與 GPT-5-Codex——誰贏得了這場程式設計之戰? technology / CometAPI 研究
Composer 與 GPT-5-Codex——誰贏得了這場程式設計之戰? 其中兩個最引人注目的競爭者分別是 Composer 和 GPT-5-Codex。 Composer 是 Cursor 公司在其 Cursor 2.0 版本中推出的專用低延遲編碼模型;GPT-5-Codex 則是 OpenAI 公司針對持續編碼工作流程優化的 GPT-5 智能體版本。它們共同揭示了開發者工具領域新的分水嶺:速度與深度、局部工作空間感知與通用推理、以及「靈感編碼」的便利性與工程嚴謹性之間的權衡。
其中兩個最引人注目的競爭者分別是 Composer 和 GPT-5-Codex。 Composer 是 Cursor 公司在其 Cursor 2.0 版本中推出的專用低延遲編碼模型;GPT-5-Codex 則是 OpenAI 公司針對持續編碼工作流程優化的 GPT-5 智能體版本。它們共同揭示了開發者工具領域新的分水嶺:速度與深度、局部工作空間感知與通用推理、以及「靈感編碼」的便利性與工程嚴謹性之間的權衡。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)近幾個月來,智慧編碼技術發展迅速:這類專業模型不僅能回應一次性指令,還能對整個程式碼庫進行規劃、編輯、測試和迭代。其中兩個最引人注目的案例是: 作曲家 這是 Cursor 在 Cursor 2.0 版本中引入的一種專用低延遲編碼模型, GPT-5-Codex OpenAI 的 GPT-5 智能體最佳化版本專為持續編碼工作流程而設計。它們共同揭示了開發者工具領域新的分水嶺:速度與深度、局部工作空間感知與通用推理,以及「感覺編碼」的便利性與工程嚴謹性之間的權衡。
一覽:直接對比
設計意圖: GPT-5-Codex — 深度、智慧推理,能夠應對長時間、複雜的會話;Composer — 快速、工作區感知的迭代,針對速度進行了最佳化。主集成面: GPT-5-Codex — Codex 產品/回應 API、IDE、企業整合;Composer — Cursor 編輯器和 Cursor 的多代理 UI。延遲/迭代: Composer 強調 30 秒以內的轉彎,並聲稱具有很大的速度優勢;GPT-5-Codex 則優先考慮徹底性,並在需要時進行數小時的自主運行。
我測試了
Composer 和 GPT-5-Codex 是什麼?
GPT-5-Codex是什麼?它旨在解決哪些問題? OpenAI 的 GPT-5-Codex 是 GPT-5 的一個專門版本,OpenAI 表示它針對智能體編碼場景進行了最佳化:運行測試、執行大規模程式碼編輯,並自主迭代直至通過所有檢查。其重點在於廣泛的工程任務能力——對複雜重構進行深度推理、進行更長時間的「智能體」操作(模型可以花費數分鐘到數小時進行推理和測試),以及在旨在反映真實工程問題的標準化基準測試中表現出更優異的性能。
Composer是什麼?它旨在解決哪些問題? Composer 是 Cursor 的首個原生編碼模型,隨 Cursor 2.0 版本發布。 Cursor 將 Composer 描述為一個前沿的、以代理為中心的模型,旨在為開發者工作流程中的低延遲和快速迭代而構建:它可以規劃多文件差異、應用全倉庫語義搜索,並在 30 秒內完成大部分操作。此模型在循環中使用工具存取(搜尋、編輯、測試框架)進行訓練,從而有效率地完成實際工程任務,並最大限度地減少日常編碼中重複的提示→響應循環帶來的摩擦。 Cursor 將 Composer 定位為一個針對開發者速度和即時回饋循環進行最佳化的模型。
模型範圍和運行時行為
作曲家: Cursor 針對快速、以編輯器為中心的互動和多文件一致性進行了最佳化。其平台級整合使 Composer 能夠存取更多程式碼庫內容,並參與多代理編排(例如,兩個 Composer 代理程式與其他代理程式的交互),Cursor 認為這可以減少文件間依賴關係的缺失。GPT-5-Codex: 該模型針對更深層、可變長度的推理進行了最佳化。 OpenAI 宣稱,該模型能夠在必要時以計算/時間成本為代價進行更深層次的推理——據報道,其耗時範圍從輕量級任務的幾秒到大型自主運行的幾小時不等——從而實現更徹底的重構和測試引導的調試。
簡而言之:Composer = Cursor 的 IDE 內建工作區感知編碼模型;GPT-5-Codex = OpenAI 專門用於軟體工程的 GPT-5 變體,可透過 Responses/Codex 取得。
Composer 和 GPT-5-Codex 的速度比較如何?
供應商聲稱什麼? Cursor 將 Composer 定位為「快速前沿」編碼工具:已公佈的數據突出了其以每秒生成的代碼單元數衡量的生成吞吐量,並聲稱其交互式完成速度比 Cursor 內部測試環境中的“前沿”模型快 2-4 倍。獨立媒體和早期測試人員的報告顯示,Composer 在 Cursor 的環境下能夠以每秒約 200-250 個代碼單元的速度生成代碼,並且在許多情況下,典型的交互式編碼回合可以在 30 秒內完成。
OpenAI 的 GPT-5-Codex 並非定位為延遲實驗;它優先考慮魯棒性和更深層次的推理,並且根據社區報告和問題討論,在類似的高推理工作負載下,當使用更大的上下文規模時,速度可能會變慢。
我們如何對速度進行基準測試(方法論) 為了進行公平的速度比較,您必須控制任務類型(短暫完成任務與長時間推理任務)、環境(網路延遲、本地整合與雲端整合),並對兩者進行測量。 首次有效結果所需時間 端對端的掛鐘 (包括任何測試執行或編譯步驟)。要點:
選擇的任務 — 小型程式碼片段產生(實作 API 端點),中型任務(重構一個檔案並更新匯入),大型任務(在三個檔案中實作功能,更新測試)。指標 — 首次令牌產生時間、首次有用差異產生時間(候選補丁發出所需時間)以及包含測試執行和驗證在內的總時間。重複 — 每個任務運行 10 次,取中位數以減少網路噪音。環境 — 測量是在東京的一台開發人員機器上進行的(以反映真實世界的延遲),使用穩定的 100/10 Mbps 連接;結果會因地區而異。 以下是一個可復現的範例。 速度線束 適用於 GPT-5-Codex(回應 API)以及如何測量 Composer(在 Cursor 內部)的說明。
速度提升工具(Node.js)— GPT-5-Codex(回應 API): // node speed_harness_gpt5_codex.js
// Requires: node16+, npm install node-fetch
import fetch from "node-fetch";
import { performance } from "perf_hooks";
const API_KEY = process.env.OPENAI_API_KEY; // set your key
const ENDPOINT = "https://api.openai.com/v1/responses"; // OpenAI Responses API
const MODEL = "gpt-5-codex";
async function runPrompt(prompt) {
const start = performance.now();
const body = {
model: MODEL,
input: prompt,
// small length to simulate short interactive tasks
max_output_tokens: 256,
};
const resp = await fetch(ENDPOINT, {
method: "POST",
headers: {
"Authorization": `Bearer ${API_KEY}`,
"Content-Type": "application/json"
},
body: JSON.stringify(body)
});
const json = await resp.json();
const elapsed = performance.now() - start;
return { elapsed, output: json };
}
(async () => {
const prompt = "Implement a Node.js Express route POST /signup that validates email and stores user in-memory with hashed password (bcrypt). Return code only.";
const trials = 10;
for (let i=0;i<trials;i++){
const r = await runPrompt(prompt);
console.log(`trial ${i+1}: ${Math.round(r.elapsed)} ms`);
}
})();
這是使用公共回應 API 測量 GPT-5-Codex 的端到端請求延遲(OpenAI 文件描述了回應 API 和 gpt-5-codex 模型的使用)。
如何測量 Composer 的速度(遊標): Composer 運行於 Cursor 2.0(桌面/VS Code 分支)內部。截至撰寫本文時,Cursor 尚未提供與 OpenAI Responses API 相符的通用外部 HTTP API 用於 Composer;Composer 的優勢在於… IDE 內有狀態工作區集成 因此,衡量 Composer 的標準應該像人類開發者:
在 Cursor 2.0 中開啟同一個專案。
使用 Composer 將相同的提示作為代理任務運行(建立路由、重構、多檔案變更)。
提交 Composer 計劃時啟動秒錶;當 Composer 發出原子差異並運行測試套件時停止(Cursor 的介面可以運行測試並顯示合併的差異)。
重複 10 次,取中位數。
Cursor 發布的資料和實際評測表明,Composer 在實踐中可以在 30 秒內完成許多常見任務;這是一個互動式延遲目標,而不是原始模型推理時間。
外賣店: Composer 的設計目標是在編輯器內實現快速互動式編輯;如果您優先考慮低延遲、對話式編碼循環,那麼 Composer 正是為此而生。 GPT-5-Codex 針對長時間會話中的正確性和智慧推理進行了最佳化;它可以犧牲一些延遲來換取更深入的規劃。廠商的數據也支持這一定位。
Composer 和 GPT-5-Codex 在準確率上有何不同?
在人工智慧編碼中,準確性意味著什麼? 這裡的準確性是多方面的: 功能正確性 (程式碼是否能編譯並通過測試) 語意正確性 (該行為是否符合規範),以及 穩健性 (處理特殊情況、安全問題)。
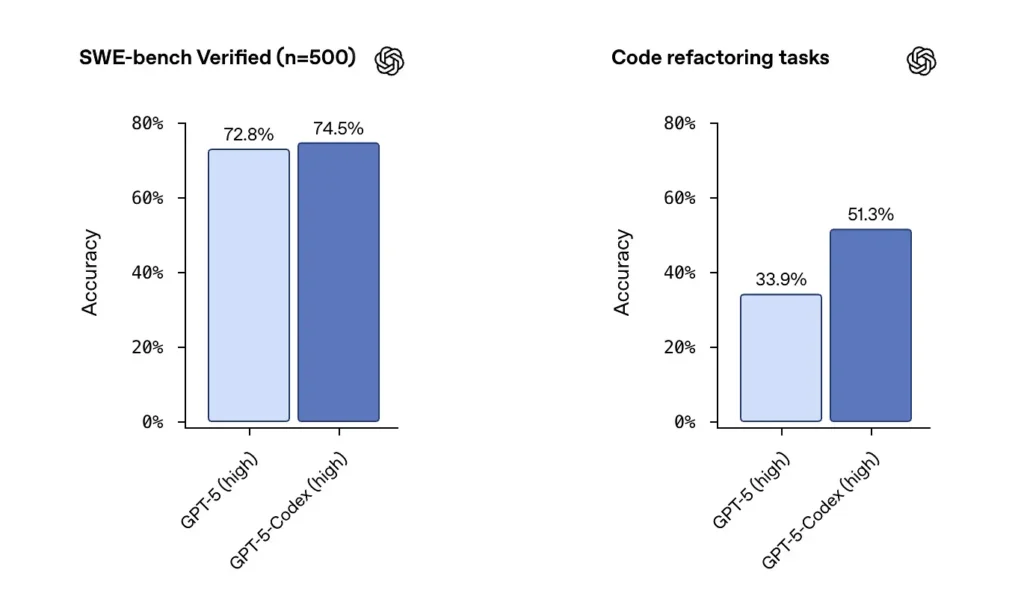
供應商和印刷機編號 OpenAI 報告稱 GPT-5-Codex 在 SWE-bench 驗證資料集上表現出色,並重點介紹了… 74.5%的成功率 在真實世界的編碼基準測試中(媒體報告有報告),重構成功率顯著提高(在其內部重構測試中,重構成功率為 51.3%,而基礎 GPT-5 為 33.9%)。
Cursor 的發布表明,Composer 在多文件、上下文相關的編輯方面表現出色,尤其是在編輯器整合和倉庫可見性至關重要的情況下。我的測試報告顯示,Composer 在多文件重構過程中產生的依賴項錯誤更少,並且在某些多文件工作負載的盲審測試中得分更高。 Composer 的延遲和平行代理功能也幫助我提高了迭代速度。
獨立準確性測試(建議方法)
單元測試 將同一個程式碼庫和測試套件提供給兩個模型;生成程式碼,運行測試。重構測試 :提供一個故意混亂的函數,並要求模型進行重構和添加測試。安全檢查 對產生的程式碼執行靜態分析和 SAST 工具(例如 Bandit、ESLint、semgrep)。人工審核 由經驗豐富的工程師根據程式碼可維護性和最佳實踐進行程式碼審查評分。
範例:自動化測試框架(Python)-運行產生的程式碼和單元測試 # python3 run_generated_code.py
# This is a simplified harness: it writes model output to file, runs pytest, captures results.
import subprocess, tempfile, os, textwrap
def write_file(path, content):
with open(path, "w") as f:
f.write(content)
# Suppose `generated_code` is the string returned from model
generated_code = """
# sample module
def add(a,b):
return a + b
"""
tests = """
# test_sample.py
from sample import add
def test_add():
assert add(2,3) == 5
"""
with tempfile.TemporaryDirectory() as d:
write_file(os.path.join(d, "sample.py"), generated_code)
write_file(os.path.join(d, "test_sample.py"), tests)
r = subprocess.run(, cwd=d, capture_output=True, text=True, timeout=30)
print("pytest returncode:", r.returncode)
print(r.stdout)
print(r.stderr)
使用此模式可自動斷言模型輸出在功能上是否正確(通過測試)。對於重構任務,請針對原始程式碼庫和模型差異執行此測試框架,並比較測試通過率和覆蓋率的變化。
外賣店: 在原始基準測試套件中,GPT-5-Codex 表現出色,重構能力強勁。在實際的多文件修復和編輯器工作流程中,Composer 的工作區感知功能可以帶來更高的實際應用率,並減少「機械性」錯誤(例如缺少匯入、檔案名稱錯誤)。對於單檔案演算法任務中追求最大功能正確性的目標,GPT-5-Codex 是一個強有力的選擇;而對於 IDE 內部涉及多檔案且對約定敏感的修改,Composer 通常表現更佳。
Composer 與 GPT-5:它們的程式碼品質有何不同?
什麼才算品質? 品質包括可讀性、命名規範、文件編寫、測試覆蓋率、慣用表達方式的使用以及安全措施。品質的衡量既包括自動評估(程式碼檢查工具、複雜度指標),也包括定性評估(人工審核)。
觀察到的差異
GPT-5-Codex :在被明確要求時,能夠出色地產生慣用模式;演算法表達清晰,並且在提示下能夠產生全面的測試套件。 OpenAI 的 Codex 工具集包含整合的測試/報告和執行日誌。作曲家 Composer 經過最佳化,能夠自動遵循程式碼倉庫的風格和規格;它可以遵循現有的專案模式,並協調多個檔案的更新(重新命名/重構傳播、匯入更新)。它為大型專案提供了出色的按需維護能力。
您可以運行的範例程式碼品質檢查
棉絨 — ESLint / pylint複雜 — 氡/flake8-複雜度安全性 — semgrep / Bandit測試覆蓋率 — 執行 coverage.py 或 vitest/nyc 測試 JS 在應用模型修補程式後,自動執行這些檢查,以量化改進或退化情況。範例命令序列(JS 程式碼庫):
# after applying model patch

npm ci
npm test
npx eslint src/
npx semgrep --config=auto .
人工審核和最佳實踐 實際上,模型需要遵循最佳實踐才能有效運作:例如,要求提供文件字串、類型註解、依賴項綁定或特定模式(例如,async/await)。 GPT-5-Codex 在獲得明確指令時表現出色;Composer 則受益於其隱式的倉庫上下文。建議採用組合方法:明確指導模型,並在 Cursor 內部使用 Composer 來強制執行專案風格。
建議: 對於 IDE 內的多檔案工程工作,推薦使用 Composer;對於可以呼叫 API 並提供大量上下文的外部管道、研究任務或工具鏈自動化,GPT-5-Codex 是一個不錯的選擇。
整合和部署選項 Composer 作為 Cursor 2.0 的一部分發布,並嵌入到 Cursor 編輯器和使用者介面中。 Cursor 的方法強調單一供應商控制平面,該平面可與其他模型並行運行 Composer,使用戶能夠在同一提示符下運行多個模型實例,並在編輯器內比較輸出結果。 ()
GPT-5-Codex 正在整合到 OpenAI 的 Codex 產品和 ChatGPT 產品系列中,可透過 ChatGPT 付費方案和 API 獲取,而 CometAPI 等第三方平台則能提供更高的性價比。 OpenAI 也將 Codex 整合到開發者工具和雲端合作夥伴的工作流程中(例如 Visual Studio Code/GitHub Copilot 整合)。
Composer 和 GPT-5-Codex 接下來會把產業推向什麼方向?
短期影響
更快的迭代周期: 像 Composer 這樣的編輯器嵌入式模型可以減少小幅修復和 PR 生成過程中的阻力。對核查的期望不斷提高: Codex 對測試、日誌和自主能力的重視將促使供應商為模型產生的程式碼提供更強大的開箱即用驗證。
中長期
多模型編排成為常態: Cursor 的多代理 GUI 是一個早期跡象,表明工程師很快就會期望並行運行多個專門的代理(程式碼檢查、安全、重構、效能最佳化),並接受最佳輸出。更緊密的CI/AI回饋循環: 隨著模型的改進,CI 管道將越來越多地採用模型驅動的測試生成和自動修復建議——但人工審核和分階段推出仍然至關重要。
結論 Composer 和 GPT-5-Codex 並非同一場軍備競賽中的同類武器;它們是互補的工具,分別針對軟體生命週期的不同階段進行了最佳化。 Composer 的價值在於速度:快速、基於工作區的迭代,能夠讓開發者保持流暢的工作流程。 GPT-5-Codex 的價值在於深度:智能體持久化、測試驅動的正確性以及對重量級轉換的可審計性。務實的工程實務指南是… 協調兩者 :用於日常流程的類似 Composer 的短循環代理,以及用於門控、高置信度操作的 GPT-5-Codex 式代理。早期基準測試表明,兩者都將成為近期開發者工具包的一部分,而不是相互取代。
沒有哪個模型在所有方面都是絕對的贏家。各個模型各有優勢:
GPT-5-Codex: 在深度正確性基準測試、大範圍推理和自主運行數小時的工作流程方面表現更佳。當任務複雜度需要長時間推理或大量驗證時,它的優勢尤其突出。作曲家: 在編輯器緊密整合的使用場景、多文件上下文一致性以及 Cursor 環境下的快速迭代速度方面,它表現更佳。對於需要即時、準確且情境感知編輯的日常開發人員來說,它可能更勝一籌。
入門 CometAPI 是一個統一的 API 平台,它將來自領先供應商(例如 OpenAI 的 GPT 系列、Google 的 Gemini、Anthropic 的 Claude、Midjourney、Suno 等)的 500 多個 AI 模型聚合到一個開發者友好的介面中。透過提供一致的身份驗證、請求格式和回應處理,CometAPI 顯著簡化了將 AI 功能整合到您的應用程式中的過程。無論您是建立聊天機器人、影像產生器、音樂作曲家,還是資料驅動的分析流程,CometAPI 都能讓您更快地迭代、控製成本,並保持與供應商的兼容性——同時也能充分利用整個 AI 生態系統的最新突破。
如果您想了解更多有關 AI 的提示、指南和新聞,請關注我們 VK , X 不和 !