Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemini API 免費層級 2026: 免費模型、限制 & 定價指南 guide / CometAPI 研究
Gemini API 免費層級 2026: 免費模型、限制 & 定價指南 我無法存取 2026 年的即時定價或免費方案清單,為避免誤導,我提供可自行查核的步驟與通用原則,並補充 RPM/TPM/RPD 概念、Python 設定與計費實務,以及與 CometAPI 進行價格比較的框架。若您提供最新官方連結或目標模型/用量,我可代為核算與比價。
一、如何查詢 2026 年可免費使用的 Gemini API 模型
- 路徑 1(Google AI Studio 路線,API Key):
- 前往 Google AI Studio 的 Pricing/Quotas/Rate limits 頁面,查看「Free tier/試用配額」是否列出可免費的模型與配額範圍。
- 在 AI Studio 專案中,檢視 Usage/Quota,確認每個模型的當前限額(通常會列出每分鐘/每日的請求或 token 上限)。
- 路徑 2(Google Cloud/Vertex AI 路線,專案計費):
- 在 Google Cloud Console:選取您的專案 → IAM & Admin → Quotas 或 Vertex AI → Quotas,篩選「Generative AI/Gemini」相關配額。
- 查看是否有「無償額度/試用配額」或「每日/每分鐘」的限制,並確認是否需啟用計費帳戶才能超出免費層級。
- 注意事項:
- 免費模型或免費層(free tier)經常會依地區、帳戶狀態(試用 vs 付費)、產品路徑(AI Studio vs Vertex AI)而異,且可能隨時調整。
- 以官方 Pricing 與 Quotas/Rate limits 頁面為準,避免依賴第三方或過期資訊。
二、理解並運用 RPM、TPM、RPD 等限制
- 定義與差異:
- RPM(Requests Per Minute):每分鐘可發送的請求數上限。超出會回 429/Rate limit。
- TPM(Tokens Per Minute):每分鐘可處理的 token 總量上限;通常為「輸入 token + 輸出 token」合計。
- RPD(Requests Per Day):每日請求數上限,常見於免費層或保護性配額。
- 其他常見:QPS(每秒查詢)、並發連線/同時請求上限、每專案/每 API Key/每地區的獨立配額。
- 實務要點:
- 預估 TPM:一次請求的 TPM 消耗 ≈ 輸入 token + 預期輸出 token(串流輸出同樣計入)。
- 配額分層:同一帳號下,專案/地區/API Key 的配額可能不同;企業用戶可申請提升。
- 限流策略:使用指數退避重試、請求分片、預估輸出長度(max_output_tokens)限制、控制並發。
- 監控與告警:結合 Cloud Monitoring 監控 429/5xx、延遲與吞吐;超限時調整流量或申請配額提升。
三、Python 設定(AI Studio 與 Vertex AI 兩條路線)
- 路線 A:AI Studio(API Key)
- 安裝:pip install google-generativeai
- 設定環境變數:export GOOGLE_API_KEY="YOUR_API_KEY"
- 範例:
import os
import google.generativeai as genai
genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
model = genai.GenerativeModel("gemini-1.5-flash")
resp = model.generate_content("Say hello")
print(resp.text)
- 適用情境:快速試用、個人或輕量用量;注意免費層與速率限制,並留意 API Key 的安全存放。
- 路線 B:Vertex AI(Google Cloud 計費/企業治理)
- 安裝:pip install google-cloud-aiplatform
- 登入與專案:
- gcloud auth application-default login
- gcloud config set project YOUR_PROJECT_ID
- 範例:
from vertexai import init
from vertexai.generative_models import GenerativeModel
init(project="YOUR_PROJECT_ID", location="YOUR_REGION")
model = GenerativeModel("gemini-1.5-flash")
resp = model.generate_content("Say hello")
print(resp.text)
- 適用情境:需要企業級功能(私有網路、VPC、地區控制、審計、配額提升、SLA/支援)。
四、計費與配額管理指引
- 計費開通:
- AI Studio 路線:通常仍綁定到某個 Google Cloud 專案與計費帳戶;超出免費層即依定價收費。
- Vertex AI 路線:需啟用計費帳戶,Vertex AI/Generative AI 依「模型 × token 類型(輸入/輸出)× 數量」計價。
- 成本預估方法(通用):
- 月成本 ≈ [(每請求輸入 token + 輸出 token) ÷ 1000] × 單價(每 1K token) × 每月請求數。
- 多模型/多地區請分別計算;影像/音訊/長上下文等可能採不同單價或計量單位。
- 成本控制:
- 設定 Budget 與 Alert(Cloud Billing → Budgets & alerts)。
- 配額限制作為「技術刹車」,避免爆量;針對非高峰期進行批次任務。
- 設定 max_output_tokens 與合理的溫度/重複懲罰,降低冗長輸出造成的 token 消耗。
- 日誌與標記:以專案/標籤區分環境與功能模組,便於成本歸因。
五、Google 與 CometAPI 價格比較框架(無假設數字)
- 請先明確「CometAPI」供應商與定價頁(不同廠商/產品線差異大)。收到連結或價表後,我可依您實際用量做精算。通用比較維度如下:
- 計費單位與口徑:
- 是否分開計價輸入/輸出 token?
- 是否有模型等級差異(如 Flash/Pro/Ultra)而單價不同?
- 圖像、音訊、長上下文或工具調用是否另行計費?
- 免費層/試用:
- 是否提供每月免費 token/請求?是否有 RPD/RPM 的軟/硬限制?
- 免費層是否需要綁定計費帳戶?超量是否自動轉為付費?
- 速率與配額:
- 預設 RPM/TPM/RPD/QPS 與並發;是否可申請配額提升?審核周期與條件?
- 地區與資料治理:
- 可用地區/資料主權、企業合規(ISO、SOC、GDPR)、資料保留/不訓練選項。
- 服務層級與支援:
- SLA、有無企業支援方案、事故回報與支援時效。
- 附加費用:
- 儲存/向量索引/檔案上傳、內容安全、網路輸出(egress)、工具/代理框架的額外費。
- 折扣與合約:
- 長約折扣、承諾用量(Committed Use)或 Marketplace 訂閱。
- 比價步驟建議:
- 定義代表性工作負載(Prompt 長度、輸出上限、模型版本、每分鐘請求量)。
- 將用量換算為每日/每月「輸入/輸出 token」與請求數。
- 套用兩邊的單價表,分模型/功能逐項相乘加總。
- 驗證速率限制:在預期流量下是否會撞到 RPM/TPM/RPD;如會,評估限流或申請提升的可行性與時間成本。
- 做敏感度分析:輸出 token ±20%、流量高峰 ±30%、模型升級(單價上升)下的成本彈性。
六、下一步
- 若您提供:
- 目標模型清單(例如:gemini-1.5-flash/pro 等)與區域,
- 預估工作負載(每請求輸入/輸出 token、請求頻率、是否串流),
- CometAPI 的定價頁或費率明細,
我可產出可執行的用量配置、速率限制校核、以及逐月成本比較表,並給出降本與限流策略建議。
Deon Goodwin AI 模型與 API 研究團隊 我無法存取 2026 年的即時定價或免費方案清單,為避免誤導,我提供可自行查核的步驟與通用原則,並補充 RPM/TPM/RPD 概念、Python 設定與計費實務,以及與 CometAPI 進行價格比較的框架。若您提供最新官方連結或目標模型/用量,我可代為核算與比價。
一、如何查詢 2026 年可免費使用的 Gemini API 模型
- 路徑 1(Google AI Studio 路線,API Key):
- 前往 Google AI Studio 的 Pricing/Quotas/Rate limits 頁面,查看「Free tier/試用配額」是否列出可免費的模型與配額範圍。
- 在 AI Studio 專案中,檢視 Usage/Quota,確認每個模型的當前限額(通常會列出每分鐘/每日的請求或 token 上限)。
- 路徑 2(Google Cloud/Vertex AI 路線,專案計費):
- 在 Google Cloud Console:選取您的專案 → IAM & Admin → Quotas 或 Vertex AI → Quotas,篩選「Generative AI/Gemini」相關配額。
- 查看是否有「無償額度/試用配額」或「每日/每分鐘」的限制,並確認是否需啟用計費帳戶才能超出免費層級。
- 注意事項:
- 免費模型或免費層(free tier)經常會依地區、帳戶狀態(試用 vs 付費)、產品路徑(AI Studio vs Vertex AI)而異,且可能隨時調整。
- 以官方 Pricing 與 Quotas/Rate limits 頁面為準,避免依賴第三方或過期資訊。
二、理解並運用 RPM、TPM、RPD 等限制
- 定義與差異:
- RPM(Requests Per Minute):每分鐘可發送的請求數上限。超出會回 429/Rate limit。
- TPM(Tokens Per Minute):每分鐘可處理的 token 總量上限;通常為「輸入 token + 輸出 token」合計。
- RPD(Requests Per Day):每日請求數上限,常見於免費層或保護性配額。
- 其他常見:QPS(每秒查詢)、並發連線/同時請求上限、每專案/每 API Key/每地區的獨立配額。
- 實務要點:
- 預估 TPM:一次請求的 TPM 消耗 ≈ 輸入 token + 預期輸出 token(串流輸出同樣計入)。
- 配額分層:同一帳號下,專案/地區/API Key 的配額可能不同;企業用戶可申請提升。
- 限流策略:使用指數退避重試、請求分片、預估輸出長度(max_output_tokens)限制、控制並發。
- 監控與告警:結合 Cloud Monitoring 監控 429/5xx、延遲與吞吐;超限時調整流量或申請配額提升。
三、Python 設定(AI Studio 與 Vertex AI 兩條路線)
- 路線 A:AI Studio(API Key)
- 安裝:pip install google-generativeai
- 設定環境變數:export GOOGLE_API_KEY="YOUR_API_KEY"
- 範例:
import os
import google.generativeai as genai
genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
model = genai.GenerativeModel("gemini-1.5-flash")
resp = model.generate_content("Say hello")
print(resp.text)
- 適用情境:快速試用、個人或輕量用量;注意免費層與速率限制,並留意 API Key 的安全存放。
- 路線 B:Vertex AI(Google Cloud 計費/企業治理)
- 安裝:pip install google-cloud-aiplatform
- 登入與專案:
- gcloud auth application-default login
- gcloud config set project YOUR_PROJECT_ID
- 範例:
from vertexai import init
from vertexai.generative_models import GenerativeModel
init(project="YOUR_PROJECT_ID", location="YOUR_REGION")
model = GenerativeModel("gemini-1.5-flash")
resp = model.generate_content("Say hello")
print(resp.text)
- 適用情境:需要企業級功能(私有網路、VPC、地區控制、審計、配額提升、SLA/支援)。
四、計費與配額管理指引
- 計費開通:
- AI Studio 路線:通常仍綁定到某個 Google Cloud 專案與計費帳戶;超出免費層即依定價收費。
- Vertex AI 路線:需啟用計費帳戶,Vertex AI/Generative AI 依「模型 × token 類型(輸入/輸出)× 數量」計價。
- 成本預估方法(通用):
- 月成本 ≈ [(每請求輸入 token + 輸出 token) ÷ 1000] × 單價(每 1K token) × 每月請求數。
- 多模型/多地區請分別計算;影像/音訊/長上下文等可能採不同單價或計量單位。
- 成本控制:
- 設定 Budget 與 Alert(Cloud Billing → Budgets & alerts)。
- 配額限制作為「技術刹車」,避免爆量;針對非高峰期進行批次任務。
- 設定 max_output_tokens 與合理的溫度/重複懲罰,降低冗長輸出造成的 token 消耗。
- 日誌與標記:以專案/標籤區分環境與功能模組,便於成本歸因。
五、Google 與 CometAPI 價格比較框架(無假設數字)
- 請先明確「CometAPI」供應商與定價頁(不同廠商/產品線差異大)。收到連結或價表後,我可依您實際用量做精算。通用比較維度如下:
- 計費單位與口徑:
- 是否分開計價輸入/輸出 token?
- 是否有模型等級差異(如 Flash/Pro/Ultra)而單價不同?
- 圖像、音訊、長上下文或工具調用是否另行計費?
- 免費層/試用:
- 是否提供每月免費 token/請求?是否有 RPD/RPM 的軟/硬限制?
- 免費層是否需要綁定計費帳戶?超量是否自動轉為付費?
- 速率與配額:
- 預設 RPM/TPM/RPD/QPS 與並發;是否可申請配額提升?審核周期與條件?
- 地區與資料治理:
- 可用地區/資料主權、企業合規(ISO、SOC、GDPR)、資料保留/不訓練選項。
- 服務層級與支援:
- SLA、有無企業支援方案、事故回報與支援時效。
- 附加費用:
- 儲存/向量索引/檔案上傳、內容安全、網路輸出(egress)、工具/代理框架的額外費。
- 折扣與合約:
- 長約折扣、承諾用量(Committed Use)或 Marketplace 訂閱。
- 比價步驟建議:
- 定義代表性工作負載(Prompt 長度、輸出上限、模型版本、每分鐘請求量)。
- 將用量換算為每日/每月「輸入/輸出 token」與請求數。
- 套用兩邊的單價表,分模型/功能逐項相乘加總。
- 驗證速率限制:在預期流量下是否會撞到 RPM/TPM/RPD;如會,評估限流或申請提升的可行性與時間成本。
- 做敏感度分析:輸出 token ±20%、流量高峰 ±30%、模型升級(單價上升)下的成本彈性。
六、下一步
- 若您提供:
- 目標模型清單(例如:gemini-1.5-flash/pro 等)與區域,
- 預估工作負載(每請求輸入/輸出 token、請求頻率、是否串流),
- CometAPI 的定價頁或費率明細,
我可產出可執行的用量配置、速率限制校核、以及逐月成本比較表,並給出降本與限流策略建議。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)重點摘要
Gemini API 的免費層級在 2026 年 10 月提供於部分模型,包括 Gemini 3.8 Flash、Gemini 3.6 Flash、Gemini 3.5 Flash-Lite 和 Gemini 3.1 Flash-Lite。你可以在未設定計費的情況下開始使用,但實際可運行的量由你的專案配額決定。
對於高需求的程式設計與推理實驗,從 Gemini 3.8 Flash 開始;日常抽取與分類可選用 Flash-Lite 模型。在使用真實客戶資料前,請確認適用的資料條款。若需要付費容量,請比較 Google 的原生費率與 CometAPI 的獨立計費存取。
關鍵重點
Gemini 3.8 Flash 是此處涵蓋的最新 Flash 選項,支援多模態輸入並可調整推理強度。Gemini 3.6 Flash 持續支援既有整合;Gemini 3.5 Flash-Lite 與 Gemini 3.1 Flash-Lite 針對較輕量的工作負載。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
Gemini 4 Argon
在 AI Studio 檢查配額。 模型的上下文視窗不同於你專案的請求與權杖允許量。
比較存取路徑。 Google 的免費配額與 CometAPI 的價格、額度與帳戶限制各自獨立。
2026 年的 Gemini API 是否免費? Google 為部分 Gemini API 模型提供免費輸入與輸出權杖,受限於專案層級的配額。你可以在未啟用計費的情況下開始使用。這是一種基於配額的免費層級,而非一次性的促銷額度。
重要的是要區分 Google AI Studio、Gemini API 與消費者版 Gemini 訂閱屬於不同的存取體驗。在某介面可用的模型,不一定能透過另一介面免費使用。
2026 年 10 月哪些 Gemini API 模型免費? 以下四個模型是文字與多模態應用的實用起點。它們並非所有可免費使用端點的完整清單。可透過模型連結探索 CometAPI 存取;Google 的規格參考連結於表格下方。
四者皆可接受文字、影像、影片、音訊與 PDF 輸入並產生文字輸出。其公布的輸入上限為 1,048,576 權杖,輸出上限為 65,536 權杖。這些模型上限不保證你的免費專案能夠送出此大小的請求。
音訊、嵌入與影像生成:存取與限制 Google 也列出部分專用模型的免費存取,例如 Gemini 3.8 Live、Gemini 3.8 Flash TTS 與 Gemini Embedding 2。整合前請先查看該模型與端點的定價條目 :理解影像或音訊片段與生成影像或語音回應是不同的能力。
API 方法、請求格式與限制會依能力而異。請查閱你計畫使用之特定模型與操作的文件。
免費存取不涵蓋所有 Gemini 模型或生成端點。Gemini 4 Argon 需要付費的 Gemini API 存取,而高階的影像與影片生成端點有其各自的資格規則。在整合某功能前,請確認精確的模型與操作,勿假設它們共享相同的免費額度。
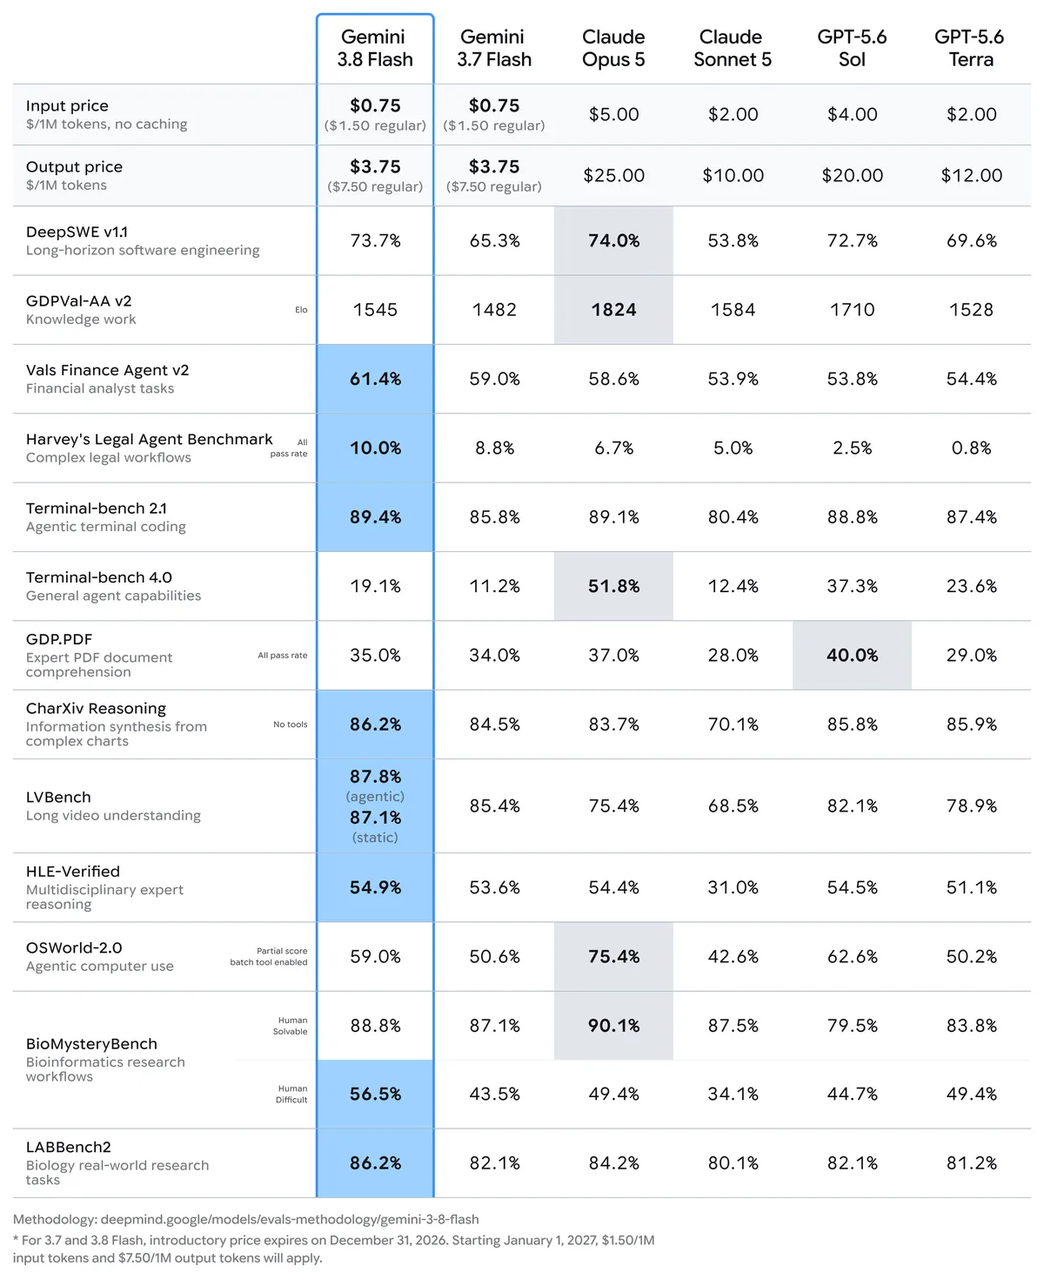
Gemini 3.8 Flash 的效能如何? Google 公布的評估比較了 Gemini 3.8 Flash 與 Gemini 3.7 Flash 及其他模型。在 DeepSWE v1.1 上報告為 73.7%,相較 3.7 Flash 的 65.3%,提升了 8.4 個百分點。於 HLE-Verified 上,報告分數自 53.6% 上升至 54.9%。
請以這些結果選擇要測試的模型,再用你的應用範例進行評估。對文件抽取器而言,欄位正確與輸出格式穩定可能比程式設計基準更重要。對程式助理而言,衡量建議變更是否可行、所需時間以及消耗的權杖數。
2026 年 Gemini API 免費層級的速率限制為何? 最大誤解之一是每個帳戶都會獲得相同固定數量的請求。
RPM(requests per minute): 限制每分鐘可送出的請求數。注意短時間突發與同時多工造成的一次性過量請求。TPM(input tokens per minute): 限制每分鐘可送出的輸入權杖量。大型提示、對話歷史與文件即使請求數不高,也可能耗用此額度。RPD(requests per day): 限制每日總請求數。請依每日允許量與重設時間規劃工作負載。 百萬權杖的輸入上限描述的是模型支援的最大輸入大小。這不保證免費層級專案擁有足夠的 TPM 容量來在單一請求中提交百萬權杖。上下文容量與速率限制容量需分別評估。
每日請求配額於太平洋時間午夜重設。同一專案中的多把金鑰共享其使用限制,因此建立另一把金鑰並不會增加容量。對專用模型或操作亦可能適用其他限制。
處理 Gemini API 429 錯誤 在重試前先閱讀錯誤內文。在目前的 Interactions API 中,429 可區分短期的請求或權杖限制與已耗盡的每日配額。對短期限制,請放慢佇列並使用帶抖動的指數退避。對每日耗盡,等待重設或調整應用的容量規劃。503 則表示服務暫時不可用。請參考 Google 的 API 錯誤參考 。
何時開始 Gemini API 計費 用完免費配額不會自動將你的專案切換到付費使用。若未有啟用中的計費帳戶,超出可用免費額度的請求將遭遇存取或容量限制,而非套用 Standard 付費權杖費率。
要使用付費容量,你需要連結計費。若帳戶被指定為預付方案,還需儲值點數,起始為 5 美元或當地等值。在升級前於 AI Studio 檢查你被指派的方案與支出控管。餘額與使用量紀錄可能延遲更新,因此顯示的預付餘額不構成即時的支出斷點。
Google 的 300 美元 Cloud 歡迎抵用金與 Gemini API 免費層級彼此獨立。2026 年 3 月 2 日之後開立的帳戶,不得將該抵用金用於 Gemini API 或 AI Studio 費用。請參閱計費指南 以了解適用於你帳戶的規則。
下表比較 Google Standard 權杖定價與 CometAPI 於 2026 年 10 月 26 日查閱的模型費率。所有金額以每百萬權杖的美元計;輸出包含可計費的推理(如適用)。Google 的免費輸入與輸出僅適用於專案允許量內的合格請求。
上述 Google 的 Flash 入門價格於 2026 年 12 月 31 日結束;3.8 Flash 與 3.6 Flash 之後調整為輸入 $1.50、輸出 $7.50。Argon 的入門價格於 2026 年 11 月 30 日結束,之後為輸入 $4、輸出 $20。當促銷變動時,應獨立查驗 CometAPI 費率。工具、快取、儲存、稅費與其他服務可能額外收費。
小型工作負載範例 假設你送出 1,000 次文字請求,每次含 2,000 個輸入權杖與 500 個輸出權杖。那即是 200 萬輸入權杖與 50 萬輸出權杖。依上述費率,透過 Google 使用 Gemini 3.8 Flash 成本為 $3.375(約 $3.38),透過 CometAPI 為 $2.70。若符合 Google 免費層級且在配額之內,成本為 $0。以上為權杖成本估算,非實際帳單。
如何開始使用 Gemini API 免費層級? 你需要符合資格的 Google 帳戶與地區、API 金鑰,以及可用的 Python 與 pip。以下範例遵循 Google 目前的快速入門指南 ,並使用 Interactions API。
建立金鑰並安裝 SDK 在 Google AI Studio 中,為未啟用付費計費的專案複製或建立 API 金鑰。安裝 SDK,然後在終端環境中設定金鑰。請將金鑰保存在伺服器上,而非嵌入瀏覽器程式碼。
pip install -U google-genai
export GEMINI_API_KEY="your_api_key"
$env:GEMINI_API_KEY="your_api_key"
發送請求並檢查結果 from google import genai
client = genai.Client()
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Explain vector databases in 100 words."
)
print(interaction.output_text)
將此儲存為一個 Python 檔案,並在相同環境中執行。成功的請求會列印一段簡要說明。接著前往 AI Studio 的使用量儀表板,確認接收流量的專案與模型。若失敗,請檢查錯誤代碼,並在變更程式碼前,驗證金鑰、模型存取、配額與計費狀態。
CometAPI 提供受支援的 Gemini 模型與其他 AI 供應商的獨立存取路徑。
當跨供應商的共用介面能簡化你的應用時,選擇此路徑。使用 CometAPI 金鑰與其端點,並驗證支援的模型 ID 與帳戶限制。Google 的免費配額不會轉移至此服務。以下範例使用 CometAPI 所記載的相容 OpenAI 介面。
使用與上方相同的針對 Shell 的方法在環境中設定 COMETAPI_KEY,然後執行:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
部署前,確認你的 CometAPI 帳戶支援預期的模型 ID。Google 原生識別符與供應商特定別名不保證在每個模型上相互對應。
Gemini API 免費層級有哪些隱私限制? 依 Google 的 Gemini API 追加服務條款 ,未付費服務的提示與輸出可能用於改進 Google 產品,並可能由人工檢視。切勿將敏感、機密或個人資訊提交至未付費服務。付費 API 服務具有不同的資料使用條款。
區域規範亦重要:對於 EEA、瑞士與英國的特定未付費使用,適用付費服務的資料使用條款,但讓 API 用戶端可供上述區域的使用者使用,則需要付費服務。這是不同的條件。請在發佈前,依你的使用者與部署情況檢查當前條款。
如何優化 Gemini API 免費層級的使用? 圍繞你量測到的配額來構建。保持一小組具代表性的任務,紀錄任務成功率、延遲、輸入與輸出權杖,以及重試情形。然後一次只改動工作負載的一部分:
按難度路由。 將日常抽取交給 Flash-Lite,僅在較大型模型能改善結果時才使用之。精簡輸入。 只發送相關文件段落與必要的對話歷史,而非反覆重送全部內容。控制生成。 請求有用的輸出長度,並僅在模型與 API 支援時調整推理強度。重用成果。 儲存重複的應用結果;在假設 API 快取免費前,先檢查模型特定的快取資格。規劃並發度。 讓工作者位於共用佇列之後,避免獨立任務造成不必要的突發。 最後,同步監控品質與消耗。較便宜但常失敗或需多次嘗試的模型,可能比稍微昂貴且一次成功的模型帶來更多工作量。
每個成功任務的有效成本 = 總推理成本 / 成功任務數
對免費層級實驗而言,另一個營運指標是每個可用配額視窗中的成功任務數。
常見問題
我如何判斷配額問題是由請求突發或大型文件引起? 比較失敗時間戳與請求數及輸入權杖量。短促的大量短提示表示請求頻率問題;少數長文件即使 RPM 低,也能耗盡權杖容量。在 Interactions API 中,檢視可機器讀取的錯誤代碼,區分每日配額耗盡與短期限制。將權杖使用量與工作者並發度一併記錄,便可調整佇列的相關部分。
如果提交請求後發生逾時,我應該怎麼做? 逾時不一定表示遠端操作是否完成。對已有互動 ID 的互動,先檢查其狀態再啟動另一個昂貴任務。以應用層級的任務 ID 包住你的工作流程,並去重後續動作,尤其是電子郵件、資料庫寫入與工具呼叫。針對文字生成的重試不應默默重複商務動作。Google 的 Interactions 文件 描述了互動檢索與執行狀態。
我該如何比較 Flash 與 Flash-Lite 的文件抽取效能? 對兩個模型使用相同文件、必要欄位與驗收規則。包含雜訊掃描、缺漏欄位與模糊數值。計分實際欄位準確率與輸出有效性,再計算重試與人工修正。輸出較少權杖的模型若造成更多錯誤而需再次請求,仍可能消耗更多精力。保留一組未參與調整的文件,以免僅在已調過的範例上評估提示變更。
測試你的應用使用的確切端點、模型 ID、訊息格式與功能。相容的 chat-completions 請求不代表對檔案、工具、快取或推理設定具有完全相同支援。比較回傳的使用量欄位與錯誤處理,以及文字回應,並檢視中介與上游供應商的資料政策。在移轉其餘流量前,先以小型、非敏感的工作負載開始。
面對模型與價格變動,如何保持整合穩定? 將模型 ID、端點設定與價格假設放在設定檔中。記錄評估結果時的模型與日期,監控淘汰通知,並在更換模型前重跑具代表性的任務。設置預算警示,並在促銷價格到期前重新檢視。為關鍵工作負載準備經測試的後備方案,而非假設免費配額或特定模型別名會無限期可用。
結論 Gemini API 免費層級是付費前驗證應用的實用方式。選擇適合任務的模型,量測你的專案配額,並在使用生產資料前檢查資料條款。
作為首次實驗,先發送一個小請求並在 AI Studio 中確認。接著量測具代表性的工作負載。若免費容量成為限制,使用相同的提示、品質要求與完整權杖成本,對比 Google 的付費 API 與 CometAPI。
Gemini 3.8 Flash gemini-3.8-flash 複雜的程式設計、推理與工具驅動的工作流程 Gemini 3.6 Flash gemini-3.6-flash 既有的 Flash 應用與一般自動化 Gemini 3.5 Flash-Lite gemini-3.5-flash-lite 文件剖析與輕量代理任務 Gemini 3.1 Flash-Lite gemini-3.1-flash-lite 分類、翻譯與直接的資料抽取
Gemini 3.8 Flash Free $0.75 / $3.75 $0.60 / $3.00 Gemini 3.6 Flash Free $0.75 / $3.75 $0.60 / $3.00 Gemini 3.5 Flash-Lite Free $0.30 / $2.50 Check the current catalog quote Gemini 3.1 Flash-Lite Free $0.25 / $1.50 $0.20 / $1.20 Gemini 4 Argon Not available $2.00 / $10.00 $1.60 / $8.00
Gemini API 免費層級 2026: 免費模型、限制 & 定價指南 - CometAPI