
TL;DR
GLM-5.3 Flash 對大多數生產工作負載而言是更好的預設選擇:它新增原生視覺輸入與 1M-token 上下文視窗,同時其標準牌價大幅更低。當你更重視極致的程式深度、困難的長期推理或資安表現而非單位成本時,GLM-5.3 仍是更強的選擇。
這不是小模型對抗大模型的故事。Flash 是一個 320B 總參數 / 18B 活躍參數的 MoE,從全新的多模態基座訓練而來,採用混合稀疏與線性注意力。旗艦版則是744B 總參數 / 40B 活躍參數的 MoE,GLM-5.3 的提升來自於在 GLM-5.2 基座上的擴大型後訓練。
Key Takeaways
- 對多模態編碼、文件理解、瀏覽器或 GUI 代理、高量自動化與成本敏感應用,選擇 Flash。
- 對最困難的倉庫級工程任務、更深度的工具輔助推理,以及防禦性安全研究,選擇旗艦版。
- 兩者皆支援 1M-token 上下文、始終啟用推理、函式呼叫、串流與開放權重部署。
- 在 Z.ai 公布的匹配基準上,旗艦版領先 DeepSWE、NL2Repo、HLE with tools 與 Agents’ Last Exam;Flash 領先 AutomationBench、Toolathlon 與 GDPval-AA v2。
- 獨立測試顯示旗艦版有更高的 Intelligence Index 並且輸出更快,而 Flash 的首 token 延遲略優且綜合成本低得多。
GLM-5.3 Flash vs GLM-5.3 at a Glance
| Dimension | GLM-5.3 Flash | GLM-5.3 | Practical result |
|---|---|---|---|
| Positioning | 高效的原生多模態編碼與代理模型 | 旗艦級文字推理、編碼、長期代理、資安 | 視工作負載而定 |
| Model size | 320B total / 18B active | 744B total / 40B active | Flash 啟用的參數少 55% |
| Base model | 全新訓練的 30T-token 多模態基座 | 與 GLM-5.2 同一基座;性能來自後訓練 | 不同的研發路徑 |
| Input / output | 文字 + 視覺輸入 / 文字輸出 | 文字輸入 / 文字輸出 | 視覺工作流程選 Flash |
| Context / max output | 1M / 128K | 1M / 128K | 平手 |
| Reasoning effort | low、high、max;推理始終啟用 | low、high、max;推理始終啟用 | 平手 |
| Independent Intelligence Index | 57 | 60 at max effort | GLM-5.3 |
| Independent output speed | 50.2 tokens/s | 76.6 tokens/s | 測試的 API 中 GLM-5.3 較快 |
| Official list input/output price | $0.15 / $0.50 per 1M tokens | $1.40 / $4.40 per 1M tokens | Flash |
| Best fit | 預設路由、多模態代理、規模化 | 最高賭注的複雜文本與安全任務 | 採用選擇性路由 |
Sources: Z.ai model documentation and Artificial Analysis comparison.
What Is GLM-5.3 Flash?
Z.ai 將 Flash 定位為 GLM-5 系列中首個原生多模態模型。它擁有320B 總參數與 18B 活躍參數,但「Flash」不應被理解為「小」。完整檢查點仍是非常大的模型;其效率來自啟用較小的專家子集與重新設計的注意力堆疊。
其基座模型在30 兆 token 的多模態語料上進行訓練。原生視覺被整合進編碼迴路,使模型能在下一步行動之前檢視螢幕截圖、渲染界面、圖表、頁面版面與其他視覺回饋並加以精煉。
GLM-5.3 Flash Specifications
| Specification | GLM-5.3 Flash |
|---|---|
| Developer | Z.ai / Zhipu AI |
| Model ID | glm-5.3-flash |
| Model type | 原生多模態 Mixture-of-Experts 模型 |
| Total / active parameters | 320B / 18B |
| Layers | 45 |
| Architecture | 混合稀疏注意力 + 線性注意力;mHC;MTP |
| Training corpus | 30T-token 多模態預訓練語料 |
| Input modalities | 文字與視覺輸入,包含影像與支援的影片/檔案流程 |
| Output modality | 文字 |
| Context / max output | 1M / 128K tokens |
| Reasoning | 始終啟用;low、high、max 推理強度 |
| Tools | 函式呼叫、串流工具呼叫、結構化流程 |
| Weights / license | 開放權重;官方儲存庫採 Apache-2.0 |
Sources: Z.ai Flash documentation and the official GLM-5 repository.
What Is GLM-5.3?
旗艦模型針對複雜軟體工程、長期代理與資安進行最佳化。Z.ai 表示其使用與 GLM-5.2 相同的基座模型;升級來自擴大型後訓練,而非新的預訓練。
官方儲存庫列出檢查點為744B 總參數、40B 活躍參數。與 Flash 相比,它在每個 token 上啟用超過兩倍的參數,並將更多容量配置給困難的多步推理。
GLM-5.3 Specifications
| Specification | GLM-5.3 |
|---|---|
| Developer | Z.ai / Zhipu AI |
| Model ID | glm-5.3 |
| Model type | 旗艦級文字 Mixture-of-Experts 模型 |
| Total / active parameters | 744B / 40B |
| Base model | GLM-5.2 基座;GLM-5.3 的提升均來自後訓練 |
| Input / output | 文字 / 文字 |
| Context / max output | 1M / 128K tokens |
| Reasoning | 始終啟用;low、high、max 推理強度 |
| Tools | 函式呼叫、串流工具呼叫、上下文快取、結構化輸出 |
| Primary focus | 複雜編碼、長期代理、工程、資安 |
| Weights / license | 開放權重,採獨立的 GLM-5.3 License;支援的儲存庫程式碼為 Apache-2.0。 |
Sources: Z.ai flagship documentation and the official GLM-5 repository.
Architecture: Why Flash Is Cheaper Without Being Small
Flash 在線性注意力區塊與稀疏注意力區塊之間交替,並在注意力與 MoE 元件周圍使用 mHC。其 IndexPool 機制將四個索引鍵向量壓縮為一個。Z.ai 報告在 1M-token 序列長度下,單層注意力運算量降低 3.01×,單層 KV 快取縮小 4.44×,相較於旗艦版。
這些是架構層級的比較,並非保證的端到端延遲倍數。實際 API 速度亦取決於硬體、量化、批次化、推理長度、服務軟體與供應商負載。
GLM-5.3-Flash 混合注意力架構與長上下文的計算/快取比較。
Source: Z.ai official architecture documentation
Benchmark Performance: Where Each Model Wins
最乾淨的比較方式是區分廠商報告的任務基準與獨立 API 測量。即便基準名稱相同,測試框架版本、工具配置、上下文管理與推理強度也可能不同。下表使用旗艦版評測與 Flash 評測中最接近的匹配值,將小幅差距視為方向性而非定論。
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Higher score | What it tests |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | 終端與代理式編碼 |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | 軟體工程 |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | 程式庫生成 |
| Toolathlon Verified | 78.4 | 73.0 | Flash | 工具使用 |
| AutomationBench | 48.8 | 48.2 | 接近平手 / Flash | 電腦操作自動化 |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | 長期代理推理 |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | 困難的工具輔助推理 |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | 接近平手 / Flash | 專業知識工作 |
Sources: flagship evaluation and Flash evaluation. Compare directionally because evaluation setups may differ.
Coding and Repository Engineering
旗艦版有更高的性能上限。它在 DeepSWE 上領先 Flash 3.5 分,在 NL2Repo 上領先 1.7 分。在 Z.ai Code Bench v1.0 中,兩者皆使用 Claude Code 2.1.207 評估,旗艦版在 max 強度達到34.5%,而 Flash 為 29.0% —— 領先 5.5 個百分點。
Flash 仍具有足夠競爭力,可作為例行程式庫維護、測試生成、除錯、重構與高量編碼代理的首選測試模型。僅將最難的任務或失敗路徑升級至旗艦版。
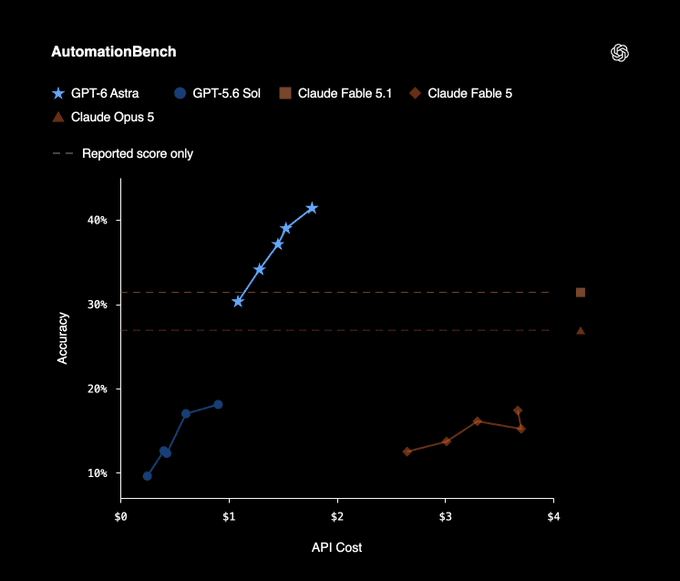
Z.ai 對 GLM-5.3-Flash 與其他編碼/代理模型的六項基準評估。
Source: Z.ai official Flash documentation
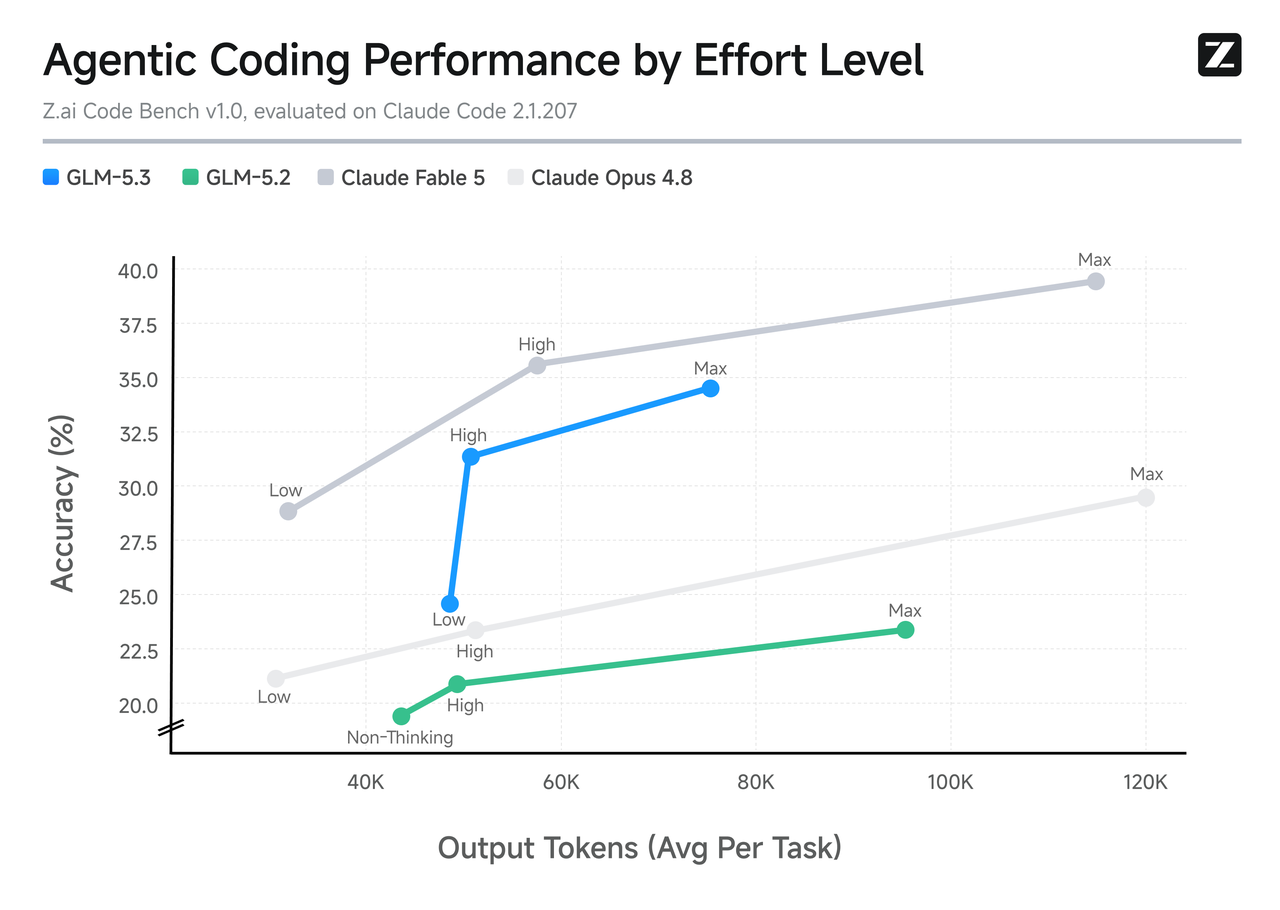
GLM-5.3 在不同推理強度下的代理式編碼準確率與輸出 token 使用量。
Source: Z.ai official flagship documentation
Tool Use, Automation, and Knowledge Work
Flash 並非處處較弱。它在 Toolathlon Verified 得分 78.4,相較旗艦版的 73.0,並以 48.8 比 48.2 小勝 AutomationBench;在 GDPval-AA v2 上基本持平。當任務重點不在單一極難的推理鏈,而是要以更低成本高可靠地協調大量工具呼叫時,Flash 特別具有吸引力。
Independent Intelligence, Speed, and Latency
| Independent measurement | GLM-5.3 Flash | GLM-5.3 (max) | Result |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Output speed | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 |
| Time to first token | 1.49 s | 1.61 s | Flash |
| Context window | 1M | 1M | 平手 |
| Blended price in AA comparison | $0.10 / 1M tokens | $0.90 / 1M tokens | Flash |
Source: Artificial Analysis matched API comparison.
此獨立結果對「Flash 更快」的假設提供重要修正。Flash 的首 token 時間略低,但在測試的旗艦端點上,一旦開始輸出,其生成速度更快。將這些測量視為供應商特定的快照,而非模型不可改變的屬性。
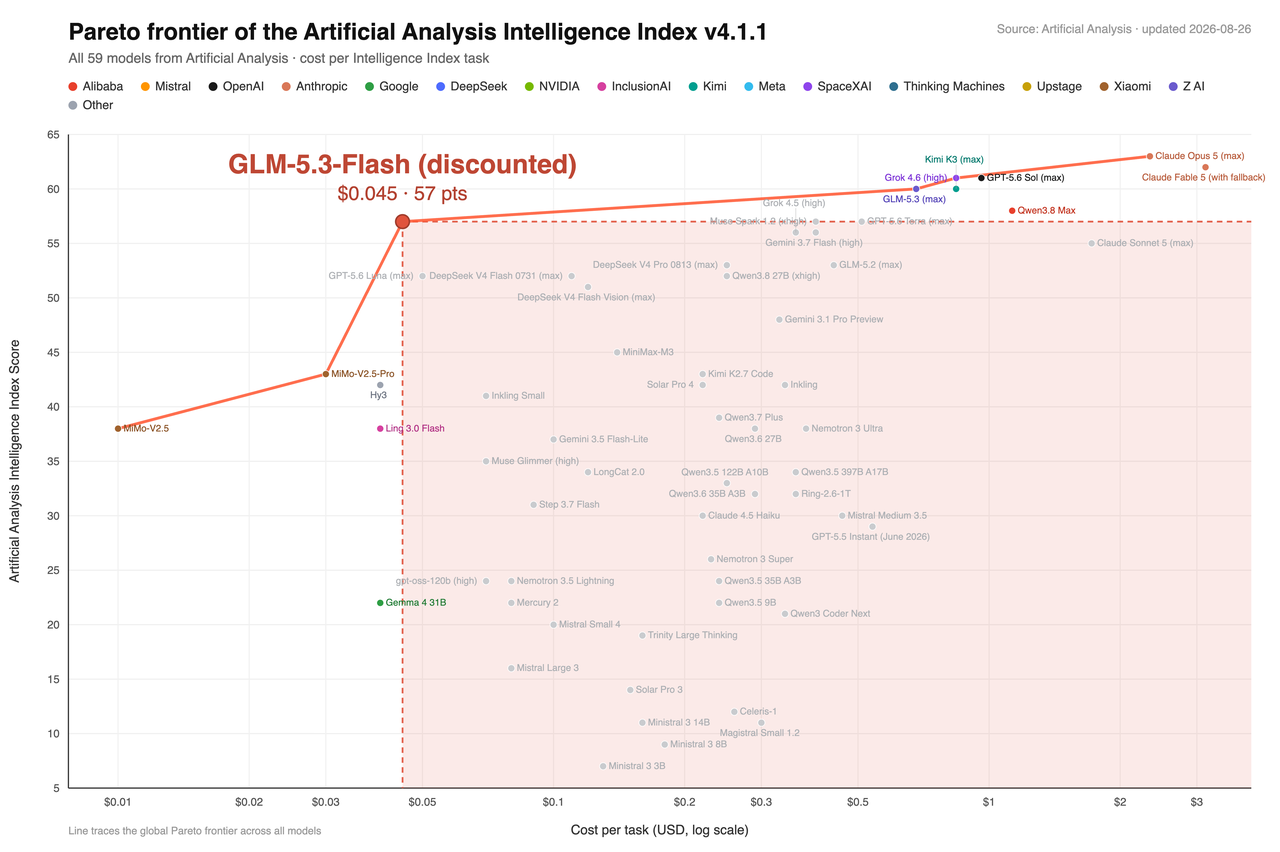
Z.ai 官方 Flash 文件中重現的 Artificial Analysis 成本–智能前沿。
Source: Z.ai official Flash documentation
Multimodality: Flash Has the Clear Advantage
Flash 接受視覺輸入並將其整合至代理式工作流程。它能檢視螢幕截圖、頁面影像、圖表、介面狀態、螢幕錄影與支援的檔案,並在編碼或操作工具時利用視覺證據。旗艦版目前僅支援文字輸入。
- 前端與設計到程式碼:Flash 能檢視參考截圖並驗證渲染實作。
- 文件與 Office 流程:Flash 能推理頁面結構、圖表、版面與影像位置。
- 瀏覽器與電腦操作:Flash 能結合視覺狀態、工具呼叫與迭代修正。
- 純文字的程式庫工作:當輸入為程式碼與文字且任務需要最大推理深度時,旗艦版仍較佳。
Long Context and Reasoning Controls
GLM-5.3 Flash 支援 1M-token 上下文視窗與最多 128K 輸出 token;GLM-5.3 提供相同限制。兩者皆維持推理啟用,且接受 low、high、max 強度。Z.ai 建議對困難編碼與基準重現使用 max。
因此,上下文容量並非主要差異點。差異在於兩者在處理長序列時的經濟性,以及能為最難任務帶來多少推理容量。Flash 在長上下文的架構成本更低;旗艦版的品質上限更高。
Cybersecurity: GLM-5.3 Is the Specialist
資安是旗艦版最鮮明的能力。Z.ai 報告其在 CyberGym 得分 84.5、在 ExploitBench 得分 54.4(https://docs.z.ai/guides/llm/glm-5.3)。在標準化的兩小時與六小時配額下,它分別完成 105 與 130 個 ExploitGym 任務。
Flash 並沒有相同的發佈重點或匹配的公開資安套件。對於程式碼審查、安全開發與授權的弱點發現,請以旗艦版為主要模型,並在流程中保留人工核准、隔離工具、稽核日誌與揭露管控。
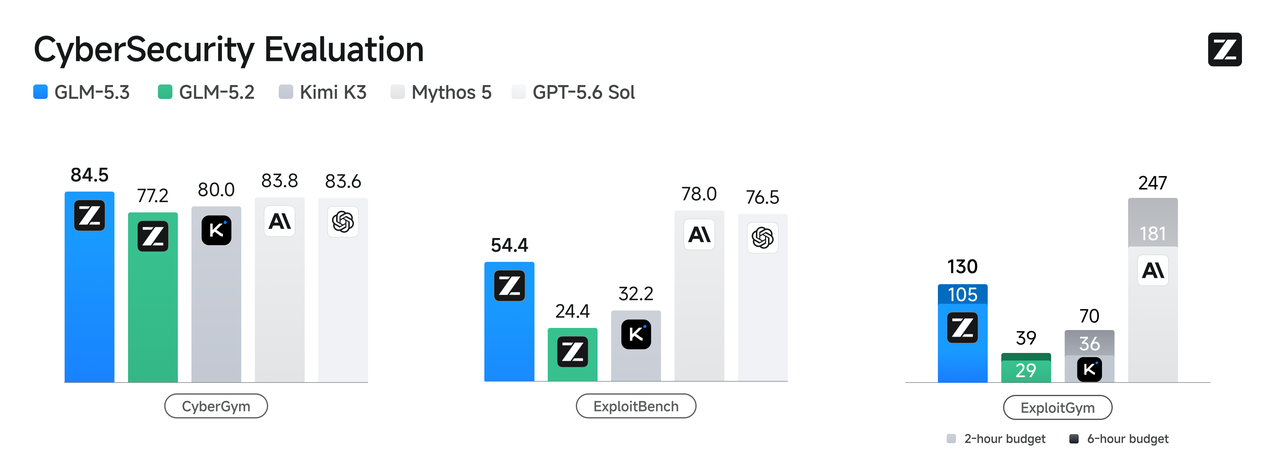
GLM-5.3 在弱點發現與利用鏈基準中的表現。
Source: Z.ai official cybersecurity documentation
Cost and Deployment
API Pricing
Z.ai 列示 Flash 的價格為每百萬輸入 token $0.15、每百萬輸出 token $0.50(促銷前),旗艦版則為$1.40 與 $4.40。
| Access route | Flash input | Flash cached | Flash output | 5.3 input | 5.3 cached | 5.3 output |
|---|---|---|---|---|---|---|
| Z.ai standard list | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Z.ai promotional Flash rate | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| CometAPI route | $0.06 | Check live route | $0.20 | $1.12 | Check live route | $3.528 |
Prices are USD per 1M tokens. Sources: Z.ai pricing, Flash route, and GLM-5.3 route. Promotions can change.
Example Monthly Cost
對於使用 100M 輸入 token 與 20M 輸出 token 的工作負載,目前 CometAPI 費率估算 Flash 約 $10.00,旗艦版約 $182.56,未計入快取效果或工具費用。在此示例中,Flash 可將 token 帳單降低約 94.5%。
| Cost component | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Input cost | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Output cost | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Total | $10.00 | $182.56 |
Open Weights and Self-Hosting
兩者皆提供可下載的 FP8 與 BF16 檢查點。GLM-5.3 Flash 權重採 MIT License。GLM-5.3 採用獨立的 GLM-5.3 License,其規定對於任何連續 12 個月合計營收超過 100 億美元的 Model-as-a-Service 營運商,在商業使用前需通過安全審查。支援的 GLM-5 GitHub 儲存庫採 Apache-2.0 授權。
與旗艦版相比,Flash 較易服務部署,但並非消費級 GPU 模型。其 320B 檢查點、多模態元件、KV 快取與 1M 上下文仍需嚴謹的基礎設施。當資料控制、自訂服務或高持續利用率足以抵銷運維成本時,自託管更具吸引力。
Which Model Should You Choose?
Choose GLM-5.3 Flash if?
- 你需要影像、截圖、圖表、文件、瀏覽器或 GUI 理解。
- 你運行高量的編碼代理、研究流程或商務自動化。
- 你希望以最低 token 成本獲得強勁的工具使用與知識工作表現。
- 你需要 1M 上下文,但不希望每次請求都承擔旗艦級經濟成本。
- 你計畫自託管,且 320B/18B 較 744B/40B 更實際。
Choose GLM-5.3 if?
- 你要解決最困難的倉庫級編碼或長期工程任務。
- 你的評估更獎勵更深的推理,而非較低的單位成本。
- 你需要在 DeepSWE、HLE with tools 或 Agents’ Last Exam 上更強的結果。
- 你在構建授權的防禦安全或弱點發現工作流程。
- 較高的成功率可抵銷約一個數量級的 token 溢價。
Decision Matrix by Use Case
| Workload | Recommended starting model | Why |
|---|---|---|
| High-volume chat and automation | GLM-5.3 Flash | 成本大幅較低;工具使用強 |
| Visual coding and UI debugging | GLM-5.3 Flash | 原生視覺輸入 |
| Document, chart, and Office analysis | GLM-5.3 Flash | 多模態專業工作流程 |
| Routine repository maintenance | Start with Flash | 將失敗或異常困難的任務升級 |
| Difficult repository-scale engineering | GLM-5.3 | 更高的編碼上限 |
| Long-horizon research with tools | GLM-5.3 | 更強的 HLE-with-tools 結果 |
| Defensive security and vulnerability discovery | GLM-5.3 | 專門的資安訓練與基準 |
| Cost-sensitive self-hosting | GLM-5.3 Flash | 較小的活躍與總體量 |
| Uncertain mixed workload | Hybrid routing | 預設 Flash;需要時升級旗艦 |
A Better Production Strategy: Route, Do Not Replace
對多數團隊而言,最強的設計並非非此即彼。將 Flash 作為預設路由,僅將高複雜度、驗證失敗、安全敏感,或其經濟價值足以支撐旗艦溢價的任務升級。
- 將視覺、例行與高量任務送往 Flash。
- 量測驗收率、token、延遲、工具失敗與人工介入。
- 將失敗或高風險的文字任務升級到旗艦版。
- 對安全敏感工作透過額外授權與沙箱控管進行路由。
- 優化每個被驗收結果的成本,而非僅看基準排名或單價。
How to Test Both Models Through CometAPI
CometAPI 在相同的 OpenAI 相容基底 URL 下提供 GLM-5.3 Flash 與 GLM-5.3 路由。建立 API 金鑰後,使用相同的文字任務呼叫兩個 model ID。為公平測試,請固定提示、推理強度、工具定義、最大輸出與驗收準則。
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "請審閱此遷移計畫,並指出其中風險最高的三項假設。",
            }
        ],
    )
    print(model, response.choices[0].message.content)
對多模態評估,請參考線上 Flash 路由文件以確認支援的影像內容結構。由於旗艦版不接受視覺輸入,其比較應使用純文字等效版本。
Limitations of This Comparison
- 多項編碼與代理分數為廠商報告。獨立重現可能採用不同工具、提示與推理設定。
- 基準名稱相同不保證測試框架版本或上下文管理策略一致。
- 架構層級的注意力運算與 KV 快取縮減不直接預示 API 延遲。
- 價格、促銷、模型可用性、速率限制與路由能力可能變動;部署前請核對即時模型頁面。
- 開放權重不代表任何一個檢查點在完整上下文下自託管會便宜。
- 資安能力具雙重用途,需有授權、沙箱、日誌與專家審查,以及負責任揭露。
Conclusion
GLM-5.3 Flash 是務實的預設選擇。它保留長上下文、加入原生視覺、在工具使用與專業工作上表現強勁,並在經濟性上帶來足夠的變化以支援更廣泛的部署。GLM-5.3 則是專家級升級模型:更昂貴、僅文字,但在最困難的編碼、推理與資安任務上更強。
最終結論取決於工作負載:以 Flash 起步,量測實際驗收率,僅在其額外推理能力能帶來足夠額外成功結果、足以支撐溢價時,才路由至旗艦版。
Frequently Asked Questions
Is GLM-5.3 Flash better than GLM-5.3?
不一定。Flash 在價格、多模態以及多項工具/自動化基準上更好。旗艦版在最困難的編碼、工具輔助推理與資安工作負載上更強。
Is GLM-5.3 Flash a small model?
不是。它有 320B 總參數、每個 token 啟用 18B。相較於 744B/40B 的旗艦版更高效,但自託管仍需可觀硬體。
Which model is cheaper?
Flash 顯著更便宜。Z.ai 的標準牌價約為旗艦版的十分之一,且目前 CometAPI 路由在促銷期間的價差更大。
Which model is faster?
取決於指標與供應商。Artificial Analysis 測得 Flash 的首 token 時間略低,但旗艦版的輸出速度更快。
Which model supports images?
Flash 支援原生視覺輸入。旗艦版目前僅支援文字輸入。
Do both models support a 1M-token context?
是。Flash 支援 1M 上下文與最高 128K 輸出;旗艦版提供相同限制。
Which model is better for coding?
例行與高量編碼代理使用 Flash。對最困難的倉庫級工程任務,或當失敗成本高於價差時,使用旗艦版。
Which model is better for cybersecurity?
旗艦版。Z.ai 對其進行了弱點發現與利用鏈推理的專門訓練與評估。僅在授權、受控環境中使用。
Can both models be self-hosted?
可以。Z.ai 的儲存庫列出可下載檢查點與支援的服務框架,但兩者皆需大型基礎設施。
What is the best deployment strategy?
將 Flash 作為預設路由,並把困難、失敗或安全敏感的文字任務升級至旗艦版。以每個被驗收結果的成本為優化目標。