
使用 CometAPI 的 OpenAI 相容 chat-completions 端點是呼叫 GLM-5.3 Flash API 的最快方式。連線細節已彙整於下方 API 規格表;請將 API 金鑰保存在伺服器端。
答案先說:建立 CometAPI 金鑰、安裝一個與 OpenAI 相容的 SDK、向 /v1/chat/completions 發送 POST 請求,待基本請求成功後再依需求新增串流、視覺、JSON 輸出或工具。
什麼是 GLM-5.3 Flash API?
GLM-5.3 Flash 是 Z.ai 的效率優先、原生多模態模型(GLM-5 家族)。它透過聊天 API 提供推理、長上下文、視覺理解與代理導向能力。該模型「總參數為 320B,但每個 token 啟用 18B」(https://docs.z.ai/guides/vlm/glm-5.3-flash);此架構對成本很重要,但開發者主要體驗到的是:在長提示與反覆工具呼叫下,模型能持續保持活躍。
本指南刻意縮短對架構與評測的介紹。配套的模型總覽 已說明混合注意力設計、開放權重、完整上線評測矩陣、定價背景與家族對比。此處重點在整合行為與生產決策。
影響整合的 API 規格
| API specification | Value | Practical meaning |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | 在伺服器端用戶端設定一次即可。 |
| Endpoint | POST /v1/chat/completions | 使用與 OpenAI 相容的 chat-completions 路由。 |
| Compatible SDKs | OpenAI-compatible Python and JavaScript clients | 以 CometAPI 的 base URL 重用熟悉的用戶端模式。 |
| Authentication | Bearer API key | 將金鑰保存在伺服器端環境變數或祕密管理工具中。 |
| Model code | glm-5.3-flash | 在請求本文中使用此精確值。 |
| Context window | 1,048,576 tokens | 適合大型程式庫、文件集合與長代理歷程。 |
| Maximum output | Up to 131,072 tokens | 為控制成本與延遲,應設定較低的應用層上限。 |
| Native inputs | Text, image, video, file | 託管路由支援可能不同;在依賴各模態前,請先驗證 CometAPI 的實際路由。 |
| Output | Text | 模型能理解媒體,但不直接產生影像或影片輸出。 |
| Reasoning | low, high, max | 使用不同投入層級在延遲與 token 消耗間換取深度。 |
| Thinking | Always enabled | 請勿嘗試傳入停用 thinking 的參數。 |
| Developer features | Streaming, function calling, caching, structured output | 對互動式應用、代理與機器可讀管線很有用。 |
模型能力與閘道能力並非完全一致。請以 CometAPI 線上模型頁與 API 結構為準,特別是針對影片、檔案、嚴格 JSON Schema 與供應商特定 thinking 欄位。
簡要效能背景
Z.ai 報告在 API 建置者關心的任務上有不錯的首發結果(https://z.ai/blog/glm-5.3-flash):終端機操作、軟體工程、工具使用與自動化。這些是廠商回報的成績,基於特定測試框架與工具策略,可用於推測優勢領域,而非建立通用排名。
| Benchmark | GLM-5.3 Flash | What it suggests for API workloads |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 很適合以終端機驅動的程式代理。 |
| DeepSWE v1.1 | 63.4 | 對程式庫規模的軟體工程具前景。 |
| Toolathlon Verified | 78.4 | 有力的工具選擇與工具使用訊號。 |
| AutomationBench | 48.8 | 較前代在多步驟自動化方面有所提升。 |
其實務意涵比表格更窄:當工作流程結合長上下文與工具或視覺回饋時,GLM-5.3 Flash 是強力候選。完整模型對比請參考既有的模型總覽,不在此重複。
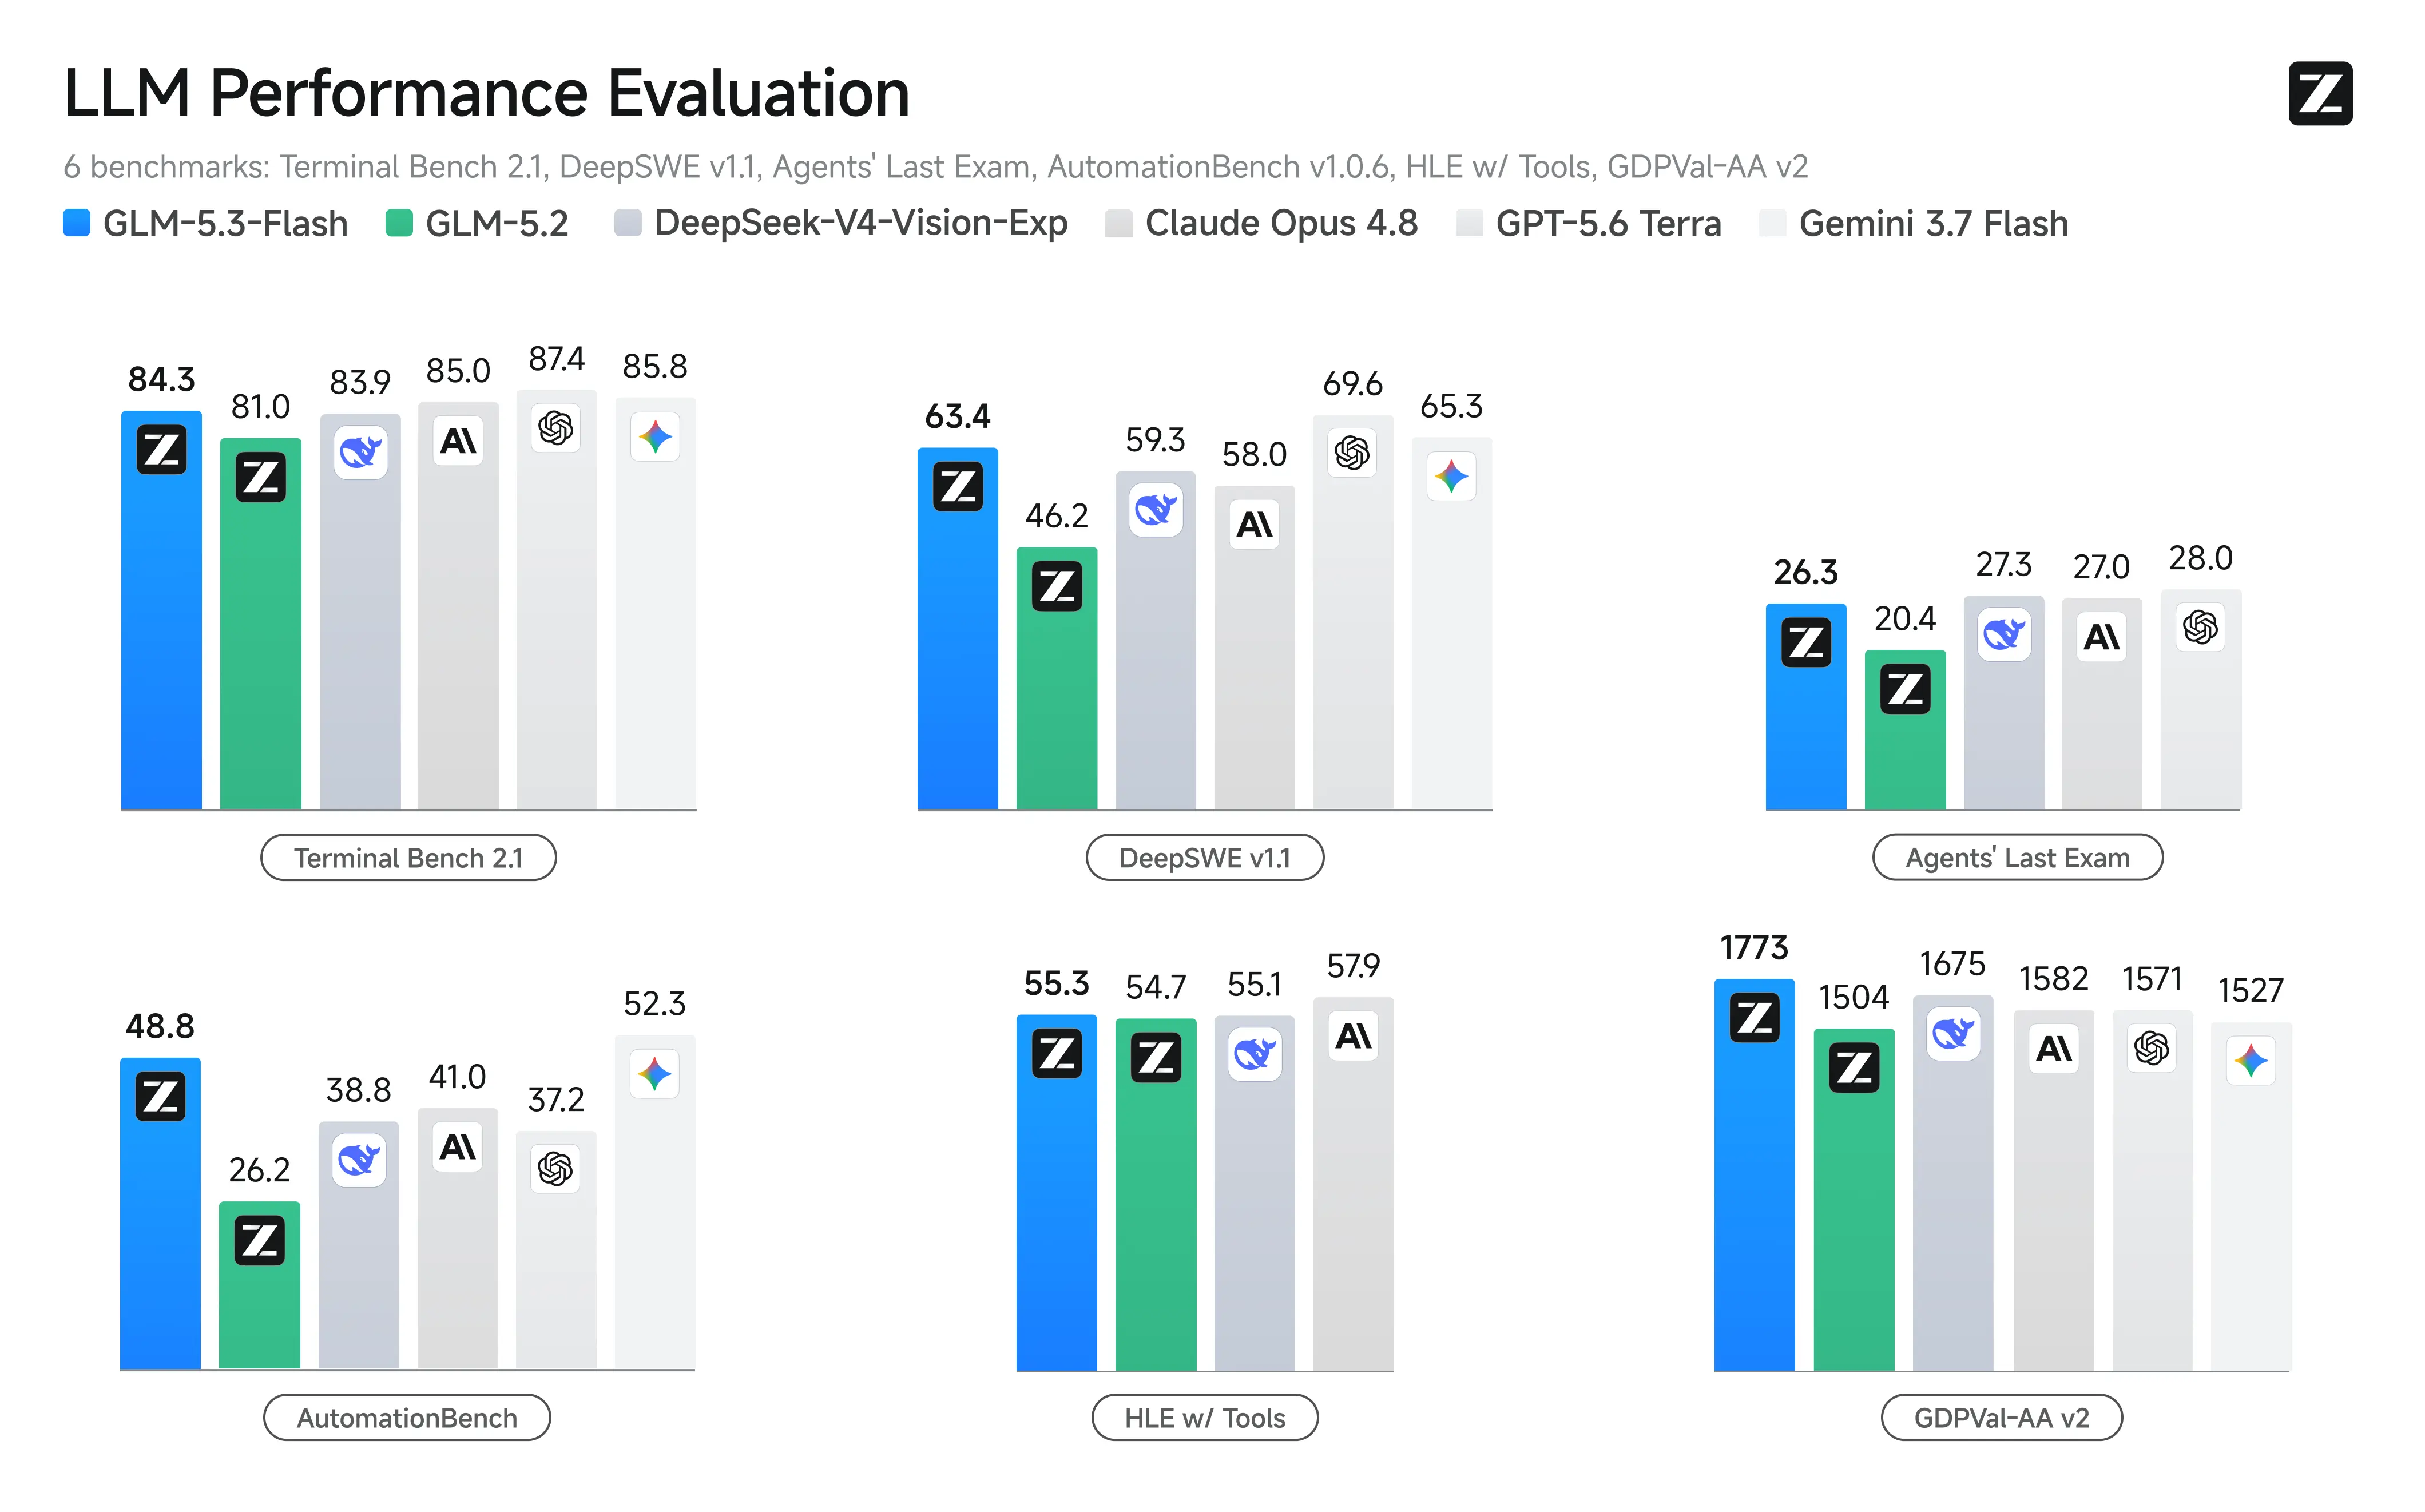
來源:Z.ai 官方效能圖
官方效能圖比較 GLM-5.3 Flash 在不同模型與投入層級的表現。對本 API 指南而言,它提供精煉的效能背景,而非重複整套上線矩陣。應用仍應在自身提示上量測任務成功率、端到端延遲與總 token 使用量。
為什麼透過 CometAPI 使用 GLM-5.3 Flash?
CometAPI 以與 OpenAI 相容的介面提供 GLM-5.3 Flash。這讓團隊可重用熟悉的 SDK 模式、集中管理憑證與計費,並能不必重寫整個請求層就切換模型。
• 單一整合模式:同一個基礎用戶端可透過更換 model ID 呼叫不同支援模型。
• 集中使用可視性:團隊可檢視使用量與成本,無需為每個供應商維護獨立儀表板。
• 更快評估:一套請求工具就能比較候選模型的回應品質、延遲與錯誤。
• 更簡化的備援設計:應用可在同一閘道層保留重試與路由邏輯。
• 較低列價:目前模型頁標示每百萬輸入 tokens $0.06(https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)與每百萬輸出 tokens $0.20(https://www.cometapi.com/models/zhipuai/glm-5-3-flash/);預算前請以線上頁面為準。
開始前準備
你需要一個 CometAPI 帳號、API 金鑰,以及以下任一在地環境:
• Python 3.9+(含 pip)
• Node.js 18+(含 npm)
• 用於最小化命令列測試的 cURL
切勿將正式環境的 CometAPI 金鑰放在瀏覽器端 JavaScript、行動 App、公開儲存庫、截圖或用戶端日誌中。請從可信任的伺服器呼叫 CometAPI,並將金鑰保存在環境變數或祕密管理工具中。
透過 CometAPI 使用 GLM-5.3 Flash API
步驟 1:建立 CometAPI API 金鑰
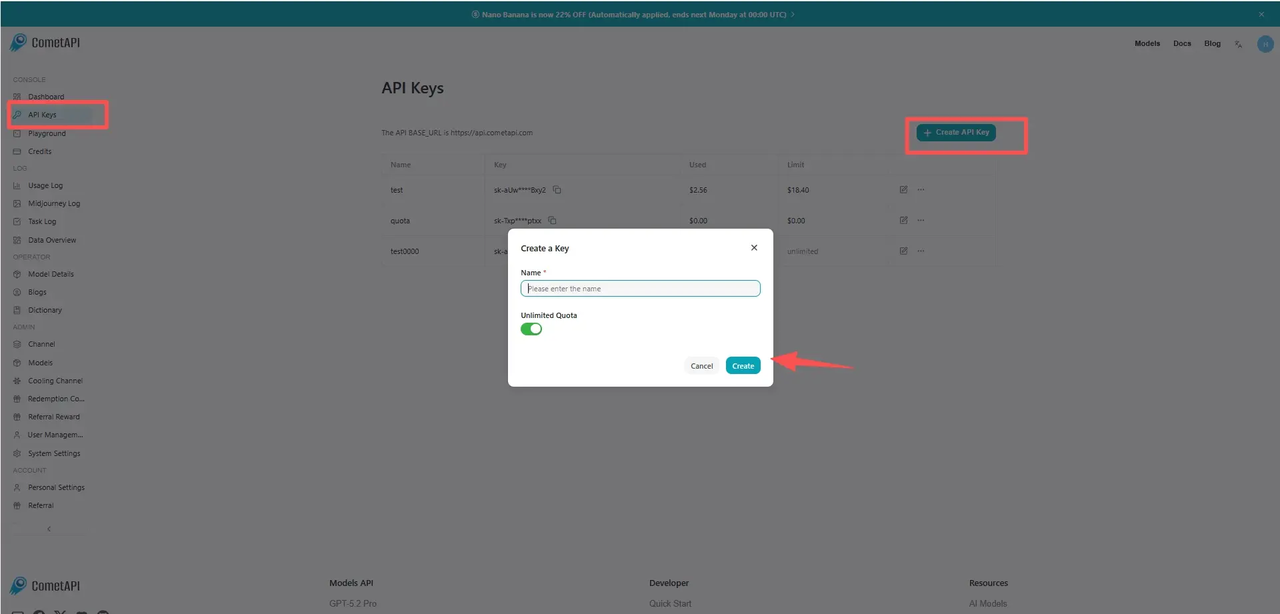
登入 CometAPI,開啟API 金鑰主控台,建立金鑰,並將其一次性納入你的祕密管理流程。開發與生產使用不同金鑰,以便在不影響另一環境的前提下輪換或撤銷。
步驟 2:將金鑰儲存為環境變數
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
在生產環境請以部署祕密、容器祕密或受管保險庫取代 shell 歷史紀錄。

### 步驟 3:安裝與 OpenAI 相容的 SDK
python -m pip install --upgrade openai
npm install openai
```

### 步驟 4:用 cURL 發送第一個請求

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "你是一名精確的技術助理。"
      },
      {
        "role": "user",
        "content": "說明百萬 token 上下文視窗的三個實際用途。"
      }
    ],
    "max_completion_tokens": 800
  }'
```

成功回應會在 choices[0].message.content 下包含一則 assistant 訊息,並在路由支援時附帶使用量中繼資料。先從這個小請求開始,再加入可選參數。

### 步驟 5:使用 Python 呼叫 API

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "你是一名精確的技術助理。",
        },
        {
            "role": "user",
            "content": "請檢視此遷移計畫並列出前五大風險。",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### 步驟 6:使用 JavaScript 呼叫 API

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "你是一名精確的技術助理。" },
    { role: "user", content: "為此 API 擬定安全的分階段上線檢查清單。" },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## 如何控制推理投入

[官方模型文件](https://docs.z.ai/guides/vlm/glm-5.3-flash)支援 [low、high 與 max 的推理投入](https://docs.z.ai/guides/vlm/glm-5.3-flash)。[Thinking 始終啟用](https://docs.z.ai/guides/vlm/glm-5.3-flash);投入設定會改變模型可使用的推理預算。

| Effort | Good starting workloads                             | Trade-off                                            |
| ------ | --------------------------------------------------- | ---------------------------------------------------- |
| low    | 分類、改寫、短篇擷取                                 | 較低延遲與輸出 token 使用;深度較淺。                 |
| high   | 程式碼審查、規劃、文件分析                           | 對多數生產任務是平衡的預設。                         |
| max    | 複雜除錯、工具代理、困難推理                         | 深度最高;延遲與成本可能較高。                       |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "在這份分散式上線計畫中找出隱藏的失敗模式。",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

若已安裝的 SDK 將 reasoning_effort 暴露為一級參數,可直接傳入。若 CometAPI 路由拒絕某供應商特定欄位,請移除該欄位並使用路由預設值。請勿嘗試停用 thinking。

## 如何串流回應

串流對聊天、寫程式助理與長篇分析很有用,因為它能在輸出產生時即時顯示。但它不會減少生成的 token 總數,因此請維持相同的輸出上限與成本控管。

### Python 串流

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "建立一份分階段的資料庫遷移計畫。"}
    ],
    max_completion_tokens=1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript 串流

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "建立一份分階段的資料庫遷移計畫。" },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• 處理取消:當用戶端斷線時停止讀取串流,並在支援時取消上游工作。

• 安全緩衝:不要假設每個區塊都包含完整的單字、JSON token 或工具呼叫物件。

• 記錄最終使用量:使用量資訊可能只出現在最後一個事件或路由特定的中繼資料中。

## 如何傳送影像

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) 透過 messages[].content[] 中的 image_url 區塊接受視覺內容。官方建議使用可存取的影像 URL 或 Base64 Data URL。CometAPI 的模型頁標示支援圖像轉文字,但在正式投入前,應測試格式、檔案大小與路由行為。

### 分析影像 URL

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "請檢視此儀表板,找出可用性問題、含糊的指標,以及可能的資料品質風險。"
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### 以 Base64 傳送本機影像

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "擷取圖表標題、座標軸與主要趨勢。",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• 在編碼前裁切無關的空白區域。

• 縮小遠大於實際資訊需求的影像尺寸。

• 提出具體的視覺問題,而非要求泛泛描述。

• 不要假設公開網頁 URL 就是直接的影像 URL。

• 測試多影像的順序,並在提示中清楚引用每張影像。

## 如何要求結構化 JSON

當下一個元件是程式而非人類讀者時,結構化輸出很有價值。請使用窄且明確的結構、驗證結果,並在路由未完全以相同形式暴露嚴格 JSON Schema 時保留備援。

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "只回傳有效的 JSON。",
        },
        {
            "role": "user",
            "content": (
                "從以下報告擷取設備、嚴重程度、觀察到的症狀與下一步行動:"
                "Feeder 12 在下雨後出現反覆的零序電流尖峰;請檢查絕緣並比較相鄰區段。"
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

JSON 模式不等於免驗證。請在儲存或觸發其他系統前,檢查必要欄位、型別、允許值與最大長度。

## 如何使用 Function Calling(工具呼叫)

Function calling 讓模型在需要外部資料時提出工具呼叫,而應用程式碼仍負責授權與執行。安全模式是:模型提議工具呼叫、伺服器驗證、伺服器執行工具、模型接收結果。

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "只回傳有效的 JSON。",
        },
        {
            "role": "user",
            "content": (
                "從以下報告擷取設備、嚴重程度、觀察到的症狀與下一步行動:"
                "Feeder 12 在下雨後出現反覆的零序電流尖峰;請檢查絕緣並比較相鄰區段。"
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• 驗證參數:將工具呼叫 JSON 視為不受信任的輸入。

• 強制授權:模型不會決定目前使用者被允許做什麼。

• 分離讀寫工具:對具破壞性或對外可見的操作要求再次確認。

• 限制工具清單:只暴露與當前工作流程相關的工具。

• 對迴圈設上限:限制最大工具回合數、總 tokens、經過時間與成本。

## [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) API 參數

| Parameter               | Purpose                           | Practical guidance                                        |
| ----------------------- | --------------------------------- | --------------------------------------------------------- |
| model                   | 選擇模型路由                      | 使用 glm-5.3-flash。                                      |
| messages                | 對話與多模態輸入                  | 保持角色順序有效;保留必要的工具訊息。                     |
| max_completion_tokens   | 限制生成輸出                      | 依工作流程設定,不要只依賴模型上限。                       |
| temperature             | 取樣行為                          | 官方建議為 1。                                            |
| top_p                   | Nucleus 取樣                      | 官方建議為 0.95。                                         |
| reasoning_effort        | 推理預算                          | 使用 low、high 或 max;需測試路由支援度。                  |
| stream                  | 漸進式輸出                        | 對互動回應使用 true。                                      |
| tools                   | 工具(函式)定義                  | 結構保持精簡並驗證每次呼叫。                               |
| tool_choice             | 控制工具選擇                      | 先用 auto,除非工作流程必須使用某工具。                    |
| response_format         | 要求機器可讀輸出                  | 驗證支援情況與回傳 JSON。                                  |

## Z.ai 直連 API 與 CometAPI 對比

兩種路由皆可能適合。決策多半取決於整合所有權、模型廣度、計費與應用對供應商原生功能的即時需求。

| Dimension       | Z.ai Direct API                               | CometAPI                                           | Practical result                                               |
| --------------- | --------------------------------------------- | -------------------------------------------------- | -------------------------------------------------------------- |
| Account and key | Z.ai 帳號與金鑰                               | CometAPI 帳號與金鑰                               | 金鑰不可互換。                                                 |
| SDK pattern     | 與 OpenAI 相容                                | 與 OpenAI 相容                                     | 多數用戶端程式碼可重用。                                       |
| Model coverage  | Z.ai 模型家族                                 | 多家供應商與多個模型家族                          | CometAPI 有助於路由與比較。                                    |
| Native features | 最快取得供應商原生行為                        | 取決於閘道的暴露與傳遞                             | 先在選定路由上測試進階欄位。                                   |
| Billing         | 供應商專屬                                    | 跨支援模型集中計費                                 | 對多模型營運可簡化。                                           |
| Fallback design | 需要另行整合其他供應商                        | 可維持在單一閘道層                                  | CometAPI 可降低切換摩擦。                                       |
| Best fit        | 深度投入 Z.ai 原生能力                        | 統一存取、評估與生產路由                           | 依系統架構選擇,而非泛用結論。                                 |

若需要最新的供應商原生參數或產品功能,請用直連 API。若更在意單一用戶端、統一計費、以及比較或替換模型的能力,請用 CometAPI。進入生產前,請在你實際計畫部署的路由上跑同一套具代表性的測試。

## 成本估算與 Token 預算

目前 [CometAPI 模型頁](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)標示每百萬輸入 tokens $0.06(https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)與每百萬輸出 tokens $0.20(https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)。以此估算請求成本為:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Workload                | Input tokens | Output tokens | Estimated cost |
| ----------------------- | ------------ | ------------- | -------------- |
| Short question          | 2,000        | 400           | $0.00020       |
| Code review             | 50,000       | 4,000         | $0.00380       |
| Large document analysis | 250,000      | 10,000        | $0.01700       |
| Long agent run          | 800,000      | 30,000        | $0.05400       |

價格會隨時間調整。發佈或生產預算前請確認最新的輸入、快取輸入與輸出費率。推理與工具迴圈會增加計費的輸出與重複輸入,因此應估算完整工作流程,而非單一可見答案。

## GLM-5.3 Flash API 生產最佳實務

### 成本與延遲控管

#### 輸出上限

評測生成設定與生產 API 限制不同。引用的 HLE 評測使用 163,840 tokens 最大輸出長度,另一些評測使用 64K 輸出;兩者都不能證明每個託管 API 路由都能回傳超過 100,000 tokens。請依線上路由結構與工作流程預算設定上限。分類與擷取用小上限、分析用中等上限、僅在明確長文或代理任務時設定更大上限。

#### 上下文控管

百萬 token 視窗是容量,不是目標。擷取相關檔案、移除重複日誌、將穩定指示放在前段,並量測額外上下文是否提升任務成功率。

### 狀態與可靠性

#### 保留狀態

儲存下一回合所需的完整 assistant 訊息,包括工具呼叫與你的應用已驗證的路由特定欄位。捨棄結構化歷史即使文字看似完整,也可能破壞多步驟工具迴圈。

#### 有選擇地重試

• 對 429、500、502、503 與網路逾時等暫時性錯誤,以指數退避加抖動重試。

• 切勿盲目重試驗證錯誤、無效參數或超大請求。

• 附上應用請求 ID,以辨識重複工作。

• 即使模型請求本身被重試,也要在外部寫入操作周圍使用冪等控制。

### 安全與驗證

#### 驗證機器可讀輸出

在模型與所有資料庫、佇列或外部 API 之間加入結構驗證、允許值檢查、長度限制與領域規則。語法上有效的 JSON 物件仍可能不完整或不安全。

#### 授權工具呼叫

將模型提出的工具呼叫視為不受信任的請求:驗證參數、強制使用者授權、分離讀寫操作,對具破壞性的動作要求確認。

### 可觀測性與備援

#### 度量工作流程

• 任務成功或人工接受率
• 第一個 token 時間與總延遲
• 輸入、快取輸入、推理與輸出 tokens
• 工具呼叫次數與工具失敗率
• 重試、速率限制與供應商錯誤
• 以完成任務的成本為準,而非單次 API 呼叫成本

#### 設計備援

依工作負載選擇備援,而非聲譽。對文件擷取,文字專用的備援或許可行,但對截圖任務則可能失敗。定義哪些輸入與工具結構可移植、哪些參數必須移除、以及何時應顯示可恢復錯誤,而非自動切換模型。

## 常見錯誤與疑難排解

| Symptom                 | Likely cause                                                       | What to check                                                                |
| ----------------------- | ------------------------------------------------------------------ | ---------------------------------------------------------------------------- |
| 401 Unauthorized        | 金鑰缺失、格式錯誤或已撤銷                                         | 確認 Authorization 標頭與伺服器端環境變數。                                   |
| 404 or model not found  | model ID 錯誤或路由不可用                                         | 使用 glm-5.3-flash 並在線上模型頁確認可用性。                                  |
| 429 Rate Limit          | 請求或 token 配額超限                                             | 退避、降低併發、檢視帳戶限制並加上抖動重試。                                   |
| Unsupported parameter   | 閘道未暴露的供應商原生欄位                                         | 先移除可選欄位,再逐一加回測試。                                              |
| Context length exceeded | 提示加上要求輸出超過路由上限                                       | 取捨、擷取、摘要,或降低 max_completion_tokens。                               |
| Invalid image           | URL 不可存取、格式不支援、或 Base64 無效                           | 測試直接的 HTTPS 影像 URL 並修正 MIME 前綴。                                   |
| Broken streamed JSON    | 逐塊解析時誤將區塊視為完整物件                                     | 緩衝完整後再解析整個 JSON 載荷。                                               |
| Tool loop never ends    | 無步數預算或工具結果含糊                                           | 設定回合上限、改善工具描述、並回傳明確的工具錯誤。                             |

## 何時應使用 GLM-5.3 Flash API?

### 適用情境

• 程式庫規模的程式理解與多檔案審查
• 視覺化程式設計、截圖分析與介面 QA
• 長文件集合與有根據的綜合分析
• 使用工具的代理,具反覆規劃與驗證
• 高流量且 token 成本顯著影響單位經濟的工作流程
• 受益於透過單一閘道切換或比較模型的應用

### 選用其他路由或模型的情境

• 產品需要影像或影片輸出(而非文字輸出)。
• 任務是小型、低風險分類,較小模型即可可靠處理。
• 必須使用尚未由閘道路由暴露的供應商原生功能。
• 工作流程無法容忍始終啟用的推理或其延遲特性。
• 應用尚未在自身工具、資料與失敗案例上測試模型。

## 常見問答

###

### 上線前應在 CometAPI 的實際路由上驗證哪些事項?

以具代表性的請求驗證模型可用性、可接受的多模態格式、最大輸出、推理相關欄位、結構化輸出行為、速率限制與當前價格。

### 生產評估應追蹤哪些指標?

追蹤任務成功率、第一個 token 時間、總延遲、輸入與輸出 tokens、工具呼叫失敗、重試率,以及每個完成工作流程的成本,而不僅是每次 API 呼叫的成本。

### 應如何在 Z.ai 直連與 CometAPI 之間做選擇?

當供應商原生行為的即時可用性至關重要時,使用 Z.ai 直連;當統一驗證、計費、模型比較與閘道層備援更重要時,使用 CometAPI。

### 什麼是安全的備援?

安全的備援會接受相同的輸入模態、保留必要的工具結構、移除不支援的參數、維持在任務的授權邊界內,並在無法保留行為時,以可辨識的方式失敗。

## 結論

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) 在結合長上下文、視覺輸入、推理與工具使用的一體化工作流程中最具效用。CometAPI 的基本整合很小:一個伺服器端金鑰、一個與 OpenAI 相容的用戶端、[glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) 模型 ID,以及 chat-completions 端點。生產品質來自該請求之外的一切:聚焦提示、輸出上限、結構驗證、工具授權、重試、可觀測性與依工作負載而定的評估。

先從簡短的文字請求開始,每次新增一項進階能力,並在擴張前測試完整的使用者旅程。請確認線上的 [GLM-5.3 Flash 模型頁](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)以瞭解當前可用性、支援的路由行為與價格。

## SEO Metadata

**Meta title:** 如何使用 GLM-5.3 Flash API:開發者指南

**Meta description:** 了解如何透過 CometAPI 使用 GLM-5.3 Flash API,包括 Python 與 JavaScript 範例、視覺、串流、工具、JSON 輸出與最佳實務。

**Keywords:** GLM-5.3 Flash API、如何使用 GLM-5.3 Flash、GLM-5.3 Flash Python、GLM-5.3 Flash JavaScript、GLM-5.3 Flash CometAPI、GLM API 教學、多模態 API、推理 API、function calling

**URL slug:** how-to-use-glm-5-3-flash-api