Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog 什麼是提示快取?2026 年的 OpenAI vs Claude vs Gemini ai-comparisons / CometAPI 研究
什麼是提示快取?2026 年的 OpenAI vs Claude vs Gemini 了解 2026 年提示快取的運作方式。比較 OpenAI、Claude 與 Gemini 的快取方法、TTL、定價、效能、Python 範例、CometAPI 存取。
Deon Goodwin AI 模型與 API 研究團隊 了解 2026 年提示快取的運作方式。比較 OpenAI、Claude 與 Gemini 的快取方法、TTL、定價、效能、Python 範例、CometAPI 存取。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
提示快取讓語言模型重用先前處理過的提示前綴,而不必重複相同的輸入計算。它可降低輸入 Token 成本並改善延遲,特別適用於代理工作流程、客服、RAG 以及大型文件分析。到 2026 年,OpenAI 提供自動快取與較新的顯式快取控制,Claude 支援自動與區塊層級的快取斷點,Gemini 在其最新模型上強調隱式快取。各供應商對快取寫入、讀取與(如適用)儲存的計費不同。快取到期可能觸發再次寫入或完整輸入計費,因此實際節省取決於重用頻率與量測到的快取命中。
本指南比較開發者在重複性輸入情境下使用 GPT-6.1 Sol、Claude Opus 5.5 與 Gemini 4 Argon 的提示快取。重點在快取控制、定價,以及如何驗證重用。
Key Takeaways
提示快取重用的是已處理的輸入,而非模型先前的答案。
OpenAI 的提示快取取決於穩定前綴、模型支援特性,以及模型特定的最小值與保留設定。
Claude 的提示快取提供 5 分鐘與可選的 1 小時 TTL,並支援自動與顯式快取控制。
Gemini 在現代模型上以隱式快取為主;顯式快取資源依模型而定。
提示快取的節省取決於寫入、讀取、儲存與實際命中;使用 CometAPI 時請驗證端點支援與快取 Token 計費。
What Is Prompt Caching in LLMs?
提示快取是一種推論最佳化,允許重用先前處理過的前綴所產生的運算狀態。提示通常包含穩定的指令、工具定義或文件,後面接著變動的使用者問題。若後續請求重複符合條件的前綴,供應商可重用快取的鍵值(KV)狀態,只處理未快取的剩餘部分。不同於回應快取,它不會重播先前的答案:模型會針對當前請求產生新的回覆。
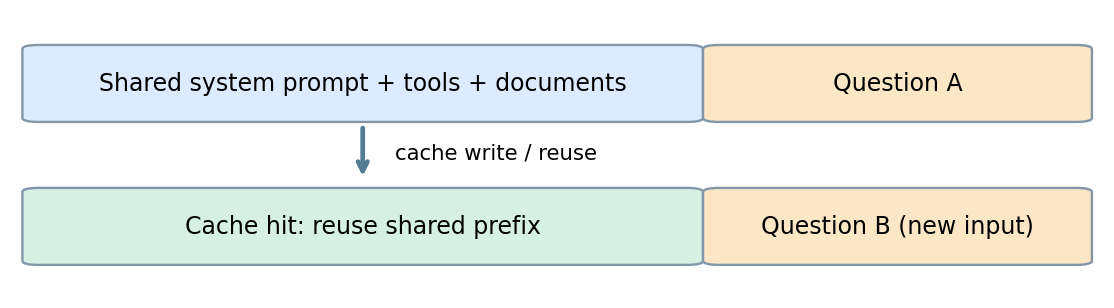
第一次請求:送出大型、可重複的前綴與特定問題。
建立快取:供應商儲存符合條件的中間運算狀態。
下一次請求:重用相同前綴並替換問題。
快取讀取:重用先前處理的 Token,同時正常處理新 Token。
概念示意圖來自原始草稿:重複的提示材料在前,變動的問題在後。這不是官方供應商的架構圖。
共同的設計原則是前綴穩定性。API 契約、符合條件的模型族、快取壽命與費用不可混用。
OpenAI, Claude, and Gemini Caching at a Glance 相同的穩定前綴原則適用於各家供應商,但以下控制項特定於本指南使用的模型。請同時檢查模型與端點再複製設定。
Cache activation 隱式匹配;支援顯式斷點 以請求層級或內容區塊的 cache_control 選擇加入 預設啟用隱式快取 Minimum prefix 1,024 可見輸入 Token 斷點前 512 Token 4,096 輸入 Token Lifetime controls Responses API:prompt_cache_options.ttl;預設 30m 或 12h 預設 5 分鐘;可選 1 小時 TTL 由供應商管理的隱式存活期 Where to place stable content 前置的指令、工具與參考資料 穩定的工具定義、system 內容,或斷點之前的訊息區塊 將大型共享內容置於提示開頭 Usage to inspect input_tokens_details.cached_tokens 與回報的快取寫入用量 cache_creation_input_tokens 與 cache_read_input_tokens usage_metadata 中的 cached_content_token_count(如有) Important distinction prompt_cache_key 可區分帳務;Sol 的自動路由不強制需要 斷點必須結束在保持不變的內容 Argon 無顯式快取資源;部分舊版支援另行介面
Prompt Caching Controls and Python Examples 每個範例都以相同的參考資料搭配兩個不同問題送出。保持共享內容不變,依序執行請求,並檢查使用量以判斷第二次請求是否確實重用了快取輸入。
OpenAI: Cache Controls and Python Example OpenAI 會自動匹配可快取的提示前綴,且在支援的新型模型上允許設定顯式斷點與保留期。當長篇 system 指令、工具結構或存放庫內容在多次請求中重現時,快取重用尤其有用。所需前綴長度與 Token 價格倍率取決於模型世代與所選保留層級。
此範例使用 Responses API,將 prompt_cache_options 設為隱式模式與 30 分鐘存活時間。較早的模型世代使用不同的保留參數;請遵循你實際模型的設定 。
安裝 openai SDK 並設定 OPENAI_API_KEY。於穩定前綴中至少使用 1,024 個可見 Token。依序執行兩個請求,檢查 input_tokens_details.cached_tokens 與使用量中的 cache_write_tokens。正的快取 Token 計數確認有計費的快取讀取;這不保證每次請求都能降低延遲。
要執行這些範例,請安裝相應的 Python SDK、設定供應商 API 金鑰,並建立一個 UTF-8 的 reference.txt 檔,內含足以達到該模型快取門檻的穩定內容。
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example 在 Claude Messages API 中,提示快取需選擇加入。可在請求層級加入 cache_control 以自動放置斷點,或將其附加到內容區塊以標示顯式斷點。開發者可標記穩定的指令、文件與選定的提示區塊,同時變更後續的使用者輸入。標準短時快取為 5 分鐘,另有 1 小時選項,適合合適的工作負載。
安裝 anthropic SDK 並設定 ANTHROPIC_API_KEY。對 Claude Opus 5.5 而言,在快取邊界之前至少提供 512 個 Token。於不同請求間保持 system 區塊完全相同。快取項目會在第一次回應開始時可用;此範例等待完整回應以簡化示範。請檢查快取建立與讀取計數;過短的前綴可能同時回傳零而不拋出錯誤。
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example Google 將其實作稱為 context caching。Gemini 4 Argon 使用隱式快取,不支援顯式快取資源。部分較早的模型族支援可設定 TTL 的顯式快取。請依各模型契約選擇快取介面,而非假設所有 Gemini 模型都具相同控制。
安裝 google-genai 並設定 GEMINI_API_KEY。對 Gemini 4 Argon 而言,使用至少 4,096 個共享的前置內容,並在第一次請求後不久送出第二次請求。於 usage_metadata(如有)中檢視 cached_content_token_count。隱式快取即便前綴符合資格也可能未命中。
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini? 評估快取成本時,應同時考慮寫入、讀取,以及(在部分顯式快取系統上)保留或儲存。以下倍率示意常見設計,並非所有模型版本的通用價格承諾。
Uncached input 一般輸入 Token 費率 一般輸入 Token 費率 一般輸入 Token 費率 Cache write 新型模型可能有寫入加成 5m/1h 寫入加成 隱式或顯式,依模型而定 Cache read 降低的模型特定費率 降低的模型特定費率 降低的模型特定費率 Cache lifetime 依模型而定 5m / 1h 隱式管理 / 顯式可設定 Additional storage 視模型而定 通常反映於寫入層級 可能有顯式儲存費用
示意範例:一個 10,000 Token 的前綴在 N 次請求間被重用,初次快取寫入成本為一般輸入的 1.25 倍,後續快取讀取成本為一般輸入的 0.1 倍。假設基本輸入價格為每百萬 Token 2 美元,且在第一次請求之後皆完美命中快取。
10 $0.200 $0.043 78.50% 100 $2.000 $0.223 88.85%
公式:Cached prefix cost = 1.25P + (N − 1) × 0.1P,其中 P 為處理共享前綴一次的正常成本。此範例不包含動態輸入、輸出、到期、未命中、儲存與其他服務。
上述範例以 10% 的讀取費率為示意,非 GPT-6.1 Sol 的當前費率。Sol 的標準短上下文定價 為每百萬未快取輸入 Token 2 美元、快取輸入 Token 0.10 美元,以及在預設存活期下每百萬寫入 Token 2.50 美元。請依你的實際模型、層級與端點帳單重新計算。
較長的存活期只有在其避免足夠多的重複寫入或未快取請求並能抵銷其價格時才值得。Claude 的 5 分鐘與 1 小時寫入分別按基本輸入的 1.25 倍與 2 倍計價。受支援的舊版 Gemini 顯式快取也可能產生儲存費用。請在真實的閒置間隔下量測重用,而非僅在一連串的緊密呼叫中。
請將未命中、到期與輸出生成視為帳單的一部分。若前綴在重用前過期,下一次請求可能需要再次寫入或完整輸入處理。短提示可能完全不符合資格,而長回覆即便快取重用強勁,也可能使輸出 Token 成為最大的支出。請在加入更多快取複雜度前,先比較每個完成任務的總成本。
Which Prompt Caching API Is Best for Different Workloads? 對於程式代理與客服,請將穩定的工具定義、存放庫內容、政策與知識放在變動任務之前。OpenAI 與 Claude 提供有助於定義可重用邊界的斷點控制;請評估端點的實際快取讀取,而非假設重複文字即被快取。
對於文件分析與多模態工作,請將來源文件或支援的媒體置於問題之前。Gemini 的隱式方法降低快取管理工作;Claude 允許直接標記穩定區塊。在依賴重用之前,請確認特定媒體類型與模型的支援。
對於長對話,請附加新回合而非反覆重寫開頭,並選擇可用且符合回合間隔的存活期。若你的應用需要可顯式建立並引用的具名快取資源,請評估支援該介面的 Gemini 模型;Argon 不支援。
沒有通用的贏家:請在真實流量模式下比較快取命中率、每個完成任務的成本與延遲。
快取命中可減少重複的輸入處理,並縮短首個 Token 的時間。它並不會本質上提升答案品質或加速輸出生成,而且被快取的輸入仍佔用上下文視窗。請在可比較的請求上同時量測首 Token 延遲與總回應時間;僅僅快取命中並不代表使用者更快收到最終答案。
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix 將可重用的指令、工具定義、政策與文件放在前面;把時間戳、請求 ID、變動上下文與使用者問題放在後面。保持工具順序與結構穩定。使用顯式快取時,將斷點結束在最後一個保持不變的區塊。僅在有助於任務時加入參考資料;不要為追求快取指標而膨脹每次請求。
If Cached Tokens Stay at Zero 在修改提示前先檢查資格:確認精確的模型、端點、最小 Token 長度與必需的快取控制設定。接著以完全相同的共享內容連續送出兩個請求。分別檢查快取建立與快取讀取;第一次請求可能建立了供後續請求重用的項目。隱式快取是「有機會命中」,非「保證命中」。
對 Claude 而言,低於最小值的請求可能同時回傳零的快取建立與快取讀取 Token,而不拋錯。其快取項目會在第一次回應開始時可用。Claude 的快取指南 亦說明斷點位置與變更請求設定如何影響重用。
If Hits Disappear Between Requests 比較實際 payload,而非僅比較提示樣板。檢查文件文字是否改變、工具是否重排、結構是否變更、早期對話是否被改寫,或在可重用邊界之前是否插入了動態欄位。檢視與先前請求的時間間隔,以及所選存活期是否涵蓋該間隔。一次只變更一個變數並記錄使用量結果。
If Hits Do Not Produce Savings 分開計算快取輸入、寫入、未快取輸入、輸出與任何儲存費用。閒置間隙後的重複寫入、低重用率或長輸出,可能抵消輸入折扣。使用上文的成本計算,搭配量測到的使用量與端點實際計費。僅在其改善總任務成本或使用者可見延遲時保留該最佳化。
Check Endpoint Support and Data Boundaries 相容端點可能接受請求,但未暴露與原生 API 相同的快取控制或使用欄位。請確認參數支援,並將回傳的使用量與帳戶計費比較後,再將重用視為節省。維持租戶隔離與存取控制,並遵循供應商的保留與資料處理政策。快取不取代這些控制。
CometAPI 提供跨模型族測試請求的單一整合點。針對快取,請驗證所選端點接受哪些供應商特定控制,以及快取輸入如何出現在使用量與計費中。開發者可集中化模型測試,但仍需分別驗證快取行為與帳務,因為原生供應商選項不保證在代理或相容端點上一致。
安裝 openai SDK 並設定 COMETAPI_KEY。此範例透過 CometAPI 的 OpenAI 相容 Chat Completions 介面傳送具有重複前綴的請求。確認模型可用性,接著檢查回傳的使用量與帳戶計費,以找出快取重用的證據。未確認支援前,請勿將 Responses API 的快取參數直接套用到此端點。
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion 對於重複性高的 AI 應用,提示快取能夠大幅影響推論經濟性。OpenAI 提供日益細緻的提示與保留控制;Claude 提供便利的自動與區塊層級控制;Gemini 則在現代模型上以隱式重用簡化管理。正確的實作取決於穩定提示的規模、命中率、到期與總成本。請先建立清晰的共享前綴、驗證使用遙測,接著以貼近實際的量測來優化存活期與供應商選擇。
FAQ
How can I compare caching providers fairly? 重放相同的有用來源文件與等效問題,但使用各供應商自己的 Token 計數與實際計費。保持輸出需求可比,並回報失敗與成功請求。固定字元數不代表相同 Token 數,因此請在快取命中測量之外,同時比較每個完成任務的成本。
Should I cache every document in a changing knowledge base? 依文件的變更頻率與重用頻率分組。經常更新的文件可能反覆使大型共享前綴失效;將穩定的政策材料放在前、變動材料放在後可降低風險。對來源材料進行有意義的版本化,並在正確性需要時更新,即使這會降低快取重用。