SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. new/CometAPI 研究
Tencent Hyra 2.0:Harness 架構、基準測試與結果
探索 Tencent Hunyuan Hyra 2.0、其三層代理 Harness、科學模型、基準測試、研究突破,以及與 Hyra 1.0 的差異。

Deon GoodwinAI 模型與 API 研究團隊 from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-5-mini",
messages=[{"role": "user", "content": "Build this workflow."}],
)
print(response.choices[0].message.content)
重點摘要
Tencent Hunyuan 於 2026 年 11 月 2 日推出 Hyra 2.0,作為一個用於開發科學模型、軟體工具與可重用工作流程的研究 Harness。其核心特點是在跨多天或多週的實驗中實現持久協同。
目前公開釋出的是部分研究產物——模型、程式碼、權重與報告——而非可普遍使用的 Hyra 2.0 托管服務。截至 2026 年 11 月 4 日,騰訊公開資料未記載通用的編排 API 或訂閱方案。
主要要點
- 研究目標:Hyra 2.0 開發可支援多個研究專案的可重用科學模型與工具。
- 持久協同:Overall、Mission 與 Worker 代理分工合作,透過佇列與研究記錄在長時程實驗中保留進度。
- 知識可重用:代理記憶、Books 與研究技能將發現與其支撐證據及適用條件一併保存。
- 任務特定結果:已釋出的蛋白、力場與細胞模型面向不同科學工作負載;速度與品質應一併評估。
- 實務取得:從可用的研究產物開始。完整的 Hyra Harness 與托管的 Hunyuan 模型 API 是不同的產品。
什麼是 Tencent Hunyuan Hyra 2.0?
意為 Hunyuan Research Agent 2.0,是一個旨在自動化複雜科學研究與工程工作流程的多代理系統。
騰訊將 Hyra 2.0 定位為從解決單一問題轉向開發可用於探索更廣泛問題類別的模型、方法與基礎設施。
Hyra 2.0 並非具固定參數規模或上下文視窗的獨立基礎模型。它是一個可使用不同 AI 模型、執行程式碼、管理科學實驗並協調專門研究代理的編排系統。
科學研究不僅僅是推理。完整專案可能需要實驗設計、實作、訓練、除錯、評估與反覆修正。這些活動可能跨越數天或數週,且常涉及平行實驗與共享運算資源。
Hyra 2.0 透過將模型智能與持久執行、結構化協作以及基於證據的驗證結合,來應對這一運營挑戰。
Hyra 2.0 技術規格
|
| 開發者 | Tencent Hunyuan |
| 公開宣布 | 2026 年 11 月 2 日 |
| 系統類別 | 自主科學研究代理 |
| 核心架構 | 分層多代理 Harness |
| 代理角色 | Overall、Mission、Worker |
| 研究執行 | 長時間、並行的工作流程 |
| 任務管理 | 持久化任務佇列 |
| 協作 | Research Board 與代理訊息傳遞 |
| 驗證 | 以證據為基礎的結果與獨立的 Review Worker |
| 記憶 | 專案狀態、分層代理記憶、共享 Books |
| 知識重用 | 經驗證的發現與可重用技能 |
| 模型靈活性 | 不同 Worker 可使用不同底層模型 |
| 研究環境 | WeCom、運算平台、程式碼儲存庫 |
| 人類監督 | 對重大操作設置核准檢查點 |
| 公開產物 | 選定的模型、原始碼、訓練權重與技術報告 |
該系統規格描述其編排與研究能力。Hyra 2.0 創建的個別科學模型則各自有不同的架構、參數規模與效能基準。
為什麼 Hyra 2.0 要打造工具
從 Hyra 1.0 到 Hyra 2.0 的轉變,針對的是自動化研究的一個基本限制:成功解決一個問題,未必能提升系統解決下一個問題的能力。
Hyra 1.0 使用相對簡單的代理循環來產生解法、執行評估,並透過反覆嘗試改善結果。在騰訊開源的 Hy3 模型支援下,Hyra 1.0 幫助確立了和集與差集之間關係的最優指數,並同時發佈了機器檢驗的證明。這一區別很重要:被評估的數學結果是具體輸出,而對研究流程的改進則可在後續問題中重複使用。
從答案到可重用能力
- 代理解出單一道數學問題。
- 代理開發出可解決類似問題的證明工作流程。
- 代理改進未來研究系統所用的推理模型與驗證工具。
第一個產生答案。第二個產生可重用的方法。第三個可改進底層研究能力本身。
騰訊將可重用工具分為兩大類。Symbolic tools 透過程式碼、演算法、規則與工作流程來表達能力。例子包括自動化驗證系統、科學搜尋演算法與實驗管理管線。Parametric tools 則將學得的能力存於模型權重中,包括蛋白設計模型與科學基礎模型。
改進任一類別,都能惠及多個下游任務,而不必讓每個研究專案從相同起點重新開始。
邁向遞迴式自我改進的方向
Hyra 2.0 亦為遞迴自我改進鋪路。基礎模型研究依賴訓練基礎設施、合成資料管線、最佳化演算法與推理系統。
若 AI 代理改進這些工具,它們可助力開發更強的模型。而更強的模型接著能參與後續的工具開發。
更好的研究工具 → 更強的 AI 模型 → 更有能力的研究代理 → 更好的研究工具。
騰訊描述將 Hyra 應用於預訓練基礎設施、後訓練資料生成與推理最佳化。這在工具開發與模型開發之間建立了可能的正向迴圈。它本身並不保證無限或完全自主的遞迴改進;每一項預期收益仍需以實驗隔離其效果。
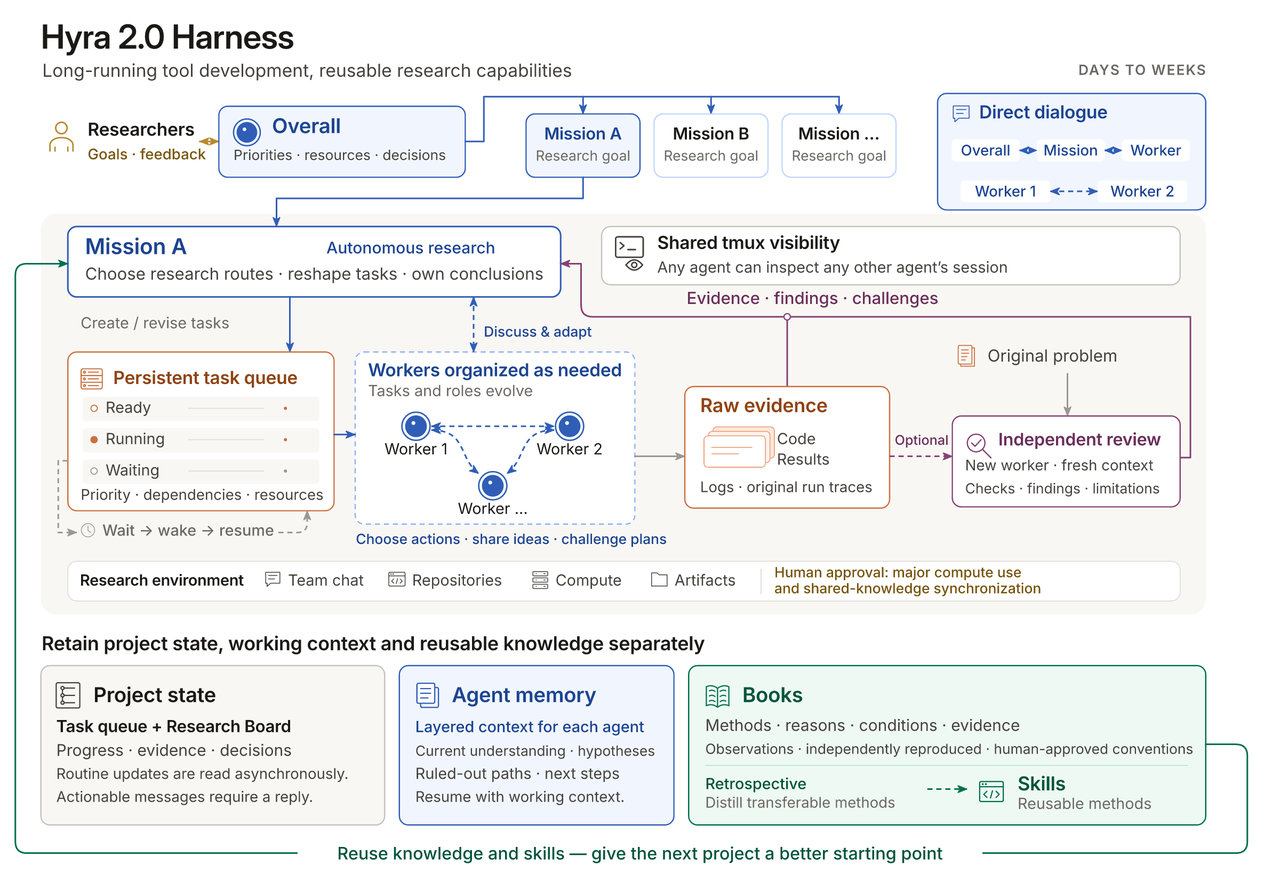
Hyra 2.0 的 Harness 架構如何運作?
Harness 是 Hyra 2.0 的核心工程創新。傳統代理循環可在單一會話內執行工具、檢視結果並持續推理。科學模型開發需要更進階的執行環境。
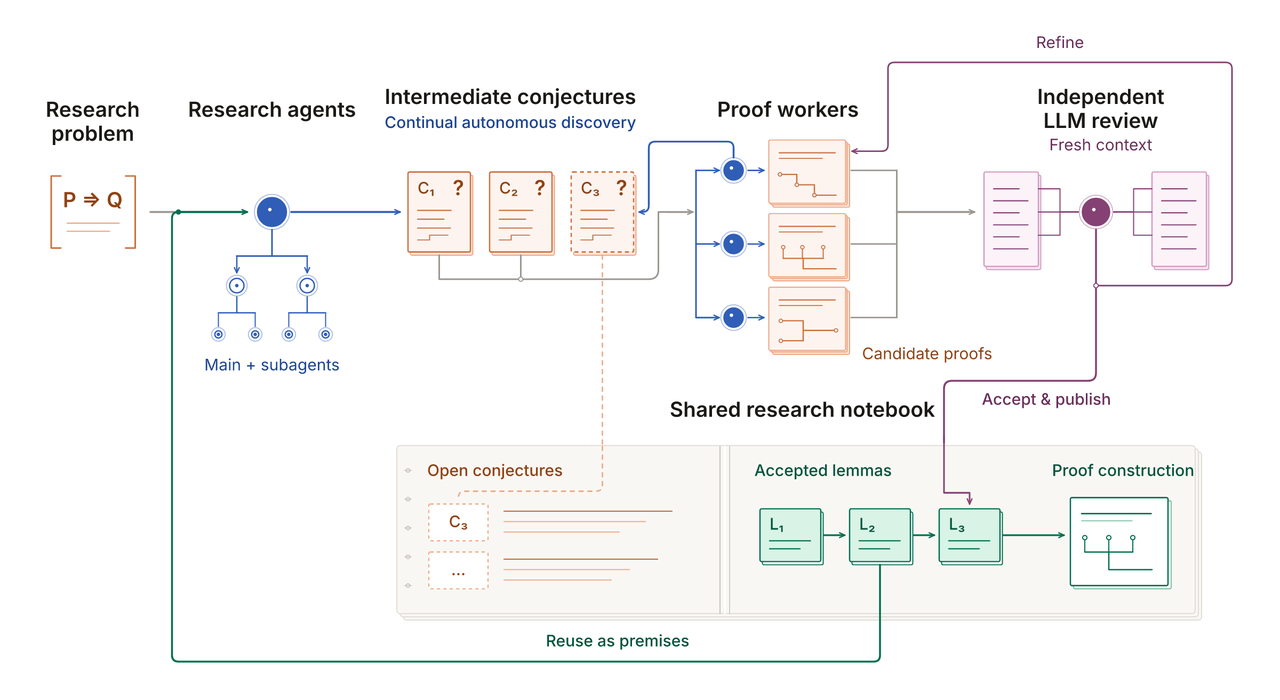
實驗可能運行數小時,訓練任務可能耗時數天,不同研究方向可能需要不同運算資源與驗證方法。Hyra 2.0 透過三層代理、持久任務排程、結構化研究記錄與獨立驗證來滿足這些需求。
Overall:研究協調與資源管理
Overall 是最高協調層。它與人類研究人員溝通、維持與研究目標一致、管理優先級並協調運算資源。
其職責包括決定哪些專案應獲得額外資源,並識別需要人類核准的決策。因此 Overall 作為自主研究活動與人類研究管理之間的協調層。
Mission:長期研究規劃
每個 Mission 針對一個特定研究問題負責。Mission 在多次實驗中維持研究方向、組織 Worker、解讀結果,並決定某個假設是否值得進一步探究。
它也會判定何時應修正或放棄某研究方法。這在長期專案中提供連續性,而無需單一代理會話保留每個中間步驟。
Worker:實驗執行與獨立探索
Worker 執行專門的研究任務。職責包括閱讀程式碼、實作演算法、運行實驗、診斷故障並提出替代方案。
Worker 可以質疑 Mission 的決策,不同 Worker 也可使用不同底層 AI 模型。此結構支援平行探索,降低對單一路徑推理的依賴。
持久排程與 Research Board
Hyra 2.0 將研究任務放入持久佇列。排程器在啟動 Worker 時會考量任務優先級、相依性與可用資源。
當某個實驗在等待訓練結果或人類核准時,其他任務可繼續。代理亦可在實驗完成後排定下一次喚醒。
Research Board 記錄假設、發現、證據與重大決策。此舉將研究專案的持久狀態與個別代理的對話分離。
獨立驗證與人類核准
Worker 的結論必須以實驗證據支撐,如程式碼版本、執行日誌、評估結果或原始追蹤。
當結果需要額外檢視時,獨立的 Review Worker 可對原始問題與證據進行獨立檢查。此流程有助在結果影響後續研究前,識別缺乏支撐的結論與實作錯誤。
高成本運算操作與對共享團隊知識的更改仍需人類核准。因此該架構將自主執行與對重大決策的顯式檢查點結合。
Books:把研究經驗轉化為技能
- 專案狀態:任務佇列、協作記錄與研究進度。
- 代理記憶:當前理解、假設、被拒方法與未來計畫。
- Books:跨研究專案共享的可重用知識。
Books 將資訊分類為觀察、經驗證的發現與約定。單一實驗可能產出一則觀察。經獨立重現的發現可成為經驗證知識。影響團隊行為的約定需人類確認。
在專案檢視中,可將可重用方法轉化為技能。成功的數值驗證程序或診斷訓練不穩定的方法可成為未來研究工作流程的可重用組件。
Hyra 2.0 已取得哪些研究成果?
Hyra 2.0 的初期成果涵蓋科學模型、數學研究、量子運算、機器人學、單細胞分析與硬體工程。
官方研究倉庫包含選定的實作、權重、報告與驗證產物。以下概述騰訊報告的成果;後續子章節說明其測試條件與可用性。這些是不同的科學任務,而非對通用代理能力的單一排名。
|
| HyInv | 1.96M 參數 | 蛋白序列生成速度較 ProteinMPNN 快 57× |
| HyPLM-Flash | 650M 參數;726B 訓練語料 | 單張 H20 約 130,000 殘基/秒;在 32 項任務上品質具競爭力 |
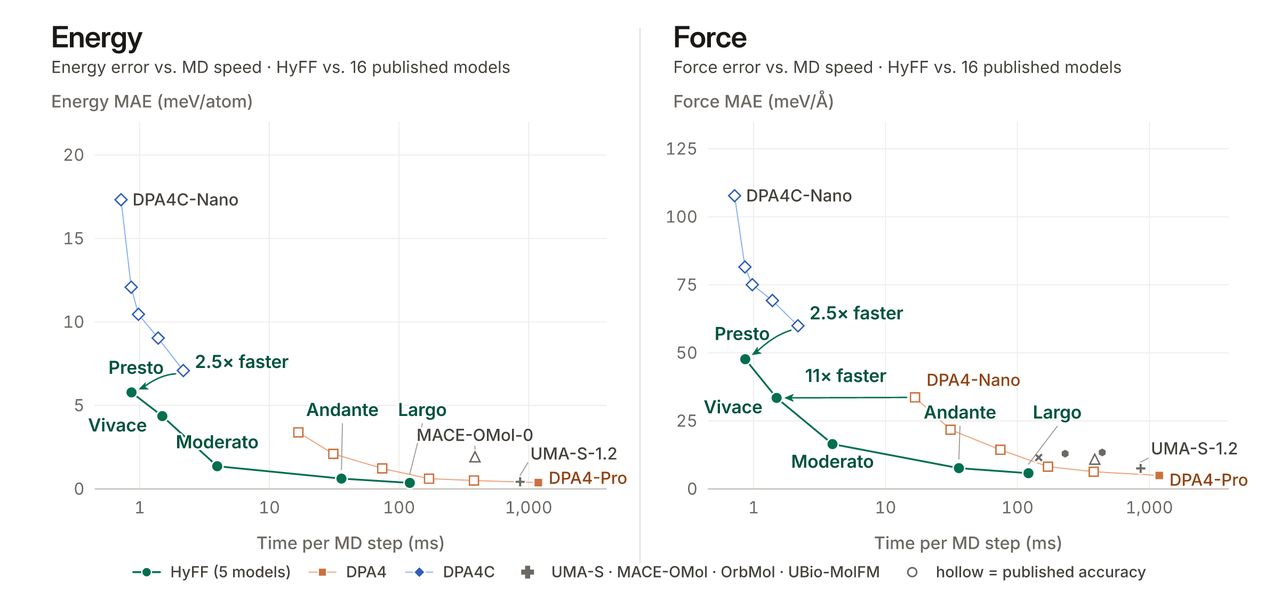
| HyFF | 五個模型;2.3M–1.2B 參數 | 相對 16 個公開模型的準確度-速度 Pareto 前沿 |
| HyCell | 16.1M 參數;512 維嵌入 | 橫跨七個保留細胞圖譜的整體分數 0.735 |
| HyProver | 數學證明工作流程 | 關於 Petty 猜想與 Yau 圓作用猜想的結果 |
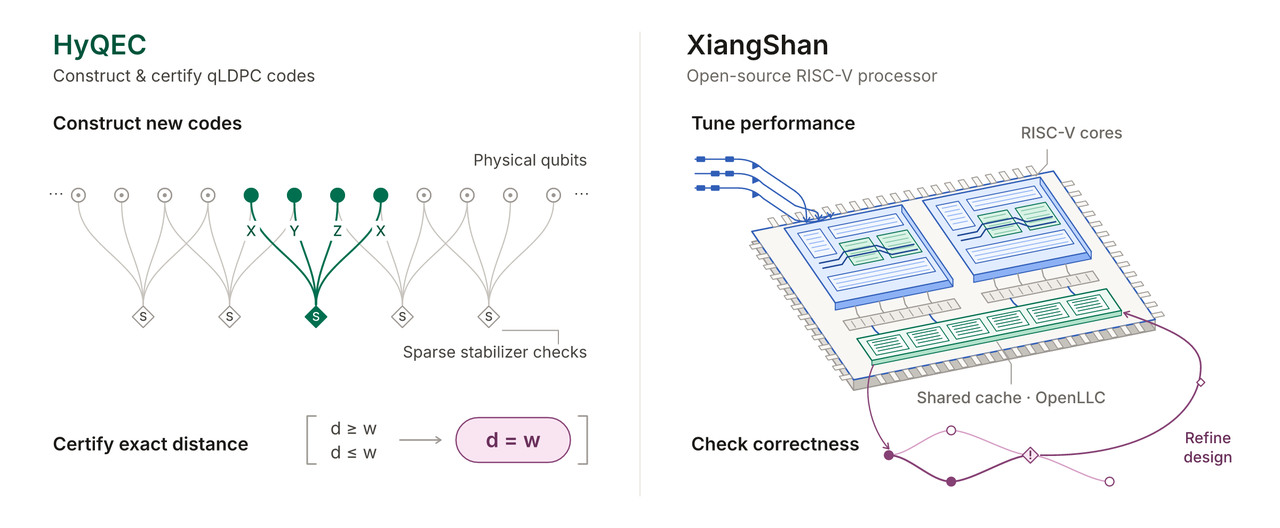
| HyQEC | 量子碼 [[488,123,22]] | 效率指標 122.0;在所述約束下約高於先前挑戰領先者 48% |
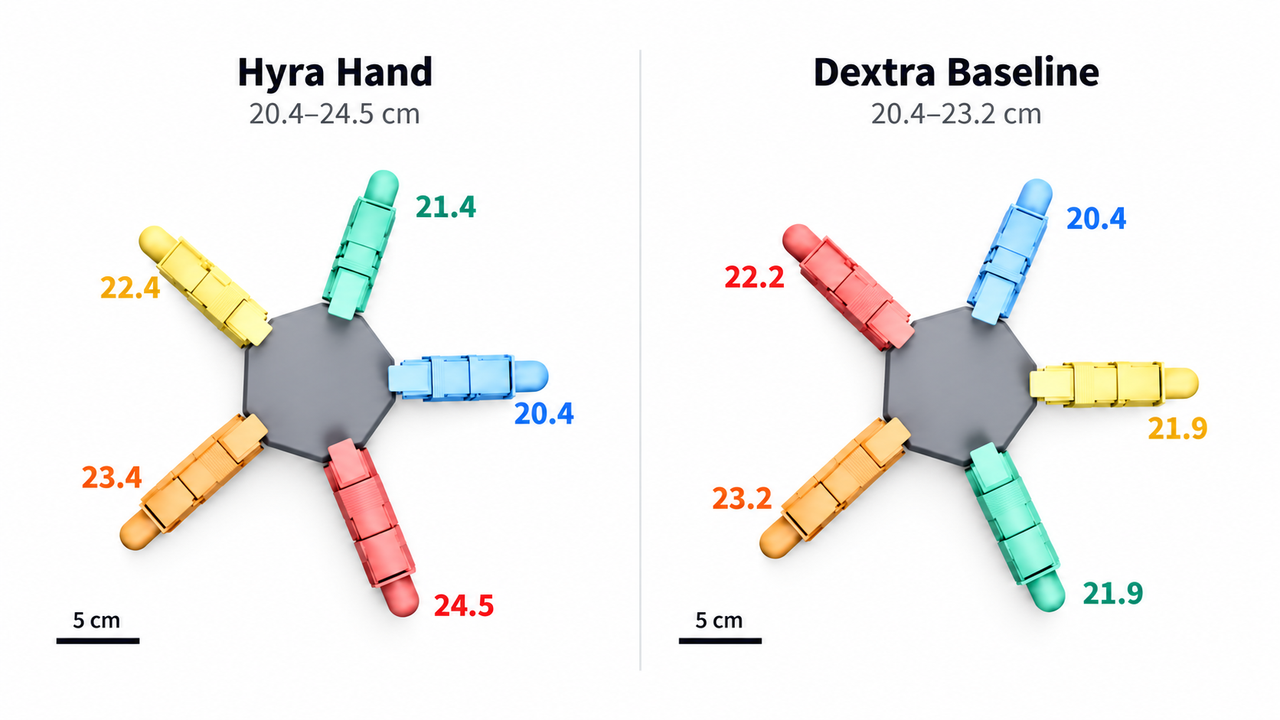
| Spiral Hand | 五指機器手設計 | 在 DR5 模擬中物體旋轉速度快 28.6% |
| XiangShan RISC-V | SPEC CPU2006 表現 | 每 GHz 分數提升 5.79%,面積增加 0.3% |
這些結果展示的是多種類型的研究輸出,而非單一通用代理分數。
HyInv:57× 更快的蛋白逆向摺疊
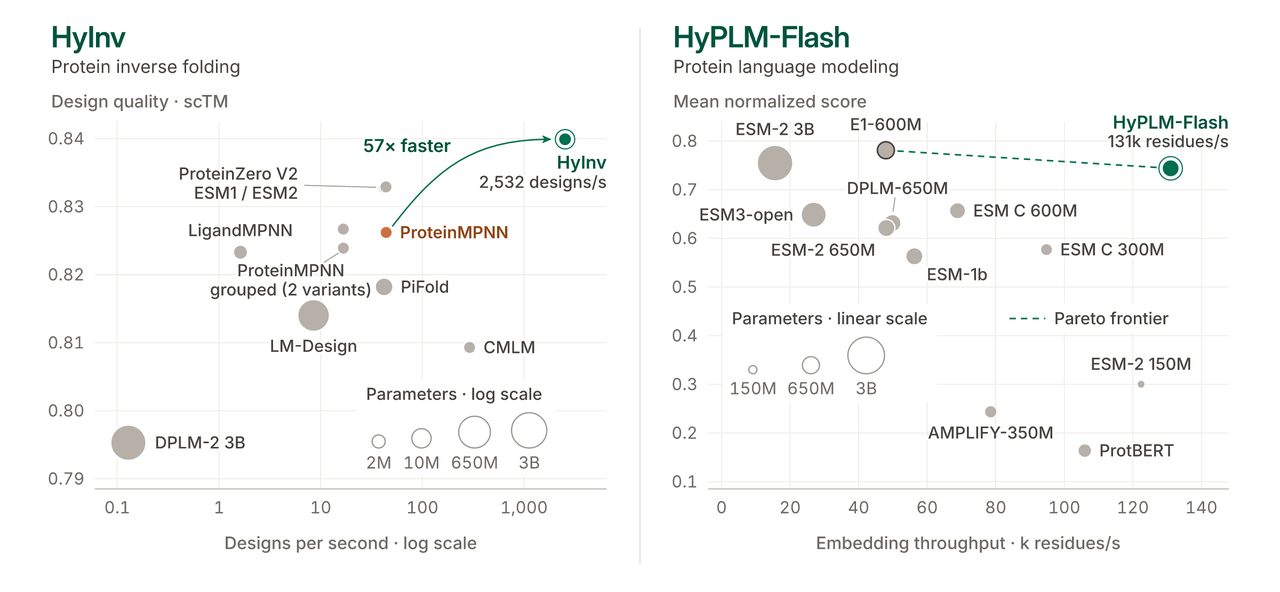
HyInv 為給定主鏈生成蛋白序列。其 1.96M 參數模型據稱較 ProteinMPNN 快 57×。報告的 50.6 ms(128 個設計)以 402 殘基主鏈、單張 H20、BF16 為設定,且不含編譯與 CUDA 圖擷取。可將此視為預熱後的生成速度;結構篩選仍會影響完整設計週期。
HyPLM-Flash:高吞吐蛋白語言建模
HyPLM-Flash 是一個 650M 參數的蛋白語言模型,訓練於 726B 語料。在已釋出的 28 檢查點、32 任務評估中,其 ProteinGym 分數與可比編碼器統計上相當。INT8 推理在單張 H20 約達 130,000 殘基/秒;當細微表徵差異會影響下游分析時,建議使用 BF16。下圖啟動數據使用了不同評估範圍。
HyFF:五種模型尺寸的更快分子模擬
HyFF 預測分子能量與原子力,提供五種模型尺寸,範圍 2.3M–1.2B 參數。在報告的 OMol25 比較中,Andante 於力誤差接近 UMA-S-1.2(7.65 對 7.55 meV/Å)下,分子動力學速度快 29×。Largo 的能量誤差低於 DPA4-Pro(0.364 對 0.380 meV/atom),速度高 9.7×。請依你要模擬的分子,同時測試準確度與執行時間來選擇模型尺寸。
HyCell:單細胞嵌入模型
HyCell 將人類細胞的基因表達計數映射為 512 維嵌入,模型規模 16.1M 參數。跨七個保留細胞圖譜,其綜合分數為 0.735,接近 Stack 的 0.736。該分數綜合生物保守性、批次校正與註釋轉移;並非分類準確率。請檢視與你研究相關的組成指標。
HyProver:可重用的數學研究工作流程
HyProver 將數學工作組織為探索、證明開發與審查。據報結果包括證立 Petty 等邊集猜想的五維情形,並給出 Yau 圓作用猜想不受限形式的反例。這些結果有明確邊界:Petty 猜想並未在所有維度上解決,而 Yau 的單連通表述仍未定。
HyQEC:量子碼效率提升 48%
HyQEC 搜尋量子糾錯碼並檢查其距離。騰訊報告一個 [[488,123,22]] 結構,其效率指標 kd²/n 為 122.0,在所述約束下約高於先前挑戰領先者 48%。此為碼效率衡量,非量子硬體表現。截至 2026 年 11 月 5 日,官方發佈包含 hyqec-verify 與 hyqec-check 工具,但仍將此特定結構的碼檔與證書列為待發佈證據。公開工具與可公眾重現的特定結果證據是不同的里程碑。
Spiral Hand:AI 設計的機器人形態
Hyra 的 Spiral Staircase Hand 於掌心周圍使用逐步加長的手指。騰訊報告在同等策略微調預算後,相較 Dextra 基線,在 DR5 模擬中物體旋轉快 28.6%,且完成目標多 21%。實體硬體驗證尚未完成。
XiangShan:處理器最佳化與形式化驗證
對於 XiangShan RISC-V 處理器,騰訊報告每 GHz 的 SPEC CPU2006 分數提升 5.79%,核心頻率不變且面積增加 0.3%。該工作亦發現十個先前未報告的錯誤與一個快取一致性的反例。這些結果適用於所評估的設計與工作負載,而非所有 RISC-V 系統。
研究人員應如何解讀 Hyra 2.0 的基準測試?
在各自的工作負載內閱讀每個基準測試。比較相同的輸入、硬體、精度與計時邊界,並同時評估輸出品質與執行時間。對科學主張,請檢視支撐的程式碼、資料、證明或證書:報告的結果與獨立重現的結果代表不同層級的證據。
開發者可以透過 API 使用 Hyra 2.0 嗎?
截至 2026 年 11 月 4 日,公開的 Hyra 資料描述研究輸出與選定釋出。尚未記載普遍可用的 Hyra 2.0 編排 API、訂閱價格或完整部署套件。研究公告與可下載產物應與對完整系統的托管存取有所區分。
公開資料聚焦於研究結果與選定的產物。開發者可透過相關研究倉庫存取某些透過 Hyra 開發的模型,包括 HyInv、HyPLM-Flash、HyFF 與 HyCell。
完整的 Hyra 2.0 Harness 與上述可下載輸出應加以區分。
Hyra 2.0 與托管的 Hunyuan API
開發者可透過 CometAPI 使用 Tencent Hy4,模型 ID 為 hy4。這提供用於編碼、分析與代理工作流程的托管模型推理。它不提供完整的 Hyra 2.0 研究 Harness;透過 Hyra 開發的科學模型可另行透過騰訊的研究倉庫取得。
研究團隊如何讓 Hyra 2.0 發揮作用?
從一個已釋出的產物與小型參考工作負載開始。一旦成功運行,再以固定的品質門檻與算力預算測試具有代表性的本地資料。將倉庫版本、權重、環境、輸入與輸出整理在一起,以利同事重現結果。當存在長時間等待、相依實驗或競爭假設時,再加入持久多代理協同。
結論
Hyra 2.0 將研究規劃、實驗執行與可重用知識整合到一個持久的工作流程。其科學輸出為後續工作提供了有希望的起點。對研究團隊而言,實務檢驗在於:某個釋出的產物是否改善了真實實驗,並產生他人可檢視與重現的證據。
常見問題
實驗室應如何為首次 Hyra 產物試用編列預算?
預算分三階段:建立可重現環境、運行小型參考案例、評估具代表性的本地工作負載。包含準備與審查時間以及加速器使用。預先設定驗收標準,例如在維持所需品質的同時縮短週轉時間。初始試用應足夠小,以便在不承擔完整研究活動資源的情況下診斷失敗。
重現性封裝應包含哪些內容?
將倉庫版本、模型權重識別碼、環境版本、輸入資料來源、配置、相關隨機種子與評估輸出整理在一起。記錄對已發佈範例的任何改動。當結果依賴某個證明或證書時,也請保存檢查器版本及其輸出。該封裝應讓其他研究者能區分軟體問題、輸入變更與科學結果的真正差異。
研究者如何避免基準污染?
將用於選模或調參的資料,與最終評估所用資料分離。在比較候選前凍結最終流程,並記錄任何可確定的與預訓練或開發資料的重疊。對新的科學資料集,使用反映預期部署情境的切分,如保留研究或實驗條件。若評估樣本反覆影響被測系統,強分數的資訊量會降低。
團隊應如何處理代理結論相互矛盾的情況?
比較背後的實驗,而非以多數決合併結論。檢查代理是否使用相同的資料集版本、假設、指標與軟體配置。在原因釐清前,保留兩者的發現,然後運行針對性的實驗,以區分相互競爭的解釋。代理的一致性有用,但不能取代外部測量或可檢查的論證。
何時較簡單的研究工作流程更可取?
對於短、具決定性的任務,且已有成熟腳本與清晰評估器時,持久多代理協調未必帶來收益。新增的排程、記錄與審查可能成本高於節省。當實驗存在實質相依、長等待、多個競爭假設,或需要持續維護的可重用輸出時,再引入編排。決策應依工作負載的結構與觀測到的協同成本而定。