
TL;DR: FLUX 3 是 Black Forest Labs 的統一式多模態基礎模型。其公開的 Video API 可從文字、影像、關鍵影格或現有影片生成最長 20 秒、24 fps 的片段,並可選擇同步音訊,支援從 HD 到 UHD/4K 的解析度;同時,FLUX 3 Image 與開放權重的 FLUX 3 Dev 仍為分開發佈的項目。
什麼是 FLUX 3?
FLUX 3 是 Black Forest Labs 的前沿多模態模型。BFL 並非分別訓練影像、影片、音訊各一個模型,而是跨多種模態訓練共享的表示。
核心理念是:影像、影片與聲音是對同一底層世界的不同觀測。一輛移動的汽車具有可見外觀、運動、聲音、空間關係、材質屬性與因果行為。將這些訊號一同學習,能比單獨學習單帧畫面提供更多約束。
這也是為什麼 Black Forest Labs 將 FLUX 3 描述為邁向現實模型或世界模型的一步,而非僅僅是影像或影片產生器。已發佈的影片系統已展現該方向:同步音訊、運動、場景結構、對白、鏡頭行為與環境音效都在同一生成流程中處理。
並非所有公告中的 FLUX 3 能力都已公開。截止 2026 年 9 月,FLUX 3 Video 已可用,而 FLUX 3 Image 與開放權重的 FLUX 3 Dev 仍為分開推出的項目。
FLUX 3 規格速覽
以下規格以目前的 FLUX 3 開發者文件為準,而非 7 月初步發佈時的配置。
| 規格 | 官方 FLUX 3 文件 |
|---|---|
| 開發者 | Black Forest Labs |
| 模型家族 | FLUX 3 |
| 模型類型 | 統一式多模態基礎/生成式影片模型 |
| 公開影片發佈 | 2026-08-04 |
| 核心訓練方向 | 影像、影片與音訊的聯合表示學習 |
| 研究基礎 | Self-Flow |
| 目前主要 API 輸出 | 具同步音訊的影片 |
| 文字轉影片 | 支援 |
| 影像轉影片 | 支援 |
| 關鍵影格轉影片 | 支援 |
| 影片續接 | 支援 |
| T2V/I2V 最長時長 | 20 秒 |
| 影片續接時長 | 5–15 秒 |
| 影格率 | 24 fps |
| 解析度 | HD、FHD、QHD/2K、UHD/4K |
| FHD 16:9 解析度 | 1920 × 1088 |
| 影像參考 | I2V/關鍵影格流程最多 10 張 |
| 原生音訊 | 是 |
| 多語言對白 | 是 |
| 口型同步 | 是 |
| 多鏡次生成 | 是 |
| 草稿模式 | 是 |
| 公開的 FLUX 3 靜態影像端點 | BFL 尚未一般性發佈 |
| 開放權重 FLUX 3 Dev | 規劃中 |
目前 BFL 文件規範文字轉影片與影像轉影片為 5–20 秒;影片續接接受 5–15 秒的生成視窗。支援的長寬比包括 21:9、2:1、16:9、4:3、1:1、3:4、9:16。
FLUX 3 如何運作?
Self-Flow
關鍵研究基礎是 Self-Flow,也就是 Black Forest Labs 的自監督 flow-matching 方法。傳統生成式訓練流程常依賴分離的預訓練表示模型或輔助監督。Self-Flow 旨在直接從生成目標中學到有用的表示。
其中一個主要機制是 Dual-Timestep Scheduling。在訓練期間,模型可對不同 token 群組分配不同噪聲級別,形成資訊不對稱:部分輸入包含比其他部分更可用的訊息,迫使網路建立能推斷缺失內容的表示。
實務上,FLUX 3 因而被鼓勵去學習物件、影格、運動、聲音與時間事件之間的關係,而不是僅記住單獨影格應該長什麼樣。
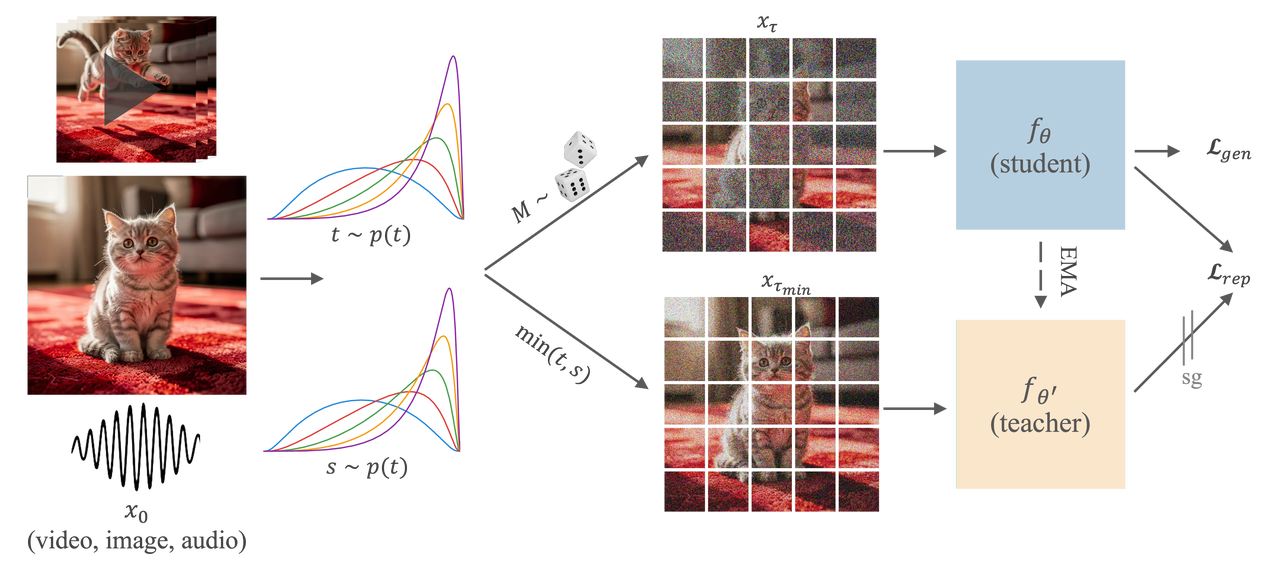
Self-Flow 方法架構 - 官方圖片來源: Black Forest Labs Self-Flow 專案
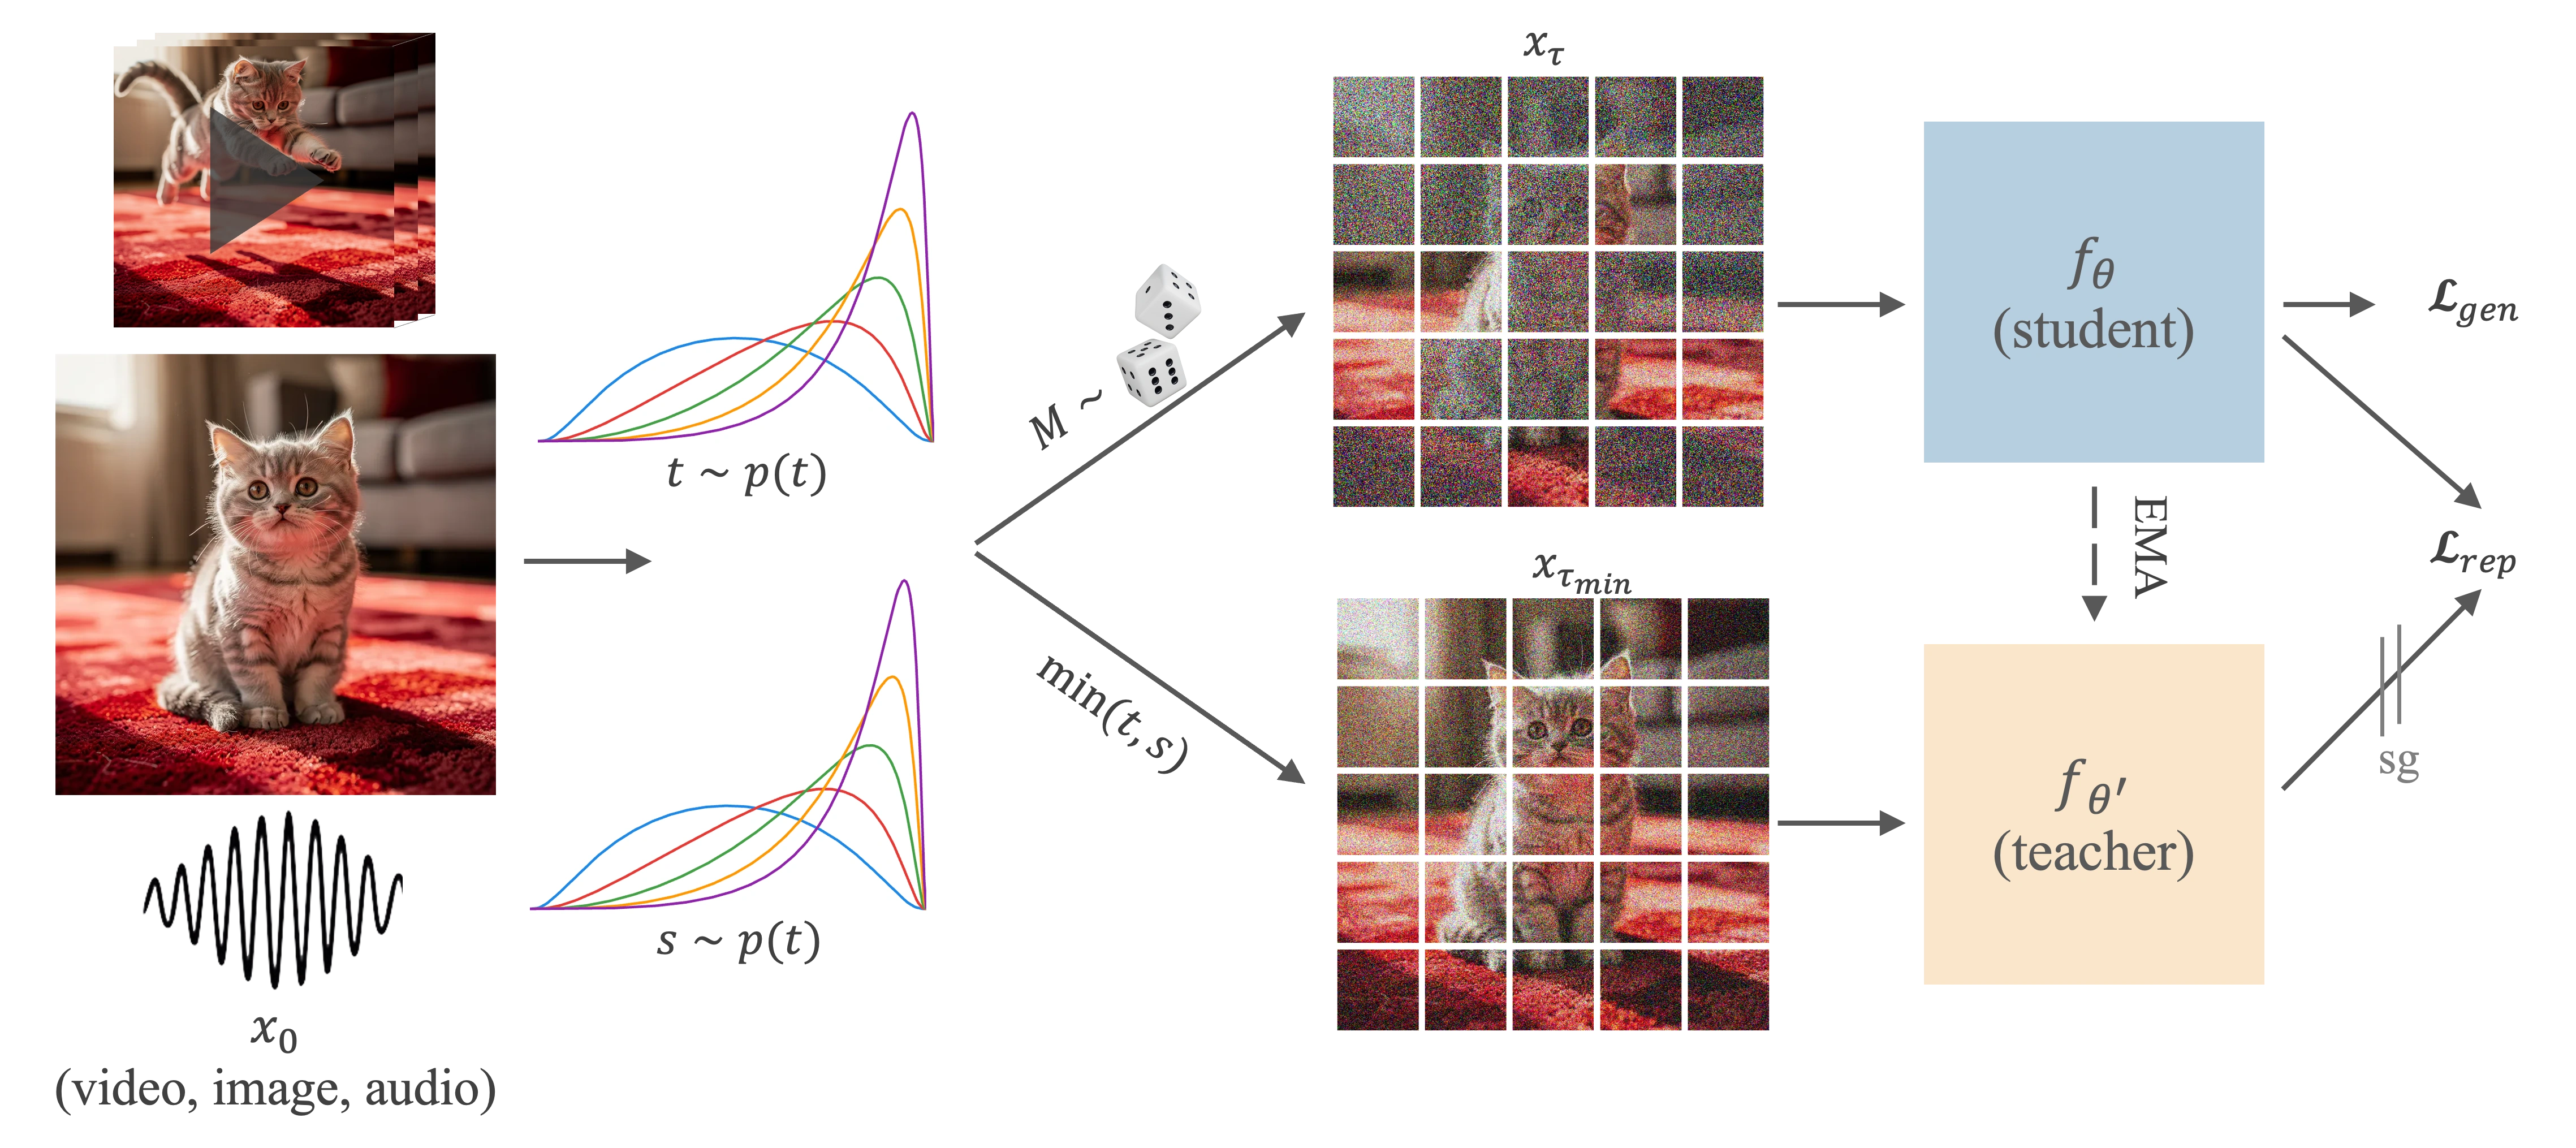
BFL 也測試了使用源自 FLUX.2 的骨幹,對數百萬部影片與數億張影像進行聯合多模態訓練。這些實驗支持更廣義的 FLUX 3 假設:表示學習與生成不必是分離的系統。
為何影片在 FLUX 3 中居於核心
影片對於世界建模尤其有價值,因為它包含單張影像所無法提供的資訊。單一影格能顯示一顆球在地板上方;影片則能揭示球正在下落、彈跳、撞擊變形、發出聲音,並在之後改變方向。
BFL 透露影片預測佔據了 FLUX 3 訓練算力的超過 95%。音訊相對便宜,因為它是與可見事件緊密耦合的低維訊號。這樣的配置有助解釋為何影片成為第一個達到全面可用的 FLUX 3 能力。
FLUX 3 能做什麼?
文字轉影片
使用者可從自然語言指令生成完整影片。BFL 表示已發佈的模型能處理簡單與複雜提示,同時協調動作、場景邏輯、視覺構圖與聲音。這對於包含多個連續事件、而非單一被攝主體的提示特別有用。
影像轉影片與關鍵影格
FLUX 3 能將初始影像動畫化、朝終局影格推進,或使用多張影像作為定時的關鍵影格。現行 API 在影像轉影片流程中最多支援十張影像參考,讓創作者可以控制場景隨時間的變化,而非完全交由模型即興完成整段序列。
影片續接
可提供既有影片及其音訊作為脈絡,FLUX 3 能生成接下來會發生的內容。BFL 描述的續接會在銜接處保留運動、鏡頭行為、對白與聲音,這與生成第二段獨立片段再事後拼接有本質差異。
原生音訊與對白
FLUX 3 在生成時就會產生音訊,而不需額外的語音或音效生成流程。已發佈的音訊能力包括對白、音效與環境音。亦支援多語言對白與口型同步。
單次生成中的多鏡次
單一提示可包含多個場景或鏡頭。這很重要,因為許多早期影片模型在被要求生成一個短且視覺連續的鏡頭時表現最佳;FLUX 3 則明確設計為在一次生成中支援多鏡次序列。
草稿模式
草稿模式是高量影片生成的實用新增功能。開發者可先建立更快、成本更低的預覽,再在保留所選構圖與運動的前提下強化選定草稿。根據目前 BFL 價格,標準 T2V/I2V 草稿每秒 $0.06,而一般 HD 生成為每秒 $0.17。
尚未推出的項目
FLUX 3 的發佈聲明描述了在同一架構方向下的影像、影片、音訊與動作能力,但上市是分階段的。
| 能力 | 目前 BFL 路線圖與可用性 |
|---|---|
| FLUX 3 影片生成 | 一般可用 |
| 原生影片音訊 | 一般可用 |
| 文字轉影片 | 一般可用 |
| 影像轉影片/關鍵影格 | 一般可用 |
| 影片續接 | 一般可用 |
| 更豐富的影像/影片/音訊參考組合 | 計劃擴展 |
| FLUX 3 影像生成與編輯 | 即將推出 |
| FLUX 3 Dev 開放權重 | 規劃中 |
| 動作預測部署 | 研究/商業合作管道 |
對熟悉 FLUX.2 Max 的使用者而言,這點尤其重要。FLUX.2 仍是目前專注於靜態影像生成的選項,而公開的 FLUX 3 產品聚焦於影片與音訊。
FLUX 3 基準測試表現
目前有兩類有用的 FLUX 3 基準證據:BFL 發佈後的內部評估,以及獨立第三方評估。前者顯示在 BFL 協議下的人類偏好相對結果;後者檢驗這些優勢在另一套獨立設計的基準下是否仍然可見。
BFL 發布後 ELO 評估
7 月初步公告包含了初始勝率。對目前使用者更相關的是 8 月 4 日 BFL 對已發佈模型的評估。Black Forest Labs 報告其文字轉影片在內部全互比評估中的 ELO 分數為 1135。
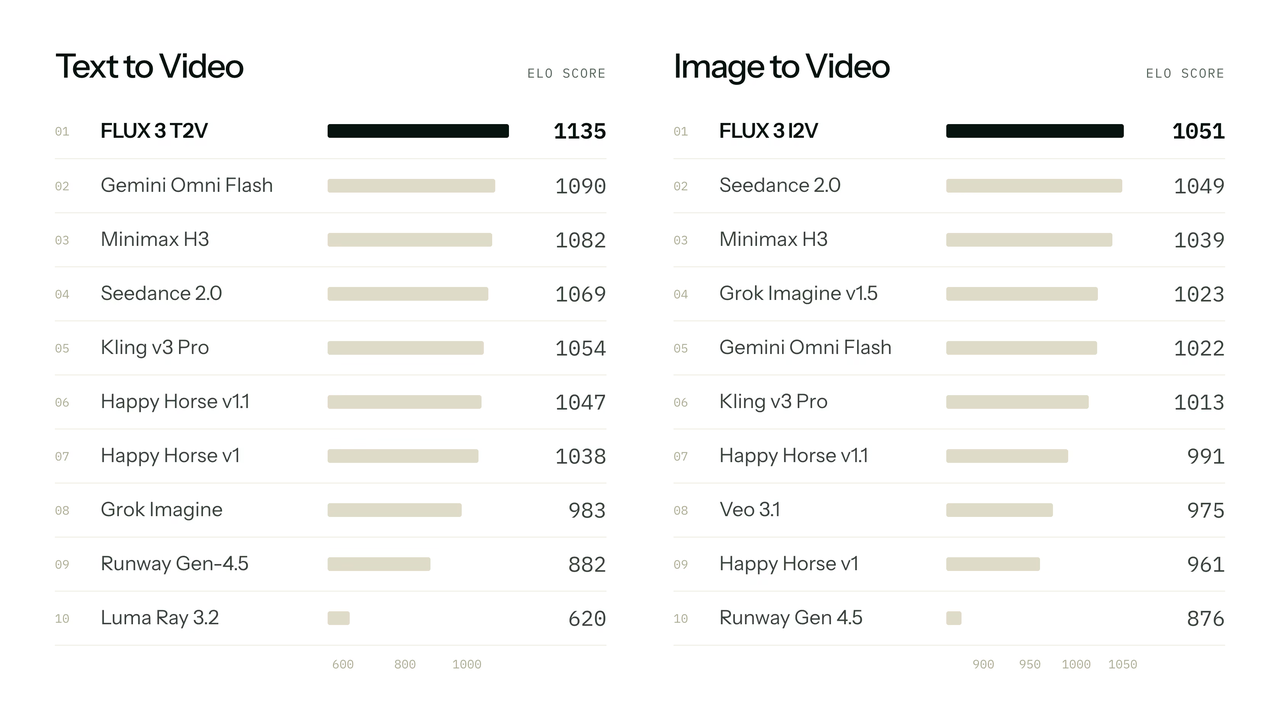
FLUX 3 已發佈模型 ELO 評估 - 官方圖片來源: Black Forest Labs
| 指標 | BFL 已發佈模型評估 |
|---|---|
| 文字轉影片 ELO | 1135 |
| T2V 排名 | 在 BFL 測試組中得分最高 |
| 影像轉影片結果 | 與最強競品持平,並優於其餘受評模型 |
| 評估類型 | 內部人類偏好評估 |
| 模型階段 | 一般可用的 FLUX 3 Video 發佈版 |
這比先前的初步基準更有力,因為它評估的是 8 月發佈的版本。不過這仍是供應商主導的基準,不能被解讀為 FLUX 3 在每一類提示上都優於所有競品的證據。
獨立的 FLUX 3 基準測試
Megaton 的 v-benchmark v2 提供了獨立檢驗。FLUX 3 在 2026 年 8 月受測,目前 Megaton 指數為 76.51/100,在當時公布的集合中排名第 3。
| 基準維度 | Megaton 對 FLUX 3 的評估 |
|---|---|
| Megaton 指數 | 76.51 |
| 提示遵循度 | 87.07 |
| 場景一致性 | 94.76 |
| 物理 | 70.63 |
| 人類擬真度 | 73.70 |
| 物件與產品擬真度 | 83.82 |
| 因果與語義連貫性 | 80.91 |
| 文字擬真度 | 82.41 |
| 攝影 | 71.43 |
| 品味與美術指導 | 65.00 |
分項輪廓比總分更具資訊量。場景一致性的 94.76 是最強主要類別;提示遵循度、物件擬真度、因果連貫性與文字擬真度也超過 80。物理、人類擬真度與品味/美術指導較弱,顯示更強的時間表示仍無法完全消除合成運動或藝術品質的變異。
這也解釋了為什麼基準結論可能不同:BFL 的內部偏好測試將 FLUX 3 排在其比較組之首,而 Megaton 的獨立排行榜則將其置於第三。不同的提示集、評分維度、評估者族群與聚合方法都會產生不同排名。
FLUX 3 vs Seedance 2.5 vs MiniMax H3 vs Wan 3.0
2026 年的 AI 影片市場快速演進。FLUX 3 現在與越來越多結合長時段生成、同步音訊、參考資產與編輯能力的多模態系統競爭。
| 維度 | FLUX 3 | Seedance 2.5 | MiniMax H3 | Wan 3.0 |
|---|---|---|---|---|
| 開發者 | Black Forest Labs | ByteDance Seed | MiniMax | Alibaba |
| 最大宣稱片長 | 20 s | 30 s | 15 s | 30 s |
| 影片解析度 | HD / FHD / QHD (2K) / UHD (4K) | 視 API 等級而定 | 最多 2K | 最多 1080p |
| 原生音訊 | 是 | 是 | 是,立體聲 | 是 |
| 文字轉影片 | 是 | 是 | 是 | 是 |
| 影像/參考輸入 | 是 | 是 | 是 | 是 |
| 關鍵影格/參考控制 | 強的定時關鍵影格 | 強的多模態參考控制 | 多模態條件化 | 多模態參考控制 |
| 影片續接/編輯 | 提供續接 | 偏重編輯導向流程 | 全能生成取向 | 編輯與參考流程 |
| 獨特強項 | 現實模型架構、場景一致性、Self-Flow | 長篇敘事與參考控制 | 2K 視聽生成與全模態脈絡 | 長片段與較低起始成本 |
| CometAPI 起始/單位價格* | $0.136/s | 列示 $0.0824/s | $0.064/s | $0.040/s |
* 價格僅為粗略比較。 各影片 API 的解析度、時長、品質等級與計費規則不同,最便宜的「每秒價格」未必對應等品質的最低總成本。
FLUX 3 vs Seedance 2.5
Seedance 2.5 在時長上有明顯優勢,最高可達 30 秒,而 FLUX 3 為 20 秒;它亦強調參考驅動的生成、編輯與長篇敘事。FLUX 3 則以共享的世界模型架構、場景一致性、原生視聽生成、定時關鍵影格與更廣的影像/動作路線圖作為差異化。獨立測試也強化這是一場真實的高階競爭:Megaton 目前將 Seedance 2.5 排在 FLUX 3 之上。
FLUX 3 vs MiniMax H3
MiniMax H3 支援最高 2K 輸出與原生立體聲,在視聽內容的技術規格上具強項。FLUX 3 支援更長的最長生成視窗——20 秒,相較於 H3 的 15 秒——且其草稿模式提供具成本控管的迭代流程。
FLUX 3 vs Wan 3.0
Wan 3.0 強調廣泛的多模態輸入、視聽生成、編輯與最長 30 秒片段。在 CometAPI 的起始價格上也更便宜。FLUX 3 雖較昂貴,但以其現實模型定位、場景一致性、Self-Flow 研究基礎、草稿模式與與動作預測的整合作為差異化。
FLUX 3 定價
Black Forest Labs 以所生成影片的時長計費。
| 模式 | 官方 BFL FLUX 3 價格 |
|---|---|
| T2V / I2V 草稿 HD | $0.06/s |
| T2V / I2V HD | $0.17/s |
| T2V / I2V FHD | $0.29/s |
| T2V / I2V QHD (2K) | $0.40/s |
| T2V / I2V UHD (4K) | $0.80/s |
| 影片續接 草稿 | $0.12/s |
| 影片續接 HD | $0.41/s |
| 影片續接 FHD | $0.53/s |
| 影片續接 QHD (2K) | $0.65/s |
| 影片續接 UHD (4K) | $0.95/s |
因此,標準 10 秒 HD 生成約為 $1.70,而 10 秒 FHD 生成約為 $2.90。影片續接每秒價格顯著高於一般生成,經常延長片段的應用應另行建模其成本。
CometAPI 上的 FLUX 3 價格
CometAPI 目前列示 FLUX 3 可用,模型 ID 為 flux-3。
| 解析度 | CometAPI FLUX 3 價格 |
|---|---|
| 720p | $0.136/s |
| 1080p | $0.232/s |
以 10 秒生成計,720p 約為 $1.36,1080p 約為 $2.32。相較於 BFL 列示的 $0.17/s 與 $0.29/s,CometAPI 的這兩個等級預設價格約低 20%。
可用性註記:CometAPI 上部分較舊的說明仍反映 7 月的 Early Access 期間。目前的 即時模型卡、價格區塊與 API 範例皆將 flux-3 標示為 Available,CometAPI 發佈日期為 2026-08-13。整合決策時,即時的 API 與價格欄位較舊版說明文字更具參考價值。
為何 FLUX 3 的重要性超越 AI 影片
FLUX 3 不尋常之處並非 20 秒影片生成——已有數個競品可生成同等或更長片段。更大的技術賭注是:強大的影片表示能否成為其他智能形式的基礎。
從影片預測到動作預測
機器人控制訊號是以視覺觀測為條件的時間預測,因此 BFL 使用 FLUX 3 的影片表示作為動作預測的基礎。其與 mimic robotics 的合作產生了 FLUX-mimic,在其中動作解碼器讀取來自影片模型的表示,而不是訓練完全獨立的感知堆疊。
BFL 報告 FLUX-mimic 的骨幹可在單張 RTX 5090 上以低於 80 ms 運行,完整機器人系統的反應迴路約為 101 ms。公司亦提到與 Audi 的工業評估。
這並不代表公開的 FLUX 3 Video API 是機器人學 API,但它說明了為何 BFL 重押多模態影片表示,而不是將影片生成視為孤立的媒體任務。
FLUX 3 的主要優勢是什麼?
- 時間與場景一致性。Megaton 的 94.76 場景一致性分數是該模型最強的主要類別。
- 原生視聽生成。對白、音效、環境聲與影像能一同生成,而非由多個模型後期拼接。
- 強提示遵循度。獨立的 87.07 提示遵循度顯示其優勢不僅止於純視覺精緻度。
- 關鍵影格控制。當前影像轉影片流程最多可使用十張影像,提供創作者明確的時間控制。
- 草稿到定稿的流程。草稿模式直面 AI 影片中的真實成本問題:許多生成會在提示迭代中被丟棄。
- 廣泛的視覺範圍。BFL 定位 FLUX 3 能產出自然、電影感、懷舊、俏皮、風格化與非典型等多樣風格,而非單一屋風。
- 世界模型研究方向。Self-Flow 與動作預測讓 FLUX 3 超越媒體生成而具更廣泛意義。
FLUX 3 的限制是什麼?
- 完整的多模態路線圖尚未出貨。公開的 FLUX 3 Image 與 FLUX 3 Dev 開放權重不應僅因家族公告而被視為已可用。
- 20 秒已非業界最長。一些 2026 年競品已支援 30 秒生成。
- 物理尚未解決。Megaton 給予 FLUX 3 的物理分數為 70.63,遠低於其場景一致性分數。
- 人類擬真度仍有進步空間。獨立的 73.70 分意味著困難的肢體結構與逼真人類動作仍可能失敗。
- 影片續接昂貴。BFL 的續接每秒價格顯著高於一般 T2V/I2V。
- BFL 的標題競爭性基準為內部測試。生產決策亦應包含使用自身提示、鏡頭類型、語言與參考資產的獨立測試。
如何透過 CometAPI 使用 FLUX 3
CometAPI 先前的 FLUX 3 報導說明了 7 月 Early Access 階段、初步基準與規劃發佈。此處聚焦於目前的生產整合、價格與運作中的 API 流程,因此不重複歷史導覽。FLUX 3 生產模型的模型 ID 為 flux-3。
基本的 720p 請求使用 /v1/videos 端點:
Bash
curl --request POST "https://api.cometapi.com/v1/videos" \--header "Authorization: Bearer $COMETAPI_KEY" \ --form-string "model=flux-3" \ --form-string "prompt=A paper boat glides across a still pond in soft morning light" \ --form-string "seconds=5" \ --form-string "size=1280x720" |
|---|
影片流程是非同步。初始請求回傳任務 ID 後,應用程式需輪詢任務至生成完成,再取回結果影片。對生產應用而言,生成通常應由背景工作或任務佇列處理,而非在整個渲染時間內持有 HTTP 連線。
誰該使用 FLUX 3?
當應用需要的不只是視覺漂亮的五秒短片時,FLUX 3 特別具有吸引力:具有同步視覺與音訊的廣告系統、自動化短片製作、物件持續性重要的產品展示、多語言對白生成、分鏡到影片的流程、關鍵影格控制的動畫、教育內容,以及更長多模態管線的實驗。
若唯一需求是最低的每秒成本、一次必須生成超過 20 秒,或者主要任務是靜態影像生成,則吸引力較低。對靜態影像而言,現有的 FLUX 影像模型如 FLUX.2 Max 或許更合適。
FLUX 3 比其他 AI 影片模型更好嗎?
沒有一個對所有場景都可辯護的單一答案。BFL 的內部評估將已發佈的 FLUX 3 置於文字轉影片比較之首,而獨立的 Megaton 評估則將FLUX 3 排在第三、落後於較新的競品。兩者皆可能為真,因為測試衡量了不同的提示分佈與品質維度。
當場景一致性、提示遵循、物件擬真度、因果連貫性、文字渲染、同步聲音與可控關鍵影格很重要時,FLUX 3 表現特別強。其他模型可能在最長時長、解析度、藝術偏好、人類擬真度、編輯流程或成本上更勝。對開發者而言,正確的比較應以工作負載為中心,而非以排行榜為中心。
常見問題
FLUX 3 現在可用嗎?
可。FLUX 3 Video 於 2026 年 8 月 4 日經由 BFL 一般可用。CometAPI 亦將 FLUX 3 列為可用,模型 ID 為 flux-3。FLUX 3 的靜態影像發佈與 FLUX 3 Dev 開放權重仍為獨立路線圖項目。
FLUX 3 能生成音訊嗎?
能。FLUX 3 Video 會生成同步的原生音訊,包括對白、環境音與音效。亦支援多語言對白與口型同步。
FLUX 3 的影片最長能有多久?
目前文字轉影片與影像轉影片支援 5–20 秒。影片續接支援 5–15 秒的新生成內容。
FLUX 3 支援哪些解析度?
BFL 支援 HD(每影格最多 1 百萬像素)、FHD(最多 2 百萬像素)、QHD/2K(最多 4 百萬像素)與 UHD/4K(最多 8 百萬像素)。16:9 的 FHD 輸出為 1920 × 1088。解析度等級依每影格總像素而非長寬比劃分;草稿模式僅限 HD。
FLUX 3 支援影像轉影片嗎?
支援。影像轉影片與關鍵影格生成屬於 FLUX 3 Video 的一般可用功能。
FLUX 3 是影像生成模型嗎?
在架構上,FLUX 3 橫跨影像、影片與音訊訓練,且 BFL 已展示影像生成與編輯研究。不過 FLUX 3 Image 產品仍為即將推出的發佈;請勿將家族路線圖與當前公開的 FLUX 3 Video API 混淆。
FLUX 3 是開源的嗎?
目前不是。BFL 已宣布 FLUX 3 Dev,一個開放權重的多模態變體,但尚未提供公開發佈日期。
FLUX 3 要多少費用?
BFL 的文字/影像轉影片價格為:草稿 HD 每秒 $0.06,HD 每秒 $0.17,FHD 每秒 $0.29,QHD 每秒 $0.40,UHD 每秒 $0.80。影片到影片為:草稿 HD 每秒 $0.12,HD 每秒 $0.41,FHD 每秒 $0.53,QHD 每秒 $0.65,UHD 每秒 $0.95。CometAPI 目前列示 720p 為 $0.136/s、1080p 為 $0.232/s。
什麼是 Self-Flow?
Self-Flow 是 BFL 的自監督 flow-matching 研究方法,旨在讓生成模型不依賴外部表示模型也能發展出有用的內部表示。其在不同 token 上使用不同噪聲級別,鼓勵網路推斷缺失資訊,並學習多模態觀測之間的關係。
FLUX 3 是世界模型嗎?
Black Forest Labs 將 FLUX 3 定位為現實模型(reality-model)的基礎,因其共享表示自視聽預測延伸至物理動作預測。將其稱為完整通用的世界模型仍超前於目前證據;更精確的描述是以世界建模目標為核心設計的多模態生成式基礎模型。
結論
對 Black Forest Labs 而言,FLUX 3 不只是從一個 FLUX 影像模型到下一代的常規升級。其關鍵理念是訓練世界的共享多模態表示,並用該表示來處理影片、聲音、影像,最終延伸到動作。Self-Flow 提供研究基礎,而已發佈的 FLUX 3 Video 是此策略的首個生產級示範。
截至 2026 年 9 月,FLUX 3 Video 支援最長 20 秒片段、24 fps、從 HD 到 UHD/4K 的輸出、同步音訊、多語言對白、影像轉影片、關鍵影格、影片續接、多鏡次生成與草稿模式。
基準測試面貌也比發佈時更可信。BFL 對已發佈模型的評估將 FLUX 3 排在其內部 T2V ELO 測試之首,而獨立的 Megaton 測試將其列為總體第三,並凸顯其尤為強勁的場景一致性。
因此,FLUX 3 並非對每個工作負載都自動成為最佳影片模型。Seedance 2.5、MiniMax H3、Wan 3.0 可能在最長時長、更高名目解析度、更低價格,或不同的參考與編輯能力上佔優。
讓 FLUX 3 特別有意思的是影片生成器背後的方向:BFL 押注於,為了預測可信影片而需要的同一套表示,最終能支撐影像生成、音訊、物理推理與機器人動作。開發者已可在 CometAPI 上使用模型 ID 為 flux-3 的 FLUX 3 體驗這一策略的首個生產步驟。