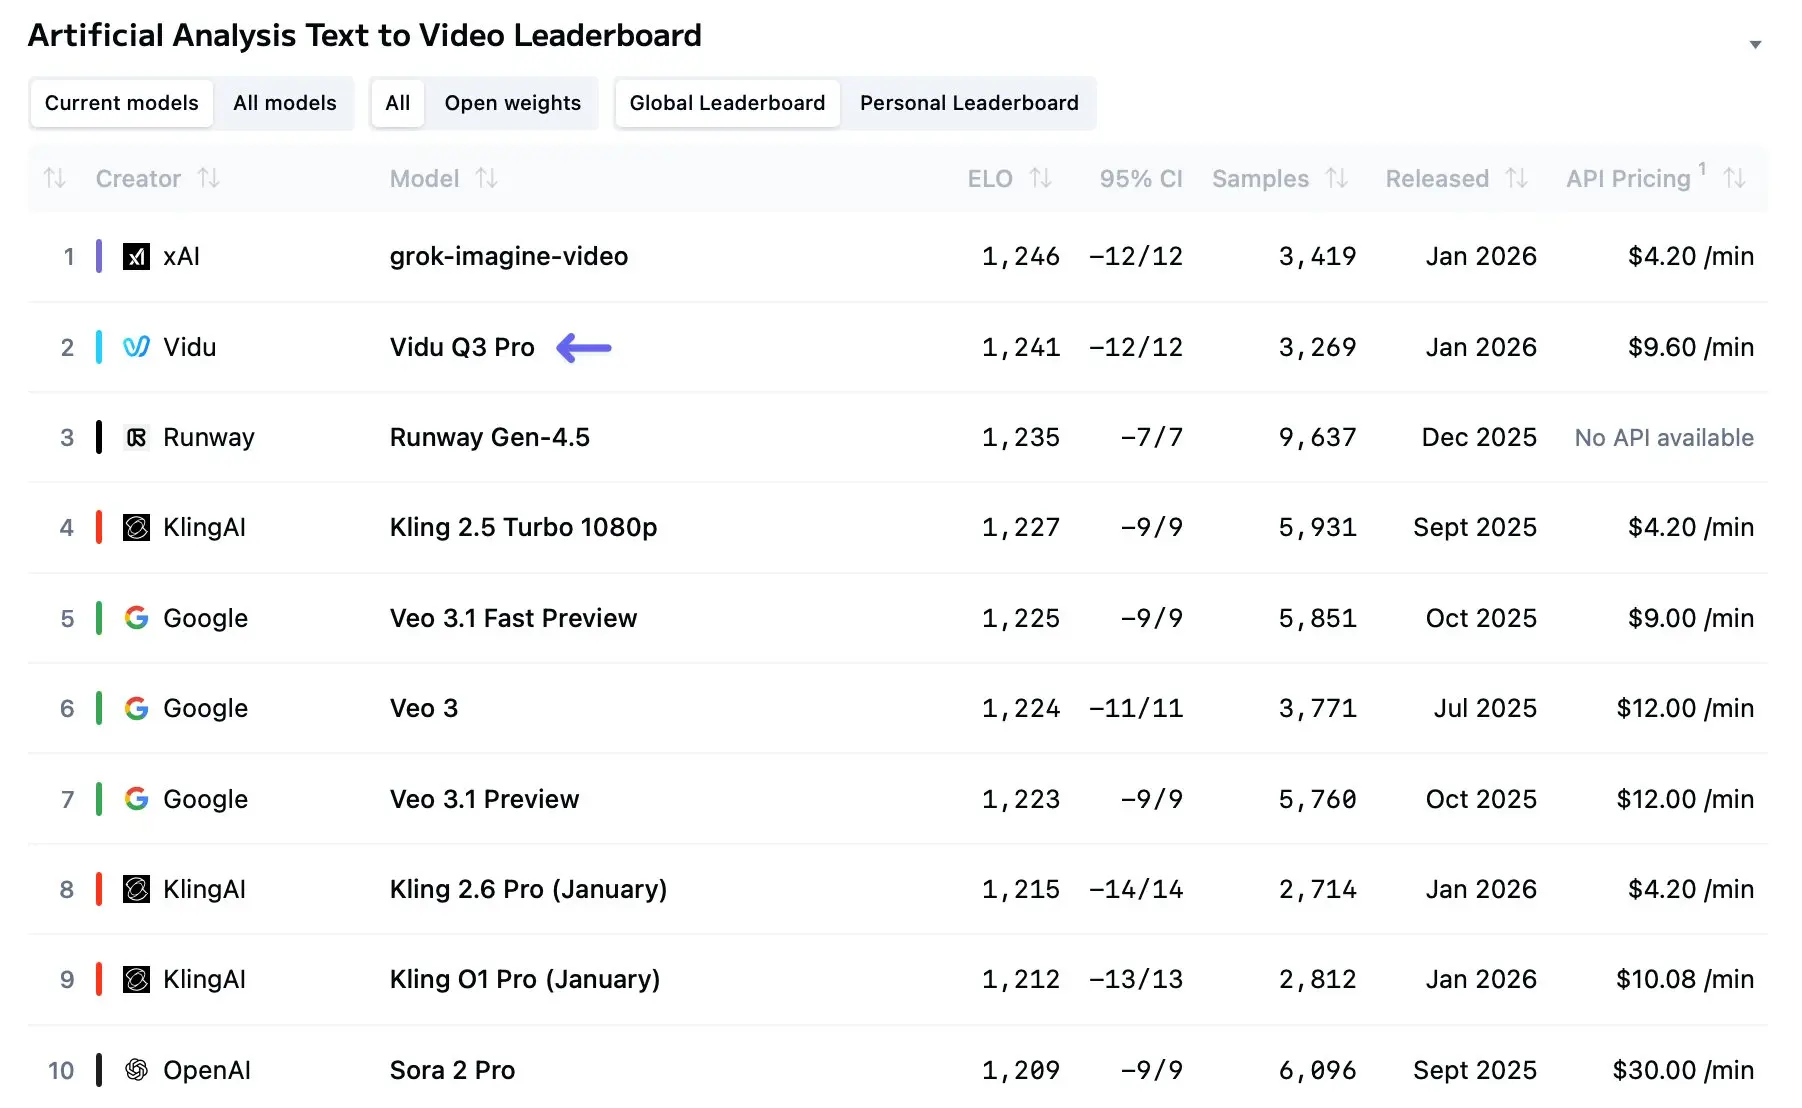

Vidu Q3 於 2026 年初進入視野,成為迄今最明確的信號之一:由 AI 驅動的影片生成,正從短小、新奇的片段邁向真正具敘事性的多鏡頭故事。在廣泛發布後的數月裡,Vidu Q3 已成為創作者工作流程、研究試點與商業試點的常用工具——理由充分:它在時長、聲畫整合與多鏡頭一致性方面均超越多數早期模型,並提供面向開發者的 API 以便程式化使用。
什麼是 Vidu Q3?
Vidu Q3 是 ShengShu Technology 大型影片模型(LVM)架構的最新旗艦迭代。與其前代(Vidu 1.0 與 1.5)需要將影像生成與音訊後期分開的工作流程不同,Vidu Q3 是一個「一體化」生成引擎。
Vidu Q3 的核心突破在於能夠同時生成高畫質影像與高保真音訊。[ 藉由同時理解聲音與光線的物理,該模型消除了競品常見的音畫不同步所帶來的「恐怖谷」。它支援最高 16 秒的連續生成,原生 1080p 解析度,定位於可投入製作的短片、廣告與敘事創作工具。
Vidu Q3 在底層如何運作?
儘管核心架構細節為專有,Vidu 建立在 U‑ViT 將擴散模型與 Transformer 融合 的設計之上——這種設計以在影片生成中平衡整體連貫性、時間連續性與表現力而著稱。
這種混合式架構使模型能在較長序列中推理運動、聲音與敘事脈絡。
Vidu Q3 的 6 大亮點
1. 延長時長的生成——能做到多長?
Vidu Q3 的主打功能之一是更長的單次生成時長。許多早期模型聚焦於微型片段;Q3 有意延長片段長度,以允許簡單的故事弧線與多鏡頭序列,無需強迫創作者拼接許多短片。平台文件與合作夥伴入口宣稱,一次生成可達 ~16 秒的原生時長(不同提供者與 API 方案的格式與品質選項可能有所差異)。這很重要,因為由 4–8 秒提升至 16 秒,會改變創作者規劃場景、撰寫節奏點與安排聲音提示的方式。