
المختصر المفيد
ابدأ باستخدام GPT-6.1 Sol عندما تكون قد بدأت بالفعل باستخدام أدوات Responses من OpenAI أو تحتاج إلى سلّم جهد استدلال صريح؛ اختبر Claude Sonnet 5.5 لإنجازات الترميز محددة النطاق والتسليمات المهنية المستندة إلى القوالب. هذه أولويات للتقييم، وليست ترتيب جودة مثبتًا. يبدأ كلاهما بسعر $2 لكل 1M من رموز الإدخال و$10 لكل 1M من رموز الإخراج، ويقومان بفوترة قراءات ذاكرة التخزين المؤقت الأساسية بـ$0.10 لكل 1M. ومع سياق يقارب 1M وإخراجًا قياسيًا أقصى يبلغ 128K، تكمن الفروق العملية في التكامل، وسلوك المهمة، واحتفاظ الذاكرة المؤقتة، وفوترة السياق الطويل، وليس في خصم لقراءات الذاكرة المؤقتة الأساسية.
المقايضة الأساسية هي سلوك المهمة وشروط الفوترة. يستخدم GPT-6.1 Sol خمسة مستويات للجهد ويتطلب Responses لاستدعاء الأدوات؛ بينما يستخدم Sonnet 5.5 تفكيرًا تكيّفيًا. فوق 272K من رموز الإدخال، يطبق GPT-6.1 Sol أسعارًا أعلى على الطلب القياسي بالكامل. لا تُثبت المصادر المُراجعة هنا فائزًا في اختبار إصدار مطابق تمامًا، لذا اختر النموذج الذي يلبّي معايير القبول لديك بأقل تكلفة إجمالية لسير العمل.
أهم النقاط
- أسعار أساسية متساوية: كلا النموذجين يتقاضيان $2/1M للإدخال، $10/1M للإخراج، و$0.10/1M لقراءات الذاكرة المؤقتة. قارن عمليات كتابة الذاكرة المؤقتة، وفترات الاحتفاظ، وطبقات السياق الطويل، والاستخدام المفوتر الفعلي.
- السعة السياقية متقاربة: 1.05M مقابل 1M من الرموز؛ كلاهما يدعم أقصى إخراج قياسي يبلغ 128K.
- الاختلاف في التكامل: يتطلب GPT-6.1 Sol استخدام Responses لاستدعاء الأدوات ولا يقبل none أو minimal للجهد؛ يستخدم Sonnet 5.5 تفكيرًا تكيّفيًا وقيود أدوات خاصة بالنموذج.
- حافظ على الدليل خاصًا بالإصدار: لا يمكن إعادة تسمية نتائج GPT-6 Sol باعتبارها نتائج GPT-6.1 Sol.
- اختر بناءً على العمل المُنجز: قِس الجودة، والزمن، والمحاولات المعادة، وعمليات كتابة/قراءة الذاكرة المؤقتة، ورسوم الأدوات، وتصحيح البشر.
نظرة سريعة: GPT-6.1 Sol مقابل Claude Sonnet 5.5
| عامل اتخاذ القرار / المواصفات | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| المزوّد | OpenAI | Anthropic |
| تاريخ الإصدار | 29 سبتمبر 2026 | 28 سبتمبر 2026 |
| معرّف النموذج | gpt-6.1-sol | claude-sonnet-5-5 |
| السياق / الحد الأقصى القياسي للإخراج | 1,050,000 / 128,000 رمز | 1,000,000 / 128,000 رمز |
| المدخلات → المخرجات | نصوص وصور → نص | نصوص وصور → نص |
| عناصر التحكم في الاستدلال | low, medium, high, xhigh, max؛ والافتراضي medium | تفكير تكيّفي؛ الافتراضي high على منصة Claude |
| الجهد الافتراضي | medium | high على منصة Claude |
| تاريخ حدّ المعرفة | 30 أبريل 2026 | يونيو 2026 |
| السعر الرسمي الأساسي للإدخال/الإخراج لكل 1M | $2 / $10؛ الطلبات القياسية حتى 272K رمز إدخال | $2 / $10 |
| السعر الرسمي الأساسي لقراءات الذاكرة/1M | $0.10 | $0.10 |
| السعر الرسمي الأساسي لكتابات الذاكرة/1M | $2.50 | $2.50 لمدة 5 دقائق؛ $4.00 لمدة ساعة |
| فوترة السياق الطويل | فوق 272K إدخال: $4 للإدخال، $0.20 لقراءة الذاكرة، $5 لكتابة الذاكرة، $15 للإخراج لكل 1M؛ تُطبَّق على الطلب القياسي كاملًا | لا توجد زيادة مماثلة مذكورة في نظرة النموذج المشار إليها |
| التموضع الأساسي | ترميز معقّد، استخدام الحاسوب، والعمل الاحترافي | تكرار ترميزي سريع وسير عمل مهني |
| اختبر أولًا عندما | تستخدم أدوات Responses بالفعل أو تحتاج عناصر تحكم جهد صريحة | يتركز عملك على الترميز، والوثائق، والشرائح، أو الجداول |
| حدود الأدلة والقرار | قدرات موثّقة؛ لا يوجد فائز رقمي بإصدار مطابق مثبت هنا | نتائج منشورة للترميز والعمل المعرفي؛ ليست فوزًا مضبوطًا على GPT-6.1 Sol |
نظرة عامة على GPT-6.1 Sol
GPT-6.1 Sol هو إصدار Sol من OpenAI بتاريخ 29 سبتمبر 2026 للترميز المعقّد، واستخدام الحاسوب، والعمل الاحترافي. تصفه OpenAI بأنه أداء قريب من Astra بتكلفة أقل؛ ويجب التحقق من ذلك على مهامك. سِعته السياقية الكبيرة وضبط الاستدلال يجعلاه خيارًا مناسبًا لوكلاء المستودعات وسير العمل المهني متعدد الخطوات.
تُعد قيوده التشغيلية مهمة بقدر تموضعه: medium هو الجهد الافتراضي، وlow هو الحد الأدنى المدعوم، واستدعاء الأدوات يتطلب Responses. أي سير عمل مبني على مسار بلا استدلال أو أدوات Chat Completions يحتاج ترحيلًا قبل الاعتماد على هذا النموذج بثقة.
نظرة عامة على Claude Sonnet 5.5
Claude Sonnet 5.5 هو إصدار Anthropic بتاريخ 28 سبتمبر 2026 للترميز اليومي محدد النطاق، والوكلاء، والعمل الاحترافي. توثّق نظرة النموذج التفكير التكيّفي، وجهدًا افتراضيًا مرتفعًا على منصة Claude، ومدخلات نصوص وصور، وحدًا أقصى قياسيًا للإخراج يبلغ 128K. تؤكد Anthropic على إصلاح الأخطاء، والوثائق الواضحة، والشرائح المصقولة، وتكرار التنفيذ بكفاءة.
بالنسبة لفريق تطوير، يجعل ذلك Sonnet مرشحًا مفيدًا لدورات التنفيذ والمراجعة المتكررة. بالنسبة لسير العمل المكتبي، قيّم جودة المسودة الأولى والالتزام بالقوالب. يُقارن ادعاء السرعة لدى المزوّد Sonnet 5.5 بـSonnet 5؛ ولا يثبت أفضلية سرعة على GPT-6.1 Sol.
الأداء: GPT-6.1 Sol مقابل Claude Sonnet 5.5
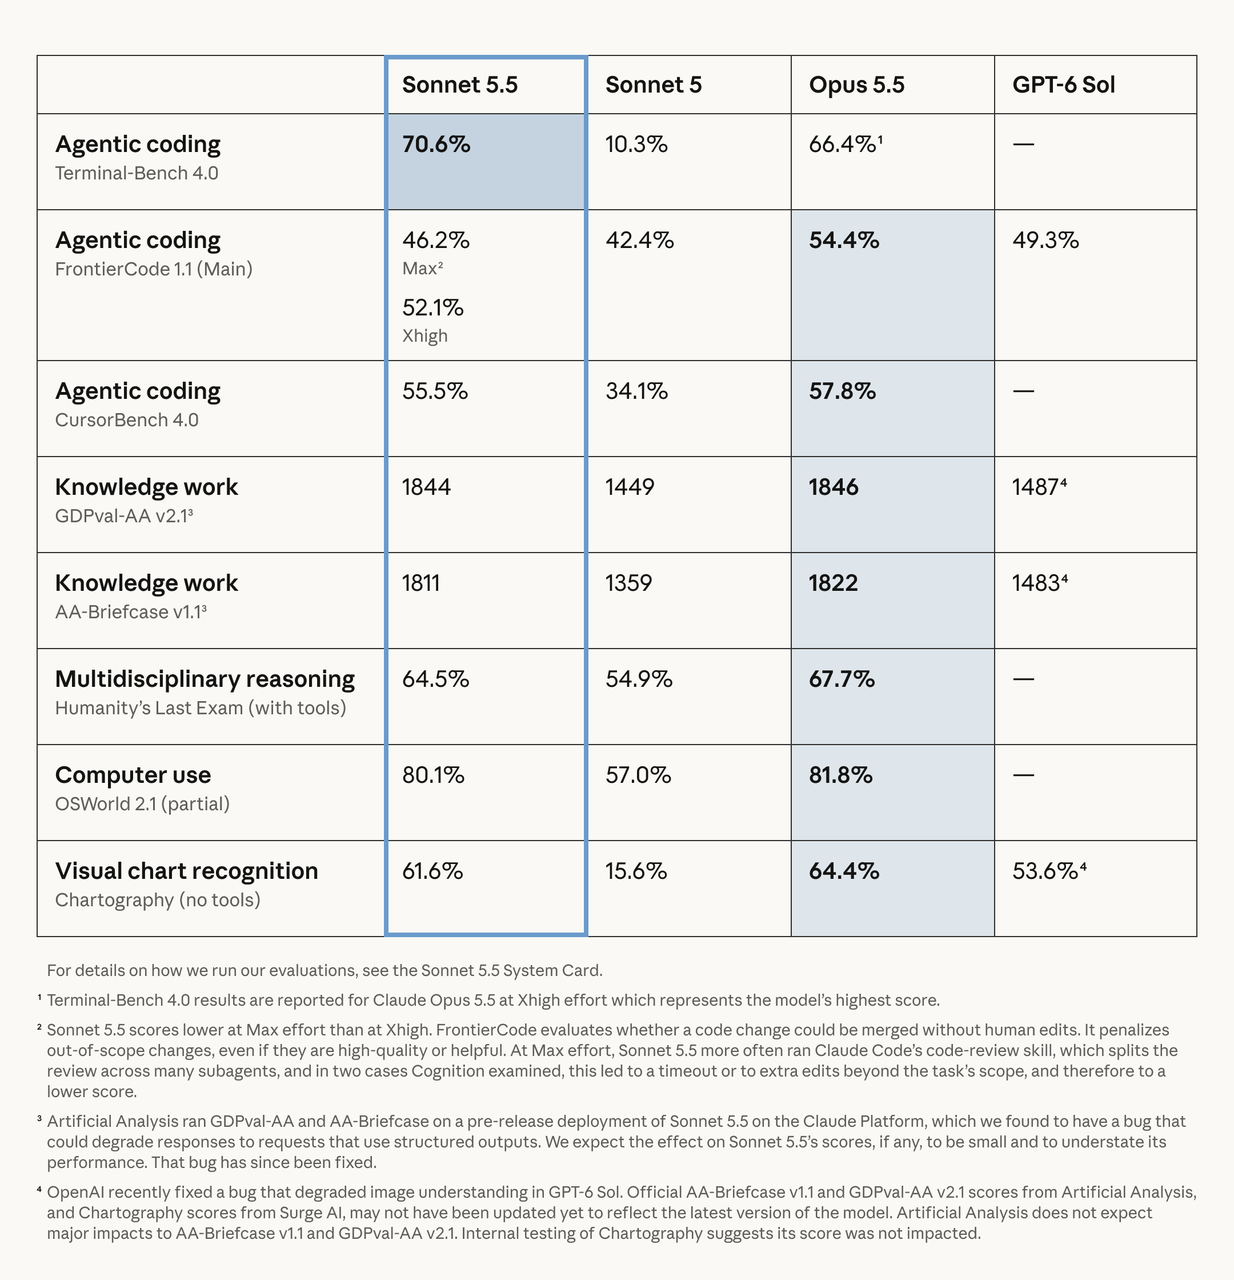
توفّر نتائج إطلاق Sonnet 5.5 إشارات مفيدة لأعباء العمل. تشمل المقارنة النموذج الأقدم GPT-6 Sol، لذا تم استبعاد قيم عمود OpenAI من الجدول الحالي. يشير "غير مُثبت هنا" إلى أن المصادر لا تدعم نتيجة لمقارنة إصدار مطابق؛ ولا يعني أداءً صفريًا.
| معيار / الشروط | GPT-6.1 Sol | Claude Sonnet 5.5 | ما الذي يقيسه |
|---|---|---|---|
| Terminal-Bench 4.0 | غير مثبت هنا | 70.6% | مهام الترميز على الطرفية |
| FrontierCode 1.1 Main | غير مثبت هنا | 52.1% Xhigh؛ 46.2% Max | تغييرات قابلة للدمج في المستودع |
| CursorBench 4.0 | غير مثبت هنا | 55.5% | تطوير بأسلوب الوكلاء في مهام Cursor |
| GDPval-AA v2.1 | غير مثبت هنا | 1844 | عمل معرفي مهني |
| AA-Briefcase v1.1 | غير مثبت هنا | 1811 | عمل معرفي طويل الأمد |
| Humanity’s Last Exam, tools | غير مثبت هنا | 64.5% | استدلال متعدد التخصصات |
| OSWorld 2.1, partial | غير مثبت هنا | 80.1% | مكافأة جزئية لاستخدام الحاسوب |
| Chartography, no tools | غير مثبت هنا | 61.6% | التعرّف على الرسوم البيانية بصريًا |
شروط الاختبار: يؤثر الجهد وإطار الوكيل على نتائج الترميز. GDPval-AA وAA-Briefcase تقييمات من Artificial Analysis، بينما تأتي نتائج Chartography من Surge AI. تشير Anthropic إلى خطأ مُهيكل في مخرجات Sonnet قبل الإطلاق وقد تم إصلاحه لاحقًا وقد يكون قلّل قليلًا من نتائج العمل المهني. استخدم رابط بطاقة النظام في الإعلان لبيئات الاختبار والمنهجية كاملة؛ لا تجمع مقاييس غير متشابهة في ترتيب إجمالي واحد.
تتضمن الصورة الأصلية من Anthropic أدنى النصّ ملاحظات التقييم. عمود GPT-6 Sol سياق تاريخي فقط ولا يُبلغ عن أداء GPT-6.1 Sol.
الترميز الوكيلي والهندسة البرمجية
يمتلك Sonnet 5.5 أدلة مُبلّغًا عنها على الترميز في الطرفية، والتغييرات القابلة للدمج، ومهام التطوير بأسلوب بيئات IDE. يوثّق GPT-6.1 Sol الترميز المعقّد ويتكامل مع منظومة أدوات OpenAI. لا يثبت التموضع التسويقي ولا نتيجة سلفٍ فائزًا حاليًا في الترميز. لتقييم مفيد، اختر تغييرات حقيقية مع اختبارات انحدار واطلب من المراجعين تقييم النطاق، والقابلية للصيانة، وجاهزية الدمج.
العمل المعرفي والاستدلال والرياضيات والعلوم
تجعل نتائج Sonnet في GDPval-AA وAA-Briefcase التقارير والتحليلات وتسليمات المكتب أهداف تقييم منطقية. يستهدف GPT-6.1 Sol أيضًا العمل الاحترافي، لكن المصادر المستخدمة هنا لا توفّر مقارنة مطابقة بين هذين النموذجين. استخدم قوالبك للوثائق والجداول والعروض التقديمية. تتطلب ادعاءات الرياضيات المتقدمة والعلوم أدلة خاصة بالمهمة بدلًا من الاستقراء من عناصر تحكم الاستدلال العامة.
استخدام الحاسوب وأتمتة المتصفح وسير العمل متعدد الوسائط
كلا النموذجين يقبل الصور، ما يدعم تصحيح الأخطاء عبر لقطات الشاشة والتحليل البصري. تُعد نتائج Sonnet في OSWorld وChartography أدلة لتلك التقييمات بعينها. يوضّح GPT-6.1 Sol استخدام الحاسوب عبر أدوات Responses. اختبر سير العمل كاملًا: دقة التنقل، والتعافي بعد فشل استدعاء أداة، وصحة المخرجات، والوقت حتى الإتمام. إدخال النص والصورة لا يضمن بمفرده تكاملًا مطابقًا لاستخدام الحاسوب.
تقييم مستقل وجودة الأدلة
قد تحتوي جداول منشورة من مزوّد على نتائج طرف ثالث دون أن تصبح تجربة مضبوطة واحدة. لأي مقارنة مستقلة، سجّل معرّفات النماذج الدقيقة، وتواريخ النشر، والجهد، والأدوات، والضمانات، وحدّ انقضاء الوقت، وسياسة إعادة المحاولة، وقواعد الإيقاف. يُجيب مؤشر ذكاء تجميعي، ومعدل نجاح ترميز، ودرجة مكافأة جزئية لاستخدام الحاسوب عن أسئلة مختلفة. لا تُثبت المصادر المُراجعة مجموعة نتائج مستقلة كاملة متطابقة لهذه الثنائية تحديدًا.
التكلفة: GPT-6.1 Sol مقابل Claude Sonnet 5.5
تسعير API الرسمي
| مقياس التسعير | أسعار GPT-6.1 Sol الرسمية | أسعار Claude Sonnet 5.5 الرسمية |
|---|---|---|
| الإدخال / 1M رموز، الطبقة القياسية | $2.00 | $2.00 |
| الإخراج / 1M رموز، الطبقة القياسية | $10.00 | $10.00 |
| قراءة الذاكرة / 1M رموز، الأساسية | $0.10 | $0.10 |
| كتابة الذاكرة / 1M رموز، الأساسية | $2.50 | $2.50 لمدة 5 دقائق؛ $4.00 لمدة ساعة |
| المعالجة الدُفعية | أقل 50% من القياسي | خصم 50% على الإدخال/الإخراج |
| إدخال فوق 272K، الطلب القياسي الكامل | $4 إدخال / $0.20 قراءة ذاكرة / $5 كتابة ذاكرة / $15 إخراج | لا توجد زيادة مماثلة مذكورة في النظرة العامة المشار إليها |
كل الأسعار بالدولار لكل مليون رمز. قراءات ذاكرة GPT-6.1 Sol الأساسية تكلف $0.10/1M وقراءات ذاكرة Sonnet 5.5 تكلف أيضًا $0.10/1M. شرط Sol فوق 272K إدخال يرفع الأسعار للطلب القياسي كله، وليس فقط الرموز الزائدة. قارن عمليات كتابة الذاكرة، والاحتفاظ، وطبقات السياق الطويل، والمعالجة الإقليمية، وطبقات الخدمة؛ فسعر القراءة الأساسي وحده لا يمنح أفضلية لأي نموذج.
التكلفة لكل مهمة مكتملة
التكلفة لكل نتيجة مقبولة = التكلفة الإجمالية عبر كل المهام المُنفّذة / عدد النتائج المقبولة. تشمل التكلفة الإجمالية الإدخال الجديد المفوتر، وقراءات وكتابات الذاكرة، والإخراج (بما في ذلك رموز الاستدلال المفوترة عند الاقتضاء)، واستدعاءات الأدوات المدفوعة، والمراجعة أو التصحيح البشري. تُحتسب تكاليف الإعادة وفق استخدامها الفعلي، ولا تُضاف مجددًا كرسوم مزدوجة.
لمليون رمز من قراءات الذاكرة المفوترة بالكامل بالسعر الأساسي، يكلف أي منهما $0.10؛ فرق سعر القراءة الأساسي هو $0.00. هذا توضيح لمعدل، وليس طلب Sol بمليون رمز إدخال مفوتر بالسعر الأساسي. تشمل تكلفة الجلسة الفعلية أيضًا الإدخال الجديد، وكتابات الذاكرة، والإخراج، والأدوات، والمحاولات المعادة. قارن الجلسات الباردة والحارة ضمن طبقة السياق المطبّقة وبلّغ معدل النتائج المقبولة إلى جانب الاستخدام المفوتر.
تسعير CometAPI
| فئة CometAPI المنشورة | GPT-6.1 Sol عبر CometAPI | Claude Sonnet 5.5 عبر CometAPI |
|---|---|---|
| الإدخال/الإخراج الأساسي لكل 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| الخصم الأساسي مقابل المزوّد | 20% | 20% |
| إدخال/إخراج سياق GPT الطويل | $3.20 / $12.00 | راجع الشروط الخاصة بالمسار الحالي |
| قراءات ذاكرة GPT، أساسي/طويل | $0.08 / $0.16 | غير مذكور في جدول التسعير الأساسي المذكور |
هذه أسعار مسارات النماذج المنشورة لهذا التحديث، وهي منفصلة عن أسعار المزوّدين. يفرّق تسعير CometAPI لـ GPT-6.1 Sol بين السياق القصير والطويل. يسرد جدول Sonnet الأساسي المُشار إليه الإدخال والإخراج، لذا لا يبرّر افتراض سياسة ذاكرة مؤقتة مماثلة عبر البوابة. تحقّق من شروط الفوترة الحالية للمسار المحدد قبل تقدير جلسة إنتاجية.
كيف تقارن نوافذ السياق، السرعة، والمواصفات التقنية؟
يدعم GPT-6.1 Sol عدد 1.05M رمز، بينما يدعم Claude Sonnet 5.5 عدد 1M رمز. الفارق الاسمي نحو 5% فقط، لذا من غير المرجّح أن تحسم سعة السياق وحدها معظم عمليات النشر.
سُلّم جهد GPT-6.1 Sol هو: low, medium, high, xhigh, max؛ والافتراضي medium. يستخدم Sonnet 5.5 تفكيرًا تكيّفيًا مع high كافتراضي على منصة Claude. لا تعني هذه الأسماء ميزانيات استدلال متساوية. عند متطلبات جودة متساوية، قِس زمن الوصول لأول رمز، ومعدل بثّ الإخراج، وزمن حلقات الأدوات، والإتمام من طرف إلى طرف بصورة منفصلة.
تُبلغ Anthropic عن توليد مخرجات أسرع بأكثر من 30% لـ Sonnet 5.5 مقارنة بـ Sonnet 5. اعتبر ذلك مقارنة بسلف. لا تُثبت أدلة هذا المقال رقمَ زمن وصول شاملًا لـ GPT-6.1 Sol أو فائزًا مباشرًا في السرعة بين النموذجين الحاليين. لأعباء العمل التفاعلية، اختبر إعدادات جهد أدنى وفق نفس معيار القبول بدلًا من افتراض أن max هو أفضل إعداد للنشر.
ما المهم للسلامة والمواءمة والنشر؟
ينبغي أن تميّز قرارات النشر بين سلوك النموذج المُوثّق وعناصر التحكم في التطبيق. لا يمكن لمقارنة نماذج وحدها أن تُثبت أي نشر يستوفي متطلبات مؤسستك لمعالجة البيانات أو الوصول. قيّم المزوّد أو البوابة التي تستخدمها فعليًا، بما في ذلك تسجيل الطلبات، وإقامة البيانات، وأذونات الأدوات، والتعامل مع الإخفاقات.
- ترحيل الاستدلال: لا يدعم GPT-6.1 Sol none أو minimal. تُوجّه إرشادات ترحيل OpenAI سير عمل استدعاء الأدوات إلى Responses.
- سلوك أدوات Claude: تشمل التغييرات الموثّقة للتوافق في Sonnet 5.5 أوضاع أدوات مفروضة غير مدعومة وكتل تفكير مرتبطة بالمحادثة. اختبر هذه المسارات قبل النشر.
- الضوابط التشغيلية: امنح الوكلاء الأدوات اللازمة فقط، وسجّل الاستدعاءات الفاشلة، واحتفظ بمراجعة بشرية للإجراءات الخارجية ذات العواقب. هذه خيارات تصميم تطبيق، وليست مزايا مقاسة لأي نموذج.
أيهما تختار: GPT-6.1 Sol أم Claude Sonnet 5.5؟
اختبر GPT-6.1 Sol أولًا عندما تستخدم أدوات Responses بالفعل أو تحتاج سُلّم جهد يمكن التنبؤ به. اختبر Sonnet 5.5 لتكرار الترميز محدد النطاق، والشرائح، والجداول، والوثائق حيث تتوافق أدلته المبلّغة مع مهامك. في الجلسات ذات البادئات المخبأة، اختبر كليهما: أسعار قراءات الذاكرة الأساسية متساوية، بينما يمكن أن تغيّر تكاليف الكتابة، والاحتفاظ، وطبقات السياق الطويل، والنجاح في المهام التكلفة الإجمالية. وجّه العمل فقط بعد أن تُثبت تقييمات ممثّلة فارقًا مفيدًا في الجودة أو التكلفة أو الزمن.
اختيار قائم على عبء العمل
| عبء العمل | نقطة البداية | ما يجب التحقق منه |
|---|---|---|
| وكيل Responses من OpenAI قائم | GPT-6.1 Sol | توافق الأدوات وتغييرات الجهد |
| تكرار الترميز/إصلاح الأخطاء | Sonnet 5.5، ثم قارن مع Sol | جاهزية الدمج، والزمن، والمحاولات المعادة |
| الشرائح/الجداول/التقارير | Sonnet 5.5، ثم قارن مع Sol | الالتزام بالقوالب ووقت تحرير البشر |
| جلسات ببادئات مستقرة مُخبأة | كلاهما؛ أسعار قراءة ذاكرة متساوية | نسبة الإصابات، والكتابات، وطبقة السياق، والجودة |
| طلبات كاملة فوق 272K إدخال | كلاهما | فاتورة السياق الطويل الفعلية وجودة الاسترجاع |
| استخدام الحاسوب/أتمتة المتصفح | كلاهما | التعافي، وإتمام المهام، والأذونات |
| الرياضيات/التحليل العلمي | كلاهما في اختبارات خاصة بالمهمة | الصحة مع إجابات قابلة للتحقق |
| إنتاج حساس للتكلفة | كلاهما | التكلفة الإجمالية لكل نتيجة مقبولة |
ينبغي أن تُبقي مقارنة الإنتاج النظام المحيط ثابتًا. استخدم نفس المطالبات، والمستودعات أو الوثائق، وأذونات الأدوات، وحدّ الوقت، وسياسة إعادة المحاولة، ومعيار قبول المخرجات.
سجّل الإدخال الجديد، وكتابات وقراءات الذاكرة، والاستخدام للإخراج، واستدعاءات الأدوات المدفوعة، والمحاولات المعادة، ووقت المراجعة البشرية، ونجاح المهمة، والزمن من طرف إلى طرف. قد ينتج عن استجابة أولى أرخص نتيجة مقبولة أكثر تكلفة.
كيف تصل إلى GPT-6.1 Sol وClaude Sonnet 5.5؟
يمكن للمطورين الوصول إلى GPT-6.1 Sol API في CometAPI وClaude Sonnet 5.5 API في CometAPI عبر مسارات النماذج الموثّقة. أنشئ مفتاح API، وخزّنه بأمان، وتحقق من الوصول إلى النموذج وشروط الفوترة الخاصة بالمسار قبل الاستخدام الإنتاجي.
الوصول إلى GPT-6.1 Sol
بالنسبة إلى Sol، استخدم مسار Responses الموثّق عندما يتطلب الأمر استدعاء الأدوات. اختر gpt-6.1-sol ومستوى الجهد المدعوم، مع medium كافتراضي. مرّر مُدخل المهمة، واضبط فقط الأدوات اللازمة، وتحقق من النص المُعاد، واستدعاءات الأدوات، والأخطاء، والاستخدام. أكّد دعم البوابة للميزات الخاصة بالمزوّد بدل افتراض أن كل خيارات OpenAI متاحة.
الوصول إلى Claude Sonnet 5.5
بالنسبة إلى Sonnet، اختر claude-sonnet-5-5 عبر واجهة متوافقة موثّقة وأرسل المهمة كرسائل محادثة بميزانية إخراج مناسبة. تحقق من كيفية تعامل ذلك المسار مع التفكير الأصلي ومعاملات الأدوات؛ حقول الاستدلال في OpenAI ليست قابلة للاستبدال تلقائيًا بخيارات Claude. تحقق من استمرار المحادثة والتعامل مع الأخطاء قبل نشر الوكلاء.
يفحص اختبار نقطة النهاية الاتصال، لا الأداء المقارن. للتقييم، وحّد المطالبات، وميزانيات الإخراج والاستدلال الفعلية، والأدوات، وإعادات المحاولة، وحدود الوقت، ومعايير القبول، ثم قارن العمل المقبول، والزمن، والتكلفة المفوترة الإجمالية.
الخلاصة
يتقاسم GPT-6.1 Sol وClaude Sonnet 5.5 نفس أسعار الإدخال، والإخراج، وقراءة الذاكرة الأساسية، مع سعة سياق متشابهة. يُعد Sol مرشحًا طبيعيًا لوكلاء Responses القائمين وعناصر تحكم الجهد الصريحة. يجعل التفكير التكيّفي لدى Sonnet ونتائجه المبلّغ عنها في الترميز والعمل المهني منه مرشحًا مفيدًا للتسليمات اليومية. تتطلب سير العمل الثقيلة على الذاكرة المؤقتة مقارنة للجلسة كاملة: تساوي أسعار القراءة الأساسية لا يضمن تكاليف كتابة، واحتفاظ، وسياق طويل، أو تكلفة لكل مهمة مكتملة متساوية.
اختر النموذج الذي يُنجز عملك الفعلي ضمن متطلبات الجودة، والزمن، والتكلفة. افصل نتائج الأسلاف عن أدلة النماذج الحالية، واحتسب طبقة السياق التي يستخدمها عبء عملك، وقارن كلا المسارين قبل اعتماد افتراضي.
الأسئلة الشائعة
هل يمكن لـ GPT-6.1 Sol وSonnet 5.5 مشاركة مخطط أدوات واحد؟
يمكن أن يكون تعريف أداة JSON المشتركة نقطة انطلاق، لكن دعم نقاط النهاية، وسلوك الأدوات المفروضة، وكتل التفكير، والتعامل مع الاستجابة تختلف. تحقّق من استدعاءات الأدوات لكل نموذج باختبارات تعاقدية للوسائط، ومسارات الفشل، واستمرار المحادثة. احتفظ بمحوّلات خاصة بالنموذج للخيارات غير المدعومة بدل افتراض أن طلب نص ناجح يثبت توافق الوكيل.
كيف ينبغي مطابقة جهد الاستدلال عبر كلا النموذجين؟
لا تعامل الإعدادات ذات الأسماء المتطابقة كميزانيات حساب متساوية. عرّف معيار قبول وحدّ تكلفة أو هدف زمن، ثم اجْرِ مسحًا لإعدادات الجهد لكل نموذج. قارن أفضل تهيئة تلبّي نفس القيد التشغيلي، بما يشمل الإعادات والتصحيح البشري، بدل مقارنة أعلى الإعدادات فقط في كلا النموذجين.
متى ينبغي استخدام الاسترجاع بدل سير عمل بسياق 1M؟
استخدم الاسترجاع عندما تحتاج المهمة إلى جزء صغير ومحدد من مجموعة كبيرة وتُظهر اختبارات الاسترجاع أن المادة ذات الصلة تُستعاد باستمرار. اختبر طلبات السياق الكامل عندما تكون الأدلة موزّعة أو عندما تهم العلاقات عبر الملفات. قارن صحة الإجابات، وتغطية الاستشهادات، وتكلفة الإدخال، والزمن؛ إذ لا يثبت حد سياق كبير وحده أن ملء النافذة بالكامل اقتصادي أو موثوق.
كيف تتجنب الفرق مقارنة مضللة لتكلفة الذاكرة المؤقتة؟
قِس تشغيلات الذاكرة الباردة والساخنة بشكل منفصل، وسجّل كتابات الذاكرة إلى جانب قراءاتها، وطبّق نافذة الاحتفاظ الصحيحة وطبقة السياق الطويل. أبقِ البادئات المشتركة ثابتة وقارن جلسات متكررة واقعية، لا مجرد طلب مخفّض واحد. أبلغ عن معدل الإصابة والاستخدام المفوتر الإجمالي بحيث يمكن إعادة إنتاج التوفير الظاهر.
ما الذي يجب أن يطلق تقييمًا جديدًا بين GPT-6.1 Sol وSonnet 5.5؟
أعِد تشغيل مجموعة المهام المتأثرة بعد تحديث نشر، أو إصلاح خطأ من المزوّد، أو تغيير في التوجيه، أو تغيير أداة أو مطالبة، أو تعديل جوهري في التسعير. سجّل تاريخ التقييم، ومعرّف النموذج، ونقطة النهاية، والجهد، وإصدار الإطار. احتفظ بتشغيل سابق كخط أساس حتى لا تُخلط تغييرات الجودة أو الزمن بتغييرات النظام المحيط.