TL;DR
GPT-6.1 Sol ليس بديلاً أوسع سياقًا أو أعلى تكلفة من GPT-6 Sol. فهو يحتفظ بنفس نافذة السياق البالغة 1.05 مليون رمز، وحد أقصى للمخرجات 128K، وتسعير API القياسي $2/$10، مع تحسينات في البرمجة، واستخدام الحاسوب، وسير العمل المهني، والموثوقية الواقعية، وسلوك الوكلاء. أوضح تغيّر في التسعير هو التخزين المؤقت للمطالبات: ينخفض سعر الإدخال المُخزَّن من $0.20 إلى $0.10 لكل مليون رمز.
النتيجة العملية هي أن GPT-6.1 Sol أقل تعلقًا بتغيير شكل واجهة البرمجة، وأكثر تعلقًا بالحصول على مقدار عمل مفيد أكبر بكثير ضمن ميزانية الرموز نفسها تقريبًا.
النقاط الأساسية
- GPT-6.1 Sol ترقية قدرات لـ GPT-6 Sol، مع نفس نافذة السياق 1,050,000 رمزًا وسقف المخرجات 128,000 رمز.
- تبقى أسعار الإدخال والإخراج القياسية عند $2 لكل 1M و$10 لكل 1M؛ ينخفض سعر الإدخال المُخزَّن من $0.20 لكل 1M إلى $0.10 لكل 1M.
- التقييمات الرسمية تُظهر قوة أكبر في البرمجة، واستخدام الحاسوب، والأتمتة التجارية، وسير العمل العلمي؛ النتائج تعتمد على المعيار وإعدادات الاستدلال.
- الهجرة تتطلب التحقق من كلٍّ من جهد الاستدلال وتوافق نقطة نهاية API: GPT-6.1 Sol لم يزل شيئًا ولاكن يتطلب Responses API لاستدعاء الأدوات.
- تحقّق من نجاح المهمة، والزمن، وضربات التخزين المؤقت الفعلية، والتكلفة الطرفية-إلى-الطرف قبل استبدال نشر GPT-6 Sol المستقر.
ما هو GPT-6.1 Sol، ولماذا وصل بعد GPT-6 Sol بفترة قصيرة؟
قدّمت OpenAI نموذج GPT-6 Sol في 22 سبتمبر 2026. بعد أسبوع، أعلن الملحق الخاص ببطاقة النظام في 29 سبتمبر عن GPT-6.1 Sol. تقدّم OpenAI الإصدار الجديد على أنه ترقية لـ GPT-6 Sol وليس فئة تسعير منفصلة.
فترة الإصدار القصيرة مهمة لأن GPT-6.1 Sol لا يتموضع كفئة منتج جديدة. حافظت OpenAI على فئة تسعير Sol وركّزت التحديث على قدرات المهام الصعبة، وكفاءة التكلفة، وموثوقية الوكلاء.
تضع OpenAI GPT-6.1 Sol في سياق البرمجة الوكيلية، واستخدام الحاسوب، والعمل المهني. المقارنة المهمة هي نجاح المهمة عند تكلفة معينة، لا اسم النموذج وحده. يوضّح ملخص القياسات الرسمية أدناه مكاسب القدرات مقابل مواصفات API غير المتغيرة.
هذا يجعل المقارنة مباشرة على نحو غير معتاد: GPT-6.1 Sol هو أساسًا ترقية في القدرة والكفاءة بدلاً من ترقية في نافذة السياق أو السعر الأساسي.
GPT-6.1 Sol مقابل GPT-6 Sol: ما الذي يبقى كما هو؟
يحتفظ النموذجان بنفس السعة العنوانية، وأنماط الإدخال/الإخراج المدعومة، وأسعار الإدخال/الإخراج القياسية. كما تسجّل الجدول اختلافات في تواريخ القطع المعرفي، وخيارات الاستدلال، واستدعاء الأدوات، وأسعار الإدخال المُخزَّن؛ لا ينبغي الخلط بين تلك الاختلافات والمواصفات المشتركة.
المواصفات المشتركة وفروقات التوافق
| المواصفة | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| تاريخ الإصدار | Sep. 29, 2026 | Sep. 22, 2026 |
| نافذة السياق | 1,050,000 tokens | 1,050,000 tokens |
| الحد الأقصى للمخرجات | 128,000 tokens | 128,000 tokens |
| تاريخ القطع المعرفي | Apr. 30, 2026 | Apr. 20, 2026 |
| إدخال/إخراج نصي | Yes / Yes | Yes / Yes |
| إدخال الصور | Yes | Yes |
| سعر الإدخال القياسي | $2.00 / 1M | $2.00 / 1M |
| الإدخال المُخزَّن | $0.10 / 1M | $0.20 / 1M |
| كتابة التخزين | $2.50 / 1M | $2.50 / 1M |
| سعر الإخراج | $10.00 / 1M | $10.00 / 1M |
| جهد الاستدلال | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| المخرجات المُهيكلة | Yes | Yes |
| استدعاء الدوال | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| الضبط الدقيق | No | No |
| إدخال صوت/فيديو | Not supported | Not supported |
| إخراج صور أصلي | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
تُظهر العمودان الرسميان أعلاه نفس حدود السياق والمخرجات. تصف هذه الأرقام السعة؛ لكنها لا تثبت دقة الاسترجاع أو الكمون المتساوي عبر كل مهام السياق الطويل.
يتقدم تاريخ القطع المعرفي قليلاً، من 20 أبريل إلى 30 أبريل 2026. والأهم، أن GPT-6.1 Sol لم يعد يدعم reasoning.effort="none"؛ إعدادات الاستدلال المتاحة تبدأ بـ low.
بالنسبة للمطورين المعتمدين على سلوك أدنى كمون ممكن، فإن هذا التفصيل التوافقي يستحق الاختبار لأن GPT-6 Sol ما زال يدعم جهد الاستدلال none.
المعمارية: ما يزال غير مُفصح عنه
لم تقدّم صفحة أيٍّ من النموذجين المستخدمة في هذه المقارنة عدد المعاملات أو تفصيلًا معماريًا. يذكر ملحق بطاقة النظام الرسمي أن GPT-6.1 Sol يستخدم نفس أنواع البيانات والتدريب مثل Astra؛ وهذا لا يثبت أن Sol وAstra لهما معمارية متطابقة. لذا تبقى فروقات المعمارية وحجم المعاملات غير مُفصح عنها في المواد المستشهد بها.
التسعير الأساسي لم يتغير؛ والقراءات المُخزَّنة أرخص
بالنسبة للرموز غير المُخزَّنة مؤقتًا، لا. تظل أسعار الإدخال والإخراج القياسية دون تغيير. التحسين الرئيسي في التسعير هو الإدخال المُخزَّن.
| تسعير API الرسمي — بالدولار لكل 1M رمز | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| إدخال / 1M رمز | $2.00 | $2.00 |
| إدخال مُخزَّن / 1M | $0.10 | $0.20 |
| كتابة التخزين / 1M | $2.50 | $2.50 |
| إخراج / 1M رمز | $10.00 | $10.00 |
يخفض GPT-6.1 Sol الإدخال المُخزَّن إلى $0.10 لكل مليون رمز، أو 5% من معدل الإدخال غير المُخزَّن.
على سبيل المثال، إعادة استخدام 100 مليون رمز مُخزَّن تكلف نحو $10 على GPT-6.1 Sol مقابل $20 على GPT-6 Sol. هذا الفرق متواضع للمطالبات لمرة واحدة لكنه أكثر أهمية للوكلاء كثيفي الحجم ذوي سوابق المطالبات الثابتة.
تنطبق أيضًا شروط التسعير الرسمية الموضحة في وثائق النموذج: الطلبات التي تتجاوز 272K رمز إدخال تستخدم معدلات إدخال وتخزين 2x وتسعير إخراج 1.5x على كامل الطلب. وضع Fast في GPT-6.1 Sol بسعر 2x Standard؛ فيما Batch وFlex أدنى بـ 50% من Standard. تضيف المعالجة الإقليمية علاوة 10% حيثما توفرت، ووضع Fast غير متاح مع إقامة بيانات الاتحاد الأوروبي. قد تنطبق رسوم أدوات منفصلة. خطط الميزانية وفق وضع المعالجة المختار، والمنطقة، وضربات التخزين الفعلية.
ما الذي تحسن في GPT-6.1 Sol؟
أفضل تقييم للترقية يكون عبر البرمجة، وسير عمل الوكلاء، والمستندات المهنية، والعلوم، والموثوقية الواقعية، والتعافي من الإخفاق. تجمع الأقسام أدناه هذه التحسينات مع الحفاظ على شروط القياس الأصلية وحدودها.
نظرة عامة على القياسات: مكاسب مُبلغ عنها وظروف التقييم
تأتي أقوى حالة لـ GPT-6.1 Sol من أداء مستوى المهمة لا من المواصفات الخام. تُبلغ OpenAI عن تحسينات عبر هندسة البرمجيات، والأتمتة التجارية، والتفاعل مع الحاسوب، وسير العمل العلمي، والموثوقية الواقعية، ومحاذاة الوكلاء.
| نتائج القياسات/التقييمات الرسمية | GPT-6.1 Sol مقابل GPT-6 Sol | ماذا يعني التغيير |
|---|---|---|
| DeepSWE v1.1 | +6.4 نقطة مئوية فوق أفضل نتيجة لـ GPT-6 Sol، مع جهد استدلال وتكلفة مهمة أقل؛ ليست مقارنة بجهدٍ مطابق | هندسة برمجيات طويلة الأفق أقوى |
| AutomationBench 1.0.6 | +4.8 نقطة مئوية عند جهد medium لكلا نموذجي Sol؛ +2.2 نقطة فوق Opus 5.5 عند medium | تنفيذ وكيل أعمال متعدد الخطوات أفضل |
| OSWorld 2.0 offline | +7 نقاط عند أقصى جهد؛ مكافأة جزئية على المجموعة غير المتصلة، الإصدار v2026.08.08؛ بأقل من نصف تكلفة المهمة | سير عمل استخدام الحاسوب أفضل |
| Terminal-Bench Science 0.1 | أكثر من 2x نتيجة GPT-6 Sol عند أقصى جهد، وبأقل من نصف تكلفة المهمة | مكسب كبير في سير العمل العلمي للوكلاء |
| تقييم الواقعية الصعبة | عند جهد low، تنخفض الاستجابات ذات الأخطاء من 11.4% إلى 7.7%; هذا تقييم لمطالبات صعبة مختارة | أخطاء واقعية أقل في المطالبات الصعبة |
| اختبار محاذاة البحث المعطّل | عند أقصى جهد، ينخفض الفشل في الإفصاح عن البحث المعطّل من 4.9% إلى 2.1%; مهام عدائية عمدًا | تعرّف أفضل على أعطال الأدوات |
هذه نتائج مُعلنة من OpenAI، وليست قياسات مستقلة من CometAPI. قيّمت OpenAI نماذجها في بيئة أبحاثها أو من خلال API الخاصة بها؛ قد يختلف سلوك الإنتاج تبعًا لمطالبات النظام والأدوات المتاحة. أرقام المنافسين تأتي من تقارير عامة. تكلفة المهمة تعكس التهيئة المختبرة وليست نفس سعر الرموز. لا ينبغي استنتاج تفاصيل غير مُبلغ عنها مثل ميزانيات التشغيل لكل مرة أو القوالب.
تُقارن النتيجة الرسمية في جدول القياسات أداء GPT-6.1 Sol عند جهد استدلال أقل بأفضل نتيجة لـ GPT-6 Sol. لا ينبغي وصفها كمقارنة سرعة بجهد متساوٍ. يقوم DeepSWE v1.1 بتقييم مهام أصلية طويلة الأفق في قواعد شفرات حقيقية.
للسياق، أبلغ إطلاق GPT-6 Sol الأصلي عن 68.8% عند أقصى جهد على DeepSWE v1.1.
البرمجة: هندسة برمجيات طويلة الأفق أقوى
البرمجة ربما هي الترقية الأوضح. يقيّم DeepSWE v1.1 الوكلاء على مهام هندسة برمجيات أصلية في قواعد شفرات حقيقية تتطلب عملاً مستدامًا متعدد الخطوات.
تكون تحسينات DeepSWE ذات صلة عندما يتعين على وكيل تفقد مستودع، وتخطيط تغييرات، واستخدام أدوات، وإصلاح إخفاقات على مدى خطوات عديدة. يمكن للمطورين مقارنة هذه الترقية مع GPT-6 Astra API في CometAPI عند تقرير ما إذا كانت أصعب المهام تبرر نموذجًا أعلى تكلفة.
هذا أهم من معيار برمجي قصير لأن وكلاء البرمجة الطويلة يراكمون تكلفة عبر الاستدلال المتكرر، واستدعاءات الأدوات، وقراءات الملفات، والرقع، وإعادة استخدام السياق. يحسّن GPT-6.1 Sol كلًا من إتمام المهام واقتصاديات السياق المُعاد دون رفع معدل الرموز القياسي $2/$10.
يبقى GPT-6 Sol API في CometAPI مفيدًا للنشر القائم ويوفّر مسارًا متوافقًا مع OpenAI لأعمال البرمجة والوكلاء.
وكلاء الذكاء الاصطناعي وسير الأعمال: الأتمتة واستخدام الحاسوب
نعم، والتحسين يتجاوز البرمجة. يُقيّم AutomationBench ما إذا كان وكيل يمكنه إكمال سير عمل طرفي-إلى-طرف باستخدام أدوات عديدة عبر المبيعات، والتسويق، والعمليات، والدعم، والمالية، والموارد البشرية.
نتيجة AutomationBench المطابقة عند جهد medium في ملخص القياسات ذات صلة بسير العمل التجاري كثيف الأدوات. تبقى نتيجة معيارية وليست ضمانًا للنجاح في حزمة أدوات شركة معينة. تتضمن المقارنة أيضًا Claude Opus 5.5 API في CometAPI؛ قيّم جميع البدائل باستخدام الأدوات نفسها ومعايير النجاح نفسها قبل الاختيار.
بالنسبة لاستخدام الحاسوب، تستخدم نتيجة OSWorld أعلاه المجموعة غير المتصلة ومكافأة جزئية. لا تعني نتيجة مكافأة جزئية أعلى بالضرورة أن كل مهمة اكتملت طرفيًا-إلى-طرف. ما يزال لحالة المتصفح، والأذونات، وسلوك التعافي، وجودة تكامل الأدوات أثر في نتائج النشر.
المستندات المهنية والعلوم: قدرة أوسع على المهام المعقدة
يدفع GPT-6.1 Sol طبقة Sol أبعد في عمل المعرفة المهنية. تقيم OpenAI فهم المستندات المعقدة عبر GDP.pdf، حيث تجيب النماذج عن أسئلة واقعية اعتمادًا على ملفات PDF تحتوي جداول ومخططات ورسومًا بيانية وتنسيقات كثيفة وتفاصيل دقيقة عبر مجالات كتمويل والرعاية الصحية والقانون.
يضيف GDP.pdf دليلًا لتحليل ملفات PDF المهنية أبعد من أسئلة وأجوبة نصية عادية. تعامل مع نتيجته في إعلان الإطلاق كتقييم لفهم المستند، لا كضمان بأن كل مخطط أو حاشية أو صفحة ممسوحة ستُفسَّر بدقة.
تغطي نتيجة Terminal-Bench Science في ملخص القياسات الرسمي سير عمل مثل تحليل البيانات، والمحاكاة، وإثبات النظريات. ينبغي أن يقيس تقييم محلي مفيد صحة المخرجات النهائية وقابليتها لإعادة الإنتاج، مع قياس إجمالي تكلفة الأدوات والنموذج.
هذا لا يعني أن GPT-6.1 Sol يستبدل Astra عالميًا. ما تزال OpenAI تضع Astra بوصفه نموذجها الأعلى قدرة لأصعب الأعمال طرفيًا-إلى-طرف. التغير المهم هو أن الفجوة في الأداء بين Sol وAstra تضيق بينما تبقى فجوة سعر الرموز بينهما كبيرة.
الواقعية وموثوقية الوكلاء: أخطاء أقل وتعامل أفضل مع الإخفاق
تشير بيانات الواقعية من OpenAI في هذا الاتجاه، وإن كان لا ينبغي تفسير التقييم باعتباره معدل هلوسة عالميًا.
يبلغ الإعلان الرسمي مباشرة عن تحسن في الواقعية عند جهد منخفض: تنخفض الاستجابات المحتوية على أخطاء من 11.4% مع GPT-6 Sol إلى 7.7% مع GPT-6.1 Sol، بانخفاض 3.7 نقطة مئوية، أو نحو 32% تقليصًا نسبيًا. كانت هذه محادثات مختارة مسبقًا تثير أخطاء؛ هذه الأرقام ليست معدل هلوسة عالميًا.
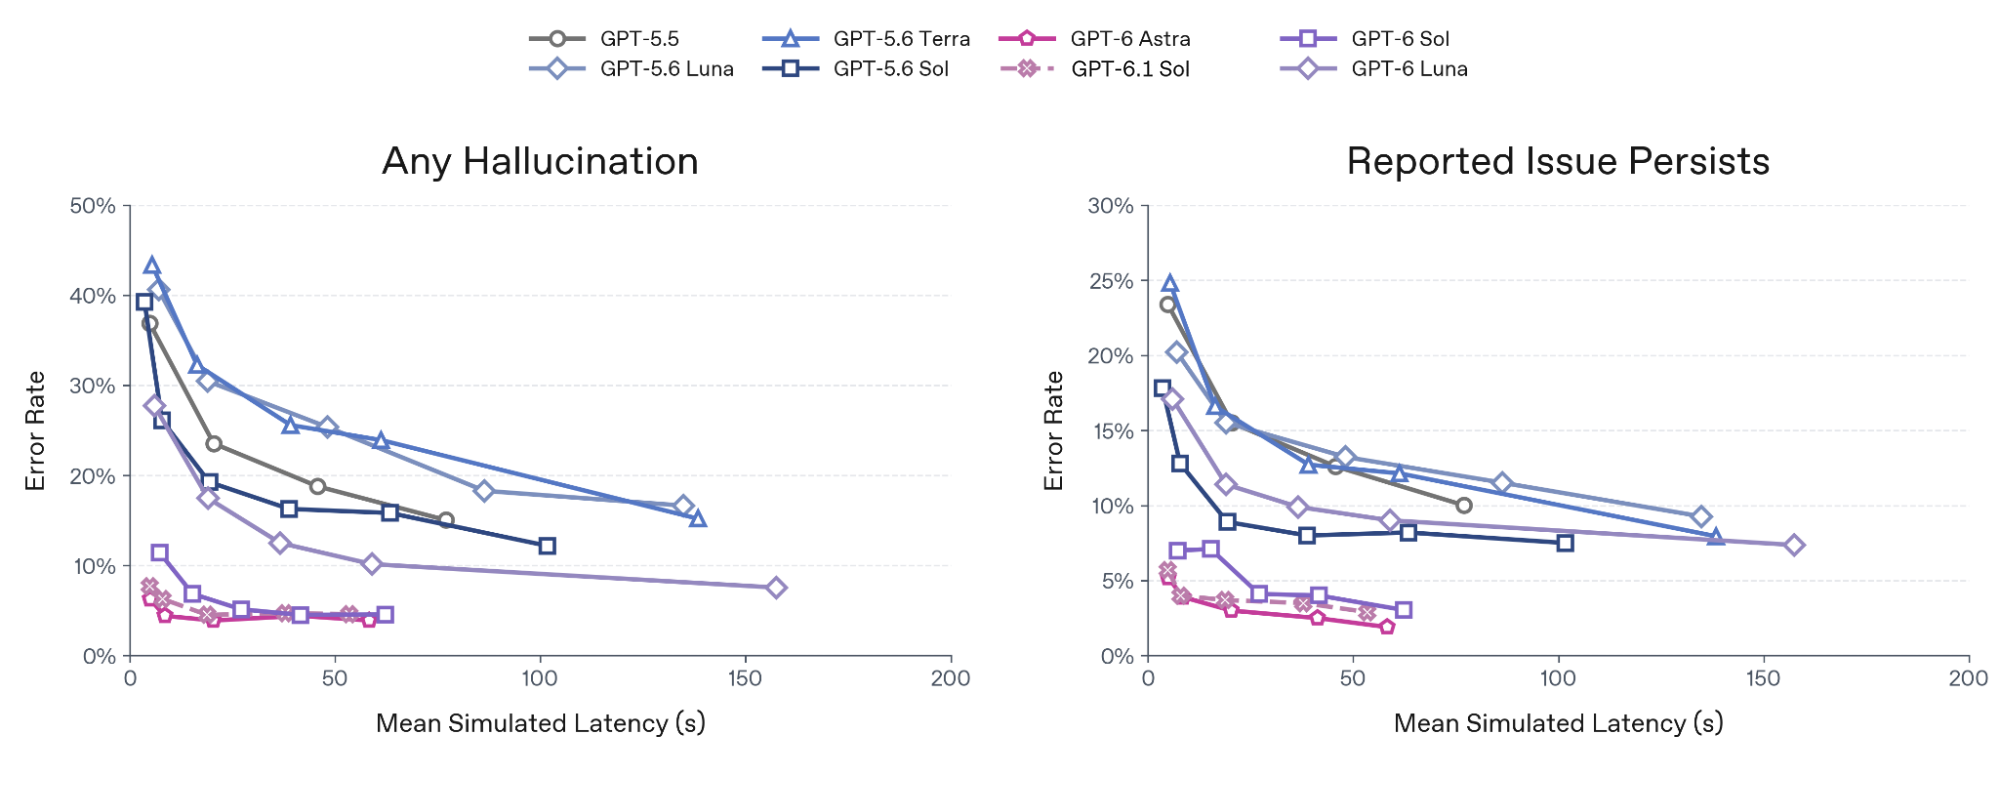
المخطط الأصلي أعلاه مُستخرج مباشرة من ملف PDF لبطاقة نظام OpenAI دون إعادة رسم. يرسم تقييمات محادثات صعبة مختارة مقابل زمن مُحاكى؛ يقيس اللوحان أي هلوسة واستمرارية المشكلة المُبلغ عنها. لا ينبغي قراءته كتشخيص لمعدل خطأ على نطاق الإنتاج.
| النموذج | معدل فشل البحث المعطّل — أقصى جهد |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
يُعد GPT-6 Luna API في CometAPI خيارًا آخر موجهًا للتكلفة، لكن نتيجته هنا في البحث المعطّل توضح لماذا يجب اختبار الوكيل في التعامل مع الإخفاق إلى جانب تنفيذ الأدوات بنجاح.
هذه تقييمات عدائية عمدًا لا معدلات فشل تمثيلية للإنتاج. وهي مفيدة كدليل على أن GPT-6.1 Sol أفضل في التعرف متى تكون الأدوات غير متاحة أو معطّلة بدلًا من الاستمرار بثقة بادعاءات غير مدعومة.
GPT-6.1 Sol مقابل GPT-6 Sol: هل ينبغي عليك الترقية؟
بالنسبة لسير عمل معقد جديد، GPT-6.1 Sol مرشح قوي للتقييم. بالنسبة لنشر GPT-6 Sol مستقر، قم بالترقية فقط عندما تبرر المكاسب المقاسة عملية الهجرة. حدود السياق المشتركة وأسعار الرموز الأساسية تتيح مقارنة عادلة، لكن المعايير العامة لا يمكنها تقرير ما إذا كان تطبيقك سيصبح أسرع أو أكثر موثوقية أو أرخص.
متى تستحق الترقية الاختبار؟
أعطِ الأولوية للتجربة عندما تشكل برمجة على مستوى المستودع، أو أتمتة أعمال متعددة الخطوات، أو استخدام الحاسوب، أو تحليل مستندات صعب نسبة كبيرة من عبء عملك. التحسينات المبلغ عنها في القسم السابق ذات صلة بهذه الاستخدامات. تعامل معها كأسباب للاختبار، لا كضمان أن معدل نجاح الإنتاج سيرتفع بنفس المقدار.
تطبيقات إعادة استخدام السياق هي حالة اختبار مفيدة أخرى. يمكن أن يخفض معدل القراءة المُخزَّنة الأدنى جزء الإدخال من الفاتورة عندما تعيد الطلبات استخدام سابقة ثابتة بالفعل. إذا جاء معظم الإنفاق من الرموز المُولّدة أو الأدوات أو المحاولات الفاشلة، فقد يكون خصم التخزين المؤقت وحده ذا تأثير محدود. قارن التكلفة الإجمالية لكل نتيجة مقبولة، بما في ذلك إعادة المحاولات ووقت المراجعة.
متى يكون الإبقاء على GPT-6 Sol منطقيًا؟
أبقِ GPT-6 Sol عندما يلبّي بالفعل أهدافك في الجودة والكمون والميزانية، ولا يُنتج النموذج الأحدث فائدة مادية في تقييم تمثيلي. التكامل العامل له قيمة أيضًا: تجنب استبدال مسار مستقر لمجرد أن اسم النموذج أحدث.
يمكن أن يكون التوافق حاسمًا. يدعم GPT-6 Sol جهد الاستدلال none؛ بينما يبدأ GPT-6.1 Sol عند low. يجب على تطبيق يستخدم استدعاء دوال Chat Completions في Sol عند none نقل حلقة الأدوات إلى Responses لاستخدام 6.1 Sol. راجع أيضًا معايير التوليد ومعالجة الاستجابة. هذه تغييرات ترحيل، لا استبدالًا لمعرّف النموذج فقط. راجع إرشادات ترحيل OpenAI.
كيف تتخذ قرار الترقية
أنشئ مجموعة تقييم ثابتة تضم مهام روتينية وحالات صعبة وإخفاقات أدوات من سير العمل المقصود. أبقِ تعريفات المهام وأذونات الأدوات ومعايير القبول متسقة. قارن خط أساس Sol مُثبتًا بتهيئة 6.1 Sol صحيحة؛ سجّل إعدادات الاستدلال صراحة بدلًا من التظاهر بأن none وlow متكافئان.
- الجودة: قِس الإكمالات المقبولة، والتصحيحات الواقعية، واستدعاءات الأدوات غير الصالحة، وجهد المراجعة البشرية.
- السرعة: قارن p50/p95 للكمون طرفيًا-إلى-طرف، بما في ذلك إعادة المحاولات وأزمنة انتظار الأدوات.
- التكلفة: سجّل الإدخال غير المُخزَّن، والقراءات المُخزَّنة، وكتابات التخزين، ورموز الإخراج/الاستدلال، ورسوم الأدوات، وجهد الهندسة.
- الإطلاق: ابدأ بشريحة حركة صغيرة، واحتفظ بخيار رجوع إلى Sol، وتوسّع فقط عندما تُستوفى حدود محددة مسبقًا.
توصية عملية: اختر GPT-6.1 Sol عندما تحقق التجربة اقتصاد مهام مقبولًا أفضل أو مكسب قدرة لازم دون تراجعات غير مقبولة. احتفظ بـ GPT-6 Sol للمسارات التي تفوق فيها التوافق والنتائج المثبتة الفائدة المقاسة. النشر المختلط معقول عندما تتحسن فقط بعض فئات المهام. هذه توصيات قائمة على عبء العمل، لا ادعاء بأن أي نموذج يفوز عالميًا.
كيف تهاجر من GPT-6 Sol إلى GPT-6.1 Sol؟
على أبسط مستوى، يتغير معرّف النموذج من gpt-6-sol إلى gpt-6.1-sol.
يمكن أن يبدو طلب Responses API بهذا الشكل:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
تغيير معرّف النموذج ليس سوى الخطوة الأولى. يدعم GPT-6.1 Sol إعدادات low وmedium وhigh وxhigh وmax، بينما يدعم GPT-6 Sol كذلك none. أزل أي تعيين صريح لقيمة none واختر جهدًا مسموحًا به. تحتاج التطبيقات التي تستخدم الأدوات أيضًا إلى Responses API: لا يدعم GPT-6.1 Sol استدعاء الأدوات عبر Chat Completions، بينما يدعم GPT-6 Sol Chat Completions استدعاء الدوال فقط عند none. توثّق أعمدة النموذج الرسمية في جدول المواصفات هذه القيود في نقاط النهاية.
على الفرق إعادة اختبار سير العمل الحساسة للكمون، واستدعاء الأدوات، والتخزين المؤقت للمطالبات، وسلوك السياق الطويل، وأي منطق يرسل صراحة reasoning.effort="none".
يستهدف هذا المثال OpenAI مباشرة باستخدام OPENAI_API_KEY؛ وليس مثال نقطة نهاية CometAPI مُتحققًا منه. احتفظ بمسار GPT-6 Sol متاحًا خلال إطلاق مرحلي، وسجّل نجاح المهمة وp95 للكمون، وارجع إذا لم تُستوفَ معايير القبول لتطبيقك.
أي أعباء عمل تستفيد أكثر من GPT-6.1 Sol؟
| عبء العمل | ميزة GPT-6.1 Sol |
|---|---|
| وكلاء البرمجة | أداء أعلى على DeepSWE |
| تصحيح على مستوى المستودع | هندسة برمجيات طويلة الأفق أفضل |
| وكلاء المتصفح/الحاسوب | +7 نقاط على OSWorld 2.0 |
| الأتمتة المؤسسية | أداء أعلى على AutomationBench |
| وكلاء إعادة استخدام السياق | إدخال مُخزَّن أرخص بـ 50% |
| تحليل PDF معقد | أداء قريب من Astra في المستندات المهنية |
| سير العمل العلمي | أكثر من 2x نتيجة GPT-6 Sol في تقييم Terminal-Bench Science من OpenAI |
| سير عمل حسّاسة للواقع | معدل خطأ واقعي أدنى في مطالبات صعبة |
| وكلاء كثيفة الأدوات | سلوك أفضل عند تعطل الأدوات |
يبقى GPT-6 Sol مفيدًا حيث تكون التكاملات القائمة مستقرة بالفعل أو حيث يحتاج المطورون تحديدًا إلى إعداد none للاستدلال. بالنسبة للنشر الجديد الذي يتمحور حول الوكلاء والبرمجة واستخدام الحاسوب أو سير العمل المعتمد على إعادة استخدام السياق، يغيّر GPT-6.1 Sol معادلة التكلفة-الأداء دون تغيير سعر الرموز الطبيعي للإدخال/الإخراج.
كيف يساعدك CometAPI في الترقية من GPT-6 Sol إلى GPT-6.1 Sol؟
بالنسبة للمطورين الذين يستخدمون بالفعل GPT-6 Sol API في CometAPI، يمكن التعامل مع الترقية إلى GPT-6.1 Sol على أنها هجرة صغيرة نسبيًا لا إعادة كتابة كاملة للتكامل.
يتوفر GPT-6.1 Sol الآن عبر CometAPI بمعرّف النموذج gpt-6.1-sol. يعرض CometAPI حاليًا سعر إدخال سياق قصير يبدأ من $1.60 لكل مليون رمز، مقارنة بسعر OpenAI الرسمي $2.00، بينما يبدأ تسعير الإخراج عند $8.00 لكل مليون رمز. يُبقي هذا نموذج Sol الأحدث ضمن هيكل التسعير المخفّض نفسه الخاص بـ GPT-6 Sol مع منح المطورين إمكانية الوصول إلى أدائه الأقوى في البرمجة والوكلاء واستخدام الحاسوب.
وبما أن CometAPI يوفّر واجهة متوافقة مع OpenAI، يمكن لتطبيقات GPT-6 Sol الحالية عادةً الإبقاء على بنية SDK وتدفق الطلب نفسه مع تبديل معرّف النموذج إلى gpt-6.1-sol. كما يوفر CometAPI أدوات لمقارنة النماذج واختبار المطالبات وتقدير تكاليف عبء العمل وفحص سلوك الهجرة قبل طرح الإنتاج.
عملية ترقية أكثر أمانًا هي تشغيل المطالبات التمثيلية نفسها على GPT-6 Sol وGPT-6.1 Sol أولًا، ثم مقارنة جودة المخرجات، والكمون، وسلوك الأدوات، والتكلفة الإجمالية. هذا مهم خصوصًا للتطبيقات المعتمدة على إعدادات الاستدلال، والمخرجات المهيكلة، واستدعاءات الأدوات، أو الوكلاء طويلة التشغيل، لأن التوافق بين النماذج لا يضمن سلوكًا مطابقًا على كل عبء عمل.
بالنسبة للفرق التي تُشغِّل أعباء عمل إعادة استخدام السياق أو كثيفة الوكلاء، يمكن للمسار الأحدث تحسين الاقتصاديات أيضًا. يسعّر CometAPI حاليًا قراءات التخزين المؤقت القصيرة لـ GPT-6.1 Sol عند $0.08 لكل مليون رمز، مقابل $0.10 الرسمي من OpenAI، بينما أسعار الإدخال والإخراج للسياق القصير مُدرجة عند أقل بـ 20% من التسعير الرسمي.
عمليًا، يمكن لـ CometAPI جعل انتقال GPT-6 Sol → GPT-6.1 Sol عملية من ثلاث خطوات:
- استبدل
gpt-6-solبـgpt-6.1-sol. - قِس المطالبات الإنتاجية نفسها وسير عمل الوكلاء قبل تحويل الحركة.
- انقل الأعباء تدريجيًا بمجرد أن تلبي جودة المخرجات وسلوك الأدوات والكمون والتكلفة متطلباتك.
يتيح هذا النهج للمطورين اعتماد GPT-6.1 Sol دون إعادة بناء تطبيقهم حول حزمة API جديدة، مع الاستمرار في التحقق من الاختلافات السلوكية التي يقدمها النموذج الأحدث.
الخلاصة
GPT-6 Sol ليس متقادمًا تقنيًا. فهو يحتفظ بنافذة السياق 1.05M نفسها، وسقف المخرجات 128K، والمخرجات المُهيكلة، وإدخال الصور، وتسعير Standard $2/$10. قد يكون خيار الاستدلال none مهمًا أيضًا للتكاملات الحالية. ينبغي أن يعتمد قرار الترقية على نتائج المهام المقاسة والتوافق، لا رقم الإصدار وحده.
مع ذلك، تشير وثائق GPT-6 Sol من OpenAI الآن المطورين إلى GPT-6.1 Sol بوصفه نموذج Sol الأحدث.
لأغلب الأعباء المعقدة، السؤال الأساسي ليس ما إذا كان GPT-6.1 Sol يملك نافذة سياق أكبر أو معدل رموز أعلى—فهو لا يملك ذلك. السؤال هو ما إذا كانت نسبة نجاح أعلى، وقراءات مخزّنة أرخص، وواقعية محسّنة، وسلوك وكيل أقوى تبرر تغيير معرّف النموذج وإعادة اختبار عبء العمل.
الأسئلة الشائعة
كيف تهاجر من GPT-6 Sol إلى GPT-6.1 Sol مع استدعاء الأدوات؟
لا. أولًا راجع نقطة النهاية وحقول الطلب، ثم انقل حلقة الأدوات إلى Responses API واختبر تحليل استدعاءات الأدوات، والتحقق من الوسائط، وإعادة المحاولات، والتعامل مع الأخطاء. شغّل Canary على مهام تمثيلية قبل زيادة الحركة؛ طلب نصي ناجح لا يثبت عمل حلقة الأدوات.
هل GPT-6.1 Sol أرخص في أعباء العمل الواقعية؟
سجّل رموز الإدخال المُخزَّنة وغير المُخزَّنة، وكتابات التخزين، ورموز الاستدلال والإخراج، ووضع المعالجة، ورسوم الأدوات. قارن التكلفة لكل مهمة مقبولة بدلًا من سعر الرموز المُخزَّنة وحده. تفيد السوابق الثابتة فقط عندما تصطدم الطلبات فعلًا بالتخزين المؤقت، ويمكن أن تعوض حلقات الأدوات الأطول أو المحاولات الفاشلة وفورات التخزين المؤقت.
كيف تختبر GPT-6.1 Sol قبل التحويل من GPT-6 Sol؟
استخدم مجموعة ثابتة من مهام تشبه الإنتاج وسجّل الإكمال الناجح، والتصحيحات الواقعية، واستدعاءات الأدوات غير الصالحة، وp50/p95 للكمون، والتكلفة الإجمالية. حدِّد حدود القبول قبل الاختبار. احتفظ بمسار رجوع للنموذج ووسّع الحركة فقط بعد أن يلبي التكوين الجديد تلك الحدود.
كيف تختبر GPT-6.1 Sol مع ملفات PDF؟
أنشئ مجموعة صغيرة تحتوي جداول كثيفة، وحواشي، ومخططات، وصفحات ممسوحة تماثل سير العمل المقصود. اطرح أسئلة بإجابات قابلة للتحقق واطلب دليلًا من الصفحة أو الجدول. قيّم دقة الحساب، والملاحظات المفقودة، والإجابات غير المدعومة بشكل منفصل؛ واحتفظ بمراجعة بشرية للمخرجات التي قد تكون لأخطائها تبعات مادية.