
الخلاصة
أطلقت OpenAI GPT-6.2 Astra في 17 نوفمبر 2026 بوصفه نموذجها الحدودي الجديد للعمل المهني المعقّد، والعمل الوكيلي، والعلمي، والقانوني، والتصميمي، والبرمجة. يقدّم مكاسب قابلة للقياس مقارنة بـ GPT-6 Astra (خصوصًا في المهام المهنية طويلة الأمد ومعايير العلوم) مع خفض أسعار الرموز القياسية في واجهة برمجة التطبيقات بنسبة 20% وتقليل التكلفة لكل مهمة أكثر عبر كفاءته الأعلى.
النموذج متاح عبر OpenAI API باسم gpt-6.2-astra، وفي ChatGPT Work/Codex، ومباشرة على CometAPI لإتاحة وصول موحّد وتنافسي التكلفة جنبًا إلى جنب مع أكثر من 500 نموذج آخر.
أبرز النقاط
- GPT-6.2 Astra هو فئة OpenAI الحدّية الحالية، مُحسّن لعمليات العمل المهنية الصعبة متعددة الخطوات، والبحث العلمي، والصياغة القانونية، وCAD/3D، والعروض التقديمية، والبرمجة الوكيلية.
- يحسّن الأداء مقارنة بـ GPT-6 Astra عبر معايير مهنية وعلمية رئيسية مع استخدام عدد أقل من رموز المخرجات، ما يقود إلى انخفاضات كبيرة في التكلفة الفعلية لكل مهمة.
- تسعير API القياسي: 8.00$ لكل مليون رمز إدخال، 0.40$ للإدخال المخزّن مؤقتًا، 40.00$ لكل مليون رمز إخراج (أقل بنسبة 20% من GPT-6 Astra في الإدخال/الإخراج؛ أقل بنسبة 60% في الإدخال المخزّن).
- درجة Artificial Analysis Intelligence Index: 62 (ثانيًا بعد Claude Fable 5.2 عند 65، ومتقدمًا على Gemini 4 Carbon وClaude Opus 5.5 في العديد من المقارنات).
- نافذة السياق: 1,050,000 رمز (922,000 كحد أقصى للإدخال / 128,000 كحد أقصى للإخراج).
- متاح بالفعل على CometAPI مع نقاط نهاية متوافقة مع OpenAI، ما يسمح للمطورين بتبديل النماذج بسطر واحد من الشفرة وغالبًا ما يحقق وفورات إضافية.
- موصى به لأنظمة الوكلاء الإنتاجية، وتوليد المستندات المهنية، وسير العمل العلمي، والبرمجة عالية المخاطر عندما تكون الكفاءة في التكلفة والقدرة مهمتين.
ما هو GPT-6.2 Astra؟
GPT-6.2 Astra هو أحدث نموذج استدلال حدّي من OpenAI، أُطلق في 17 نوفمبر 2026 إلى جانب نموذج GPT-6.2 Sol الأكثر كفاءة للاستخدام اليومي. يخلف GPT-6 Astra وموجّه صراحة لأصعب الأعمال المهنية والعمل الوكيلي طويل الأمد بدلًا من المحادثات العرضية.
تصفه OpenAI بأنه نموذج ينتج شرائح وعروضًا وجداول بيانات ومستندات ومواقع وتصميمات ثلاثية الأبعاد أنظف وأكثر التزامًا بالقوالب. يُظهر قوة خاصة في سير العمل المهني متعدد الخطوات، والبحث العلمي المعتمد على الطرفية، واستكمال التكليفات القانونية، ومهام CAD، والتقييمات المتعلقة بالأمن السيبراني (مع تطبيق ضوابط أكثر صرامة بسبب ارتفاع القدرات).
يدعم النموذج نافذة سياق كبيرة جدًا تبلغ 1,050,000 رمز، مع حدود موثّقة تقارب 922,000 رمز إدخال و128,000 رمز إخراج. تاريخ القطع المعرفي يُذكر أنه في منتصف مايو 2026. يقبل إدخالات نصية وصورية ومصمّم لاستخدام الأدوات، والمخرجات المهيكلة، والتخزين المؤقت للمحفزات، والحلقات الوكيلية.
الأهم أن الإطلاق يركّز على ChatGPT Work وCodex وواجهة البرمجة. لم يُضف إلى واجهة ChatGPT الاستهلاكية المجانية. غالبًا ما تتطلب مساحات Enterprise وEdu تمكينًا إداريًا.
الترقيات الرئيسية في GPT-6.2 Astra
يحسّن GPT-6.2 Astra نموذج OpenAI الرائد عبر العمل المهني، والبحث العلمي، والبرمجة، واستخدام الحاسوب. تجمع ترقياته الرئيسية بين أداء أقوى للمهام، وكفاءة رمزية أعلى، وأسعار API أقل، وضوابط نشر موسّعة.
1. مستندات وجداول وعروض مهنية أفضل
درّبت OpenAI GPT-6.2 Astra لإنتاج مخرجات أوضح تتبع الأعراف المهنية في المالية والمحاسبة والمبيعات والقانون. تشمل التحسينات المُعلن عنها مطابقة أدق لقوالب العروض، وتنظيمًا أفضل لجداول البيانات، وكتابة أكثر مباشرة.
على GDPval v2، التي تقيّم سير العمل المهني الطويل، يحسّن GPT-6.2 Astra الأداء بمقدار 6.2 نقطة مئوية مقارنة بـ GPT-6 Astra مع استخدام أقل بنسبة 22% من رموز المخرجات. بالنسبة للشركات، يجعله هذا جديرًا بالتقييم في دفاتر العمل المالية، ومذكرات الاستثمار، والعروض، والتقارير التفصيلية.
2. استدلال علمي أقوى وسير عمل بحثي
يحسّن Astra قدرته على أداء العمل العلمي باستخدام أدوات حسابية بدلًا من مجرد الإجابة عن أسئلة معرفية.
تفيد OpenAI بتحسّن قدره تسع نقاط مئوية مقارنة بـ GPT-6 Astra على Terminal-Bench-Science 0.1، بأقل من ثلث تكلفة المهمة المقاسة. كما تبلغ عن رقم قياسي جديد على Vals Science Index، الذي يقيم تفسير البيانات البيولوجية والاستدلال عبر تجارب محاكاة.
تدعم هذه النتائج اختبار GPT-6.2 Astra للبرمجة العلمية، وتحليل مجموعات البيانات، والبحث الحسابي. يظل التحقق الخبروي ضروريًا للاستنتاجات العلمية.
3.. أسلوب برمجي مُحسّن وتطوير تفاعلي ثلاثي الأبعاد
تفيد OpenAI بوجود شيفرة أنظف، واختبارات أكثر تركيزًا، وتنفيذ أقوى لتغييرات المستودعات المعقدة. كما يقدّم Astra أداءً جيدًا في مواقع الويب التفاعلية، والألعاب، والتجارب ثلاثية الأبعاد.
في تقييم AA-3D من Artificial Analysis، يحقق Astra 1,318 Elo مقارنة بـ 1,259 لـ GPT-6.2 Sol. يقيس هذا التقييم تفضيل البشر للتجارب التفاعلية المُولّدة.
تظل مكاسب البرمجة معتمدة على عبء العمل. تجد Artificial Analysis أن Astra دون تغيير مقابل GPT-6 Astra على Coding Agent Index باستخدام Codex harness عند أقصى جهد، لذا ينبغي للمطورين تقييم جودة التنفيذ وفهم المستودعات بشكل منفصل.
4. استخدام حاسوبي متقدم وتكامل أدوات
يدعم Astra سير العمل المعتمد على الأدوات عبر Responses API، بما في ذلك بحث الويب، وبحث الملفات، ومفسّر الشيفرة، وصدفة مستضافة، واستخدام الحاسوب، وMCP، وبحث الأدوات. كما توثق OpenAI نسخة تجريبية متعددة الوكلاء لتفويض العمل.
يسلط الإطلاق الضوء على تفاعل حاسوبي أدق في CAD والمحاكاة وسير عمل التصميم الميكانيكي. تعتمد هذه القدرات على الأدوات والأذونات التي يوفرها التطبيق.
بالنسبة لتكاملات CometAPI، تحقق من دعم كل نقطة نهاية وأداة مستضافة مطلوبة قبل النشر.
5. أسعار API أقل وكفاءة رمزية أفضل
مقارنة بـ GPT-6 Astra، تُخفض OpenAI أسعار رموز الإدخال والإخراج القياسية بنسبة 20%، بينما ينخفض تسعير الإدخال المخزّن مؤقتًا بنسبة 60%.
| فئة الرموز | السعر القياسي لدى OpenAI | السعر المُدرج لدى CometAPI |
|---|---|---|
| الإدخال | 8.00$ / مليون رمز | 6.40$ / مليون رمز |
| إدخال مخزّن | 0.40$ / مليون رمز | 0.32$ / مليون رمز |
| الإخراج | 40.00$ / مليون رمز | 32.00$ / مليون رمز |
تم التحقق من الأسعار في 19 نوفمبر 2026. هذه مقارنات معدلات سياق قصير؛ الطلبات طويلة السياق، والأدوات، وكتابات التخزين المؤقت، وطبقات المعالجة قد تغيّر التكاليف الإجمالية.
للفِرق التي تقارن Astra بنماذج أخرى، يقدّم CometAPI مسار تكامل متوافقًا مع OpenAI. قارن التكلفة الفعلية لكل نتيجة مقبولة إلى جانب أسعار الرموز.
6. ضوابط أمان موسعة ومراقبة للوكلاء
يقدم GPT-6.2 Astra ضوابط نشر أقوى مع قدراته المتزايدة. تصف OpenAI عدة تغييرات:
- قيود أمن سيبراني أكثر صرامة: يستوفي 6.2 Astra وSol عتبة OpenAI الحرجة للقدرات السيبرانية. يواجه الدعم الأعلى خطورة قيودًا افتراضية أشد، مع طلب تدقيق إضافي للوصول الأكثر سماحية.
- مراقبة وتدخل أوسع: وسّعت OpenAI مراقبة استدلال الوكلاء وأفعالهم. يتتبع Control Room الداخلي أعمال البحث ويمكنه إيقافها عند ظهور مخاوف أمان أو سلامة.
- عزل أقوى لبيئات البحث: يُعد GPT-6.2 Astra أول نموذج مُعلن خارجيًا يستوفي عتبة عالية لتحسين الذات بالذكاء الاصطناعي، ما يستلزم مزيدًا من العزل، والإشراف، وضوابط نشر مرحلية.
- حماية إضافية للاستدلال الخاص: عززت OpenAI حماية الاستدلال المُشفّر وفحوصات منع الاستخراج غير المصرح به. نجحت محاولات استخراج حمراء تكيفية بأقل من 1% من الوقت تحت الظروف المختبرة.
لا يزال التقدم في الأمان غير متساوٍ. تفيد OpenAI بأن النماذج أغفلت عقبات معروفة في بعض التقييمات، رغم أن تعليمات مطوري Codex قلّصت تلك الإغفالات بشكل كبير. لذلك يجب أن تتطلب التطبيقات تقارير صريحة عن الملفات أو الأدوات أو المصادر غير المتاحة.
أداء GPT-6.2 Astra**: مكاسب دون فوز شامل**
ملف مؤشرات GPT-6.2 Astra قوي بشكل خاص في البحث العلمي، والوكلاء المهنيين، وتوليد التجارب التفاعلية ثلاثية الأبعاد. تجمع الأرقام أدناه نتائج إطلاق OpenAI مع تقييمات مستقلة. لا ينبغي اعتبارها ناجمة عن منهجية اختبار واحدة.
تحليل يوم الإطلاق من Artificial Analysis يضع GPT-6.2 Astra في المركز الثاني على Intelligence Index، خلف Claude Fable 5.2، مع تحسن خمس نقاط مقارنة بـ GPT-6 Astra. يحصل Sol على نقطتين إلى 57، مساويًا GPT-6 Astra عند نحو 15% من تكلفته المقاسة لكل مهمة.
يشير التحليل نفسه إلى نقطة يجب أن يضعها المطورون في الاعتبار: GPT-6.2 Astra ثابت مقابل GPT-6 Astra على Coding Agent Index باستخدام Codex harness عند أقصى جهد. ينخفض Sol ثلاث نقاط مقابل GPT-6.1 Sol، مدفوعًا بانخفاض 14 نقطة على SWE-Atlas-QnA-AA حيث يغفل الحقائق الأساسية أكثر.
بطاقة تقييم Epoch AI للنموذج تُدرج Astra بشكل مستقل عند 174 ECI، متعادلًا مع Claude Fable 5.2، مقابل 169 لـ GPT-6 Astra. تعكس التصنيفات المختلفة مجموعات تقييم مختلفة.
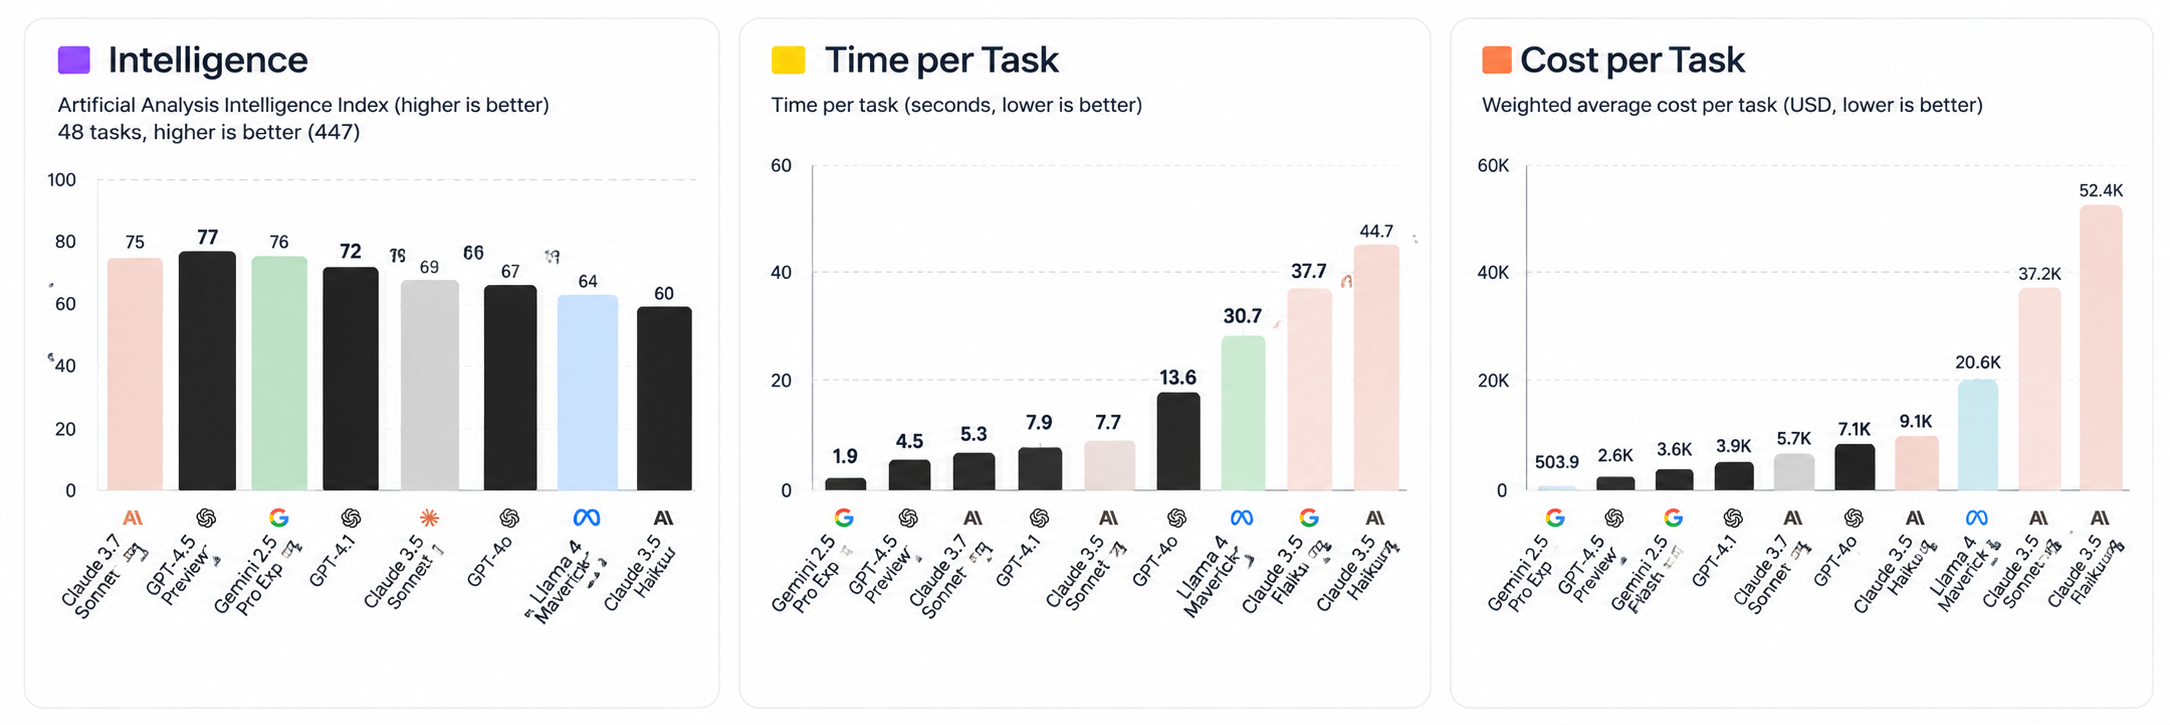
1. Artificial Analysis Intelligence Index
62.1 نقطة
تفيد Artificial Analysis بدرجة تقارب 62 لـ GPT-6.2 Astra عند أقصى جهد استدلال على Intelligence Index v5.0.1، ما يضعه ثالثًا في ترتيب النموذج الحالي.
يجمع المؤشر تسعة تقييمات تغطي أعمال المعرفة المهنية، والبرمجة، والعلوم، والاستدلال العام. تشمل معاييره Terminal-Bench 4.0، وFrontierCode-AA 2.0، وAA-Briefcase، وGDP.pdf، وHLE-Diamond.
هذا مقياس عام مفيد، لكنه لا يعني أن Astra يتصدر كل مكوّن.
2. Terminal-Bench-Science 0.1
78.6% عند Xhigh
Terminal-Bench-Science يقيّم مدى قدرة النماذج على تنفيذ سير عمل بحثي علمي في بيئة طرفية.
تفيد Artificial Analysis بشكل مستقل:
| جهد استدلال GPT-6.2 Astra | الدرجة |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
تضع هذه النتائج Astra في قمة لوحة المتصدرين الحالية لدى Artificial Analysis لهذا التقييم. يهمّ التمييز بين Xhigh وMax: ليست أعلى درجة بالضرورة من الإعداد الأكثر استهلاكًا للحوسبة.
3. Vals Science Index
68.44% · المرتبة الأولى
يقيم Vals Science Index قدرات البحث العلمي عبر التحقيق في البيانات البيولوجية، واكتشاف الآليات، وسير العمل العلمي القائم على الطرفية.
لوحة Vals AI، محدّثة في 16 نوفمبر 2026
| النموذج | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
تُعد نتيجة Astra مهمة بشكل خاص لوكلاء البحث العلمي لأن الفهرس يجمع مهام علمية متعدّدة بدلًا من الاعتماد على معيار سؤال-وجواب واحد.
4. AA-3D: توليد تجارب تفاعلية ثلاثية الأبعاد
1,318 Elo · المرتبة الأولى
يقيس AA-3D، الذي طورته Artificial Analysis، مدى جودة تحويل النماذج للتعليمات المكتوبة إلى تجارب ويب تفاعلية ثلاثية الأبعاد. يقارن مقيمون بشريون بين تجربتين منشأتين من نموذجين عبر تصويت مزدوج أعمى.
| النموذج | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
هذه نتيجة ملحوظة للتصميم التفاعلي، وتوليد الواجهات الأمامية، والتصوّر ثلاثي الأبعاد. يتقدم Astra على Claude Fable 5.2 بمقدار 47 نقطة Elo.
تحتاج نتيجة AA-AnalystAgent إلى تفسير حذر مماثل: 62.5% تشير إلى الأسئلة المُجاب عنها بشكل صحيح في جميع المحاولات الخمس، بدلًا من دقة محاولة واحدة عادية. وبالمثل، يقيس فرق Elo في AA-3D التفضيل النسبي؛ ولا يمكن قراءته كنسبة تحسن في جودة التصميم.
5. نتائج OpenAI في المعايير المهنية والوكيلة
تفيد OpenAI أيضًا بنتائج قوية في تقييمات أعمالها المهنية.
| المعيار | نتيجة GPT-6.2 Astra | المقارنة |
|---|---|---|
| Agents' Last Exam | 5.2 نقاط فوق GPT-6 Astra | أقل من ثلث تكلفته لكل مهمة |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | صحيح في جميع المحاولات الخمس المستقلة في مهمة دفتر العمل المبرزة |
| Harvey LAB-AA v1.1 | 15.0% | أكثر من ضعفي معدل النجاح المبلغ عنه لـ Claude Fable 5.2 |
يعد Agents’ Last Exam ذا صلة خاصة بالمنظمات التي تشتري أعمالًا مكتملة. كما تفيد OpenAI بأن GPT-6.2 Astra سجّل 5.5 نقاط فوق Claude Fable 5.2 عند نحو 5% من تكلفته لكل مهمة. تستثني المقارنة تسع مهام Fable استخدمت نماذج بديلة، وهي تفاصيل منهجية ينبغي أن ترافق العنوان.
تشير هذه النتائج إلى تحسينات في التنفيذ الوكيلي المهني، والتحليل المالي، والعمل على المستندات القانونية. ومع ذلك، فإن GDPval v2 هو تقييم داخلي لدى OpenAI، بينما تستخدم تقييمات AA-AnalystAgent وHarvey تعريفاتها وقواعدها الخاصة للمهام.
ماذا تخبرنا المعايير فعليًا؟
ثلاث خلاصات بارزة:
- العلم قوة رئيسية. يتصدر Astra Vals Science Index وTerminal-Bench-Science، ما يجعله مرشحًا قويًا لسير العمل البحثي الحسابي.
- التنفيذ الوكيلي المهني هو تحسين رئيسي. تشير نتائج GDPval v2 وAgents' Last Exam إلى أداء أقوى في المهام طويلة الأمد.
- الإبداع البصري والتفاعلي فارق مميز. تُظهر نتيجة AA-3D أن قوة Astra تمتد إلى ما بعد الاستدلال النصي التقليدي والبرمجة.
تحذير مهم: ليست كل مقارنات إطلاق OpenAI اختبارات مستقلة. لتوثيق مستقل، يوفر Artificial Analysis وVals AI أدلة إضافية مفيدة. كما أن درجة الذكاء العامة القوية لـ Astra لا تجعله تلقائيًا الخيار الأفضل لكل معيار برمجي أو الأقل تكلفة لكل عبء عمل.
GPT-6.2 Astra مقابل GPT-6 Astra (ونماذج سابقة ذات صلة)
ملاحظة حول التسمية: يُشار إلى النموذج الحدّي السابق من OpenAI باسم GPT-6 Astra. تشير تقارير إلى أن إصدار GPT-6.1 Astra قد أُلغي أو تأخر لأسباب أمان قبل إصدار 6.2.
| الجانب | GPT-6 Astra (السابق) | GPT-6.2 Astra | ملاحظات / أفضلية |
|---|---|---|---|
| الإطلاق | ~سبتمبر 2026 | 17 نوفمبر 2026 | أحدث |
| API إدخال / إخراج | 8$ / 40$ لكل مليون رمز | 10$ / 50$ (Astra) | خفض 20% لـ Astra |
| إدخال مخزّن / مليون رمز | 1.00$ | 0.40$ | أرخص بنسبة 60% |
| نافذة السياق | ~922k–1.05M | 1,050,000 (922k حد أقصى إدخال / 128k حد أقصى إخراج) | متشابه / موضّح |
| Agents’ Last Exam | ~73.1% | ~78.3% | مكسب واضح + تكلفة مهمة أقل بكثير |
| Terminal-Bench Science | خط أساس | +~9 نقاط | تحسن علمي قوي |
| AA Intelligence Index | ~57 | 62 | قفزة تنافسية |
| تكلفة لكل مهمة (أمثلة) | أعلى | غالبًا <1/3 على مخططات OpenAI؛ 36–50% أقل في اختبارات مستقلة | مكسب كفاءة كبير |
| كفاءة رموز الإخراج | خط أساس | رموز أقل في العديد من المهام | يضخّم الوفورات |
| الضوابط | أشد في السايبر عالي المخاطر | المستوى السابق | استجابة لقدرات أعلى |
| Ultrafast | توفر موسع | أكثر محدودية | Pro 200 يحصل الآن على Sol Ultrafast |
يحافظ GPT-6.2 Sol (النموذج المرافق للاستخدام اليومي) على تسعير أقل (2$ / 10$) ويقترب من Astra في العديد من مهام البرمجة عند نحو خمس التكلفة، ما يجعله الخيار العملي الافتراضي للعمل مرتفع الحجم.
GPT-6.2 Astra مقابل GPT-6 Astra: يقدّم Astra 6.2 أداءً مُعلنًا أفضل في سير العمل المهني والبحث العلمي، مع خفض أسعار رموز الإدخال والإخراج القياسية بنسبة 20%. يحصل الإدخال المخزّن على خصم أعمق.
GPT-6.2 Astra مقابل Claude Fable 5.2: يسجّل Fable 5.2 درجة أعلى على Artificial Analysis Intelligence Index، بينما يتصدر Astra Vals Science Index وAA-3D. يذكّر هذا بأن اختيار النموذج يجب أن يعتمد على عبء العمل، لا على لوحة ترتيب واحدة.
كيفية الوصول إلى GPT-6.2 Astra
قنوات OpenAI الرسمية
- ChatGPT Work وCodex (لمستخدمي Plus وPro وEnterprise وEdu؛ قد يتطلب تمكينًا إداريًا لمساحات العمل).
- OpenAI API باستخدام معرّف النموذج
gpt-6.2-astra. يتوفر Ultrafast تحت خطط Pro معينة وعبر API.
عبر CometAPI (موصى به للعديد من المطورين والفِرق)
أضافت CometAPI GPT-6.2 Astra وGPT-6.2 Sol في أو حوالي 18 نوفمبر 2026 (معرّفات النماذج: gpt-6.2-astra وgpt-6.2-sol).
توفّر CometAPI:
- نقطة نهاية واحدة متوافقة مع OpenAI ومفتاح API لأكثر من 500 نموذج (OpenAI وAnthropic وGoogle وغيرها).
- أسعار تنافسية غالبًا أقل بنسبة 20–40% من أسعار المورّد الرسمية.
- لا حاجة لإدارة مفاتيح مزودين متعددين أو إعادة كتابة كود التكامل عند تبديل النماذج.
- دعم لكل من صيغ Chat Completions وResponses API.
- أهداف موثوقية عالية وهجرة بسيطة (غيّر فقط
base_urlوapi_keyفي SDK الخاص بـ OpenAI). - مثال انطلاق سريع (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
يجعل هذا CometAPI جذابًا بشكل خاص للفِرق التي ترغب في أداء حدّي اليوم، والقدرة على اختبار A/B مقابل Claude Fable وGemini وGrok أو نماذج أخرى، والتحكم المستمر بالتكلفة دون قفل مزوّد. اشترك عبر CometAPI.com للحصول على أرصدة مجانية ووصول فوري.
توصيات عملية
- استخدم GPT-6.2 Astra لأصعب المشاريع المهنية متعددة الخطوات، والبحث العلمي، والصياغة القانونية/المالية عالية المخاطر، والتشغيل الوكيلي المعقّد، وتوليد المستندات المرئية/المهنية حيث تهم الجودة والموثوقية.
- اجعل GPT-6.2 Sol الافتراضي (أو وجّه بذكاء) لأحجام البرمجة العالية، وحلقات الوكلاء اليومية، وأعباء العمل الحساسة للتكلفة — غالبًا ما يقدّم نتائج قريبة من Astra بجزء بسيط من السعر.
- استفد من التخزين المؤقت للمحفزات واحفظ مقدمات النظام/المحفز مستقرة لتعظيم سعر الإدخال المخزّن المنخفض جدًا.
- راقب الميل الموثّق في بعض التقييمات لإغفال العوائق؛ صمّم أطر الوكلاء بخطوات تحقق صريحة عند التشغيل غير المُراقَب.
- لتحقيق مرونة متعددة المزوّدين وفورات محتملة إضافية، وجّه عبر CometAPI.
الخلاصة
يمثّل GPT-6.2 Astra خطوة ذات معنى على حدود التكلفة-القدرة للعمل المهني والوكيلي. يجمع بين درجات أعلى على معايير طويلة الأمد ومعايير العلوم، وانخفاض كبير في أسعار الرموز، وكفاءة رمزية محسنة، ما يجعله من أقوى الخيارات العملية المتاحة في أواخر 2026.
سواء وصلت إليه مباشرة من OpenAI أو عبر بوابة موحّدة مثل CometAPI، فإن النموذج جاهز للإنتاج لتطبيقات العالم الحقيقي المتطلبة. ستستخلص الفرق التي تقارن بين Astra وSol، وتقيس تكلفتها لكل مهمة، وتضع إشرافًا مناسبًا، أكبر قيمة ممكنة.

