
الخلاصة
DeepSeek-V4.1-Flash مفتوح الأوزان ويمكن تشغيله ذاتيًا، لكن "محلي" لا يعني "على حاسوب ألعاب". تصف DeepSeek النموذج بأنه عمود فقري Mixture-of-Experts بعدد 552B من المعاملات باستخدام عمارة Causal Encoder-Decoder، مع 8B معاملات نشطة أثناء معالجة المُدخلات و16B أثناء التوليد. يظل النموذج الكامل هدفًا للنشر على مستوى الطليعة.
وصفة النشر الحالية عبر vLLM تضع نقطة التحقق عند حوالي 511 GB على القرص وقرابة 614 GB كحد أدنى من VRAM، ما يجعل خادمًا من فئة 8×H200 أو نظامًا بذاكرة عالية أكثر واقعية بكثير من محطة عمل للمستهلكين.
بالنسبة للفرق التي تحتاج الوصول دون التحكم بمستوى الأوزان، فإن DeepSeek V4.1 Flash API في CometAPI أبسط بكثير من إدارة خادم استدلال متعدد وحدات GPU.
النقاط الأساسية
- يستخدم DeepSeek-V4.1-Flash عمودًا فقريًا MoE بسعة 552B، مع 8B معاملات نشطة أثناء التمهيد و16B أثناء فك الترميز؛ المعاملات النشطة لا تمثل متطلبات الذاكرة المُقامة.
- نافذة السياق 1,048,576 رمزًا وذاكرة KV العالمية 890 بايت/رمز تقللان ضغط الذاكرة المؤقتة، لكن أوزان النموذج لا تزال تهيمن على تخطيط السعة.
- نقطة التحقق الرسمية حوالي 511 GB على القرص. تقدّر وصفة vLLM قرابة 614 GB من VRAM المجمّعة القابلة للاستخدام كميزانية حد أدنى لتحميل النموذج ونفقات وقت التشغيل؛ هذا تقدير أساسي، وليس ضمانًا لكل حجم دفعة، أو طول سياق، أو إعداد متعدد الوسائط.
- vLLM هو أوضح مسار لخدمة الإنتاج، بينما يستهدف SGLang الاستدلال الموزع المتقدم؛ مسار Ollama الحالي مستضاف سحابيًا بدل الاستدلال المحلي الكامل.
- الاستضافة الذاتية جذابة خصوصًا للخصوصية، التشغيل المعزول (air-gapped)، البحث على مستوى الأوزان، أو الاستفادة المستدامة للعنقود؛ معظم المطورين سيجدون واجهة API المستضافة أبسط.
ما هو DeepSeek-V4.1-Flash؟ العمارة، المعاملات، وحجم النموذج
أصدرت DeepSeek رسميًا V4.1-Flash في 10 سبتمبر 2026 كأصغر نموذج في عائلة العمارة الجديدة، مع فهم بصري أصيل. رغم اسم "Flash"، فهو ليس نموذجًا كثيفًا صغيرًا.
التغيير المعماري الأساسي هو تصميم Causal Encoder-Decoder (CED). يقسم النموذج الحوسبة بشكل غير متناظر بين ابتلاع المِحفّز وتوليد الرموز، ما يقلل الحوسبة النشطة مع الاحتفاظ بمجمّع خبراء كبير جدًا.
| المواصفة | DeepSeek-V4.1-Flash |
|---|---|
| العمارة | MoE متعدد الوسائط مع Causal Encoder-Decoder |
| معاملات العمود الفقري | 552B |
| المعاملات النشطة، الإدخال | 8B |
| المعاملات النشطة، الإخراج | 16B |
| طبقات المحول | 40: 20 مُشفّر + 20 مُفكك |
| نافذة السياق | 1,048,576 رمزًا |
| ذاكرة KV العالمية | 890 بايت/رمز |
| الوسائط | نص + إدخال صورة، إخراج نص |
| ترخيص الأوزان | MIT |
| أخذ العينات الموصى به | الحرارة 1.0؛ top_p 0.95 أو 1.0 |
| الأوزان الرسمية | Hugging Face |
| خيارات الخدمة المحلية الأساسية | vLLM، SGLang، مرجع الاستدلال من DeepSeek |
التمييز بين المعاملات النشطة والمعاملات المُقيمة أساسي. يقلل توجيه MoE مقدار الحوسبة المستخدمة لكل رمز، لكن الخادم لا يزال بحاجة إلى الوصول إلى أوزان الخبراء التي يمكن اختيارها. لهذا السبب يمكن لنموذج "8B نشطًا" أن يتطلب رغم ذلك مئات الجيجابايت من التخزين وذاكرة المسرّع.
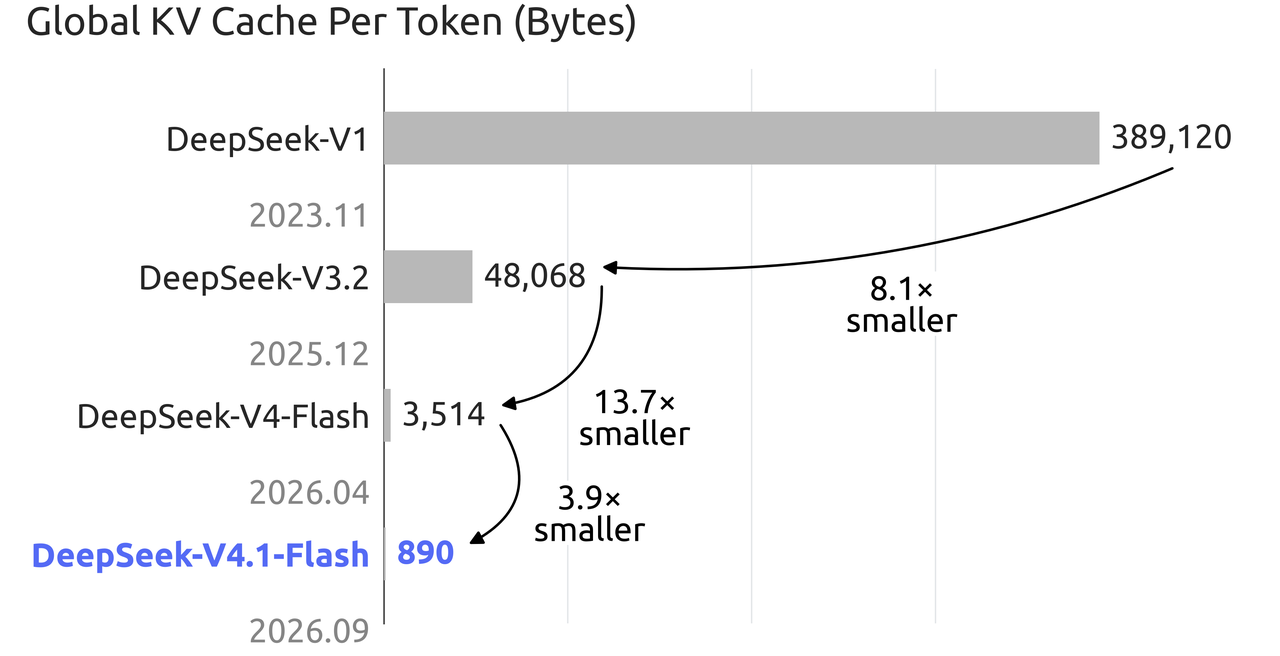
تُظهر مخططات DeepSeek الرسمية لذاكرة KV أن الذاكرة العالمية انخفضت من 3,514 بايتًا لكل رمز في V4 Flash إلى 890 بايتًا لكل رمز في V4.1 Flash، أي انخفاض بحوالي 3.9×. هذا مهم لاستدلال بمليون رمز، لكنه لا يلغي متطلبات الذاكرة الأكبر بكثير التي تخلقها أوزان النموذج نفسها.
ما مدى جودة DeepSeek-V4.1-Flash قبل نشره؟
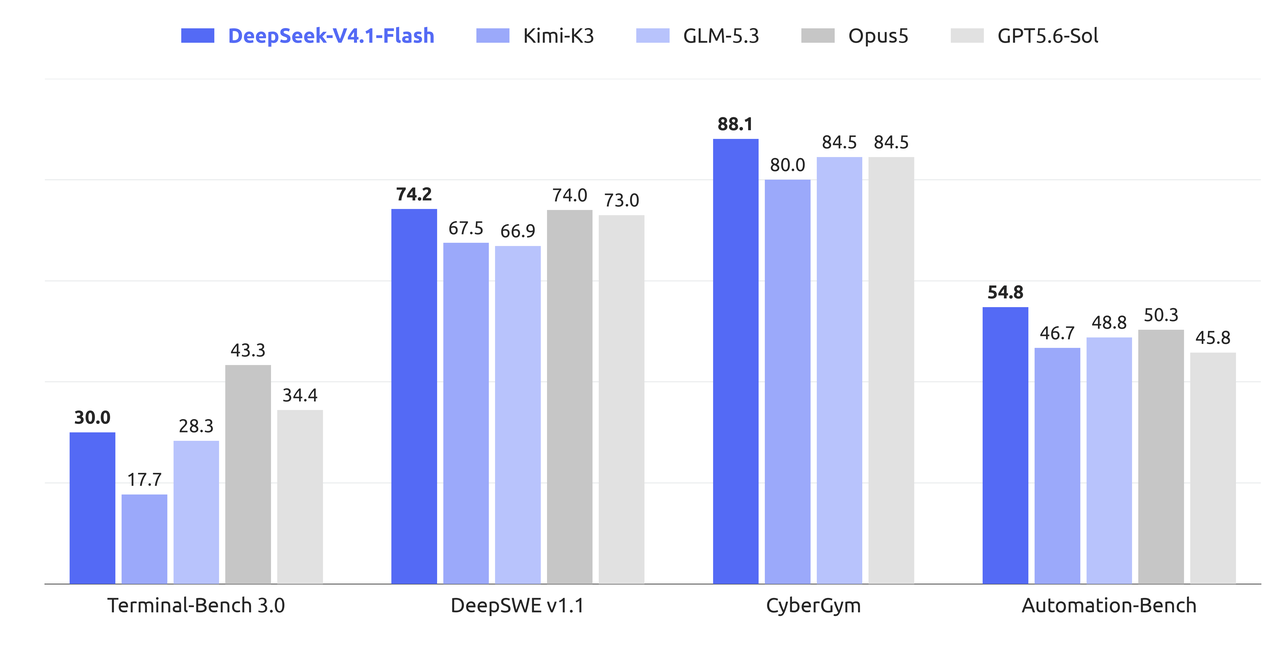
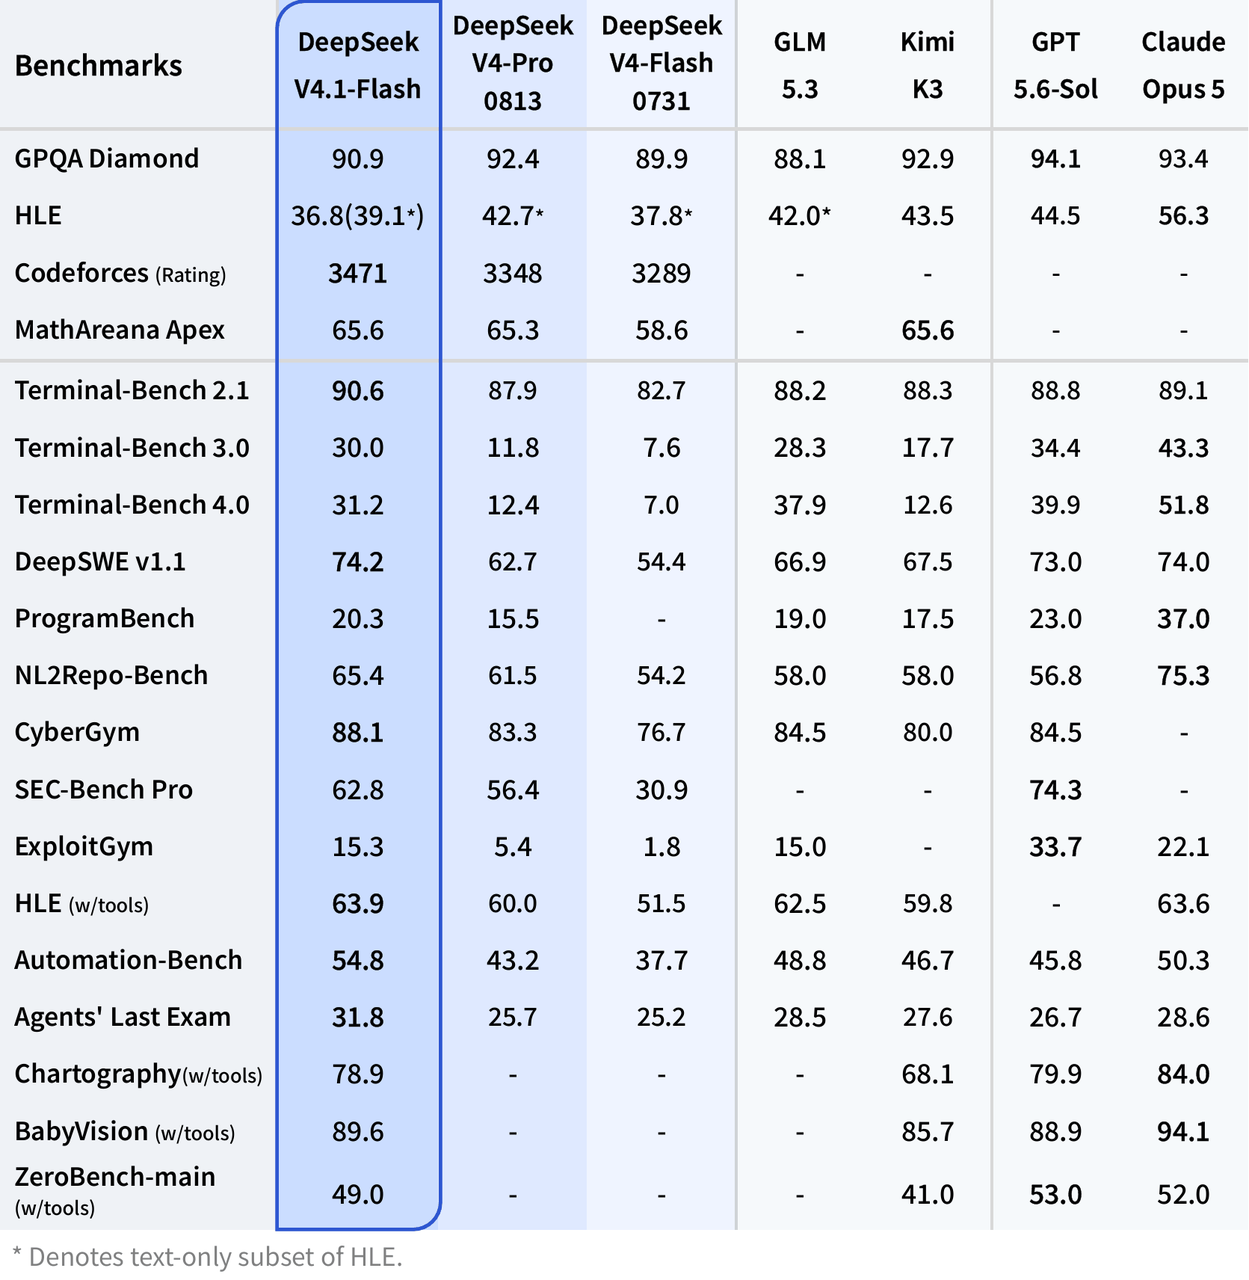
تضع جداول القياس المنشورة من DeepSeek V4.1-Flash أساسًا كترقية كبيرة في الترميز العامل (agentic coding)، تشغيل الطرفية، الأتمتة، وأعباء عمل هندسة البرمجيات. هذه نتائج قياس مُعلن عنها من المورد، لذا يجب التعامل معها كقياسات مرجعية لا كضمانات أداء تطبيقية.
لإعادة الإنتاج، توصي بطاقة النموذج الرسمية بالحرارة 1.0 وtop_p 0.95، بينما تختلف جهود التفكير وميزانيات الرموز حسب التقييم. الأرقام أدناه هي نتائج مرجعية مُشغلة من المورد، وليست ضمانات أداء محايدة العتاد؛ يجب الرجوع إلى تفاصيل أطر القياس المحددة قبل إعادة إنتاجها.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
النمط أهم من أي نتيجة مفردة. لا يتصدر V4.1-Flash كل قياس، لكن القفزة من V4 Flash 0731 كبيرة بشكل خاص في Terminal-Bench وDeepSWE والأتمتة وأعباء الأمن السيبراني. يجعل هذا النشر المحلي ذا صلة خاصة لوكلاء الترميز الخاصين، تحليل بمقياس المستودعات، الأتمتة الداخلية، وبنية تحتية للوكلاء معزولة (air-gapped).
هل يمكنك فعلًا تشغيل DeepSeek-V4.1-Flash محليًا؟
نعم، لكن كلمة "محليًا" تحتاج إلى تأهيل. تفكك وصفة vLLM الأخيرة لـ DeepSeek-V4.1-Flash نقطة التحقق عند نحو نصف تيرابايت وتوصي بميزانية VRAM أكبر بكثير بمجرد احتساب نفقات وقت التشغيل.
| المكوّن | الحجم المخزّن التقريبي |
|---|---|
| خبراء Routed + DSpark | 259.5 GiB |
| جداول Engram | 183.1 GiB |
| الانتباه، الإسقاطات الكثيفة والموجّهات | 6.9 GiB |
| التضمينات، رأس LM والمعايير | 3.9 GiB |
| UE8M0 block scales | 21.9 GiB |
| نقطة التحقق الكاملة | ~476 GiB / ~511 GB |
| ميزانية VRAM الدنيا الموصى بها من vLLM | ~614 GB |
المفاجأة الأساسية أن V4.1-Flash مضغوط داخليًا بالفعل. تستخدم أوزان الخبراء الموجّهين دقة منخفضة، لذا ليست نقطة التحقق الرسمية مجرد نموذج BF16 ضخم بانتظار تحويل 4-bit سهل.
متطلبات عتاد DeepSeek-V4.1-Flash
| تكوين العتاد | الحالة العملية | التعليقات |
|---|---|---|
| 1× RTX 4090 / 5090 | لا | أقل بكثير من بصمة ذاكرة النموذج |
| 2–4 وحدات GPU للمستهلكين | لا لنقطة التحقق الرسمية الكاملة | VRAM المجمّع يظل غير كافٍ |
| محطة عمل 128 GB | لا | المعاملات النشطة لا تحدد ذاكرة الأوزان المُقيمة |
| محطة عمل 256 GB | لا لمسار الخدمة الرسمي | لا تزال أقل بكثير من بصمة نقطة التحقق الرسمية |
| 512 GB RAM + إزاحة إلى GPU | تجريبي | مجال المجتمع/الإزاحة، ليس مكافئًا لخدمة إنتاج مُتحقَّق منها |
| 4× وحدات GPU ذاكرة عالية | يعتمد على العتاد | ممكن مع مسرّعات حديثة كبيرة بما يكفي؛ تحقق من وصفة وقت التشغيل |
| 8× H200 | نعم، فئة موثّقة | حوالي 1,128 GB من HBM المجمّعة |
| نظام من فئة GB200 NVL4 | نعم | تشير vLLM إلى أن درج 768 GB يستوعب النموذج |
مهم: 8B معاملات نشطة لا يعني 8 GB من VRAM. "نشطة" تصف مقدار الشبكة التي تشارك في حوسبة رمز ما. مجموعة الخبراء الكاملة لا بد أن تُخزن في مكانٍ ما متاح لمحرك الاستدلال.
أي وقت تشغيل ينبغي استخدامه لـ DeepSeek-V4.1-Flash؟
| وقت التشغيل | حالة V4.1-Flash الحالية | أفضل استخدام |
|---|---|---|
| vLLM | وصفة نشر حالية متاحة؛ تتطلب صورة حديثة | خدمة إنتاج متوافقة مع OpenAI |
| SGLang | مدعوم عبر بنى نشر DeepSeek-V4.1 الحالية | استدلال موزع عالي الأداء |
| مرجع الاستدلال من DeepSeek | تنفيذ TP8 مرجعي رسمي | بحث العمارة والتحقق |
| Transformers | تكامل النموذج مكشوف على Hugging Face | التطوير والتجربة؛ العتاد لا يزال مطلوبًا |
| Ollama | المسار الرسمي يستخدم :cloud حاليًا | استدعاء سحابي مريح، ليس مكافئًا للاستضافة الذاتية |
للخدمة الذاتية الإنتاجية، vLLM هو حاليًا نقطة الانطلاق الأوضح. يقدم دليل نشر SGLang مسارًا مدعومًا آخر للاستدلال الموزع المتقدم.
كيفية تشغيل DeepSeek-V4.1-Flash محليًا باستخدام vLLM
هذا هو المسار العملي لخادم Linux متعدد وحدات GPU.
كل أمثلة الأوامر أدناه أعيد تنسيقها ككتل كود خاصة باللغة مع أوصاف إنجليزية موجزة.
الخطوة 1: تحقق من بيئتك
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- عدة مئات من الجيجابايت من مساحة SSD الحرة.
- تكوين متعدد وحدات GPU مدعوم.
- قرابة 614 GB من ذاكرة المسرّع المجمّعة القابلة للاستخدام لملف الأوزان الرسمي الحالي.
- شبكة سريعة إذا لم يكن النموذج مخزنًا مؤقتًا محليًا.
الخطوة 2: نزّل أوزان DeepSeek-V4.1-Flash
تستضيف الأوزان الرسمية في مستودع Hugging Face الخاص بـ DeepSeek-V4.1-Flash تحت ترخيص MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
تأكد من أن نظام الملفات الذي يحتوي على ~/.cache/huggingface لديه مساحة حرة أكثر بكثير من 511 GB. قد تزيد الملفات المؤقتة والقطع الإضافية للمحرك من أقصى استخدام للقرص.
الخطوة 3: ابدأ DeepSeek-V4.1-Flash مع vLLM
بحسب وصفة vLLM الحالية، يتطلب دعم DeepSeek-V4.1 صورة vLLM حديثة بما يكفي. قد يبدو تكوين بداية نصي فقط مع ثماني وحدات GPU كما يلي:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
هناك خياران مقصودان هنا. أولًا، --language-model-only يعطّل المُشفّر البصري لأعباء العمل النصية فقط. ثانيًا، البدء عند 131,072 رمزًا أكثر أمانًا من تمكين نافذة المليون رمز مباشرة. بمجرد استقرار الخادم، يمكنك زيادتها:
--max-model-len 1048576
يعتمد إعداد التجزئة الموازية (tensor-parallel) المناسب على طوبولوجيا المسرّع، لذا لا تنسخ --tensor-parallel-size 8 على كل خادم دون تحقق.
الخطوة 4: اختبر واجهة DeepSeek-V4.1-Flash المحلية
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
الخطوة 5: استدعِ خادم DeepSeek-V4.1-Flash المحلي عبر Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
كيف تمكّن وضع التفكير في DeepSeek-V4.1-Flash محليًا؟
يدعم V4.1-Flash عناصر تحكم تفكير صريحة عبر قالب الدردشة. مثال:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
إذا بدا أن النموذج يُرجع القليل من المحتوى النهائي أو لا يُرجع شيئًا مع قيمة max_tokens صغيرة، فتحقق مما إذا كان وضع التفكير يستهلك ميزانية التوليد قبل افتراض أن النشر معطّل.
كيف تشغّل DeepSeek-V4.1-Flash عبر الكود المرجعي؟
تتضمن DeepSeek أيضًا تنفيذ استدلال TP8 مصغرًا داخل مستودع النموذج. يُقصد به أساسًا ككود مرجعي مقروء بدل خادم إنتاج عالي الإنتاجية.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
هذا المسار مفيد لفحص CED، توجيه MoE، ذاكرة Engram، الترميز المضاربي، وتفاصيل التنفيذ ذات الصلة. بالنسبة لخدمة الإنتاج العادية، vLLM أو SGLang أسهل تشغيلًا.
هل يمكنك تشغيل DeepSeek-V4.1-Flash محليًا باستخدام Ollama؟
ليس بنفس معنى تشغيل نموذج Ollama عادي 7B أو 32B. يعرض Ollama حاليًا V4.1-Flash عبر:
ollama run deepseek-v4.1-flash:cloud
الجزء المهم هو :cloud. يستخدم الإدخال الحالي لمكتبة Ollama مسارًا سحابيًا، لذا هذا الأمر لا يكافئ تنزيل الأوزان الكاملة وإجراء الاستدلال كليًا على جهازك.
نشر DeepSeek-V4.1-Flash محليًا مقابل API: أيهما أنسب؟
| البُعد | DeepSeek-V4.1-Flash محليًا | API مستضاف |
|---|---|---|
| عتاد مبدئي | مرتفع جدًا | لا شيء |
| ذاكرة المسرّع | ~614 GB هدف رسمي عملي | مُدارة من المزود |
| التحكم بالنموذج | كامل | محدود |
| بقاء البيانات محليًا | نعم | لا |
| تعديل الأوزان | نعم | لا |
| الصيانة | مسؤوليتك | مُدارة من المزود |
| تعقيد الإعداد | مرتفع | منخفض |
| التحجيم | يتطلب بنية تحتية | قائم على API |
| الأنسب لـ | بيئات معزولة، خصوصية، بحث، عناقيد عالية الاستفادة | معظم المطورين وتطبيقات الإنتاج |
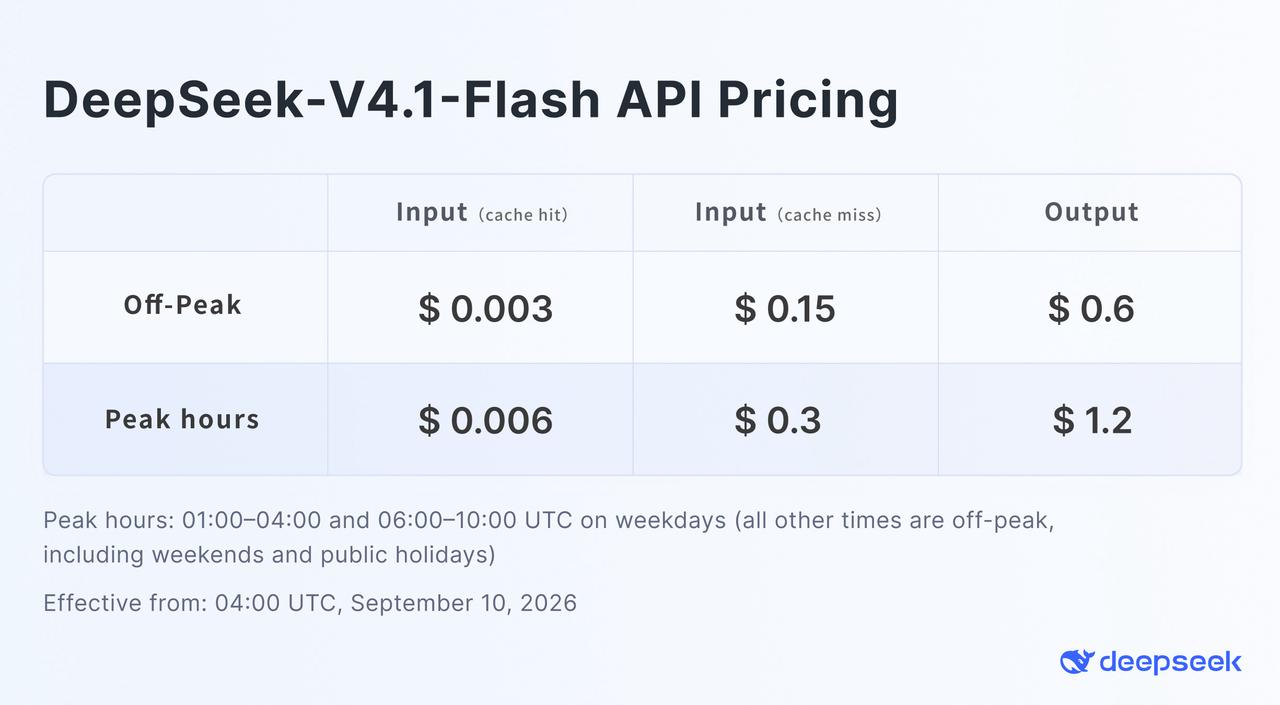
تعرض DeepSeek أسعار خارج الذروة في رسم تسعير V4.1-Flash. للمطورين الذين لا يحتاجون الحيازة الفيزيائية للأوزان، يوفر DeepSeek V4.1 Flash API في CometAPI بديلاً متوافقًا مع OpenAI دون الحاجة لتحويل الخدمة إلى مشروع بنية تحتية كبيرة.
المثال التالي يستخدم معرّف نموذج CometAPI. ليس هو المعرّف المستخدم في API الرسمي لـ DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
القرار العملي واضح: يصبح النشر المحلي جذابًا عندما تفوق الخصوصية، التشغيل المعزول، التجارب على مستوى الأوزان، الاستفادة الثقيلة المتوقعة، أو المتطلبات التنظيمية تكلفة البنية التحتية. بالنسبة لتطوير التطبيقات العادي، يجنّبك الطرف المستضاف إدارة مئات الجيجابايت من النموذج وأتمتة وحدات GPU متعددة.
ما المشاكل التي قد تواجهها عند تشغيل DeepSeek-V4.1-Flash محليًا؟
ينفد الخادم من الذاكرة قبل بدء التوليد
تحدد نقطة التحقق الكاملة، وليس أرقام 8B/16B للمعاملات النشطة، معظم متطلبات الذاكرة. تحقق من التجزئة الموازية، استخدام ذاكرة GPU، تحميل الرؤية، وHBM المتاح.
يستغرق DeepSeek-V4.1-Flash وقتًا طويلًا ليبدأ
تتطلب نقطة تحقق بنصف تيرابايت وقتًا للتنزيل، والتهيئة، والتقسيم. أزمنة الانتظار الطويلة لاستعداد المحرك طبيعية لهذه الفئة من النماذج.
الاستجابة فارغة أو تنتهي بـ finish_reason=length
قد يستهلك وضع التفكير ميزانية التوليد. زِد max_tokens، خفّض جهد التفكير، أو عطّل التفكير للطلبات البسيطة.
لا تُحل مكالمات الأدوات بشكل صحيح
تأكد من أن الخادم يستخدم مُجزّئ DeepSeek V4.1، ومحلّل مكالمات الأدوات، ومحلّل التفكير، وأعلام الاختيار التلقائي للأدوات.
لا يعمل إدخال الرؤية
إذا بدأت مع --language-model-only، فقد عطّلت عمدًا المُشفّر البصري. أعد التشغيل مع تمكين دعم الوسائط المتعددة قبل اختبار الصور.
هل ينبغي لك تشغيل DeepSeek-V4.1-Flash محليًا؟
يعد DeepSeek-V4.1-Flash مثيرًا للاهتمام بشكل غير معتاد من منظور الاستضافة الذاتية لأن عماريته تقلل بشكل كبير من الحوسبة لكل رمز وكلفة ذاكرة KV، لكنها لا تحول نموذجًا مفتوح الأوزان على مستوى الطليعة إلى نموذج لسطح المكتب.
بالنسبة لمختبر بحثي، منصة مؤسسية للذكاء الاصطناعي، مكدس وكلاء ترميز خاص، أو بيئة معزولة (air-gapped)، يجعل vLLM وSGLang الاستضافة الذاتية واقعية تقنيًا. بالنسبة لمطور يمتلك وحدة أو وحدتي GPU، ليس هدف نشر عمليًا للنموذج الكامل. في هذه الحالة، يوفّر استخدام DeepSeek V4.1 Flash عبر CometAPI الوصول إلى النموذج دون تحويل الخدمة إلى مشروع بنية تحتية كبير.
الأسئلة المتداولة
هل DeepSeek-V4.1-Flash مفتوح المصدر؟
أوزان النموذج والمستودع منشورة تحت ترخيص MIT، ما يسمح بالاستخدام الواسع، التعديل، وإعادة التوزيع وفق شروط الترخيص.
هل يمكنني تشغيل DeepSeek-V4.1-Flash على RTX 4090 أو RTX 5090؟
ليس النموذج الرسمي الكامل. تملك وحدة GPU واحدة جزءًا صغيرًا فقط من ذاكرة النموذج المطلوبة لنقطة التحقق الكاملة.
هل تعني 8B معاملات نشطة أن DeepSeek-V4.1-Flash يحتاج فقط 8 GB من VRAM؟
لا. يصف رقم 8B المعاملات المشاركة أثناء معالجة المُدخل. يجب تخزين شبكة الخبراء الكاملة والحالة الداعمة وإتاحتها.
كم VRAM يحتاج DeepSeek-V4.1-Flash؟
تستخدم وصفة vLLM الحالية حوالي 614 GB كرقم تخطيط لنقطة التحقق الرسمية زائد نفقات وقت التشغيل. تختلف الاحتياجات الفعلية حسب العتاد، حجم الدفعة، السياق، دعم الرؤية، وتكوين الخدمة.
كم حجم DeepSeek-V4.1-Flash على القرص؟
تضعه تفكيكات vLLM الحالية عند نحو 476 GiB، أو حوالي 511 GB.
هل يمكن لـ DeepSeek-V4.1-Flash تشغيل سياق 1M رمز محليًا؟
تدعم العمارة حتى 1,048,576 رمزًا، لكن الاستخدام العملي للذاكرة يعتمد أيضًا على حجم الدفعة، مخازن وقت التشغيل، حالة الرؤية، ونفقات أخرى.
هل يمكنني تشغيل DeepSeek-V4.1-Flash محليًا مع Ollama؟
يستخدم إدخال Ollama الحالي مسار :cloud، ما لا يساوي تشغيل الأوزان كاملة على جهازك وحده.
هل vLLM أم SGLang أفضل لـ DeepSeek-V4.1-Flash؟
كلاهما يستهدف الخدمة عالية الأداء. تملك vLLM حاليًا وصفة مفصلة خاصة بـ V4.1، بينما يناسب SGLang أيضًا عمليات النشر الموزعة المتقدمة.
ما أسهل طريقة لاستخدام DeepSeek-V4.1-Flash دون عتاد محلي؟
استخدم API مستضافًا. توفر DeepSeek API خاصة بها، بينما توفر CometAPI طرف DeepSeek-V4.1-Flash متوافقًا مع OpenAI إلى جانب نماذج أخرى.