المواصفات التقنية لـ Qwen3.8-Flash
| المواصفة | Qwen3.8-Flash |
|---|---|
| Provider | Alibaba / Qwen |
| Model family | Qwen3.8 |
| Model ID | qwen3.8-flash |
| Model type | نموذج استدلال متعدد الوسائط |
| Input modalities | نص، صورة، فيديو |
| Output modality | نص |
| Context window | 1,000,000 tokens |
| Maximum output | 128,000 tokens |
| Maximum reasoning budget | 262,144 tokens |
| Thinking mode | مدعوم |
| Function calling | مدعوم |
| Built-in tools | مدعوم |
توثّق واجهة برمجة تطبيقات Qwen الحالية أن qwen3.8-flash هو نموذج إنتاجي من عائلة Qwen3.8 مع نافذة سياق بحجم 1M ورقم خرج أقصى 128K. يدعم إدخال النص والصورة والفيديو، واستدعاء الدوال، والأدوات المدمجة، والخَرْج المُنظَّم.
بالنسبة لأعباء العمل المرئية، تتضمن الحدود الموثّقة ما يصل إلى 16 ميغابكسل لكل صورة، وحتى 2,048 عنوان URL للصور أو 250 صورة Base64، وحتى 64 فيديو، مع فيديوهات تصل حتى ساعتين.
ما هو Qwen3.8-Flash؟
Qwen3.8-Flash هو نموذج استدلال متعدد الوسائط منخفض التكلفة من Alibaba ضمن عائلة Qwen3.8، مصمّم للبرمجة وتدفّقات العمل القائمة على الوكلاء، وتحليل السياقات الطويلة، وفهم المرئيات. يوفّر فئة نافذة سياق 1M نفسها كما في Qwen3.8-Max مع استهداف تكلفة API أقل بكثير. توصي إرشادات المطوّرين لدى Qwen صراحةً باستخدام Qwen3.8-Flash عندما يرغب المستخدمون في قدرات مماثلة بسعر أقل، بينما يُطرح Qwen3.8-Max كخيار أقوى من حيث الاستدلال.
اللافت أن "Flash" لا يعني نموذجاً صغيراً بسيطاً. يجمع نموذج API الإنتاجي بين الاستدلال طويل السياق، والمدخلات متعددة الوسائط، واستخدام الأدوات، والخَرْج المُنظَّم في نقطة نهاية منخفضة التكلفة نسبياً.
ما هي الميزات الرئيسية لـ Qwen3.8-Flash؟
- سياق 1M-token: يستطيع Qwen3.8-Flash معالجة مستندات ومستودعات شيفرة فائقة الطول، ما يجعله مناسباً لتحليل المستودعات وجلسات الوكلاء طويلة الأمد.
- فهم متعدد الوسائط: تقبل واجهة API النصوص والصور والفيديو، مما يتيح للمطورين دمج الشيفرة ولقطات الشاشة والرسوم البيانية والمستندات والفيديو في تدفّق عمل واحد.
- وضع الاستدلال: يدعم النموذج وضع التفكير من Qwen، مع ميزانية استدلال قصوى موثّقة تبلغ 262,144 رمزاً.
- دعم الوكلاء والأدوات: يدعم استدعاء الدوال والأدوات المدمجة، بما في ذلك قدرات مثل بحث الويب وتنفيذ الشيفرة وأدوات مستضافة لدى Qwen.
- خَرْج مُنظَّم: يمكن للمطورين طلب استجابات منظّمة، مما يجعل النموذج أسهل في الدمج بالتطبيقات التي تتطلب JSON أو نتائج مقيّدة بمخطط.
- فهم الفيديو الطويل: توثّق واجهة المرئيات إدخال فيديو حتى ساعتين، مما يجعل Qwen3.8-Flash مفيداً لتحليل الفيديو وليس لمهام توصيف الصور القصيرة فقط.
ما أفضل حالات الاستخدام لـ Qwen3.8-Flash؟
البرمجة وهندسة البرمجيات
نافذة السياق بحجم 1M مفيدة للمستودعات الكبيرة، وجلسات تصحيح الأخطاء الطويلة، وتحليل الشيفرة متعددة الملفات. كما أن دعم استدعاء الدوال والاستدلال يجعل النموذج مناسباً لوكلاء البرمجة وليس للإكمال فقط.
تدفّقات عمل قائمة على الوكلاء
يدعم Qwen3.8-Flash استدعاء الدوال والأدوات المدمجة، مما يتيح للتطبيق تمكين النموذج من استرجاع المعلومات أو تنفيذ الشيفرة أو التفاعل مع الأنظمة الخارجية.
تحليل المستندات الطويلة
تجعل نافذة السياق بحجم مليون رمز النموذج مناسباً للعقود الكبيرة، والتوثيق التقني، ومجموعات الأبحاث، وقواعد المعرفة المؤسسية، حيث قد يتطلب الأمر خلاف ذلك تقطيعاً متكرراً للمعلومات.
تحليل الفيديو والمرئيات
يقبل Qwen3.8-Flash الصور والفيديو. تتيح الحدود الحالية لواجهة المرئيات إدخال فيديوهات حتى ساعتين، ما يجعله مناسباً لتسجيلات الاجتماعات، والدروس، والمحاضرات، والعروض، وتحليل المحتوى الطويل.
ذكاء اصطناعي إنتاجي حساس للتكلفة
قد تكون هذه أكبر ميزة تجارية للنموذج. توصي Qwen صراحةً بـ Flash كبديل أقل تكلفة لـ Qwen3.8-Max، ما يجعله مناسباً للتطبيقات كثيفة الحجم حيث لا تكون قدرات الاستدلال الرائدة ضرورية في كل طلب.
ما هي محدوديات Qwen3.8-Flash؟
لا ينبغي تفسير Qwen3.8-Flash باعتباره النموذج الأعلى أداءً ضمن عائلة Qwen3.8 لمجرد أنه يشترك في نافذة سياق 1M مع Qwen3.8-Max.
المقايضة الأساسية هي بين القدرة والتكلفة: توصي Qwen نفسها باستخدام Qwen3.8-Max عندما تكون أقوى جودة استدلال مطلوبة.
اعتبار ثانٍ هو أن نافذة سياق 1M لا تعني أن كل طلب يجب أن يحتوي على مليون رمز. تُزيد السياقات الكبيرة من متطلبات المعالجة، وعلى المطوّرين استخدام الاسترجاع والتخزين المؤقت وإدارة السياق عندما لا تكون الحاجة إلى السياق الكامل قائمة.
أخيراً، ينبغي على المطوّرين التمييز بين النموذج المستضاف qwen3.8-flash والنموذج مفتوح الأوزان Qwen3.8-Flash-Next. الأخير معاينة معمارية وله أوزان ومعمارية موثّقة بشكل مستقل؛ أما نموذج API الإنتاجي فيجب توثيقه وفق مواصفات واجهته البرمجية الخاصة.
هل Qwen3.8-Flash مناسب لتطبيقات API الإنتاجية؟
نعم، خصوصاً عندما يحتاج التطبيق إلى استدلال متعدد الوسائط، وسياق طويل، واستخدام أدوات، وتكلفة رمزية منخفضة نسبياً.
إنه مرشّح إنتاجي أقوى من Flash-Next عندما يكون المطلوب ببساطة استدعاء واجهة Qwen المستضافة، لأن qwen3.8-flash معرَّف صراحةً كنموذج إنتاجي في توثيق API الخاص بـ Qwen مع حدود محدّدة للسياق والإخراج والأدوات وتعدد الوسائط.
للحصول على أقصى جودة للاستدلال، يظل Qwen3.8-Max الخيار الأنسب. ولأعباء العمل كثيفة الحجم حيث تهم التكلفة ومعدل الإنتاجية أكثر، يعد Qwen3.8-Flash الخيار الاقتصادي.
معاملات Qwen3.8-Flash في واجهة API
يمكن لطلب متوافق مع OpenAI القياسي استخدام معاملات مثل:
| المعلمة | الغرض |
|---|---|
| model | qwen3.8-flash |
| messages | المحادثة ومدخلات متعددة الوسائط |
| temperature | التحكم في العشوائية |
| max_tokens | الحد الأقصى للناتج المُولَّد |
| stream | الاستجابات المتدفقة |
| tools | تعريفات الدوال/الأدوات |
| tool_choice | سلوك اختيار الأداة |
| response_format | تهيئة الخَرْج المُنظَّم |
| enable_thinking | تمكين وضع التفكير في واجهات Qwen المدعومة |
تستخدم وثائق البدء السريع OpenAI SDK مع معرّف النموذج qwen3.8-flash. يفعّل المثال وضع الاستدلال باستخدام extra_body={"enable_thinking": True}.
كيفية استخدام qwen3.8-flash API في CometAPI
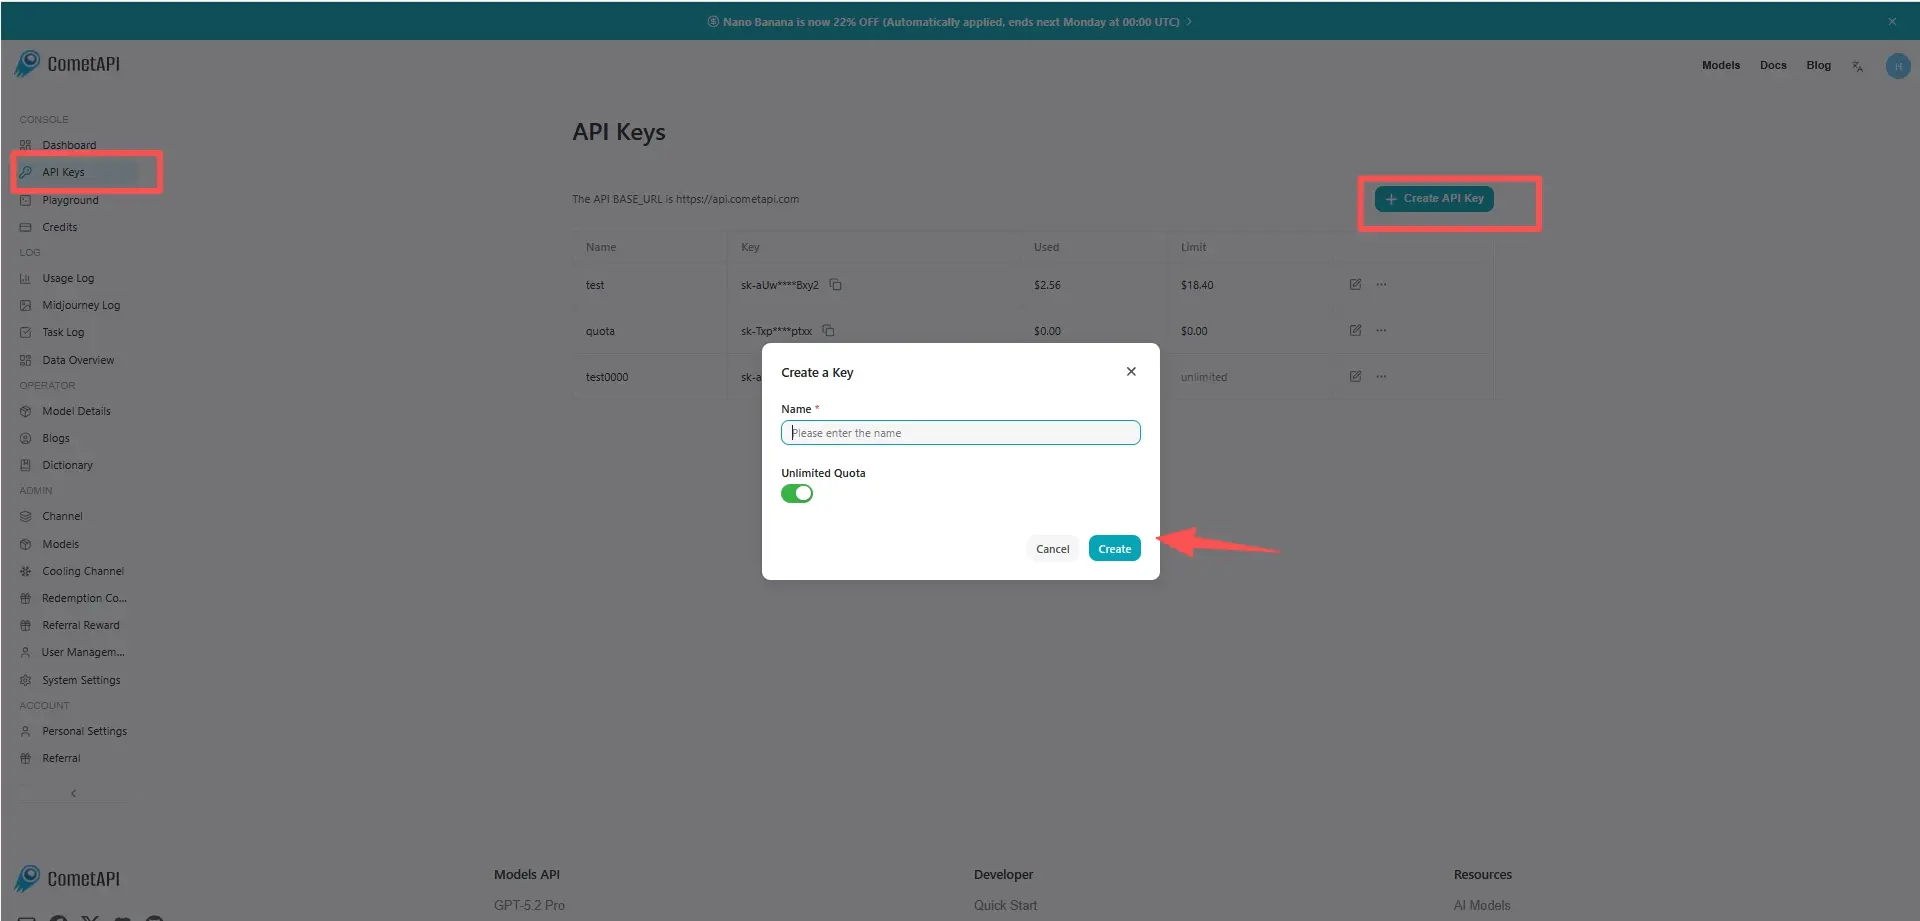
الخطوة 1: الحصول على صلاحية API
سجّل الدخول إلى cometAPI. إذا لم تكن مستخدماً لدينا بعد، الرجاء التسجيل أولاً. سجّل الدخول إلى وحدة تحكم CometAPI. احصل على مفتاح API الاعتمادي لواجهة الخدمة. انقر "Add Token" ضمن API token في المركز الشخصي، واحصل على مفتاح الرمز: sk-xxxxx ثم قدّم الطلب.
الخطوة 2: إرسال الطلبات إلى qwen3.8-flash API
اختر نقطة النهاية "qwen3.8-flash" لإرسال طلب API واضبط جسم الطلب. يمكن الحصول على طريقة الطلب وجسم الطلب من وثائق API على موقعنا. يوفّر موقعنا أيضاً اختبار Apifox لراحتك. استبدل <YOUR_API_KEY> بمفتاح CometAPI الفعلي من حسابك.
أدرج سؤالك أو طلبك في حقل المحتوى — فهذا ما سيستجيب له النموذج. عالج استجابة API للحصول على الإجابة المُولَّدة. يدعم AI SDK وواجهات متوافقة مع OpenAI Chat Completions وOpenAI Responses وAnthropic Messages.
الخطوة 3: معالجة الاستجابات
تُرجع واجهة API استجابات مرشّحة مُنظَّمة تتضمن النص المُولَّد، والاستشهادات، وبيانات السلامة الوصفية، ومخرجات أدوات اختيارية. لطلبات الوسائط المتعددة، يمكن تنظيم محتوى الرسالة بنصوص ومدخلات صور عندما يوفّر معبر CometAPI المحدّد قدرة الرؤية الخاصة بالنموذج.